Muse Glimmer 是 Meta 的 300 亿参数因果语言模型,带有专用感知编码器,从 Muse Spark 中提炼出来,并针对消费者和工作站硬件上的自主代理工作负载而发布。分发方式 Ollama 在下面 Apache 2.0,它的目标是可靠的工具使用、长期任务、多模式理解和故障恢复——无需云推理。此 Workstation 技术简介重写并扩展了面向当地代理商的工程师的公共模型卡。
- 班级: 30B因果LM+感知编码器;从 Muse Spark 中蒸馏而来;愿景+工具+思维。
- 服务:
ollama run muse-glimmer(~18GB,128K,文本+图像); Apple Silicon:muse-glimmer:30b-mlx(~21GB、DFlash)。 - 合身: 一台 GPU 或 Mac Silicon 上始终在线的本地/气隙代理 — 而不是多 TB MoE 集群模型。
- 信号强度: Meta 在 MCP-Atlas、DeepSearch QA、WildClawBench、SWE-Bench Pro、AA-LCR、Beam128K(高推理)上报告的尺寸类别矩阵领先。
- 行动: 脚手架过孔
ollama launch(Claude Code、OpenCode、爱马仕、OpenClaw);通过 evals、HITL、MCP auth 进行管理。
主要来源: Ollama 库 — muse-glimmer;元评估方法—— Muse Glimmer方法论。数字和标签发生变化;采购前验证真人模特卡。
1. 架构和设计意图
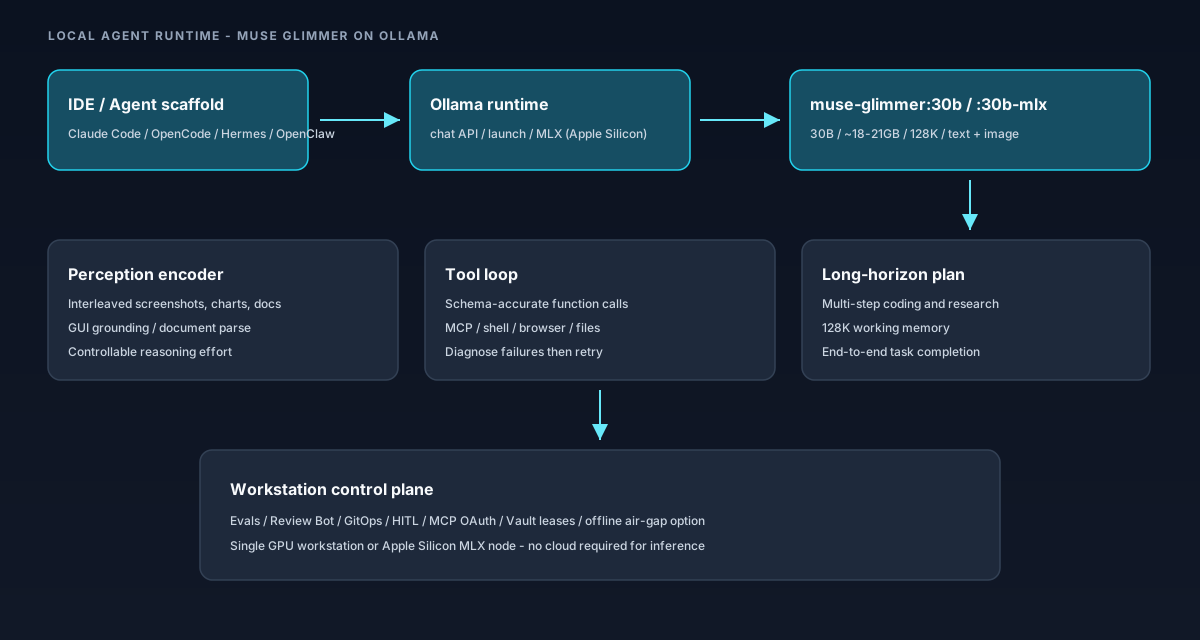
Muse Glimmer并不定位为一般的聊天教育部。 Meta的框架是 端到端代理任务完成 您可以购买用于办公桌或小型实验室机架的硬件:
- 因果 LM 主干 (30B) - 具有跨长工作流程的多步骤推理链的下一代代币生成。
- 专用感知编码器 - 接受交错的文本和图像,以便代理可以在与工具记录相同的上下文窗口中对屏幕截图、图表和文档进行推理。
- 从 Muse Spark 中蒸馏 - 将功能转移到针对单个 GPU/消费者级部署而不是仅数据中心服务的足迹中。
- 故障恢复行为 - 当工具调用失败或返回意外的有效负载时,模型将被训练/调整以诊断和重试,而不是停止事件。
- 可控的努力 - 推理强度是可选的,因此运营商可以用延迟换取每条路由的质量。
- 多语言培训覆盖范围 — Meta 陈述来自 100 多种语言的训练数据。
对于 Workstation 堆栈,产品含义是:将 Glimmer 视为 代理运行时大脑 MCP 工具、shell、浏览器和文件编辑器的背后 — 不是作为每个封闭边界 API 调用的直接替代品。
2. Ollama 分布(标签、封装、I/O)
正如 Ollama 图书卡上公布的那样(验证实际尺寸):
| 标签 | 大约。尺寸 | 语境 | 输入 | 笔记 |
|---|---|---|---|---|
muse-glimmer:latest / :30b | ~18GB | 128K | 文字、图像 | 默认单 GPU 路径 |
muse-glimmer:30b-mlx | ~21GB | 128K | 文字、图像 | Ollama MLX发动机; DFlash + Apple Silicon 上的图像 |
# Pull + interactive
ollama run muse-glimmer

# Apple Silicon (MLX)
ollama run muse-glimmer:30b-mlx

# HTTP chat (localhost Ollama)
curl http://localhost:11434/api/chat \
  -d '{"model":"muse-glimmer","messages":[{"role":"user","content":"Hello!"}]}'

# Scaffold launchers (from Ollama applications list)
ollama launch claude --model muse-glimmer
ollama launch opencode --model muse-glimmer
ollama launch hermes --model muse-glimmer
ollama launch openclaw --model muse-glimmer
Python / JS 客户端应固定您验证的标签(muse-glimmer 与 :30b-mlx)在配置中,而不是硬编码 latest 在生产代理中。
3.能力面(工程读)
- 端到端代理完成 — Meta 引用了 DeepSearch QA、MCP-Atlas、τ3-Bench(银行)和 SWE-Bench 系列任务的强大结果,这些任务衡量了支架式多轮成功,而不是单次琐事。
- 可靠的工具使用 - 跨扩展工作流程的广泛函数调用覆盖范围和模式精度(对于 MCP 工具组至关重要)。
- 多步推理 ——长远规划的一致性;与 128K 上下文窗口配对,用于转录 + 文档保留。
- 故障恢复 — 诊断意外的工具结果并重试;减少“脆性代理”在夜间工作中的中止。
- 多模态推理 — 感知编码器支持屏幕截图/图表/文档与文本交错(GUI 基础和文档解析平台包含在 Meta 的矩阵中)。
- 脚手架兼容性 — OpenClaw、Hermes Agent 和类似的编排模式; Ollama 将 Claude Code 和 OpenCode 启动器列为一流应用程序。
4. 基准矩阵(元报告,高推理)
Meta将Muse Glimmer-30B(高推理)与Gemma4-31B和Qwen3.6-27B在思维模式上进行了比较。 Workstation 阅读标题:Glimmer 领先数位 代理的 公共套件(MCP-Atlas、DeepSearch QA、WildClawBench、Gaia2、SWE-Bench Pro),同时在某些桌面代理和 GDP 验证指标上落后或追平同行。始终重新运行 你的 马具。
| 类别 | 基准 | 微光-30B | 杰玛4-31B | Qwen3.6-27B |
|---|---|---|---|---|
| 总代理 | MCP-Atlas(公共) | 75.5 | 54.2 | 62.5 |
| 深度搜索质量检查 | 74.6 | 61.7 | 71.1 | |
| τ3-银行业务 | 23.5 | 15.1 | 16.7 | |
| 野爪凳 | 47.6 | 37.6 | 43.2 | |
| GDPVal-AA v2 | 953 | 811 | 1141 | |
| 盖亚2 | 43.3 | 36.4 | 40.0 | |
| SkillsBench(带技能) | 44.3 | 32.4 | 46.6 | |
| OSWorld 验证 | 65.9 | 58.5 | 75.6 | |
| 代理编码 | SWE-Bench专业版 | 51.2 | 36.9 | 50.2 |
| SWE-Bench 已验证 | 76.0 | 66.6 | 77.2 | |
| 终端工作台 2.1 | 51.7 | 43.4 | 60.7 | |
| 科学代码 | 43.6 | 43.4 | 39.8 | |
| 多式联运 | CharXiv 推理 | 78.8 | 77.7 | 78.4 |
| 屏幕点专业版 | 75.4 | 75.9 | 76.1 | |
| OmniDocBench v1.5 | 75.8 | 72.5 | 77.8 | |
| MMMU专业版 | 74 | 73 | 75 | |
| 推理/LCR | IFBench | 77.0 | 76.0 | 70.8 |
| 2026年国际医疗器械展览会 | 94.7 | 89.2 | 94.1 | |
| GPQA 钻石 (AA) | 83.5 | 85.7 | 84.2 | |
| HLE 文本 (AA) | 22.0 | 23.6 | 23.1 | |
| AA-LCR | 80.0 | 68.3 | 73.3 | |
| 光束128K | 65.1 | 58.2 | 63.0 |
安全台(CI Memories、Siren AgentDojo)显示出权衡:Glimmer 报告在使用中包 ASR 的 AgentDojo 注入下具有高实用性;将安全性视为部署控制问题(提示防火墙、工具允许列表、HITL),而不是已解决的模型属性。请参阅 Meta 的方法 PDF,了解判断模型、尝试计数和利用注意事项。
5. 评估方法(数字的含义)
在引用董事会中的任何单元格之前,Meta 的方法论注释至关重要:
- 同行选择: 尺寸级开放型号(Gemma4-31B、Qwen3.6-27B);同行可以使用自我报告或内部复制的分数;当所有三个都可用时使用人工分析。
- 采样: Glimmer 报告具有高推理强度,温度=1.0 / top_p=0.95 / top_k=64;同行使用供应商推荐的思维配置(Qwen 在某些代理工作台上使用较低的温度)。
- 利用偏差警告: Meta 指出,第三方模型可能无法根据 Meta 的工具/系统提示进行调整——绝对排名可能会在同行原生支架下发生变化。
- MCP-Atlas: 跨 20 多个 MCP 服务器使用多轮工具; LLM-判断 500 个公共任务的通过率(阈值 0.75),4 次运行的平均值。
- 深度搜索质量检查: 900 个困难研究问题的自主浏览循环(搜索/打开/查找); F1 通过判断提取。
- WildClawBench / Gaia2: OpenClaw 风格的工具下的长期 Docker 化代理任务,具有事件注入和混合确定性/LLM 分级。
- SWE-Bench: bash + 文件工具脚手架;专业版和验证版在多次运行中取平均值——专业版比较避免了 Qwen 的精细任务变体。
- OSWorld 验证: 来自屏幕截图的仅限 GUI 的 Ubuntu VM 控制(无直接 shell);模型之间的动作空间差异很重要。
- 光束128K: 128K 的非代理长上下文内存探针 — 如果您在没有 RAG 的情况下在上下文中保存大型转录本,则相关。
Workstation 政策:发布 Meta 的定位矩阵,然后在内部黄金集(您的 MCP 工具、您的存储库、延迟 SLO)上进行生产。
6. 硬件和服务现实
- 单个 GPU 类: ~18GB 重量足迹意味着现代 24GB+ 消费者/专业版一旦考虑 KV 缓存和视觉激活,GPU 就是实用的 NVIDIA 底板;包含您的最大上下文和并发会话的配置文件。
- Apple Silicon: 更喜欢
:30b-mlx(~21GB) 用于 Ollama 的 MLX 路径,具有 DFlash 推测解码和本机图像输入 — Mac Studio / Mac mini Max 配置是一流的 SME 节点。 - 非 Kimi-K3 级: 这不是多节点 MoE。如果您需要万亿参数开放代理,请参阅我们的 开放重量指南;格丽默拥有 桌面始终开启 利基。
- 库伯内特斯: 每个节点打包 Ollama 或兼容 OpenAI 的 sidecar;将模型拉入您的私人注册表/缓存中;不要将未绑定的 Ollama 暴露到互联网上。
7. 永远在线代理的安全和治理
本地权重减少了数据传出,但增加了受感染代理主机的传播半径。最小 Workstation 基线:
- MCP OAuth 2.1 + 短期秘密(Vault 租赁)- 请参阅 代理安全文章.
- 每个代理身份的工具许可名单和网络出口策略。
- HITL 控制不可逆转的操作(付款、产品部署、群发电子邮件)。
- 对工具返回的内容进行即时注入监控(Siren AgentDojo 式威胁模型)。
- 离线/气隙模式作为一流的运行手册进行了测试,但这并不是希望。
8. 生产检查表
- 引脚 Ollama 标签 (
30b与30b-mlx)并在 GitOps 中记录摘要/哈希。 - 构建 20-50 项任务的黄金套件,反映您的 MCP 工具和编码工作流程;跟踪每个工作级别的 pass@1 和 p95 延迟。
- 钢丝脚手架(
ollama launch …或自定义),并结构化记录工具调用和重试。 - 定义混合路由器:专用 RAG/代理的 Glimmer local;针对溢出/峰值 IQ 的云故障转移。
- 在视觉开启的情况下记录 32K / 64K / 128K 的 VRAM/统一内存空间。
- 法律:Apache 2.0 审查您的分发模型(通常是简单的与限制性的开放重量许可证)。
- 在启用无人值守的夜间代理之前,先发送审核机器人 + 评估门。
发布者: Workstation。型号卡: ollama.com/library/muse-glimmer.


