
Ollama 上的 Muse Glimmer:一台 GPU 上始终在线的本地代理
Meta 的 30B Apache 2.0 代理模型 — 工具使用、愿景、故障恢复 — 以及它对工作站上的私有 AI 意味着什么
 Balinder Walia2026年8月12日1 min read
Meta 的Muse Glimmer是一款 30B 开放模型,专为始终在线的本地代理(工具使用、长时间任务、故障恢复、视觉)而调整,并且它在 Apache 2.0 下的Ollama上提供,用于单个 GPU 或 Apple Silicon。这是 Workstation 的业务。长文中的规格、工作台、方法和生产清单。
底线。云前沿 API 仍然在峰值优化和托管 SLA 方面获胜。 Muse Glimmer 更改了私有、始终在线代理的默认值:带有感知编码器的精炼 30B 模型,适合消费者/工作站硬件(约 18GB 重量,128K 上下文)、许可的 Apache 2.0,并通过
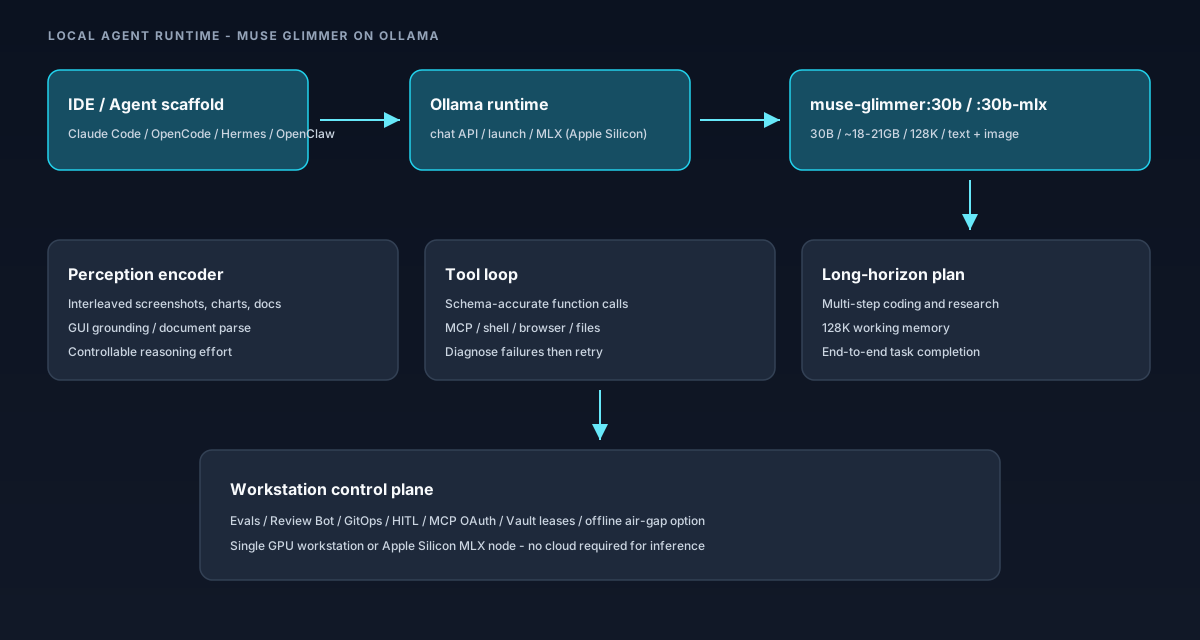
ollama launch连接到 Claude Code、OpenCode、Hermes Agent 和 OpenClaw。隐私、气隙和可预测的单位成本成为产品功能,而不是研究项目。发货内容(商业术语)
- 始终在线的本地代理:旨在持续完成多步骤作业,而无需将每个令牌往返至超大规模器。
- 工具规则:跨长工作流程的模式精确函数调用 - 演示聊天机器人与提交票据、编辑代码或查询 MCP 工具的代理之间的区别。
- 故障恢复:当工具出错或返回无意义信息时,模型会进行诊断并重试,而不是冻结运行。
- 多模式:屏幕截图、图表和文档与文本一起显示 — 对于操作控制台、发票和 UI 自动化非常有用。
- 可控工作量:为硬票据提高推理强度,为延迟敏感路径降低推理强度。
- 许可证:Apache 2.0 — 比许多带有 SaaS 剥离的“开放重量”卡更干净的商业故事。
为什么主板和中小企业应该关注
- 数据驻留:客户 PII、源代码和财务文档可以保留在工作站或私有 VPC 上。
- 单位经济性:推理成本变成硬件摊销 + 电力,而不是随着代理循环而激增的每个代币发票。
- 连续性:离线或降级网络站点(工厂、诊所、现场团队)保持代理运行。
- 采购透明度:与不透明的重量转储相比,Apache 2.0 + Ollama 分配降低了法律和运营摩擦。
而不是取代云
的地方保持封闭的 API(或集群上更大的开放式 MoE),用于峰值关键路径、品牌敏感一代以及需要供应商支持 SLA 的工作负载。 Muse Glimmer 是混合路由器中强大的本地/专用通道— 无需一夜之间拆除 Bedrock 或 Anthropic。将其与我们的代理安全简介中的评估、HITL 和控件配对。
Workstation 建议
- 中小企业/Mac 商店:从 Apple Silicon 上的
ollama run muse-glimmer:30b-mlx开始(或单个中/高端 GPU 工作站上的标准 18GB 标签)。 - 开发团队:线架与
ollama launch claude --model muse-glimmer(或 OpenCode / Hermes / OpenClaw)并衡量您的黄金任务 - 不仅仅是 Meta 的排行榜。 - Enterprises:带有 Review Bot + GitOps 的试点气隙代理吊舱;保持云故障转移以防溢出。
全面技术重写 — 架构、Ollama 标签、基准矩阵与 Gemma4-31B / Qwen3.6-27B、元评估方法和生产清单:长文。由Workstation发布。