商店现已上线

我们打造用于网站、AI 智能体和 LLM 训练的 Workstation AI 机器——在线配置并购买。

获取同行价格
AI 产品
AI 实验室OpenAI 智能体Claude 代理Grok BotWorkstation AI 原生 CRM营销所有产品
AI 解决方案
应用型 AIAI 智能体生成式 AIAI 自动化AI 技能提升中小企业 AI 套餐企业 AI 实验室AI 工作站NVIDIA 硬件与软件NVIDIA 加速计算私有 AIGPU 集群边缘 AI行业 AI
AI 服务
平台现代化数字工程数据基础与 AI自主运营AI 咨询DevOps 自动化网络安全软件开发智能体构建MLOps 搭建GPU 租赁
关于我们
公司我们的故事合作伙伴客户案例
AI 数据中心
AI 洞察Jev 系列基准测试实验室模型选择
技术说明
文档
Linux 操作系统UbuntuRed Hat Enterprise LinuxSUSE LinuxAlpine LinuxDebian, Rocky & AlmaLinux
AI 云平台AWS & Amazon BedrockGoogle Cloud & Vertex AIMicrosoft Azure & AI FoundryGPU 云与算力市场
私有 AI 数据中心面向律师事务所面向会计师事务所本地部署平台全面安全的云
工具Ring PromoterJobshout
新闻
博客
联系我们登录

面向现代企业的 AI 工作站、AI 多智能体软件、GPU 基础设施和智能代理解决方案。

联系我们

AI 解决方案

应用型 AIAI 智能体生成式 AIAI 自动化AI 技能提升中小企业 AI 套餐企业 AI 实验室行业 AI

产品

所有产品Workstation AI native CRM 与 ERP营销OpenAI 智能体Ring PromoterJobshout

公司

关于我们公司AI 数据中心为什么选择Workstation合作伙伴客户案例定价联系TenthMatrix

资源

AI 洞察技术说明文档Linux 操作系统AI 云平台私有 AI 数据中心博客搜索网站地图
英国办公室
77-79 Marlowes, Hemel Hempstead HP1 1LF路线指引 — 从 M25 外环伦敦 20 号出口驶出公司编号: 11641870周一至周五:上午 9:00 - 下午 6:00 GMT
+44 7515 356 146
比利时办公室
Workstation SRL, Rue Vanderkindere 34, 1180 Uccle, BrusselsBE 0751.518.683周一至周五:上午 9:00 - 下午 6:00 CET
+32 492 45 67 46
印度办公室
#159 Sector 9, Pocket 1, DDA Flats, 110077 Dwarka, New Delhi
+91 98881 98841

© 2026 Workstation AI。保留所有权利。

隐私数据删除Cookie服务条款网站地图

NVIDIA, the NVIDIA logo, RTX, RTX PRO, Blackwell, CUDA, NVLink, MGX, Omniverse, Spectrum-X, Quantum, BlueField, DGX and HGX are trademarks and/or registered trademarks of NVIDIA Corporation in the US and other countries. AMD, the AMD Arrow logo, EPYC, Instinct, Ryzen and Threadripper are trademarks of Advanced Micro Devices, Inc. Dell and PowerEdge are trademarks of Dell Inc. or its subsidiaries. Intel and Xeon are trademarks of Intel Corporation or its subsidiaries. AMAX, AceleMax and LiquidMax are trademarks of AMAX Engineering Corporation. All other product names, logos and brands are the property of their respective owners. We use them only to identify the products we describe, supply or support; their use does not mean their owners endorse us.

NVIDIA 合作伙伴 · 英国

NVIDIA 加速计算解决方案

从单块数据中心 GPU 到液冷机架级 AI 工厂,Workstation 为英国机构提供 NVIDIA 全系列加速计算产品的选型、供货、组装、安装与支持。

浏览产品系列咨询工程师
  • 34NVIDIA 系统、GPU、网络与软件产品
  • 5个步骤,从选型到长期支持
  • UK工程设计、组装与老化测试

加速计算,免除集成风险

加速计算将工作负载中最繁重的部分,如 AI 训练、推理、仿真、分析和渲染,从通用 CPU 转移到 GPU 和专用处理器上。这样每个机架、每瓦电力能完成更多工作,结果在数小时内即可得出,而不是数天。

实现这一点不仅需要 GPU。每个加速器都需要能为其供电和散热的服务器、能持续供给数据的网络,以及已获授权并有支持保障的软件。作为拥有自有工程师团队的 NVIDIA 合作伙伴,我们将这些组件整合为一套经过测试的系统,并在系统上线后继续为您提供服务。

  • 独立建议,帮您判断哪种 NVIDIA 平台最适合您的工作负载
  • 完整的 NVIDIA-Certified 配置,而非零散部件
  • 在我们的英国车间完成组装、系统镜像部署和老化测试
  • 在您的现场完成安装、布线和调试
  • 英国本地单一联系人,负责支持、升级和保修

加速系统由哪些部分组成

四个层级协同工作。我们对四个层级统一规划,确保任何一层都不会成为瓶颈。

GPU

承担 AI、仿真和图形背后的并行计算。显存容量和带宽通常决定了您需要哪款 GPU。

CPU 与系统

为 GPU 供给数据、运行操作系统并在内存中保存数据。机箱决定了供电、散热以及可容纳的 GPU 数量。

网络与 DPU

在 GPU、服务器和存储之间传输数据。DPU 可将网络、存储和安全任务从 CPU 上卸载。

软件

驱动、CUDA、AI 框架和集群工具将硬件转化为团队可直接使用的平台。

为什么机构纷纷转向加速计算

工作负载超出 CPU 能力

AI 模型和数据集的增长速度超过 CPU 性能提升。任务超时、服务水平下降、电费上涨。

工作流程日益复杂

数据准备、训练、推理和可视化常常运行在不同设备上。统一的加速平台可简化整个流程。

新应用带来新孤岛

在现有应用旁边增加 AI,可能形成硬件孤岛。共享且经过认证的平台让一切易于管理。

产品系列

NVIDIA 加速计算产品

以下所有系统、GPU、网络产品和软件许可证均可单独供货,也可作为完整方案的一部分。可按类型筛选、比较主要规格并索取报价。

系统与平台

NVIDIA Vera Rubin NVL72

面向代理式 AI 和超大模型的机架级系统

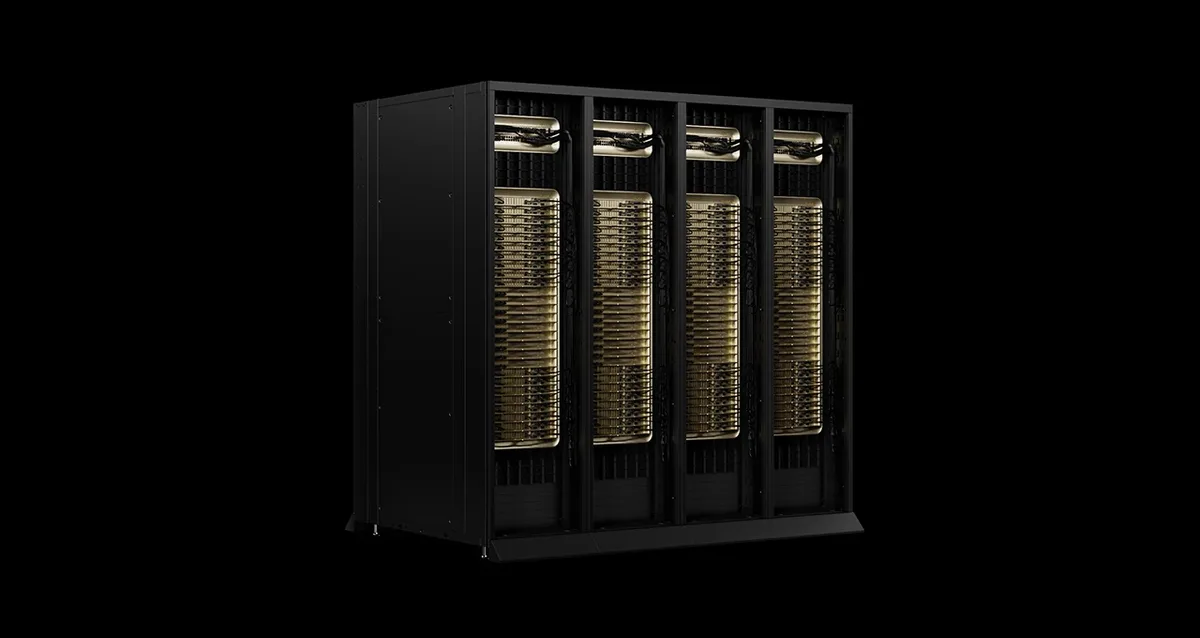
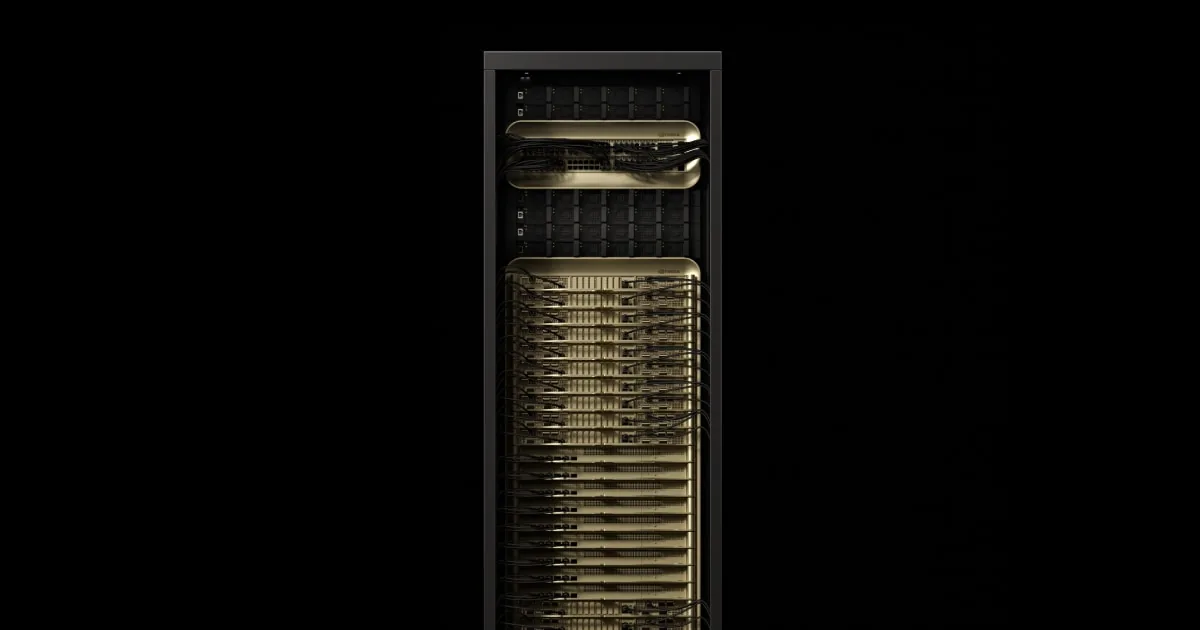
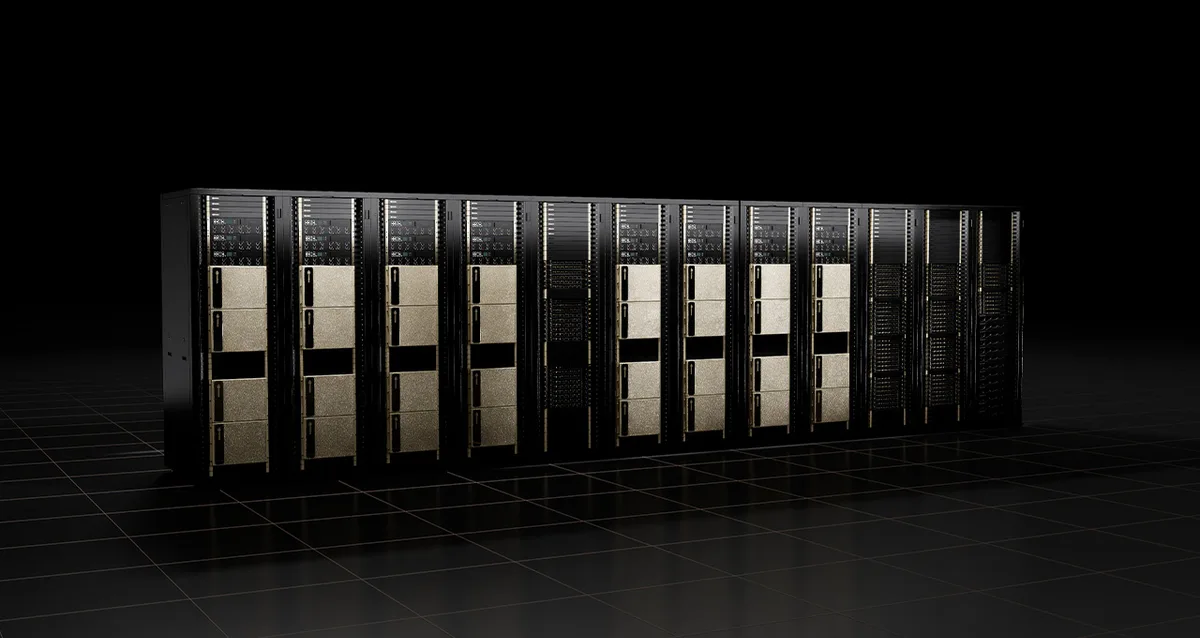
NVIDIA 最新一代机架级系统将 72 个 Rubin GPU 和 36 个 Vera CPU 集成在同一个 NVLink 域中,让单个机架如同一台超大型加速器。

适用对象: 正在规划下一次大规模部署的 AI 工厂、模型开发者和服务提供商

优势

  • 据 NVIDIA 数据,每兆瓦产生的 token 数远超 Grace Blackwell 一代
  • HBM4 内存容量足以支撑万亿参数和长上下文模型
  • 模块化、免线缆托盘,让机架内维护更简单

主要规格

配置72× Rubin GPU, 36× Vera CPU
GPU 显存20.7 TB HBM4 | 1,400 TB/s
NVFP4 推理3,600 PFLOPS (sparse)
NVLink 带宽216 TB/s (sixth generation)
CPU 内存Up to 54 TB LPDDR5X
外形规格Rack, third-generation MGX NVL72

Workstation 提供的服务: 我们会尽早核查现场供电、散热和地板承重,锁定供货配额,并围绕您的数据机房规划交付、安装和调试。

价格请询价索取报价 ↗
在 NVIDIA.com 上查看 ↗
系统与平台

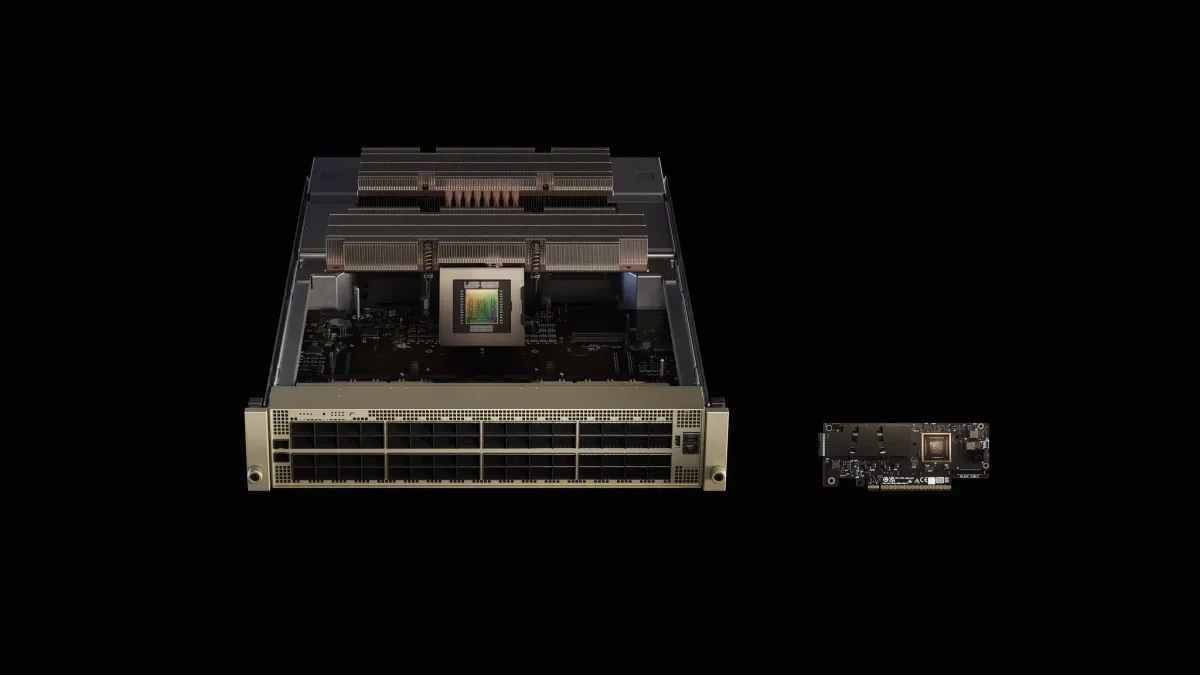
NVIDIA GB300 NVL72 (DGX GB300)

面向 AI 推理的液冷 Blackwell Ultra 机架

36 个 Grace CPU 与 72 个 Blackwell Ultra GPU 在单个液冷机架内共享同一 NVLink 网络。NVIDIA 也以 DGX GB300 的形式供货。

适用对象: 为大量用户提供推理模型服务的机构,以及进行前沿规模训练的团队

优势

  • 与基于 Hopper 的系统相比,每用户每秒 token 数大幅提升
  • 37 TB 高速内存可将长上下文和大模型保留在同一域内
  • ConnectX-8 SuperNIC 为每个 GPU 提供 800 Gb/s 的网络通道

主要规格

GPU72× Blackwell Ultra
CPU36× Grace (2,592 Arm Neoverse V2 cores)
GPU 显存20 TB | up to 576 TB/s
高速内存37 TB
FP4 Tensor Core1,440 PFLOPS (sparse)
NVLink 带宽130 TB/s

Workstation 提供的服务: 我们与您的设施团队共同规划液冷和供电,协调整机柜的交付,并按经过验证的基准完成调试。

价格请询价索取报价 ↗
在 NVIDIA.com 上查看 ↗
系统与平台

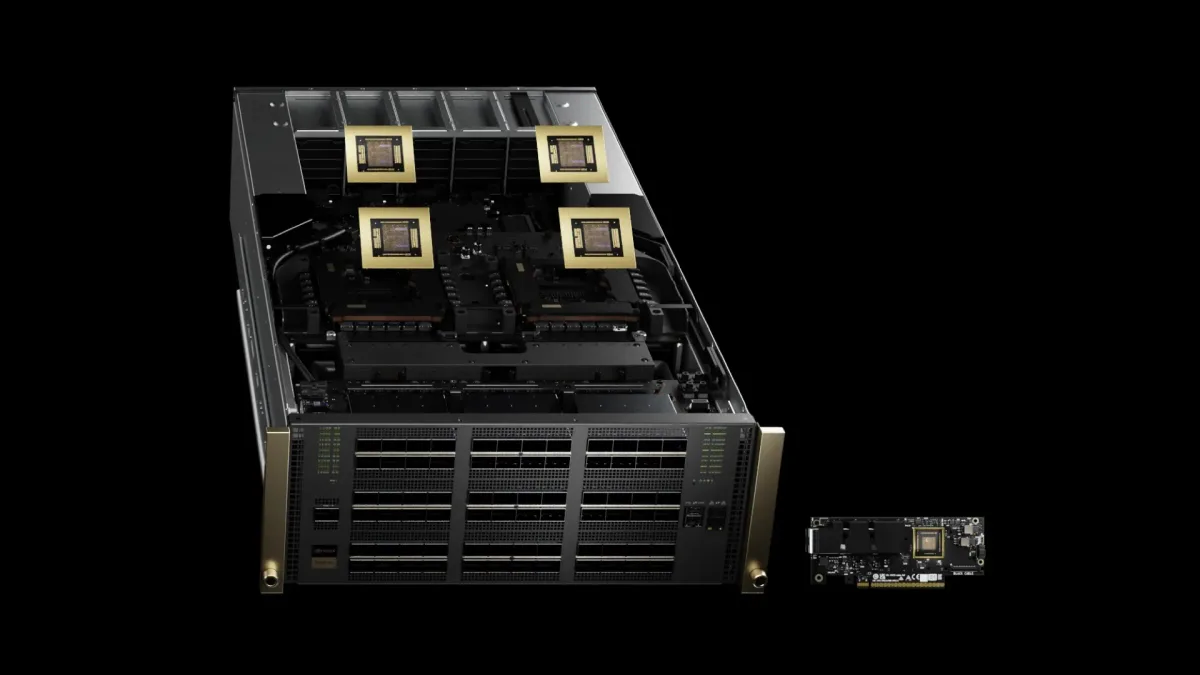
NVIDIA GB200 NVL72 (DGX GB200)

单一 NVLink 域内的 Grace Blackwell 机架级系统

首款 Grace Blackwell 机架:72 个 Blackwell GPU 与 36 个 Grace CPU 通过 NVLink 互连并采用液冷,适用于超大规模训练和实时推理。

适用对象: 训练或部署万亿参数模型、需要大型共享 GPU 内存池的团队

优势

  • 据 NVIDIA 数据,超大语言模型的实时推理速度是 H100 的数倍
  • 液冷提升密度和能效
  • 第五代 NVLink 在任意两个 GPU 之间提供 1.8 TB/s 带宽

主要规格

配置72× Blackwell GPU, 36× Grace CPU
GPU 显存13.4 TB HBM3E | 576 TB/s
NVFP4 Tensor Core1,440 PFLOPS sparse | 720 PFLOPS dense
NVLink 带宽130 TB/s
CPU 内存17 TB LPDDR5X | 14 TB/s
冷却Liquid cooled

Workstation 提供的服务: 我们评估您的现场是否适合液冷,负责交付以及与您网络和存储的集成,并在上线后为机架提供支持。

价格请询价索取报价 ↗
在 NVIDIA.com 上查看 ↗
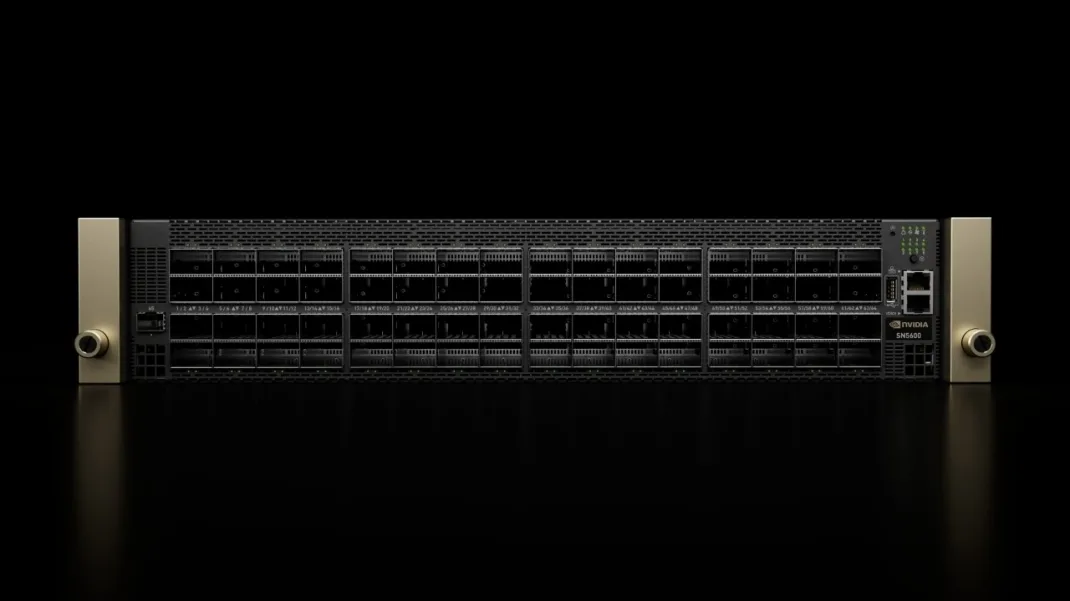
系统与平台

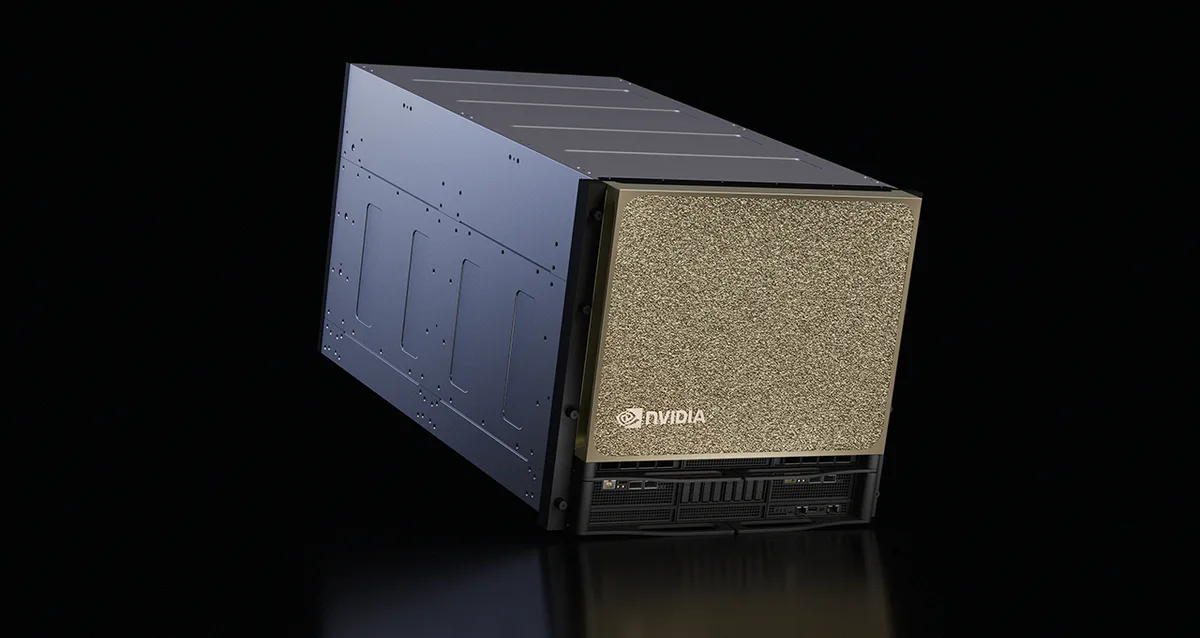
NVIDIA DGX B300

单台 DGX 系统集成八个 Blackwell Ultra GPU

一台独立完整的 DGX 服务器,配备八个 Blackwell Ultra GPU、NVIDIA 网络和完整的 DGX 软件栈,可独立运行,也可加入 BasePOD 或 SuperPOD。

适用对象: 正在建设首个正式 AI 工厂的企业,以及希望采用 NVIDIA 参考设计而非定制方案的团队

优势

  • 单节点 2.3 TB GPU 内存,适合大模型
  • 内置 ConnectX-8 和 BlueField-3 网络,便于横向扩展
  • DGX 软件从第一天起就确保集群中每个节点保持一致

主要规格

GPU8× Blackwell Ultra
GPU 显存2.3 TB total
AI 性能72 PFLOPS FP8 training, 144 PFLOPS FP4 inference
网络8× ConnectX-8, 2× BlueField-3 DPU

Workstation 提供的服务: 我们核查机架供电和气流,交付并上架系统,接入您的网络架构,并在 DGX OS 和驱动验证完毕后交付。

价格请询价索取报价 ↗
在 NVIDIA.com 上查看 ↗
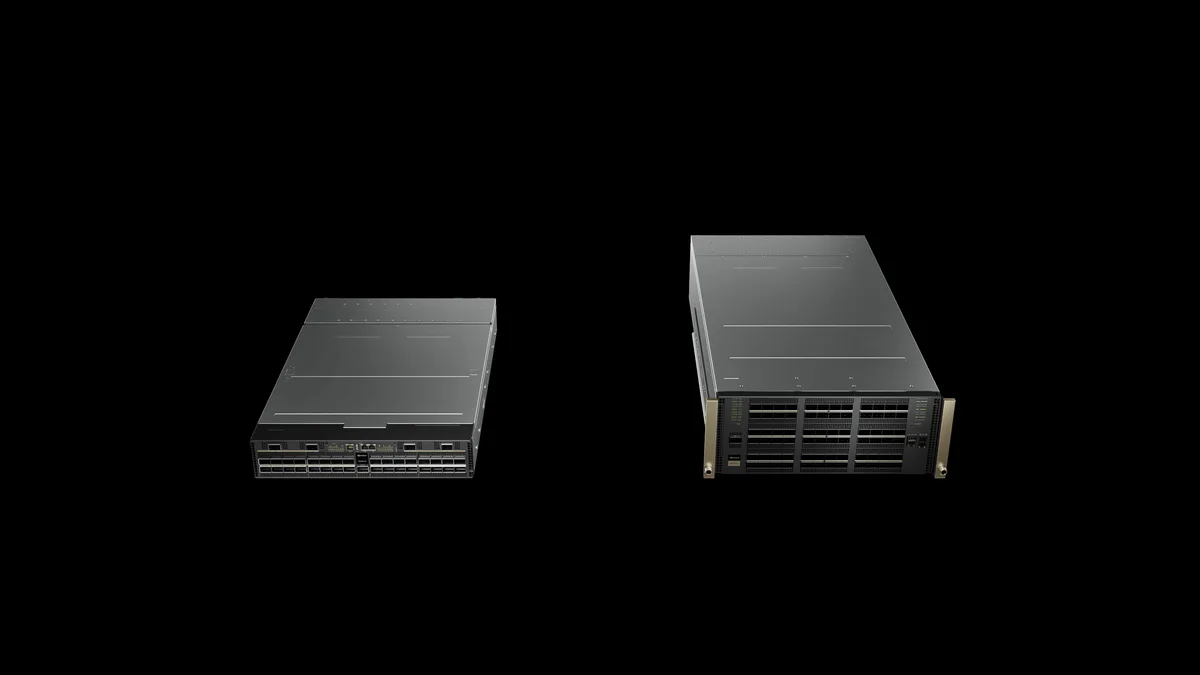
系统与平台

NVIDIA DGX B200

久经验证的 Blackwell DGX,适用于训练和推理

单个 DGX 机箱内集成八个 NVLink 互连的 Blackwell GPU,是本地部署 AI 广泛采用的基础构建模块。

适用对象: 从 Hopper 或云端 GPU 迁移到自有 Blackwell 平台的团队

优势

  • 一个平台满足训练、微调和推理需求
  • 八个 NVLink 互连 GPU 共 1,440 GB GPU 内存
  • 随业务增长,可融入 BasePOD 和 SuperPOD 参考设计

主要规格

GPU8× Blackwell
GPU 显存1,440 GB total
AI 性能72 PFLOPS training, 144 PFLOPS inference
网络8× ConnectX-7, 2× BlueField-3 DPU

Workstation 提供的服务: 我们根据您的模型进行选型,完成交付和安装,并在交付前配置好驱动、CUDA 和 NVIDIA AI Enterprise。

价格请询价索取报价 ↗
在 NVIDIA.com 上查看 ↗
系统与平台

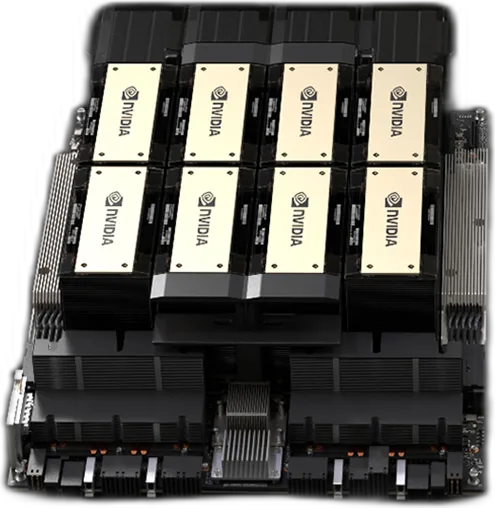
NVIDIA HGX

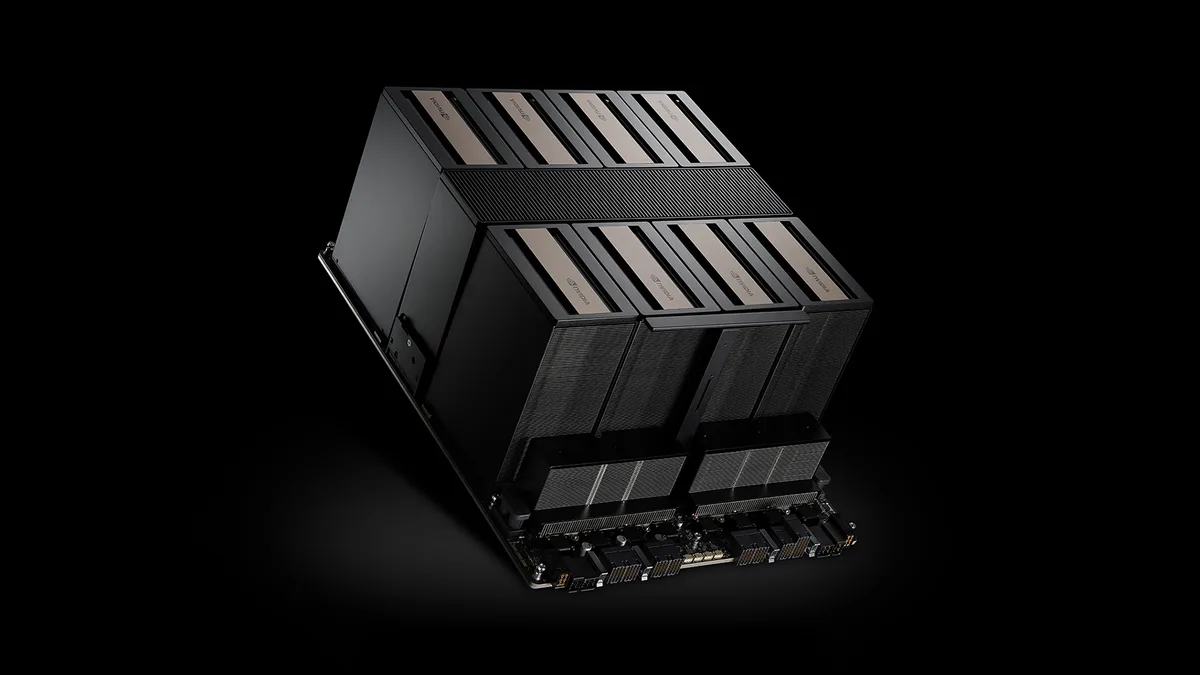
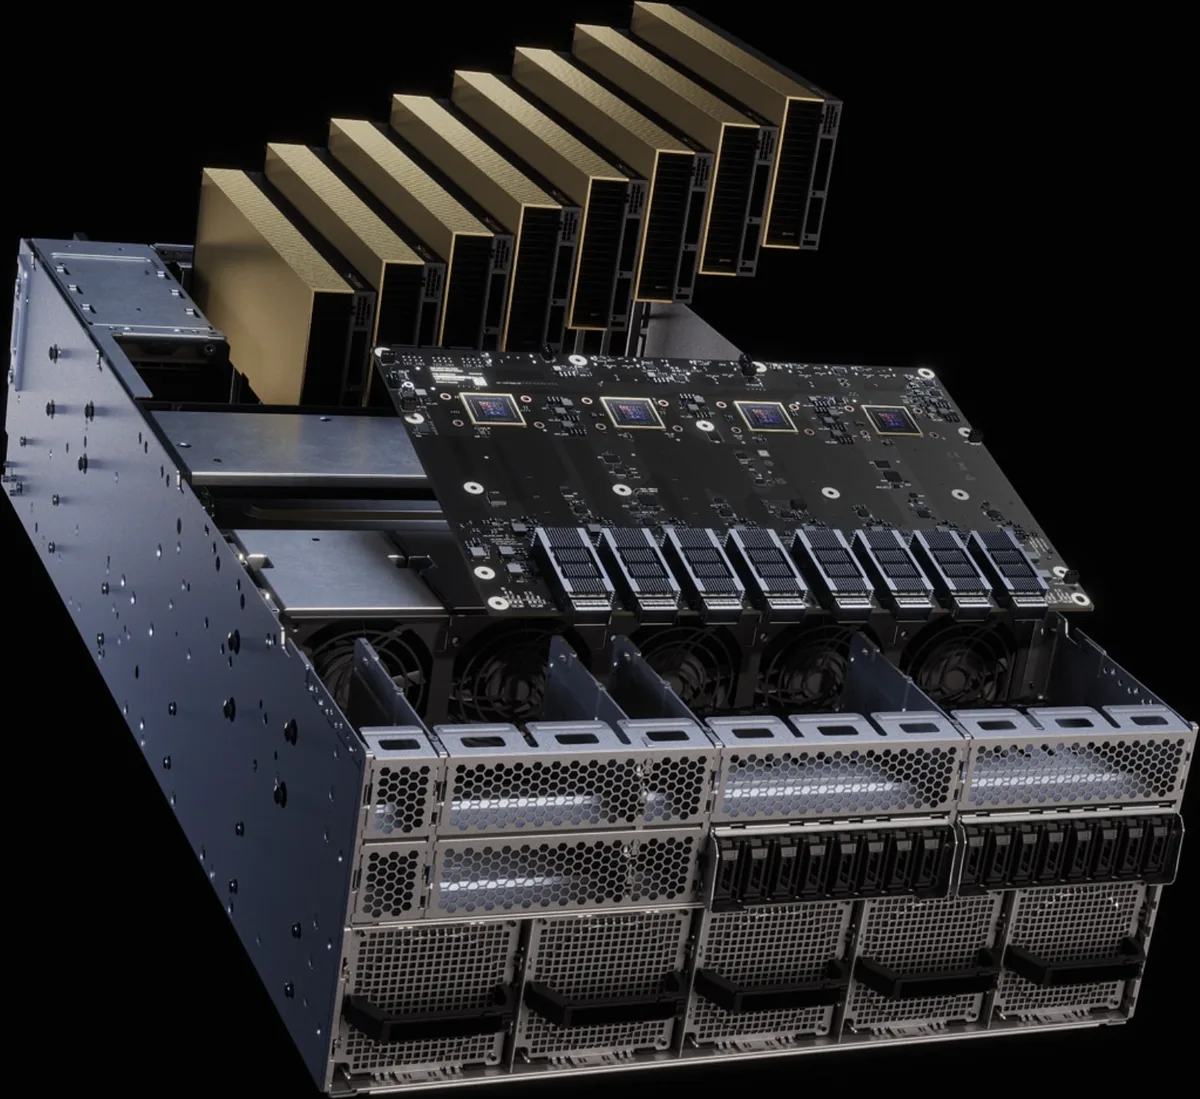
合作伙伴服务器内的八 GPU 基板

HGX 是 NVIDIA 采用 NVLink 互连的 GPU 基板,由服务器厂商集成到自有系统中,让您在获得顶级 GPU 的同时自由选择机箱、CPU 和支持品牌。

适用对象: 希望从首选服务器厂商处获得旗舰 GPU 的机构

优势

  • 自由选择适合您现有环境的服务器品牌、CPU 和存储
  • NVLink 和 NVSwitch 以全速连接全部八个 GPU
  • 涵盖 Blackwell、Blackwell Ultra 和 Rubin 各代产品

主要规格

HGX B3008× Blackwell Ultra SXM, 2.1 TB, 144 PFLOPS FP4 (sparse)
HGX B2008× Blackwell SXM, 1.4 TB, 144 PFLOPS FP4 (sparse)
HGX Rubin NVL88× Rubin SXM, 2 TB HBM4, 400 PFLOPS NVFP4 inference
NVLink 带宽14.4 TB/s total (HGX B300 and B200)

Workstation 提供的服务: 我们从您首选的品牌采购 HGX 服务器,在我们的车间进行满负载老化测试,并与您的网络一同安装。

价格请询价索取报价 ↗
在 NVIDIA.com 上查看 ↗
系统与平台

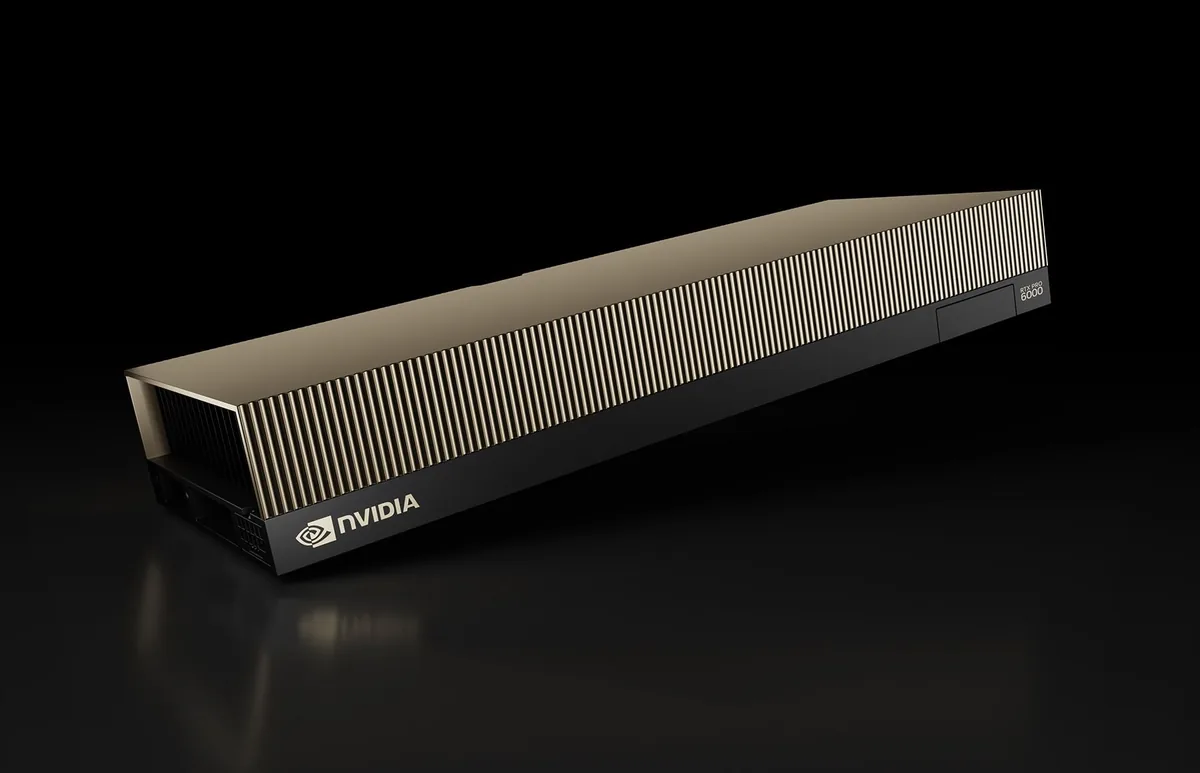
NVIDIA RTX PRO Server

面向企业 AI 与图形的通用 Blackwell 服务器

一款数据中心服务器,最多配备八个 RTX PRO 6000 Blackwell Server Edition GPU,在同一平台上运行 AI、仿真、渲染和虚拟工作站。这是 NVIDIA 的主流加速服务器,其 EGX 页面现已指向该产品。

适用对象: 在推出新 AI 服务的同时,将现有数据中心工作负载迁移到 GPU 的企业

优势

  • 一种服务器即可满足 AI 推理、视觉计算和数据科学需求
  • 风冷选项适合大多数现有服务器机房
  • 已通过 NVIDIA AI Enterprise 和 Omniverse 验证

主要规格

GPUUp to 8× RTX PRO 6000 Blackwell Server Edition
GPU 显存800 GB (8-GPU configuration)
内存带宽13 TB/s (8-GPU configuration)
RTX 图形3 PFLOPS
配置MGX 2U, 4U and 6U (6U liquid cooled)

Workstation 提供的服务: 我们根据您的工作负载确定机箱和 GPU 数量,确认其为 NVIDIA-Certified,然后完成组装、老化测试和安装。

价格请询价索取报价 ↗
在 NVIDIA.com 上查看 ↗
系统与平台

NVIDIA DGX SuperPOD

面向大规模 AI 工厂的交钥匙蓝图

一套全栈参考架构,将 DGX 系统、NVIDIA 网络、认证存储和管理软件组合为可复制的可扩展单元。

适用对象: 构建数百乃至数千 GPU 集群的研究实验室、大型企业和 AI 服务提供商

优势

  • 经过测试的设计大幅降低集成风险
  • 以可复制单元扩展至数万个 GPU
  • 包含用于运维的 Mission Control 和 Base Command Manager

主要规格

类型Reference architecture
构建模块Scalable units of DGX systems
规模Up to tens of thousands of GPUs
存储NVIDIA-certified partner storage
软件NVIDIA AI Enterprise, Base Command Manager, Mission Control

Workstation 提供的服务: 我们与 NVIDIA 及存储合作伙伴共同主导设计,执行项目计划,安装可扩展单元,并持续担任您的支持联系人。

价格请询价索取报价 ↗
在 NVIDIA.com 上查看 ↗
系统与平台

NVIDIA DGX BasePOD

适用于您首个 DGX 集群的参考设计

一套经过验证的设计,适用于两台或更多 DGX 系统,并配有匹配的网络、存储和集群软件:规模小于 SuperPOD,但构建方式相同。

适用对象: 从单台 DGX 系统发展为小型共享集群的团队

优势

  • 从两台系统起步,扩容无需重新设计
  • 网络和存储与 GPU 相匹配
  • 包含用于调度和监控的集群软件

主要规格

类型Reference architecture
规模2 or more DGX systems
网络Per reference architecture
存储Partner storage
软件NVIDIA AI Enterprise, Base Command

Workstation 提供的服务: 我们为集群选型,供应全部部件,完成上架和布线,并配置调度,让您的团队从第一天起即可共享使用。

价格请询价索取报价 ↗
在 NVIDIA.com 上查看 ↗
系统与平台

NVIDIA Grace 与 Vera CPU

专为 AI 工厂打造的 Arm 数据中心 CPU

NVIDIA 自研 CPU 通过 NVLink-C2C 与其 GPU 相连。Grace CPU Superchip 目前已搭载于合作伙伴服务器中,其后继产品 Vera 面向代理式 AI。

适用对象: HPC 中心、云构建者,以及在 GPU 之外还运行 CPU 密集型流程的用户

优势

  • LPDDR5X 带来高内存带宽
  • 据 NVIDIA 数据,同等功耗下性能是领先传统 CPU 的两倍
  • 与 NVIDIA GPU 的一致性高速互连

主要规格

Grace CPU Superchip144 Arm Neoverse V2 cores, 2 CPUs over 900 GB/s NVLink-C2C
Grace 内存带宽Up to 1 TB/s LPDDR5X
Vera CPU88 Olympus cores, up to 1.5 TB memory at up to 1.2 TB/s
Vera NVLink-C2CUp to 1.8 TB/s

Workstation 提供的服务: 我们为您的软件栈寻找合适的合作伙伴服务器,与您一同在 Arm 上测试应用,然后完成构建并提供支持。

价格请询价索取报价 ↗
在 NVIDIA.com 上查看 ↗
系统与平台

NVIDIA OVX

面向 Omniverse 和数字孪生的 L40S 服务器

OVX 是 NVIDIA 针对 Omniverse 验证的服务器设计,将 L40S GPU 与 ConnectX-7 或 BlueField-3 网络结合,用于仿真、渲染和 AI。

适用对象: 构建工业数字孪生的制造商、建筑师和工程团队

优势

  • 一台服务器兼顾图形、仿真和 AI 推理
  • 已通过 Omniverse 和 NVIDIA AI Enterprise 验证
  • 可在高速网络上扩展至数百台服务器

主要规格

GPU4× or 8× NVIDIA L40S
CPU2× Intel Xeon Gold or 2× AMD EPYC
主机内存384 GB (4-GPU) or 768 GB (8-GPU) DDR5 ECC minimum
存储1 TB NVMe boot, 2× 4 TB NVMe
网络ConnectX-7 or BlueField-3

Workstation 提供的服务: 我们采用认证合作伙伴的产品构建 OVX 架构服务器,配置 Omniverse 和驱动,并将其连接到您的设计工具。

价格请询价索取报价 ↗
在 NVIDIA.com 上查看 ↗
系统与平台

NVIDIA AGX (Jetson AGX Thor)

面向机器人和自主机器的 AI 计算机

AGX 是 NVIDIA 面向自主机器的平台。其当前旗舰 Jetson AGX Thor 将 Blackwell GPU 带入机器人、车辆和智能机器。

适用对象: 将 AI 融入机器的机器人、汽车和工业团队

优势

  • 在机器本地运行感知和生成式 AI 模型
  • 低功耗,适合移动和嵌入式设计
  • 使用与 NVIDIA 数据中心平台相同的 CUDA 软件

主要规格

GPUBlackwell, 2560 CUDA cores, 96 fifth-generation Tensor Cores
AI 性能2070 TFLOPS (FP4)
选项Developer kit, or T5000 and T4000 production modules

Workstation 提供的服务: 我们供应开发者套件和量产模组,协助选择载板和外壳,并为您提供从原型到量产部署的全程支持。

价格请询价索取报价 ↗
在 NVIDIA.com 上查看 ↗
系统与平台

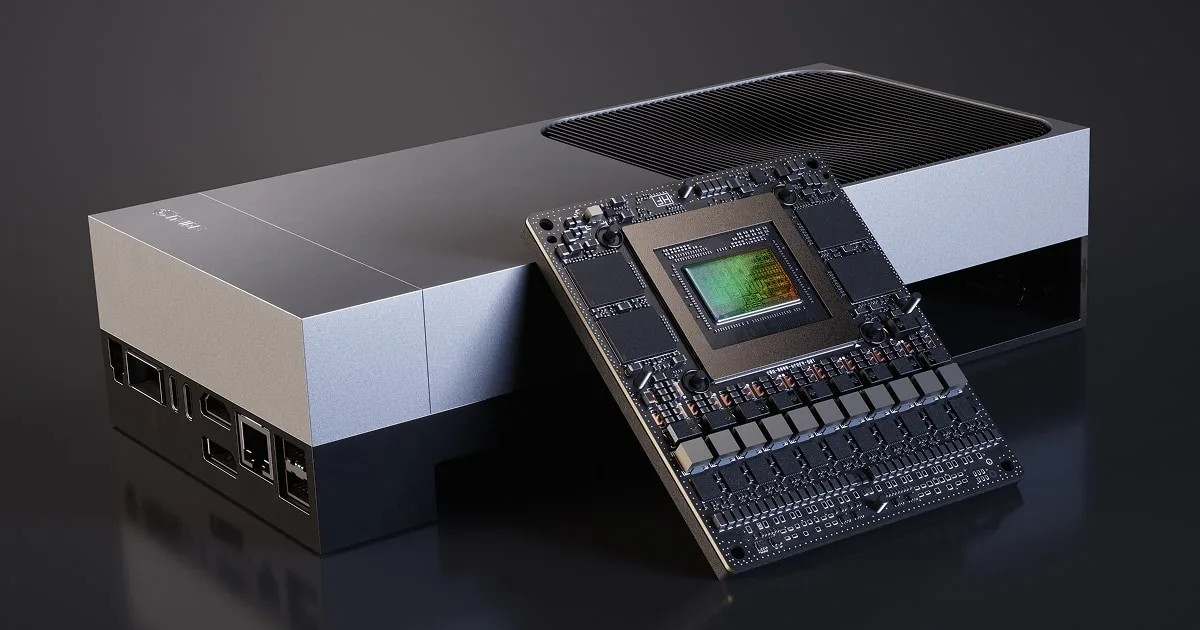
NVIDIA IGX Thor

具备功能安全的工业边缘 AI

IGX 是 NVIDIA 面向工业和医疗边缘物理 AI 的企业级平台,配备专用安全岛和长期软件支持。

适用对象: 需要安全认证和长期支持周期的医疗设备制造商、工厂和基础设施运营商

优势

  • 功能安全设计面向 ISO 26262 和 IEC 61508
  • 十年 NVIDIA 企业级软件支持
  • 可选配 RTX PRO Blackwell GPU,运行更大模型

主要规格

AI 性能Up to 5,581 TFLOPS FP4 (sparse) with discrete GPU
集成 GPU2,560-core Blackwell
CPU14-core Arm Neoverse-V3AE, 2.6 GHz
内存128 GB LPDDR5X, 273 GB/s
功耗40–130 W, up to 300 W for the discrete GPU

Workstation 提供的服务: 我们供应开发者套件和量产系统,协助您规划认证所需材料,并支持在您现场的部署。

价格请询价索取报价 ↗
在 NVIDIA.com 上查看 ↗

系统与平台

NVIDIA Groq 3 LPX

面向 Vera Rubin 的低延迟推理机架

LPX 是由 256 个 LPU 推理加速器组成的机架,与 Vera Rubin NVL72 协同工作,为交互式和代理式 AI 快速、稳定地生成 token。

适用对象: 用户需要快速、稳定响应时间的 AI 服务提供商

优势

  • 确定性的低延迟 token 生成
  • 据 NVIDIA 预测,万亿参数模型的每兆瓦吞吐量大幅提升
  • 与 NVL72 机架直接低延迟互连

主要规格

加速器256 LPUs per rack
片上内存128 GB SRAM per rack (500 MB per LPU)
SRAM 带宽40 PB/s per rack
纵向扩展带宽640 TB/s per rack
外形规格NVIDIA MGX ETL rack

Workstation 提供的服务: 我们评估其如何契合您的 Vera Rubin 规划,与 NVIDIA 确认供货情况,并与您的其他机架统筹规划安装。

价格请询价索取报价 ↗
在 NVIDIA.com 上查看 ↗

数据中心 GPU

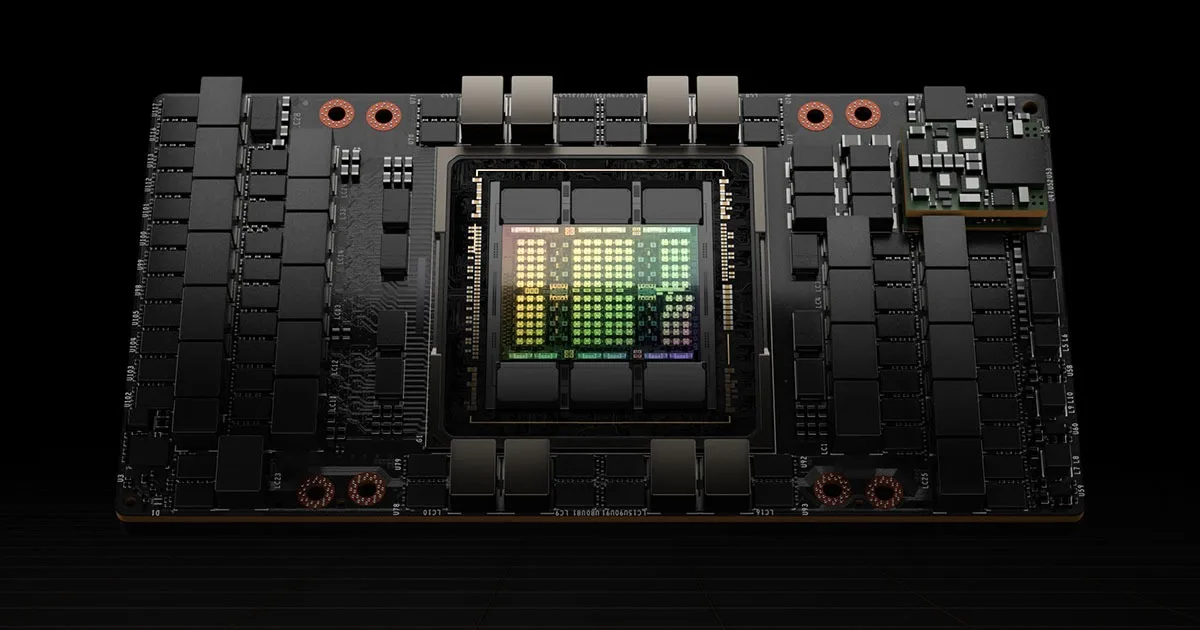
NVIDIA H200 (SXM)

配备 141 GB HBM3e 的 Hopper GPU

H200 延续 Hopper 架构,但显存容量更大、速度更快,有助于大模型推理和受内存限制的 HPC 任务。SXM 版本用于 HGX 服务器。

适用对象: 在 HGX 服务器上运行大语言模型和 HPC 代码的团队

优势

  • 每 GPU 141 GB,可容纳更大模型而无需拆分
  • 更高内存带宽加速受内存限制的任务
  • 运行与 H100 相同的 CUDA 软件

主要规格

架构NVIDIA Hopper
GPU 显存141 GB HBM3e
外形规格SXM (HGX)
冷却Passive (server airflow)

Workstation 提供的服务: 我们以认证 HGX 服务器的形式供应 H200,完成老化测试,并与您的驱动和软件栈一同安装。

价格请询价索取报价 ↗
在 NVIDIA.com 上查看 ↗

数据中心 GPU

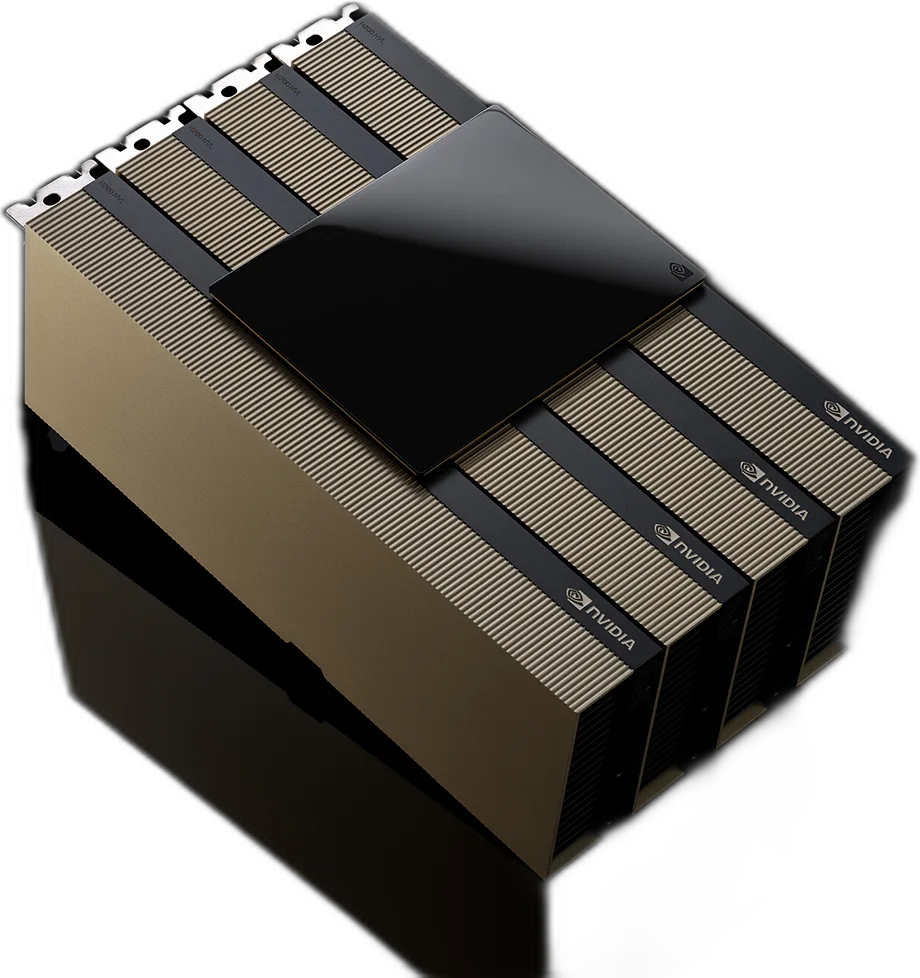
NVIDIA H200 NVL

面向风冷 PCIe 服务器的 141 GB Hopper GPU

适用于标准企业机架的 H200 PCIe 版本。NVLink 桥接器可将显卡两两配对,满足需要更大内存的模型。

适用对象: 在现有风冷服务器机房中增加大模型推理能力的企业

优势

  • 无需改用液冷即可获得大容量 GPU 内存
  • NVLink 桥接器连接多个 GPU,支持更大模型
  • 适配主流 NVIDIA-Certified 服务器

主要规格

架构NVIDIA Hopper
GPU 显存141 GB HBM3e
外形规格PCIe, dual slot
冷却Passive (server airflow)

Workstation 提供的服务: 我们核查您机箱的供电、气流和插槽布局,然后安装、测试并交付显卡或整机服务器。

价格请询价索取报价 ↗
在 NVIDIA.com 上查看 ↗

数据中心 GPU

NVIDIA H100 PCIe 80 GB

面向 PCIe 服务器训练与推理的 Hopper GPU

PCIe 版 H100 将 Hopper 的 Transformer Engine 和机密计算能力带到标准服务器上。

适用对象: 已有 PCIe GPU 服务器、需要成熟 Hopper 性能的团队

优势

  • Transformer Engine 加速语言模型的训练和推理
  • Multi-Instance GPU 可将一张显卡划分为多个隔离实例
  • 硬件支持机密计算

主要规格

架构NVIDIA Hopper
GPU 显存80 GB HBM2e
外形规格Dual-slot, full height, full length
冷却Passive (server airflow)
接口PCIe

Workstation 提供的服务: 我们将 H100 安装到经认证的服务器中,完成老化测试,并配置 CUDA、驱动以及所需的 vGPU 或 AI Enterprise 许可证。

价格请询价索取报价 ↗
在 NVIDIA.com 上查看 ↗

数据中心 GPU

NVIDIA RTX PRO 6000 Blackwell Server Edition

面向机架服务器的 96 GB Blackwell GPU

一款被动散热的 Blackwell 显卡,配备 96 GB 显存,适用于数据中心的 AI 推理、渲染、仿真和虚拟工作站。

适用对象: 将 AI 与图形工作负载整合到同一类 GPU 上的企业

优势

  • 每 GPU 96 GB,可处理大模型和大型场景
  • 同时支持 AI 和专业图形
  • 功耗可配置,适配不同服务器

主要规格

架构NVIDIA Blackwell
GPU 显存96 GB GDDR7 with ECC
最大功耗Up to 600 W (configurable)
接口PCIe 5.0 x16
外形规格Dual-slot, passive (server airflow)

Workstation 提供的服务: 我们可单独供应显卡,也可集成在 RTX PRO Server 中供货,并在交付前进行满负载测试。

价格请询价索取报价 ↗
在 NVIDIA.com 上查看 ↗

数据中心 GPU

NVIDIA RTX PRO 4500 Blackwell Server Edition

面向高密度服务器的单槽 Blackwell GPU

一款紧凑型被动散热 32 GB Blackwell GPU,可在单台服务器中安装多张显卡,用于推理、视频和虚拟桌面。

适用对象: 以更低单 GPU 成本为大量用户扩展推理或虚拟桌面的团队

优势

  • 单槽设计,每台服务器可容纳更多 GPU
  • 32 GB GDDR7,适合中等规模模型
  • 功耗更低,适合现有机架

主要规格

架构NVIDIA Blackwell
GPU 显存32 GB GDDR7
外形规格Single slot, 4.4" H × 10.5" L
冷却Passive (server airflow)

Workstation 提供的服务: 我们测算您的服务器可供电和散热的显卡数量,然后完成配置的组装与测试。

价格请询价索取报价 ↗
在 NVIDIA.com 上查看 ↗

数据中心 GPU

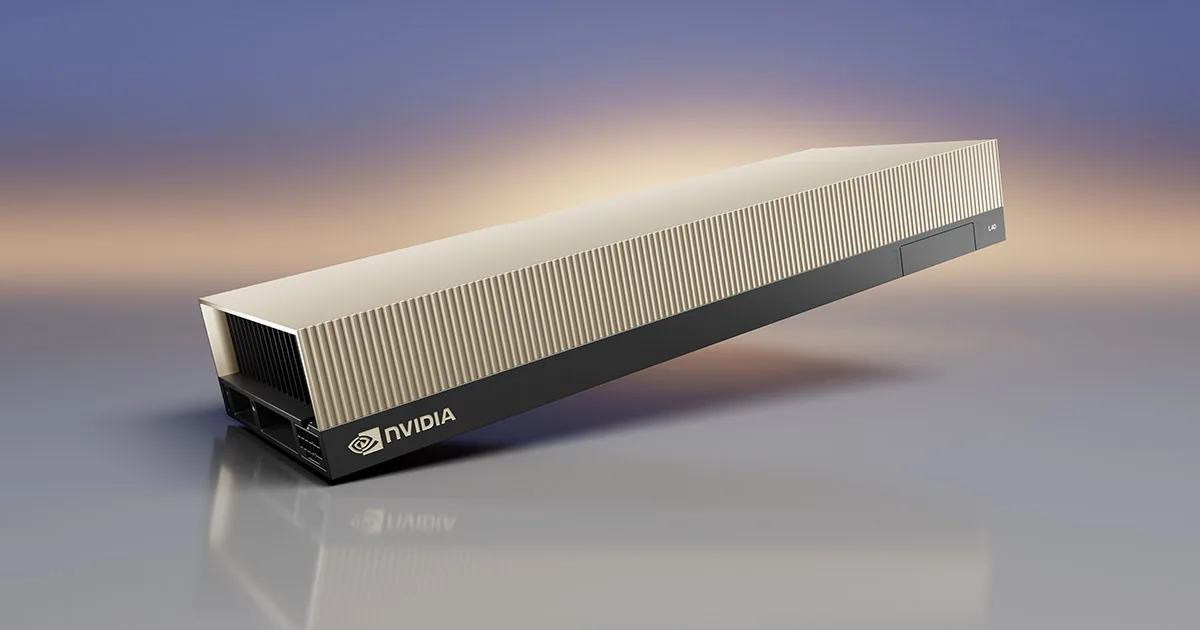
NVIDIA L40S

48 GB 全能型 GPU,兼顾 AI 与图形

一款 Ada Lovelace 数据中心 GPU,在推理、微调和 3D 图形之间取得平衡,也是 NVIDIA OVX 设计所采用的 GPU。

适用对象: 需要一款 GPU 同时处理 AI 和视觉工作负载的团队

优势

  • 推理和微调性能出色,性价比高
  • 硬件光线追踪,适用于渲染和 Omniverse
  • 适用于主流服务器的标准 PCIe 显卡

主要规格

架构NVIDIA Ada Lovelace
GPU 显存48 GB GDDR6 with ECC
外形规格Dual-slot, 4.4" H × 10.5" L
冷却Passive (server airflow)
接口PCIe

Workstation 提供的服务: 我们为 L40S 匹配经认证的服务器,完成老化测试,并在配置好驱动和许可证后安装交付。

价格请询价索取报价 ↗
在 NVIDIA.com 上查看 ↗

数据中心 GPU

NVIDIA L40

面向渲染和虚拟工作站的 48 GB GPU

L40 专注于图形:数据中心内的渲染、Omniverse 和虚拟工作站。

适用对象: 将工作站迁入数据中心的设计和媒体团队

优势

  • 48 GB,满足大型场景和素材需求
  • 支持 NVIDIA 虚拟 GPU 软件
  • 被动散热,适用于标准服务器

主要规格

架构NVIDIA Ada Lovelace
GPU 显存48 GB GDDR6 with ECC
外形规格Dual-slot, 4.4" H × 10.5" L
冷却Passive (server airflow)
接口PCIe

Workstation 提供的服务: 我们配置 vGPU 配置文件和许可证,让用户获得如同本地般流畅的远程工作站。

价格请询价索取报价 ↗
在 NVIDIA.com 上查看 ↗

数据中心 GPU

NVIDIA L4

面向高效推理和视频的半高 GPU

一款小巧低功耗的 Ada Lovelace 显卡,适用于从边缘到数据中心的视频 AI、推理和虚拟桌面。

适用对象: 在大量服务器或电力预算紧张的边缘站点上增加 AI 能力的机构

优势

  • 低功耗、半高显卡,几乎适配任何服务器
  • 非常适合视频分析和推理
  • 可经济高效地扩展到大量节点

主要规格

架构NVIDIA Ada Lovelace
GPU 显存24 GB GDDR6
外形规格Single-slot, low profile
冷却Passive (server airflow)
接口PCIe

Workstation 提供的服务: 我们检查与您现有服务器的兼容性,供应显卡,并配置驱动和推理软件。

价格请询价索取报价 ↗
在 NVIDIA.com 上查看 ↗

网络

NVIDIA Spectrum-X 以太网平台

专为 AI 工厂优化的以太网

Spectrum-X 将 Spectrum 以太网交换机与 Spectrum-X SuperNIC 相结合,为 AI 集群提供可预测的高吞吐量以太网。

适用对象: 希望采用网络团队已熟悉运维方式的 AI 网络的机构

优势

  • GPU 间流量的有效带宽高于标准以太网
  • 沿用熟悉的以太网工具和技能
  • 属于 NVIDIA 经过验证的 AI 工厂设计的一部分

主要规格

类型Ethernet networking platform
组件NVIDIA Spectrum Ethernet switches + Spectrum-X SuperNICs
使用场景AI clusters and AI factories

Workstation 提供的服务: 我们设计网络架构,供应交换机、SuperNIC 和线缆,完成安装和测试,并为您的团队编写文档。

价格请询价索取报价 ↗
在 NVIDIA.com 上查看 ↗

网络

NVIDIA Quantum-X800 InfiniBand 平台

面向大规模训练的新一代 InfiniBand

Quantum-X800 交换机与 ConnectX-8 SuperNIC 组成 NVIDIA 性能最高的 InfiniBand 网络,适用于 AI 训练和 HPC。

适用对象: 开展大规模训练的 HPC 中心和 AI 团队

优势

  • 为紧耦合任务提供极低延迟
  • 专为最大规模的训练和 HPC 集群设计
  • 通过 UFM 进行管理和监控

主要规格

类型InfiniBand networking platform
组件NVIDIA Quantum-X800 InfiniBand switches + ConnectX-8 SuperNICs
使用场景Large-scale AI training and HPC

Workstation 提供的服务: 我们设计拓扑,供应并连接每条链路,并在 UFM 监控就绪的情况下启用网络。

价格请询价索取报价 ↗
在 NVIDIA.com 上查看 ↗

网络

NVIDIA Spectrum 以太网交换机

速率高达 800 Gb/s 的数据中心以太网交换机

Spectrum 交换机承载 AI、存储和云流量,可单独使用,也可作为 Spectrum-X 的一部分。

适用对象: 更新 leaf-spine 交换架构的数据中心和网络团队

优势

  • 端口速率高达 800 Gb/s
  • 适用于 AI 网络和通用数据中心网络
  • 可搭配 NetQ 进行网络运维和遥测

主要规格

类型Ethernet switch family
端口速率Up to 800 Gb/s
用途AI and cloud data-centre fabrics

Workstation 提供的服务: 我们规划端口和光模块,配置交换机,并将其与您的现有网络集成。

价格请询价索取报价 ↗
在 NVIDIA.com 上查看 ↗

网络

NVIDIA Quantum InfiniBand 交换机

面向 HPC 和 AI 的低延迟交换

Quantum InfiniBand 交换机构建 HPC 和 AI 集群所依赖的低延迟网络。

适用对象: 拥有紧耦合工作负载的科研计算和 AI 团队

优势

  • 节点间延迟极低
  • 已在 HPC 和 AI 集群中得到验证
  • 通过 UFM 集中管理

主要规格

类型InfiniBand switch family
用途HPC and AI data centres

Workstation 提供的服务: 我们规划拓扑,供应线缆和光模块,并完成网络的安装与验证。

价格请询价索取报价 ↗
在 NVIDIA.com 上查看 ↗

网络

NVIDIA ConnectX NIC 与 SuperNIC

适用于以太网和 InfiniBand 的网络适配器

ConnectX 适配器将服务器接入网络。ConnectX-8 等 SuperNIC 专为 AI 集群中的 GPU 间流量优化。

适用对象: 需要将 GPU 服务器或存储接入高速网络的用户

优势

  • 同一产品系列覆盖以太网和 InfiniBand
  • SuperNIC 为每个 GPU 提供专属高速通道
  • 硬件卸载降低 CPU 负载

主要规格

类型Network adapter and SuperNIC family
网络类型Ethernet and InfiniBand
最高速率800 Gb/s per GPU (ConnectX-8 SuperNIC)

Workstation 提供的服务: 我们为您的交换机和服务器匹配适配器、线缆和光模块,并安装固件和驱动。

价格请询价索取报价 ↗
在 NVIDIA.com 上查看 ↗

网络

NVIDIA BlueField DPU

面向网络、存储和安全的数据处理器

BlueField DPU 将网络、存储和安全任务从服务器 CPU 上卸载,并在专用硬件中隔离运行。

适用对象: 云构建者、AI 工厂和重视安全的机构

优势

  • 为应用释放 CPU 核心
  • 将基础设施服务与租户工作负载隔离
  • 可通过 NVIDIA DOCA 编程

主要规格

类型Data processing unit (DPU) family
产品代际BlueField-3, BlueField-4
软件NVIDIA DOCA

Workstation 提供的服务: 我们供应并安装 BlueField 卡,并协助您部署所需的 DOCA 服务。

价格请询价索取报价 ↗
在 NVIDIA.com 上查看 ↗

软件

NVIDIA AI Enterprise

面向生产环境 AI 的受支持软件

NVIDIA 的 AI 框架、NIM 微服务和工具套件,提供企业级支持和长期发布分支。

适用对象: 任何在 NVIDIA GPU 上将 AI 投入生产的机构

优势

  • 企业级支持和稳定的发布分支
  • NIM 微服务让模型部署更快捷
  • 可在本地或云端的 NVIDIA-Certified 系统上运行

主要规格

许可方式Per GPU subscription
包含AI frameworks, NIM microservices, pretrained models
支持NVIDIA Enterprise Business Standard Support
试用90-day evaluation

Workstation 提供的服务: 我们提供许可证报价并完成激活,随硬件一同安装软件,并在续订前提醒您。

价格请询价索取报价 ↗
在 NVIDIA.com 上查看 ↗

软件

NVIDIA Mission Control

面向 AI 工厂的运维软件

Mission Control 将大型 GPU 集群的日常运行自动化,涵盖从工作负载编排到健康检查和故障恢复的各个环节。

适用对象: DGX SuperPOD 及其他大型 AI 集群的运营方

优势

  • 自动化日常集群运维
  • 通过检测故障并自动恢复提升系统韧性
  • 统一视图查看工作负载和基础设施

主要规格

类型AI-factory operations and cluster management software
功能Workload orchestration, infrastructure resiliency, cluster automation
许可依据Confirmed on quote

Workstation 提供的服务: 我们随您的集群一同部署 Mission Control,并培训您的运维人员使用。

价格请询价索取报价 ↗
在 NVIDIA.com 上查看 ↗

软件

NVIDIA Run:ai

GPU 编排与调度

Run:ai 将各团队的 GPU 汇集成资源池并按需分配,让昂贵的硬件持续运转而非闲置。

适用对象: 在众多数据科学家或项目之间共享 GPU 的机构

优势

  • 通过动态资源池提升 GPU 利用率
  • 配额、优先级和访问控制,确保公平共享
  • 适用于本地、混合和云环境

主要规格

类型GPU orchestration and scheduling platform
运行平台Kubernetes
部署方式On premises, hybrid or cloud
许可依据Confirmed on quote

Workstation 提供的服务: 我们在您的 Kubernetes 集群上安装 Run:ai,与您的团队一起设置配额,并提供支持。

价格请询价索取报价 ↗
在 NVIDIA.com 上查看 ↗

软件

NVIDIA Base Command Manager

集群配置与监控

Base Command Manager 可对 GPU 集群进行配置、监控和管理,从少量节点起即可使用。

适用对象: 运维各种规模 GPU 集群的 IT 团队

优势

  • 在 Arm 和 x86 上自动化配置
  • 健康仪表板和实时监控
  • Web 界面、命令行和 API

主要规格

类型Cluster management software
免费许可证Up to 8 accelerators per system
当前版本Base Command Manager 11
接口BaseView web UI, CLI, API

Workstation 提供的服务: 我们在构建集群时一并安装和配置 Base Command Manager。

价格请询价索取报价 ↗
在 NVIDIA.com 上查看 ↗

软件

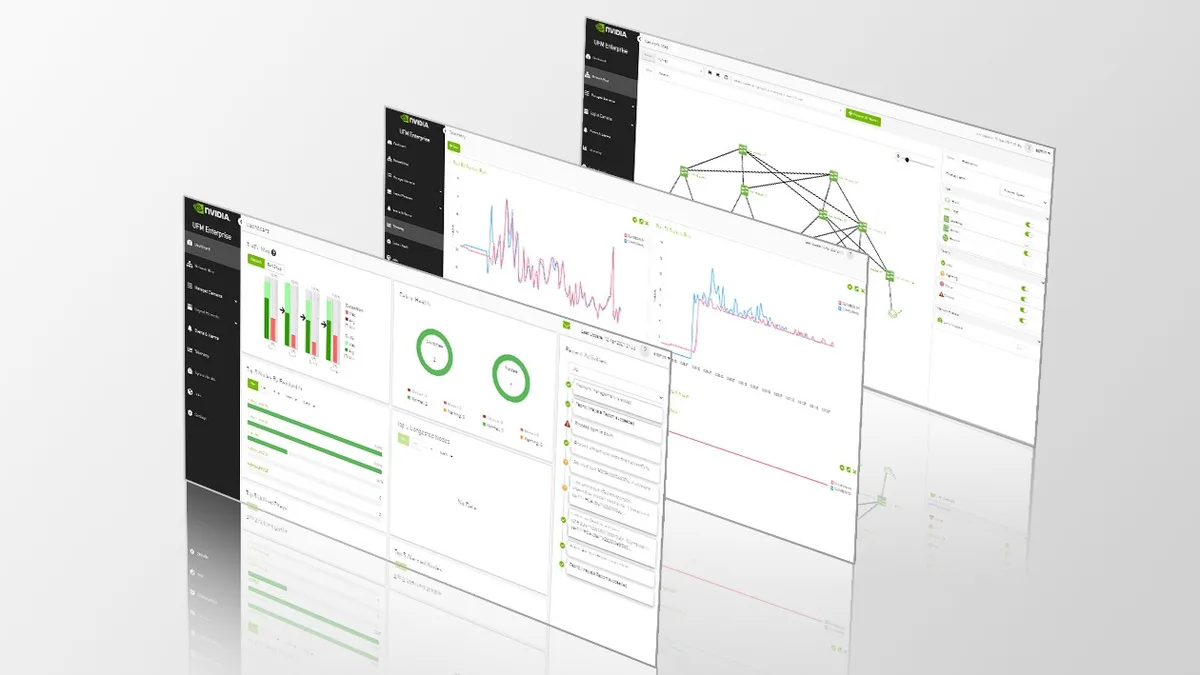
NVIDIA UFM

面向 InfiniBand 的 Unified Fabric Manager

UFM 用于监控、管理 InfiniBand 网络并协助排查故障。

适用对象: 运维 InfiniBand 集群的团队

优势

  • 实时网络遥测
  • 更快定位故障
  • 集中管理交换机和链路

主要规格

类型InfiniBand fabric management and telemetry software
兼容NVIDIA Quantum InfiniBand switches

Workstation 提供的服务: 我们随您的网络一同部署 UFM,并按照您的运维流程设置告警。

价格请询价索取报价 ↗
在 NVIDIA.com 上查看 ↗

软件

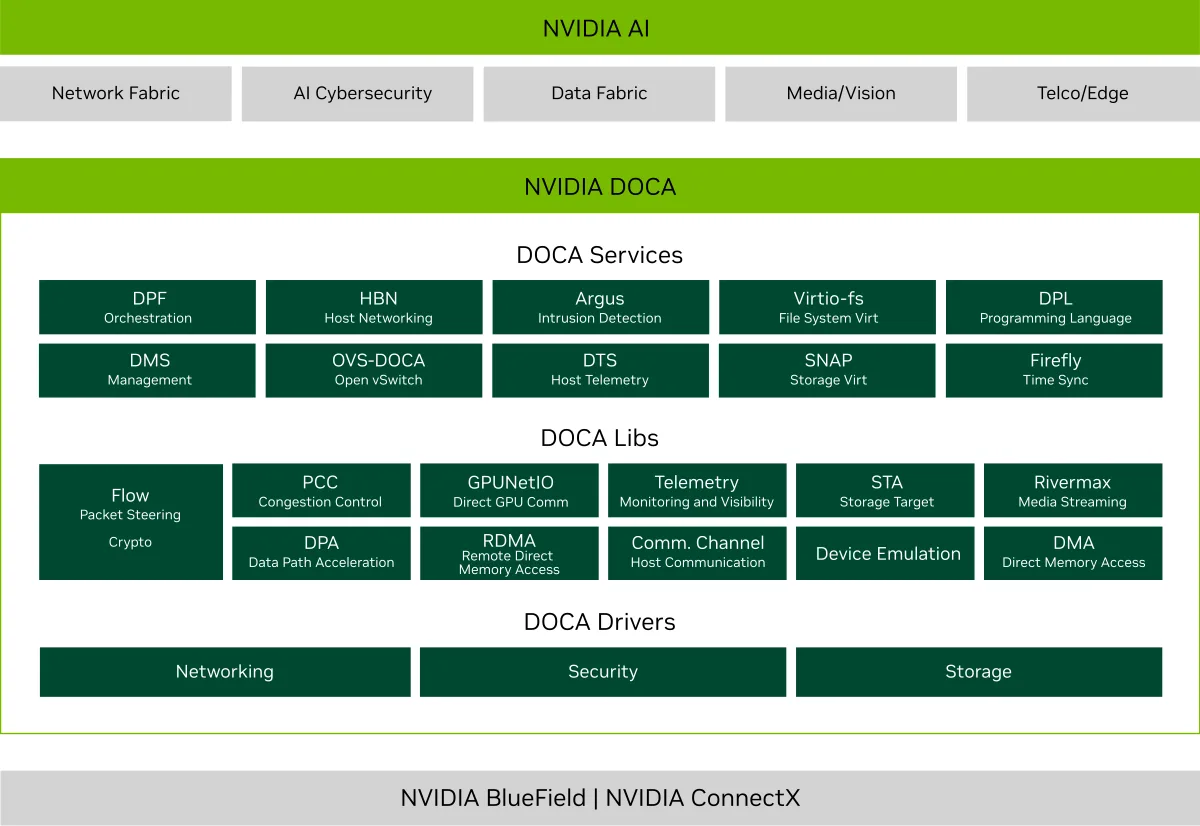
NVIDIA DOCA

面向 BlueField 和 SuperNIC 的软件框架

DOCA 是用于构建在 BlueField DPU 和 SuperNIC 上运行的服务的 SDK 和运行时。

适用对象: 基于 BlueField 进行开发的开发者和平台团队

优势

  • 一个框架覆盖各代 DPU 和 SuperNIC
  • 加快卸载服务的开发
  • 用于在生产环境中部署这些服务的运行时

主要规格

类型SDK and runtime framework
运行平台NVIDIA BlueField DPUs and SuperNICs

Workstation 提供的服务: 我们协助搭建 DOCA 环境,并在我们供应的 BlueField 卡上部署服务。

价格请询价索取报价 ↗
在 NVIDIA.com 上查看 ↗

规格摘自 NVIDIA 公开发布的信息,不同版本之间可能有所变化。标注为“稀疏”的数据基于稀疏性计算。每份报价都会确认具体配置、价格和交付周期。

Workstation 在每笔订单中提供的服务

无论您购买一块 GPU 还是一整排机架,都遵循相同的五个步骤

选型

我们从您的模型、数据、用户和现场出发,规划计算、内存、网络、供电和散热。

供货

我们通过 NVIDIA 及其服务器合作伙伴采购,确认交付周期,并持续向您通报进展直至交付。

组装与老化测试

系统在发货前于我们的英国车间完成组装、镜像部署和满负载压力测试。

安装

我们的工程师现场完成交付、上架、布线和调试,并随附文档进行交接。

支持

同一团队负责处理软件问题、升级、许可证续订和保修索赔。

所有 NVIDIA 类别

Trade 会员

Trade 会员的每笔订单均享受免费技术支持和不限时的工程师服务 — 涵盖配置、驱动、软件和故障排查,只要您仍在使用设备,服务就一直有效。

了解 Trade 会员

NVIDIA Blackwell:从芯片到数据中心

NVIDIA Blackwell: The Journey From Die to Data Center. 通过 NVIDIA 官方 YouTube 频道播放。 在 YouTube 上观看NVIDIA、Blackwell、DGX、Grace 和 RTX PRO 是 NVIDIA Corporation 的商标和/或注册商标。此处仅用于描述我们供应的产品,并不表示获得 NVIDIA 的认可。

See the NVIDIA RTX PRO 6000 Blackwell Server Edition

NVIDIA RTX PRO: AI and visual computing on the RTX PRO 6000 Blackwell Server Edition. Video: NVIDIA Corporation. 通过 NVIDIA 官方 YouTube 频道播放。 在 YouTube 上观看Read about the RTX PRO 6000 Server Edition →NVIDIA, RTX PRO and Blackwell are trademarks and/or registered trademarks of NVIDIA Corporation. Shown to describe the products we supply; no endorsement by NVIDIA is implied.

常见问题

为什么所有产品都需要询价?

加速计算的价格和供货配额变化很快,而且大多数订单取决于具体配置、现场条件和软件。通过报价,我们可以针对您的实际需求确认当前价格、供货情况和交付周期。

能否只供应单块 GPU,而不是整套系统?

可以。我们供应单块数据中心 GPU,但始终会确认您的服务器已获认证、能够为其供电和散热,我们也可以为您完成安装和测试。

你们是否安装机架级和液冷系统?

是的。对于 GB300 NVL72 等系统,我们会在交付前很早就与您的设施团队就供电、散热和地板承重展开协作,然后在现场完成安装和调试。

我们应从哪种 NVIDIA 平台起步?

这取决于您的模型、用户和现场。许多团队先从 RTX PRO Server 或 L40S 起步,兼顾 AI 和图形混合负载,再转向 HGX 或 DGX 进行大规模训练。咨询我们的工程师,我们将为您推荐合适的起点。

规划您的 NVIDIA 加速计算项目

告诉我们您需要运行什么、部署在哪里。工程师将回复您推荐配置和报价。

咨询工程师