
揭示 LLM 瓶颈:可观测性、OTEL 和成本控制
业务简介:OpenTelemetry、Prometheus/Grafana、Langfuse — 优点、缺点、成本以及可削减代理支出的使用指标
 Balinder Walia2026年9月4日1 min read
Workstation业务简介:通过可观察性发现 LLM 和代理瓶颈 — OpenTelemetry、Prometheus/Grafana/Thanos 和 LLM 平台(例如 Langfuse) — 这样您就可以削减成本、收紧 SLO 并向代理提供证据。深入探讨:长篇技术文章(OTEL、FinOps、代理预算)。相关:涡轮增压 LLMs·企业人工智能实验室。
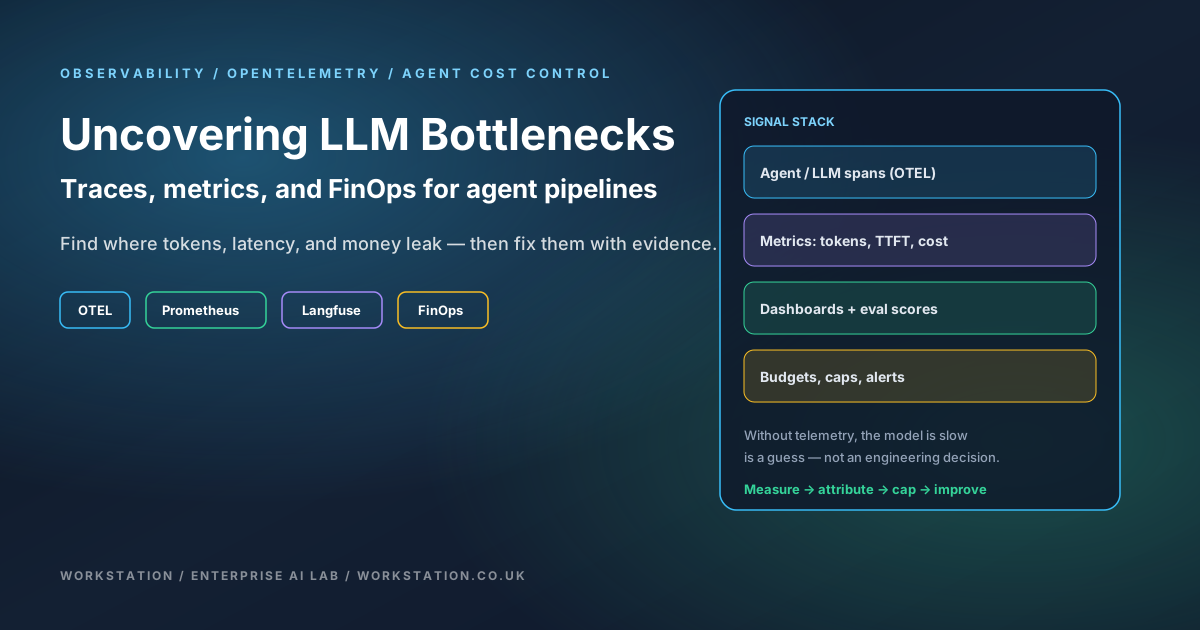
底线。大多数“慢人工智能”问题并不是神秘的模型故障——它们缺少归因。仪器代理与 OpenTelemetry 一起运行,对输出进行评分,使用租户/模型/路线/令牌/成本标记每个调用,并执行预算。执行此操作的团队通常会在第一个测量周期内发现 20-50% 的浪费在于重试、过大的模型和未缓存的提示。
为什么瓶颈会在没有遥测的情况下隐藏
LLM 代理链提示、工具、RAG 检索和重试。跨跃点的延迟和花费复合。 如果没有跨度和指标,您就无法判断瓶颈是模型、向量存储、不稳定的工具还是无限的自调试循环。然后,业务利益相关者过度购买 GPU 或 API 配额,而产品质量却保持不变。
Workstation 对 AI 资产的立场:像对待任何其他生产服务一样对待代理管道 —可观察性首先,然后优化服务(请参阅PagedAttention / vLLM),然后按纪律进行推广(Ring Promoter)。
物有所值的可观察性堆栈
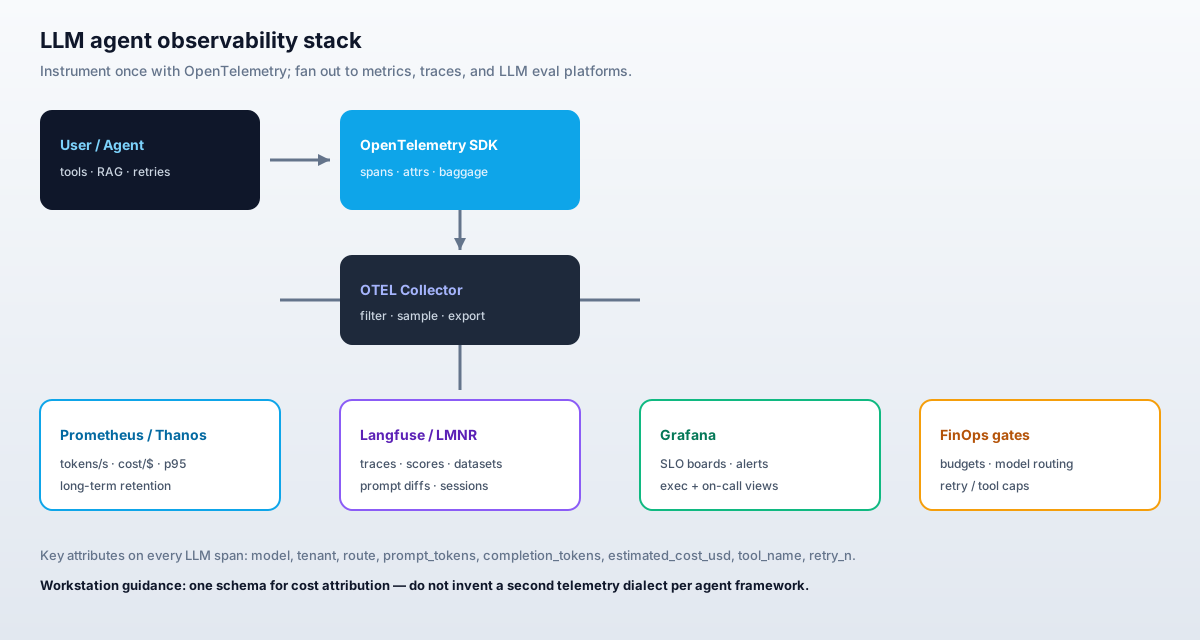
- OpenTelemetry (OTEL)— 用于跟踪、指标和(如果有用)日志的一个仪器层。导出至收集器;扇出到后端。
- Prometheus + Grafana (+ Thanos)— 黄金信号:请求率、错误率、延迟、代币吞吐量、估计/请求美元、GPU 利用率。 Thanos(或同等机构)保留 FinOps 审核的长期指标。
- LLM 可观测平台(例如Langfuse、LMNR) — 会话/跟踪 UI、提示版本、人工和跟踪版本自动评分、回归数据集。
这种方法的优点和缺点
| 尺寸 | 优点 | 缺点/权衡 |
|---|---|---|
| 成本控制 | 将支出归因于租户、功能、型号和代理步骤;消除浪费的重试。 | 仪器的工程时间;如果保留是幼稚的,则痕迹的存储成本。 |
| 质量 | 分数 + 数据集在客户之前捕获即时回归。 | 自动评分可能会很吵;关键路径仍然需要人类。 |
| 操作 | 与其他微服务相同的 OTEL/Prometheus 技能集。 | LLM 特定 UI(Langfuse 等)添加另一个要运行或购买的产品。 |
| 合规性 | 审计谁调用了哪个型号,哪个提示版本。 | 提示/PII 保留策略必须预先设计。 |
| 实现价值的速度 | 如果您已经运行 Grafana,几天后就会出现第一个仪表板。 | 跨多代理图的完整成本归因需要更长的时间。 |
成本:您花费的费用与您节省的费用
仪器成本(典型的中型代理平台):
- 1-2 工程师周采用 OTEL 跨度约定 + 出口接线。
- 收集器 + 指标保留:一旦调整采样,通常小于每月 LLM API/GPU 支出的 5-10%。
- 可选 SaaS LLM 可观测性:按事件/跟踪定价 — 将其预算为模型支出的百分比,而不是事后的想法。
节省杠杆(推动使用指标):
- 每个成功任务的令牌— 不是每个原始调用的令牌。限制工具循环和自调试轮次。
- 每成功任务的成本— 路由廉价模型进行分类/路由;为艰难的步骤保留前沿模型。
- 缓存命中率— 提示/前缀缓存安全;衡量正确性,而不仅仅是延迟。
- 重试率&死信率— 脆弱的工具伪装成“模型质量”问题。
- p95 TTFT 和端到端延迟— 在削减支出的同时保护用户体验。
经验法则。如果您无法回答“该代理上周按客户分步花费了多少费用?”你还没有准备好扩展使用——你已经准备好给财务带来惊喜了。
评分:手动与自动
| 方法 | 何时使用 | 商务笔记 |
|---|---|---|
| 手动评分 | 黄金套装、规范答案、品牌敏感副本。 | 价格昂贵,但具有自动判断功能。 |
| 自动评分 | 大容量回归、LLM 作为判断、标题检查。 | 规模便宜;每月针对人类进行校准。 |
迁移手册(从小处开始)
- 仪器一条具有 OTEL + 令牌/成本属性的端到端生产代理路径。
- 运送 Grafana 板,以衡量速率/错误/延迟/成本/成功。
- 添加 Langfuse(或同等版本)以获取该路径上的提示版本和分数。
- 强制实施硬上限:最大令牌数、最大工具调用数、每个会话的最大重试次数。
- 仅在第一条路径显示测量的成本或延迟优势后才扩展到下一个代理。
观察:为什么可观察性对于 AI 系统很重要
关于可观察性文化的上下文讨论 — 不是 Workstation 产品演示。与OpenTelemetry 文档和Workstation 技术文章配对。
读取下一个
- 长文— OTEL 跨架构、收集器、成本公式、代理上限、Langfuse/LMNR 注释。
- Turbocharging LLMs— 您可以看到服务端瓶颈。
- 本地代理·企业人工智能实验室·联系方式 Workstation
由Workstation发布。参考文献:langfuse/langfuse·lmnr-ai/lmnr·OpenTelemetry。