
Workstation 技术简介:如何发现 LLM 和多代理瓶颈 开放式遥测、Prometheus/Grafana/Thanos 和 LLM 平台等 朗福斯 / LMNR — 包括跨度模式、成本归因、采样和硬使用上限。伴侣: 商业博客 · 服务: 涡轮增压 LLMs · 实验室: 企业人工智能实验室.
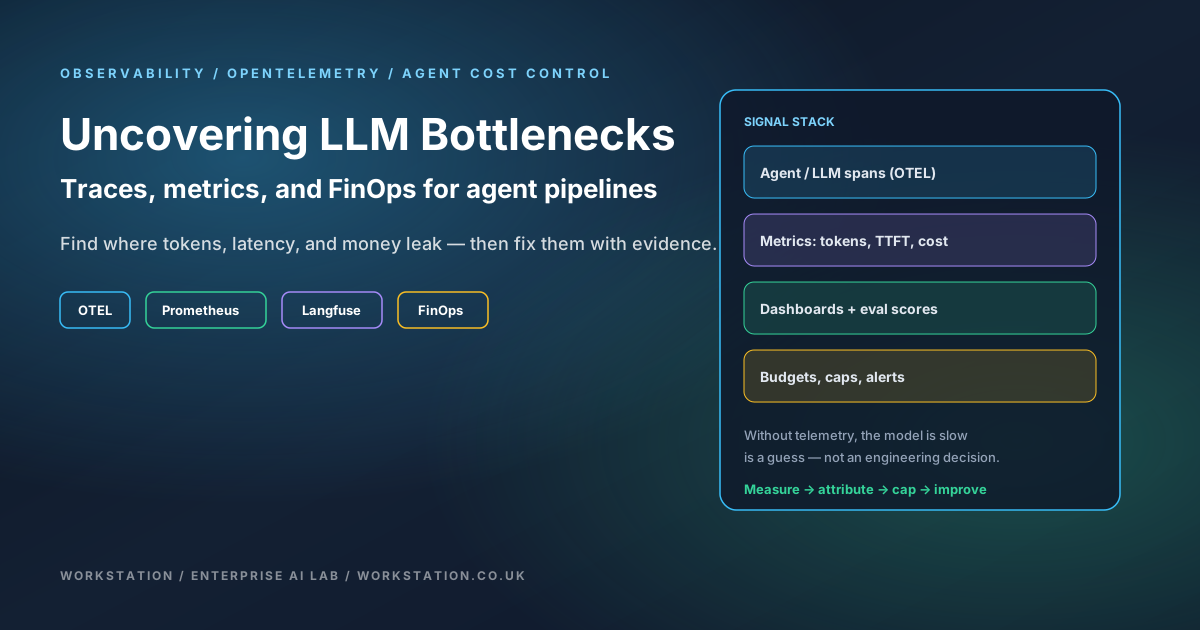
- 问题: 代理成本和延迟隐藏在跳数中(LLM→工具→RAG→重试),而不是在单个“模型慢”指标中。
- 标准: 带有 OpenTelemetry 的仪器;令牌、模型、租户、路线、estimated_cost_usd 的一种属性模式。
- 指标路径: 普罗米修斯(+灭霸)用于黄金信号;适用于 SLO 和 FinOps 委员会的 Grafana。
- LLM路径: Langfuse/LMNR 用于跟踪、分数、数据集、提示版本。
- 控制: 限制代币、工具调用和调试轮次;按步骤难度路由模型。
- 赢: 在购买更多 GPU 或提高 API 配额之前,先衡量每成功任务的成本。
1. LLM 代理的“瓶颈”意味着什么
训练时间瓶颈(数据、FLOP)与服务时间不同, 代理时间 瓶颈。在生产代理中,主要的浪费方式是:
- 迅速膨胀 — 过大的系统提示、未重用的上下文、缺少前缀/缓存命中。
- 模型杀伤力过大 - 用于小模型可以执行的分类/路由步骤的前沿模型。
- 无界循环 — 工具重试和自调试周期,无需硬预算(请参阅 Self-Debugging 权衡 涡轮增压 LLMs).
- 外部等待 — 矢量 DB、SaaS API 和人机交互门被错误归因于“LLM 延迟”。
- 服务碎片化 — 在您确认代理图正常后,GPU(PagedAttention/vLLM 区域)上的 KV 缓存浪费。
如果没有分布式跟踪,您就无法将它们分开。因此,可观察性并不是一个可有可无的仪表板——它是人工智能产品上 FinOps 和 SRE 的控制平面。
2. 参考架构
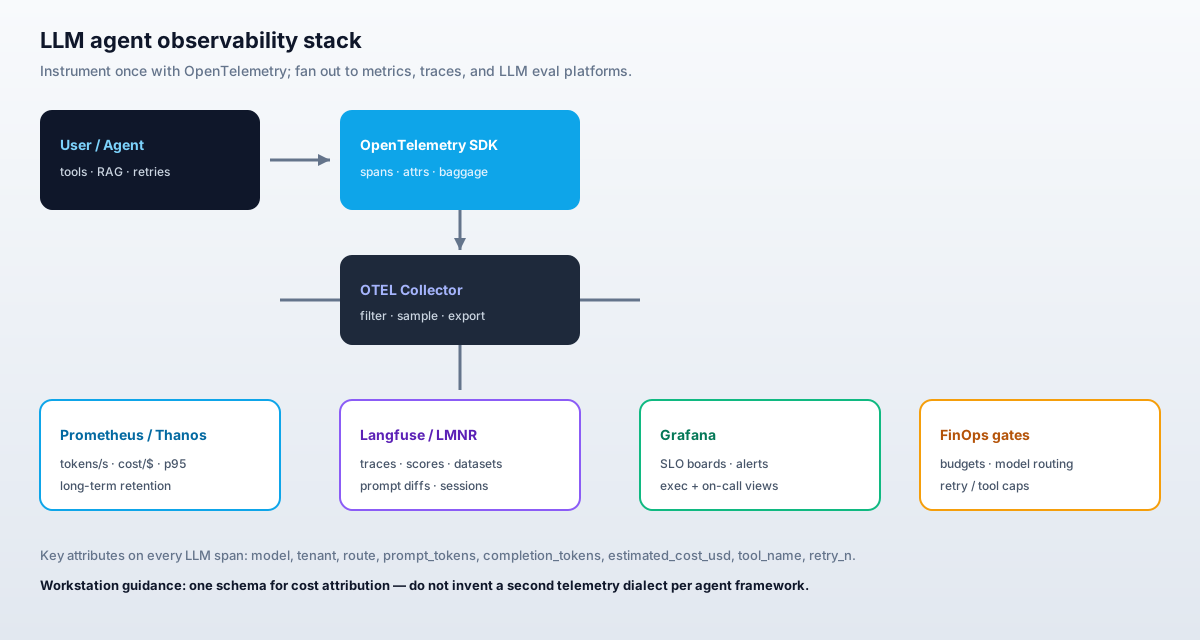
User / Orchestrator
    → Agent runtime (tools, RAG, LLM calls)
        → OpenTelemetry SDK (spans + metrics)
            → OTEL Collector (filter, sample, redact)
                ├─→ Prometheus / Thanos   (rates, costs, SLOs)
                ├─→ Grafana              (boards, alerts)
                └─→ Langfuse / LMNR      (traces, scores, datasets)
FinOps / policy layer reads the same metrics to enforce caps and model routing.
3. LLM 调用的 OpenTelemetry 跨架构
跨框架(LangChain、自定义 Go/Python 代理、Bedrock SDK)采用一种约定。优先选择存在的语义约定,并使用稳定的 Workstation 属性进行扩展:
| 属性 | 例子 | 为什么 |
|---|---|---|
gen_ai.system | openai / 人类 / 基岩 / vllm | 提供商汇总 |
gen_ai.request.model | 克劳德十四行诗-4 / llama-3.1-8b | 按型号划分的成本和质量 |
gen_ai.usage.input_tokens | 1820 | 即时成本动因 |
gen_ai.usage.output_tokens | 410 | 竣工成本动因 |
wsw.estimated_cost_usd | 0.0124 | FinOps 无需稍后加入价格表 |
wsw.tenant_id | acme-产品 | 退款 |
wsw.route | 支持.分类 | 产品特征归因 |
wsw.agent_step | 计划/工具/批评 | 寻找昂贵的步骤 |
wsw.retry_n | 2 | 环路检测 |
wsw.prompt_version | 分类@v17 | 回归联动 |
from opentelemetry import trace
from opentelemetry.trace import Status, StatusCode

tracer = trace.get_tracer("workstation.agents")

PRICE_IN = 0.003 / 1000   # example $/token — load from config
PRICE_OUT = 0.015 / 1000

def complete_llm(model: str, prompt: str, tenant: str, route: str):
    with tracer.start_as_current_span("gen_ai.chat") as span:
        span.set_attribute("gen_ai.system", "openai")
        span.set_attribute("gen_ai.request.model", model)
        span.set_attribute("wsw.tenant_id", tenant)
        span.set_attribute("wsw.route", route)
        try:
            resp = client.chat.completions.create(
                model=model,
                messages=[{"role": "user", "content": prompt}],
            )
            usage = resp.usage
            cost = usage.prompt_tokens * PRICE_IN + usage.completion_tokens * PRICE_OUT
            span.set_attribute("gen_ai.usage.input_tokens", usage.prompt_tokens)
            span.set_attribute("gen_ai.usage.output_tokens", usage.completion_tokens)
            span.set_attribute("wsw.estimated_cost_usd", round(cost, 6))
            return resp.choices[0].message.content
        except Exception as e:
            span.record_exception(e)
            span.set_status(Status(StatusCode.ERROR, str(e)))
            raise
实践: 计算 estimated_cost_usd 在跨度处。不要等到夜间工作才将代币计数加入到价格表中——随叫随到的产品所有者需要实时的 FinOps。
3b.多代理跨度层次结构和行李
代理图需要稳定的父/子模型,以便成本正确累积:
session (root)
  └─ agent.run {wsw.route, wsw.tenant_id}
       ├─ rag.retrieve {wsw.agent_step=retrieve}
       ├─ gen_ai.chat {wsw.agent_step=plan, model=…}
       ├─ tool.execute {tool=…, wsw.retry_n}
       ├─ gen_ai.chat {wsw.agent_step=synthesize}
       └─ eval.score {score.name, score.value}
- 每个用户一个 root 任务 — 不是每次 LLM 调用。会话成本 = 子进程总和
wsw.estimated_cost_usd. - 行李 — 传播
wsw.tenant_id和wsw.route跨异步工作人员/队列,因此工具跨度继承退款标签,而无需重新连接每个调用站点。 - 链接 - 当子代理启动新跟踪(例如单独的队列消费者)时,使用跨度链接返回父会话,以便 Langfuse/Grafana 仍然可以缝合图表。
- 始终提供样品成本高 — 5-20% 的头部采样对于快乐路径来说是合适的;当会话支出超过阈值或状态=错误时强制采样。
4. 重要的指标(普罗米修斯)
导出直方图和计数器(通过 OTEL 指标或 Prometheus 客户端)。最小可行集:
llm_requests_total{model,route,status}llm_tokens_total{model,direction}其中方向 ∈ {输入,输出}llm_estimated_cost_usd_total{model,tenant,route}llm_ttft_seconds/llm_e2e_seconds直方图agent_tool_calls_total{tool,status}agent_retries_total{route}agent_task_success_total{route}— 每次成功成本的分母
派生的 FinOps 查询(PromQL 草图):
# Cost per successful task (last 1h), by route
sum(rate(llm_estimated_cost_usd_total[1h])) by (route)
  /
sum(rate(agent_task_success_total[1h])) by (route)

# Retry tax
sum(rate(agent_retries_total[1h])) by (route)
  /
sum(rate(llm_requests_total[1h])) by (route)
灭霸 当财务部门要求季度模型支出时,(或 Mimir/Cortex)很重要。仅本地 Prometheus 就可以满足 on-call;它不是 FinOps 档案。
5. Grafana 面板和警报
从一个数据源运送三位受众:
- 待命: 错误率、p95 e2e、依赖性故障(向量 DB/工具)。
- 平台: 令牌/秒、GPU util(如果自托管)、队列深度、TTFT。
- 金融运营/产品: 按租户和路线、最昂贵的提示、模型组合划分的美元/成功。
警惕烧伤,而不是虚荣:
- 每次成功成本 > 30m 的预算 SLO
- 路由重试率 > 15%
- p95 e2e 漏洞,输入令牌不断增加(迅速回归)
6. LLM原生平台:Langfuse、LMNR和朋友
指标告诉你 那 成本飙升; LLM平台告诉你 哪个提示版本 和 哪个工具跨度 做到了。 朗福斯 和 LMNR 是此类的开源示例:
- 分层跟踪(会话→代理→LLM/工具跨度)
- 人类和 LLM 作为评委的分数
- 更改提示时用于离线评估的数据集
- 用于产品改进的可选使用遥测(尊重隐私政策)
整合模式:保留OTEL作为SRE的记录系统;双导出或桥接到 Langfuse 以进行快速工程。不要发明第二个不兼容的属性字典。
诸如功能优先的代理运行时(历史上围绕结构化流代理进行营销)之类的框架实验可以减少样板文件,但将利基框架视为可选的——可观察性标准比它们更长寿。
7. 评分管道:手动与自动
| 方法 | 执行 | 失效模式 |
|---|---|---|
| 手动的 | Langfuse UI 中的拇指/评分标准;黄金套装评论。 | 不扩展;仍需要校准。 |
| 自动的 | LLM-作为法官、单元检查、模式验证器、检索召回。 | 判断漂移;游戏如果只针对法官进行优化。 |
将分数附加为跨度事件或键入的 Langfuse 分数 wsw.prompt_version。以与控制应用程序版本相同的方式控制提示的促销 — 用于代码的 Ring Promoter;评估门的提示。
8. 节省成本的流程(详细)
- 基线周: 没有行为改变;只有仪器仪表。捕获 $/成功、令牌/成功、重试率。
- 归因: 按支出×交易量对路线进行排名。选出前三名。
- 模型路由: 将分类/提取拆分为小型/局部模型;保持综合前沿。重新测量质量分数。
- 及时手术: 删除未使用的工具模式;缩短几次镜头;在安全的情况下启用前缀缓存。
- 循环帽: 最大工具调用、最大自调试轮数、断路器的指数退避。
- 采样: 保持 100% 指标;样本跟踪(例如 5-20%)以及针对错误和高成本会话的始终在线采样。
- 密文: 导出前从跨度属性中去除 PII;仅在经过 TTL 批准的商店中存储完整提示。
- 审核节奏: 每周 FinOps 委员会;每月对人类进行法官校准。
8b.通过实时预算管理代理使用情况
仅靠仪表板并不能阻止失控的特工。在运行时执行预算,将决策作为跨度事件发出,并在会话经常达到上限时发出警报:
# Pseudocode: hard budget around an agent session
class Budget:
    def __init__(self, max_usd=0.50, max_tool_calls=8, max_llm_calls=12):
        self.max_usd, self.max_tool_calls, self.max_llm_calls = max_usd, max_tool_calls, max_llm_calls
        self.spent = 0.0
        self.tools = self.llms = 0

    def charge(self, usd: float, kind: str):
        self.spent += usd
        if kind == "tool":
            self.tools += 1
        else:
            self.llms += 1
        if self.spent > self.max_usd or self.tools > self.max_tool_calls or self.llms > self.max_llm_calls:
            raise RuntimeError("agent budget exhausted")
- 每会话上限 — 美元、LLM 调用、工具调用(上图)。
- 每租户每日配额 — Redis/计数器由
wsw.tenant_id;当筋疲力尽时返回受控的退化路径。 - 每条路线模型策略 — 允许名单模型
support.triage与legal.draft;拒绝或降低政策失误和记录wsw.policy_action=downshift. - 幂等工具键 — 哈希工具参数,因此重试不会对外部 API 进行双重计费。
- 成本公式 —
cost = in_tokens × p_in + out_tokens × p_out + tool_fees;刷新p_in/p_out来自版本化的价格表,因此灭霸的历史数据保持可比性。
上限落地后要观察的指标: agent_budget_exhausted_total{route,reason}。峰值意味着滥用、工具循环中断或预算对于实际工作负载来说太紧张。
9. 收集器配置示意图
# otel-collector-config.yaml (illustrative)
receivers:
  otlp:
    protocols:
      http:
      grpc:
processors:
  memory_limiter: {}
  batch: {}
  attributes/redact:
    actions:
      - key: gen_ai.prompt
        action: delete
exporters:
  prometheus:
    endpoint: "0.0.0.0:8889"
  otlp/langfuse:
    endpoint: "${LANGFUSE_OTLP_ENDPOINT}"
    headers:
      Authorization: "Bearer ${LANGFUSE_KEY}"
service:
  pipelines:
    traces:
      receivers: [otlp]
      processors: [memory_limiter, attributes/redact, batch]
      exporters: [otlp/langfuse]
    metrics:
      receivers: [otlp]
      processors: [memory_limiter, batch]
      exporters: [prometheus]
10. 优点、缺点以及何时不需要打扰
优点: 退款、更快的事件分类、提示/模型更改的可衡量投资回报率、合规性友好的审计跟踪、机器学习和平台团队之间的共享语言。
缺点: 仪表债务;如果您永远保留每个提示,则存储成本;将 PII 传送到错误后端的风险;另一个供工程师学习的控制台。
如果出现以下情况,请跳过(暂时): 您有一个离线批处理作业,每日支出固定,并且没有交互式代理。仍然记录令牌;跳过完整的多后端堆栈,直到出现并发。
11. 迁移清单
- ☐ 代理运行时中的 OTEL SDK;集群中的收集器
- 跨度属性包括模型、代币、成本、租户、路线
- ☐ Prometheus 指标 + Grafana FinOps 板
- ☐ Langfuse(或 LMNR)至少连接一条关键路径
- ☐ 代币/工具/重试的硬性上限
- ☐ 安全部门审查的编辑政策
- 每周审查热门路线的美元/成功
- ☐ 记录 ADR 链接可观察性 → 服务 (vLLM) → 促销 (Ring Promoter)
12.Workstation相关材料
- 商业博客伴侣
- 涡轮增压 LLMs — 在看到瓶颈后修复服务
- Ring Promoter — 通过健康门推广代理服务
- Muse Glimmer / 当地代理
- 联系Workstation 企业人工智能实验室参与
参考
发布者: Workstation.


