
Loading blogs...
Posts tagged MLOps.
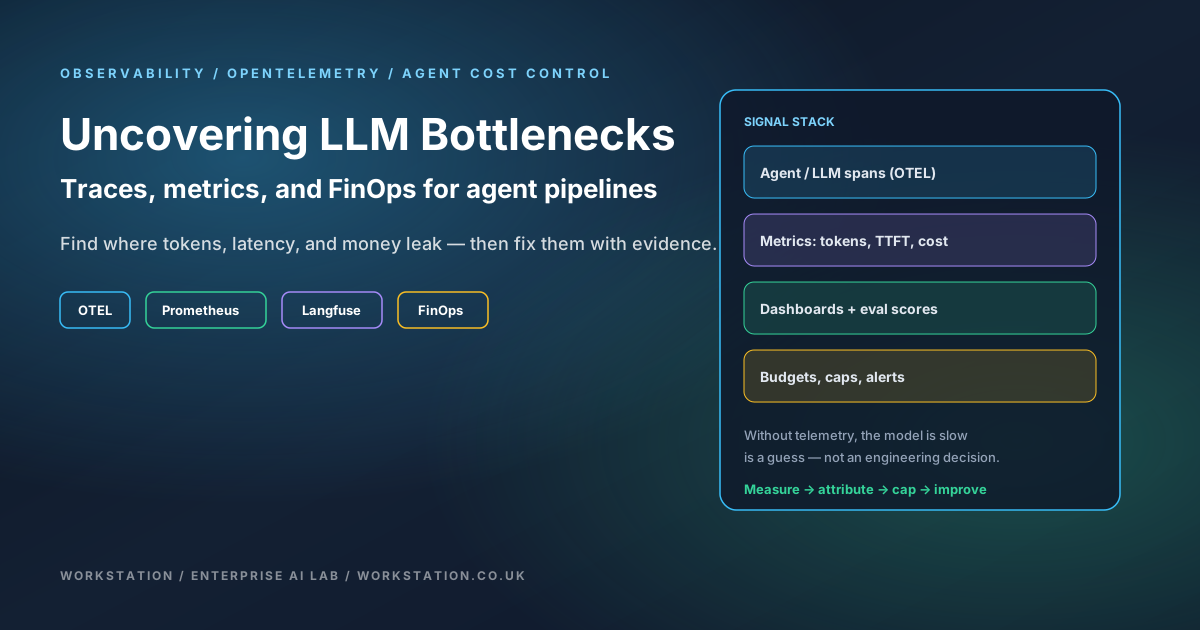
Workstation pour découvrir les goulots d'étranglement des agents LLM avec observabilité : OpenTelemetry, Prometheus/Grafana/Thanos, Langfuse — avec des avantages/inconvénients clairs, des leviers de coûts et des mesures d'utilisation qui protègent les marges.
 Balinder WaliaRead

Workstation sur turbocompresseur LLMs : pagination PagedAttention pour le cache KV, service vLLM, Self-Debugging pour les agents, taux de jetons PowerInfer et réductions de mémoire EG-MLA – avec des compromis de production.
Balinder WaliaRead 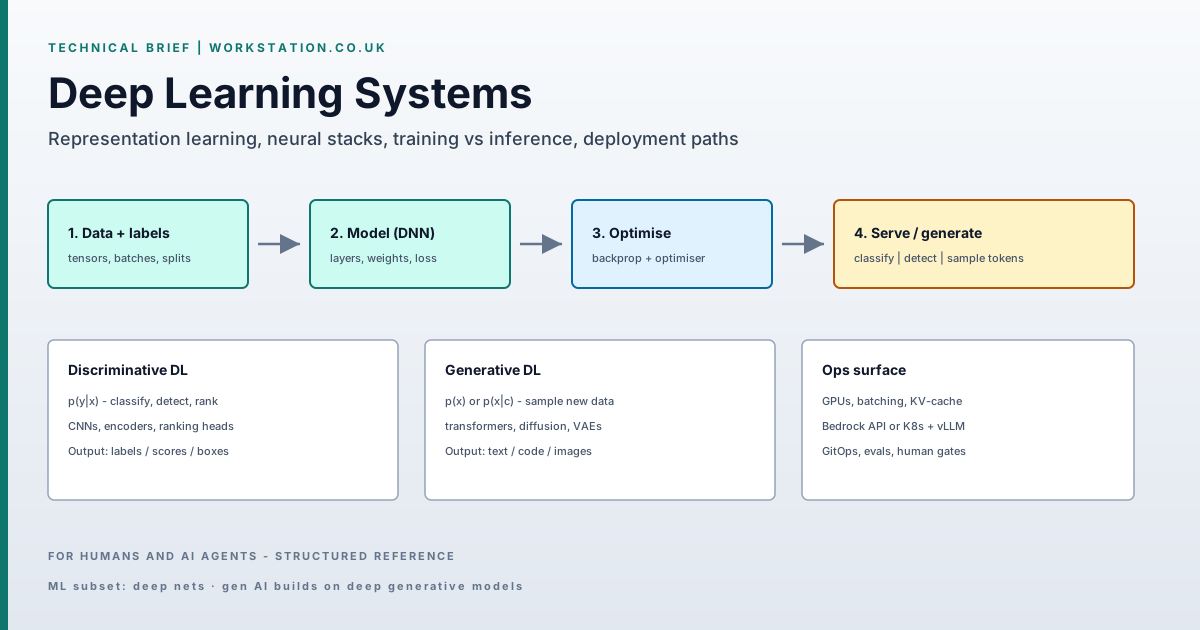
Brief technique Workstation sur le deep learning : réseaux profonds entraînés par gradient, modèles discriminatifs vs génératifs, métriques de tâche, et Bedrock vs serving Kubernetes.
Balinder WaliaRead 
Kimi K3 pousse les modèles open-weight vers le territoire des agents de frontière. Ce qui change pour les développeurs, le serving vLLM, MCP, et les conseils production Workstation.
Balinder WaliaRead 
Mettre en œuvre Amazon Bedrock, Bedrock AgentCore, SageMaker et Amazon Q, puis lancer un premier agent métier dans Microsoft Teams — avec exigences, outillage et créneaux temporels.
Balinder WaliaRead 
Associez Kubeflow et Argo CD pour le MLOps sur Kubernetes : entraînez et enregistrez les modèles dans Kubeflow, promouvez les InferenceServices en GitOps, rollback avec git revert.
Balinder WaliaRead 
Que sont les grands modèles linguistiques et comment fonctionnent-ils ? Un explicatif clair et non technique pour les gestionnaires et les ingénieurs (jetons, intégrations, transformateurs, formation et inférence) ainsi que le YAML Kubernetes de production pour déployer votre propre LLM avec Ollama et vLLM.
Balinder WaliaRead