Workstation 技術簡介:如何發現 LLM 和多代理瓶頸 開放式遙測、Prometheus/Grafana/Thanos 和 LLM 平臺等 朗福斯 / LMNR — 包括跨度模式、成本歸因、取樣和硬使用上限。伴侶: 商業部落格 · 服務: 渦輪增壓 LLMs · 實驗室: 企業人工智慧實驗室.
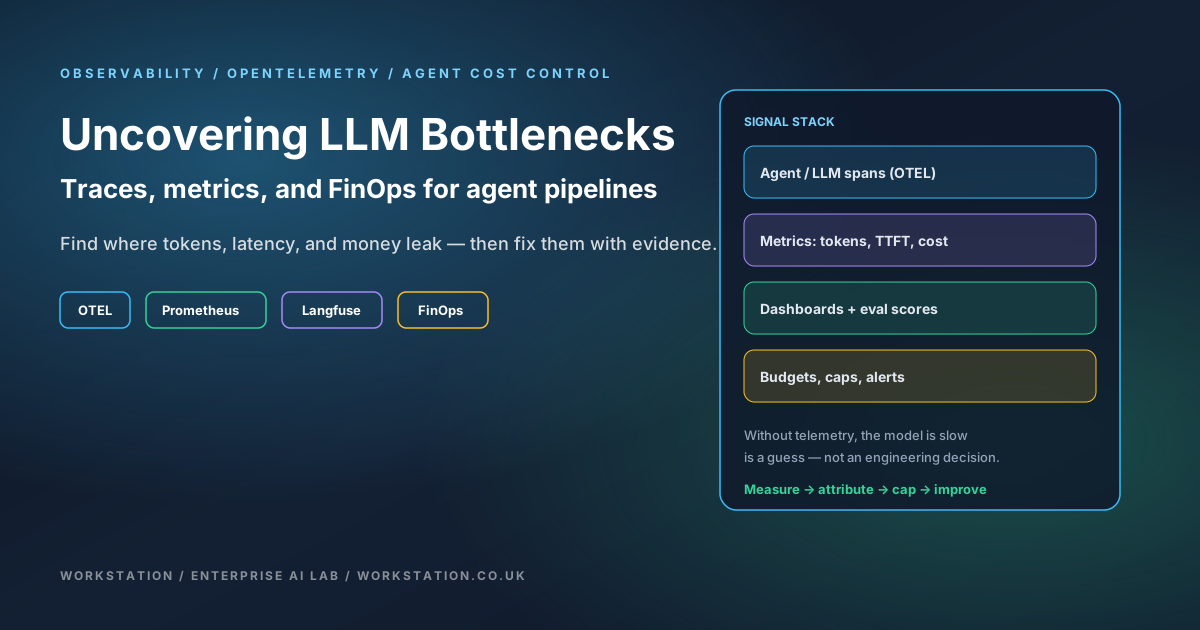
- 問題: 代理成本和延遲隱藏在跳數中(LLM→工具→RAG→重試),而不是在單個“模型慢”指標中。
- 標準: 帶有 OpenTelemetry 的儀器;令牌、模型、租戶、路線、estimated_cost_usd 的一種屬性模式。
- 指標路徑: 普羅米修斯(+滅霸)用於黃金訊號;適用於 SLO 和 FinOps 委員會的 Grafana。
- LLM路徑: Langfuse/LMNR 用於跟蹤、分數、資料集、提示版本。
- 控制: 限制代幣、工具呼叫和除錯輪次;按步驟難度路由模型。
- 贏: 在購買更多 GPU 或提高 API 配額之前,先衡量每成功任務的成本。
1. LLM 代理的“瓶頸”意味著什麼
訓練時間瓶頸(資料、FLOP)與服務時間不同, 代理時間 瓶頸。在生產代理中,主要的浪費方式是:
- 迅速膨脹 — 過大的系統提示、未重用的上下文、缺少字首/快取命中。
- 模型殺傷力過大 - 用於小模型可以執行的分類/路由步驟的前沿模型。
- 無界迴圈 — 工具重試和自除錯周期,無需硬預算(請參閱 Self-Debugging 權衡 渦輪增壓 LLMs).
- 外部等待 — 向量 DB、SaaS API 和人機互動門被錯誤歸因於“LLM 延遲”。
- 服務碎片化 — 在您確認代理圖正常後,GPU(PagedAttention/vLLM 區域)上的 KV 快取浪費。
如果沒有分散式跟蹤,您就無法將它們分開。因此,可觀察性並不是一個可有可無的儀表板——它是人工智慧產品上 FinOps 和 SRE 的控制平面。
2. 參考架構
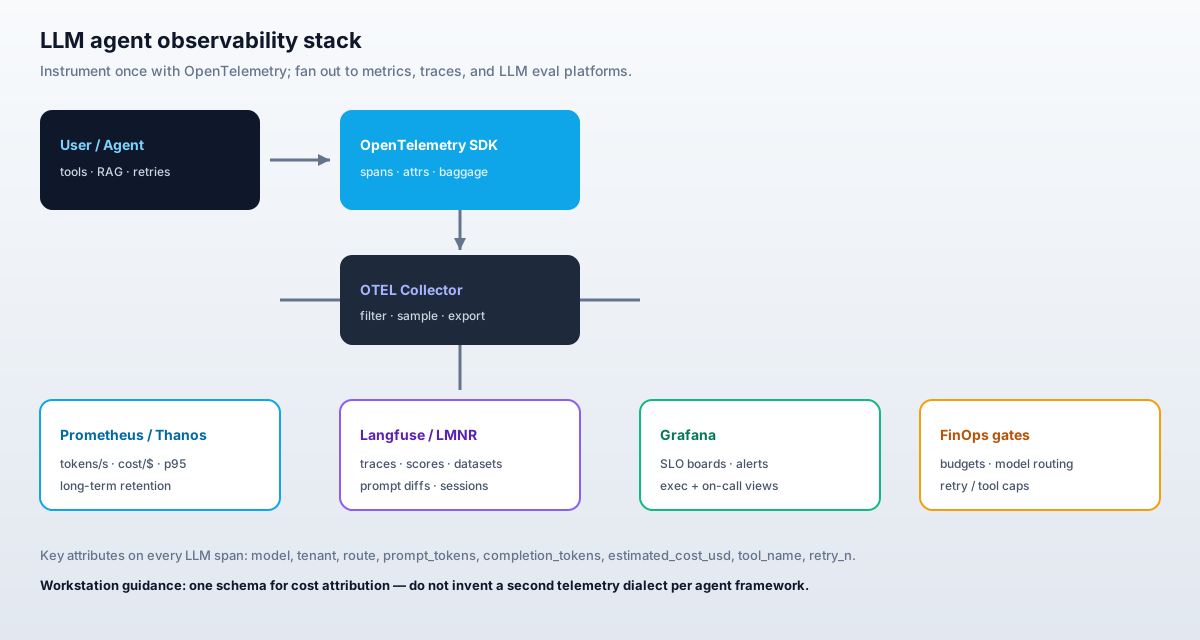
User / Orchestrator
    → Agent runtime (tools, RAG, LLM calls)
        → OpenTelemetry SDK (spans + metrics)
            → OTEL Collector (filter, sample, redact)
                ├─→ Prometheus / Thanos   (rates, costs, SLOs)
                ├─→ Grafana              (boards, alerts)
                └─→ Langfuse / LMNR      (traces, scores, datasets)
FinOps / policy layer reads the same metrics to enforce caps and model routing.
3. LLM 呼叫的 OpenTelemetry 跨架構
跨框架(LangChain、自定義 Go/Python 代理、Bedrock SDK)採用一種約定。優先選擇存在的語義約定,並使用穩定的 Workstation 屬性進行擴充套件:
| 屬性 | 例子 | 為什麼 |
|---|---|---|
gen_ai.system | openai / 人類 / 基岩 / vllm | 提供商彙總 |
gen_ai.request.model | 克勞德十四行詩-4 / llama-3.1-8b | 按型號劃分的成本和質量 |
gen_ai.usage.input_tokens | 1820 | 即時成本動因 |
gen_ai.usage.output_tokens | 410 | 竣工成本動因 |
wsw.estimated_cost_usd | 0.0124 | FinOps 無需稍後加入價格表 |
wsw.tenant_id | acme-產品 | 退款 |
wsw.route | 支援.分類 | 產品特徵歸因 |
wsw.agent_step | 計劃/工具/批評 | 尋找昂貴的步驟 |
wsw.retry_n | 2 | 環路檢測 |
wsw.prompt_version | 分類@v17 | 迴歸聯動 |
from opentelemetry import trace
from opentelemetry.trace import Status, StatusCode

tracer = trace.get_tracer("workstation.agents")

PRICE_IN = 0.003 / 1000   # example $/token — load from config
PRICE_OUT = 0.015 / 1000

def complete_llm(model: str, prompt: str, tenant: str, route: str):
    with tracer.start_as_current_span("gen_ai.chat") as span:
        span.set_attribute("gen_ai.system", "openai")
        span.set_attribute("gen_ai.request.model", model)
        span.set_attribute("wsw.tenant_id", tenant)
        span.set_attribute("wsw.route", route)
        try:
            resp = client.chat.completions.create(
                model=model,
                messages=[{"role": "user", "content": prompt}],
            )
            usage = resp.usage
            cost = usage.prompt_tokens * PRICE_IN + usage.completion_tokens * PRICE_OUT
            span.set_attribute("gen_ai.usage.input_tokens", usage.prompt_tokens)
            span.set_attribute("gen_ai.usage.output_tokens", usage.completion_tokens)
            span.set_attribute("wsw.estimated_cost_usd", round(cost, 6))
            return resp.choices[0].message.content
        except Exception as e:
            span.record_exception(e)
            span.set_status(Status(StatusCode.ERROR, str(e)))
            raise
實踐: 計算 estimated_cost_usd 在跨度處。不要等到夜間工作才將代幣計數加入到價格表中——隨叫隨到的產品所有者需要實時的 FinOps。
3b.多代理跨度層次結構和行李
代理圖需要穩定的父/子模型,以便成本正確累積:
session (root)
  └─ agent.run {wsw.route, wsw.tenant_id}
       ├─ rag.retrieve {wsw.agent_step=retrieve}
       ├─ gen_ai.chat {wsw.agent_step=plan, model=…}
       ├─ tool.execute {tool=…, wsw.retry_n}
       ├─ gen_ai.chat {wsw.agent_step=synthesize}
       └─ eval.score {score.name, score.value}
- 每個使用者一個 root 任務 — 不是每次 LLM 呼叫。會話成本 = 子程序總和
wsw.estimated_cost_usd. - 行李 — 傳播
wsw.tenant_id和wsw.route跨非同步工作人員/佇列,因此工具跨度繼承退款標籤,而無需重新連線每個呼叫站點。 - 連結 - 當子代理啟動新跟蹤(例如單獨的佇列消費者)時,使用跨度連結返回父會話,以便 Langfuse/Grafana 仍然可以縫合圖表。
- 始終提供樣品成本高 — 5-20% 的頭部取樣對於快樂路徑來說是合適的;當會話支出超過閾值或狀態=錯誤時強制取樣。
4. 重要的指標(普羅米修斯)
匯出直方圖和計數器(透過 OTEL 指標或 Prometheus 客戶端)。最小可行集:
llm_requests_total{model,route,status}llm_tokens_total{model,direction}其中方向 ∈ {輸入,輸出}llm_estimated_cost_usd_total{model,tenant,route}llm_ttft_seconds/llm_e2e_seconds直方圖agent_tool_calls_total{tool,status}agent_retries_total{route}agent_task_success_total{route}— 每次成功成本的分母
派生的 FinOps 查詢(PromQL 草圖):
# Cost per successful task (last 1h), by route
sum(rate(llm_estimated_cost_usd_total[1h])) by (route)
  /
sum(rate(agent_task_success_total[1h])) by (route)

# Retry tax
sum(rate(agent_retries_total[1h])) by (route)
  /
sum(rate(llm_requests_total[1h])) by (route)
滅霸 當財務部門要求季度模型支出時,(或 Mimir/Cortex)很重要。僅本地 Prometheus 就可以滿足 on-call;它不是 FinOps 檔案。
5. Grafana 面板和警報
從一個資料來源運送三位受眾:
- 待命: 錯誤率、p95 e2e、依賴性故障(向量 DB/工具)。
- 平臺: 令牌/秒、GPU util(如果自託管)、佇列深度、TTFT。
- 金融運營/產品: 按租戶和路線、最昂貴的提示、模型組合劃分的美元/成功。
警惕燒傷,而不是虛榮:
- 每次成功成本 > 30m 的預算 SLO
- 路由重試率 > 15%
- p95 e2e 漏洞,輸入令牌不斷增加(迅速回歸)
6. LLM原生平臺:Langfuse、LMNR和朋友
指標告訴你 那 成本飆升; LLM平臺告訴你 哪個提示版本 和 哪個工具跨度 做到了。 朗福斯 和 LMNR 是此類的開源示例:
- 分層跟蹤(會話→代理→LLM/工具跨度)
- 人類和 LLM 作為評委的分數
- 更改提示時用於離線評估的資料集
- 用於產品改進的可選使用遙測(尊重隱私政策)
整合模式:保留OTEL作為SRE的記錄系統;雙匯出或橋接到 Langfuse 以進行快速工程。不要發明第二個不相容的屬性字典。
諸如功能優先的代理執行時(歷史上圍繞結構化流代理進行營銷)之類的框架實驗可以減少樣板檔案,但將利基框架視為可選的——可觀察性標準比它們更長壽。
7. 評分管道:手動與自動
| 方法 | 執行 | 失效模式 |
|---|---|---|
| 手動的 | Langfuse UI 中的拇指/評分標準;黃金套裝評論。 | 不擴充套件;仍需要校準。 |
| 自動的 | LLM-作為法官、單元檢查、模式驗證器、檢索召回。 | 判斷漂移;遊戲如果只針對法官進行最佳化。 |
將分數附加為跨度事件或鍵入的 Langfuse 分數 wsw.prompt_version。以與控制應用程式版本相同的方式控制提示的促銷 — 用於程式碼的 Ring Promoter;評估門的提示。
8. 節省成本的流程(詳細)
- 基線周: 沒有行為改變;只有儀器儀表。捕獲 $/成功、令牌/成功、重試率。
- 歸因: 按支出×交易量對路線進行排名。選出前三名。
- 模型路由: 將分類/提取拆分為小型/區域性模型;保持綜合前沿。重新測量質量分數。
- 及時手術: 刪除未使用的工具模式;縮短几次鏡頭;在安全的情況下啟用字首快取。
- 迴圈帽: 最大工具呼叫、最大自除錯輪數、斷路器的指數退避。
- 取樣: 保持 100% 指標;樣本跟蹤(例如 5-20%)以及針對錯誤和高成本會話的始終線上取樣。
- 密文: 匯出前從跨度屬性中去除 PII;僅在經過 TTL 批准的商店中儲存完整提示。
- 稽核節奏: 每週 FinOps 委員會;每月對人類進行法官校準。
8b.透過實時預算管理代理使用情況
僅靠儀表板並不能阻止失控的特工。在執行時執行預算,將決策作為跨度事件發出,並在會話經常達到上限時發出警報:
# Pseudocode: hard budget around an agent session
class Budget:
    def __init__(self, max_usd=0.50, max_tool_calls=8, max_llm_calls=12):
        self.max_usd, self.max_tool_calls, self.max_llm_calls = max_usd, max_tool_calls, max_llm_calls
        self.spent = 0.0
        self.tools = self.llms = 0

    def charge(self, usd: float, kind: str):
        self.spent += usd
        if kind == "tool":
            self.tools += 1
        else:
            self.llms += 1
        if self.spent > self.max_usd or self.tools > self.max_tool_calls or self.llms > self.max_llm_calls:
            raise RuntimeError("agent budget exhausted")
- 每會話上限 — 美元、LLM 呼叫、工具呼叫(上圖)。
- 每租戶每日配額 — Redis/計數器由
wsw.tenant_id;當筋疲力盡時返回受控的退化路徑。 - 每條路線模型策略 — 允許名單模型
support.triage與legal.draft;拒絕或降低政策失誤和記錄wsw.policy_action=downshift. - 冪等工具鍵 — 雜湊工具引數,因此重試不會對外部 API 進行雙重計費。
- 成本公式 —
cost = in_tokens × p_in + out_tokens × p_out + tool_fees;重新整理p_in/p_out來自版本化的價格表,因此滅霸的歷史資料保持可比性。
上限落地後要觀察的指標: agent_budget_exhausted_total{route,reason}。峰值意味著濫用、工具迴圈中斷或預算對於實際工作負載來說太緊張。
9. 收集器配置示意圖
# otel-collector-config.yaml (illustrative)
receivers:
  otlp:
    protocols:
      http:
      grpc:
processors:
  memory_limiter: {}
  batch: {}
  attributes/redact:
    actions:
      - key: gen_ai.prompt
        action: delete
exporters:
  prometheus:
    endpoint: "0.0.0.0:8889"
  otlp/langfuse:
    endpoint: "${LANGFUSE_OTLP_ENDPOINT}"
    headers:
      Authorization: "Bearer ${LANGFUSE_KEY}"
service:
  pipelines:
    traces:
      receivers: [otlp]
      processors: [memory_limiter, attributes/redact, batch]
      exporters: [otlp/langfuse]
    metrics:
      receivers: [otlp]
      processors: [memory_limiter, batch]
      exporters: [prometheus]
10. 優點、缺點以及何時不需要打擾
優點: 退款、更快的事件分類、提示/模型更改的可衡量投資回報率、合規性友好的審計跟蹤、機器學習和平臺團隊之間的共享語言。
缺點: 儀表債務;如果您永遠保留每個提示,則儲存成本;將 PII 傳送到錯誤後端的風險;另一個供工程師學習的控制檯。
如果出現以下情況,請跳過(暫時): 您有一個離線批處理作業,每日支出固定,並且沒有互動式代理。仍然記錄令牌;跳過完整的多後端堆疊,直到出現併發。
11. 遷移清單
- ☐ 代理執行時中的 OTEL SDK;叢集中的收集器
- 跨度屬性包括模型、代幣、成本、租戶、路線
- ☐ Prometheus 指標 + Grafana FinOps 板
- ☐ Langfuse(或 LMNR)至少連線一條關鍵路徑
- ☐ 代幣/工具/重試的硬性上限
- ☐ 安全部門審查的編輯政策
- 每週審查熱門路線的美元/成功
- ☐ 記錄 ADR 連結可觀察性 → 服務 (vLLM) → 促銷 (Ring Promoter)
12.Workstation相關材料
- 商業部落格伴侶
- 渦輪增壓 LLMs — 在看到瓶頸後修復服務
- Ring Promoter — 透過健康門推廣代理服務
- Muse Glimmer / 當地代理
- 聯絡Workstation 企業人工智慧實驗室參與
參考
釋出者: Workstation.