Workstation 技术简介:如何增强 LLM 服务和代理 PagedAttention, vLLM, Self-Debugging, PowerInfer, 和 EG-MLA。伴侣: 博客 ·底漆: Kubernetes 上的 LLMs 文章 · 实验室: 企业人工智能实验室.
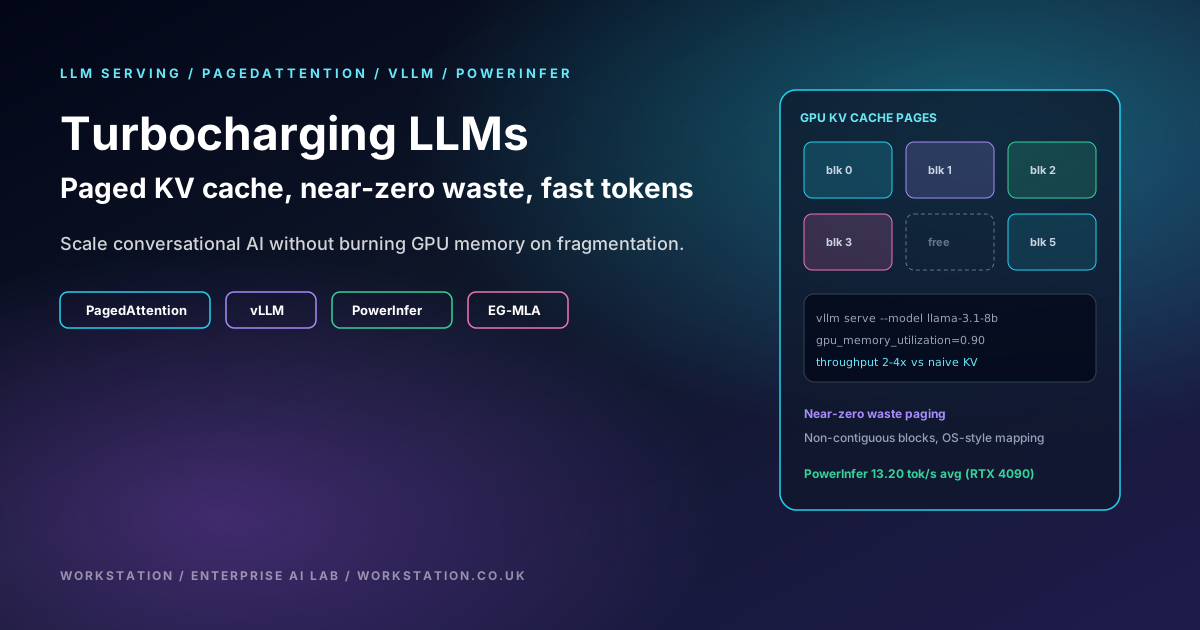
- 瓶颈: KV 缓存增长和碎片,而不是抽象的“模型很慢”。
- PagedAttention: OS风格的KV块分页;调整块大小和缓存层次结构。
- vLLM: 服务发动机近零KV浪费+连续配料;观看 TTFT 与代币的对比。
- Self-Debugging: 少量的程序修复击败了庞大的候选集;产品中的帽轮。
- PowerInfer: 热/冷分流; RTX 4090 上的平均 13.20 tok/s / 29.08 峰值(纸面/回购数据)。
- EG-MLA: 架构级 KV 压缩(相对于 MHA 约 91.6%);交换之前重新评估。
1. 为什么危机是服务而不是培训
大型语言模型改变了 NLP:聊天、生成、工具。培训一次是昂贵的;每秒的服务都很昂贵。解码是自回归的。每个新令牌都需要以前的键和值。 KV 缓存的内存与层 × 头 × 隐藏 × 序列 × 批次成正比。预填充计算量大;解码需要大量内存带宽。如果您为每个请求分配一个连续的最大长度 KV 张量,则其中大部分是空的,直到序列实际增长 - 经典的内部碎片。并发请求无法窃取这些漏洞。批量大小下降。每秒掉落的令牌数。 GPU 看起来很忙,但仍然闲置。
那就是2023年PagedAttention和vLLM攻击的问题,PowerInfer问题以及后来的注意力变体仍然从不同的角度攻击。
观看:LLM 心理模型
上下文视频: 大型语言模型简介。 Workstation解释器: LLM 的工作原理以及如何在 Kubernetes 上运行它们.
2. PagedAttention:KV缓存的分页
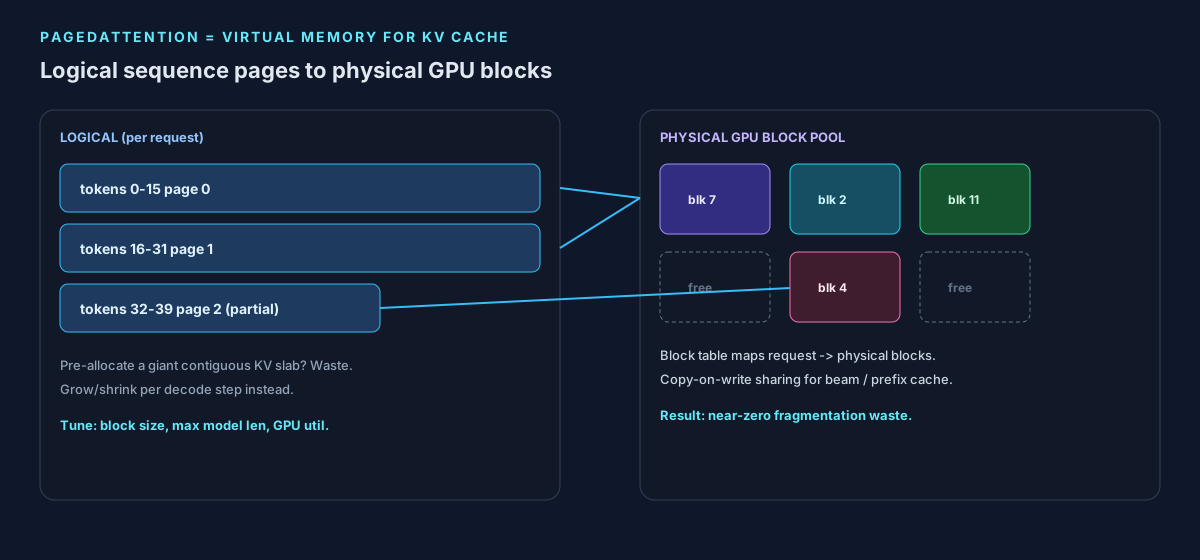
Kwon、Li、Zhang、Sheng、Zheng、Yu、Gonzalez、Zhang 和 Stoica 介绍了 PagedAttention 作为受虚拟内存和操作系统分页启发的注意力算法,并在此基础上构建了 vLLM [arXiv:2309.06180]。想法:
- 将 KV 拆分为 固定大小的块 (每个区块少量代币)。
- 保留一个 块表 从逻辑令牌位置到物理 GPU 块(可能不连续)。
- 随着序列的增长或完成而分配/释放块——就像页面分配一样,而不是像一个巨大数组的 malloc 那样。
- 共享块(写入时复制)以实现前缀重用、波束搜索和并行采样,这样您就不会重复相同的前缀。
实施并不是“给 BERT 设置一个标志”。注意力内核必须收集分散的块。调度程序必须知道哪些块是空闲的。缓存层次结构很重要:HBM 驻留块与 CPU 卸载与 NVLink 对等体。缓冲区(块)大小是一个真正的旋钮。太小:更多的表查找和内核开销。太大:最后一个部分块内的插槽被浪费。将块大小与 max_model_len 以及流量的实际提示/完成组合。
实践: 配置文件碎片(未使用的 KV 字节/保留的 KV 字节)和令牌在一起。没有吞吐量的内存图是虚荣的。
3. vLLM:寻呼机周围的服务系统
vLLM 声称 KV 缓存内存几乎为零浪费,并且可以在请求内和请求之间灵活共享。论文中的评价大致表明 2–4× 吞吐量 与当时的 SOTA 系统(FasterTransformer、Orca)相比,延迟相似,在长序列和更高级的解码方面具有更大的增益。如今,该引擎还为多 GPU 提供连续批处理、分块预填充、前缀缓存和张量/管道并行功能。
操作清单:
- 放
gpu_memory_utilization高到足以容纳重量 + KV,低到足以离开 CUDA 工作区。 - 仅在确认 eval 分数和 p95 TTFT 开启后才启用前缀缓存 你的 提示。
- 如果混合流量破坏 SLO(分解服务),则将预填充密集型和解码密集型池分开。
- 在网关后面公开与 OpenAI 兼容的端点(Workstation 资产通常将其放在后面) WSL Proxy/API网关 模式)。
from vllm import LLM, SamplingParams

llm = LLM(
    model="meta-llama/Llama-3.1-8B-Instruct",
    gpu_memory_utilization=0.90,
    max_model_len=8192,
    enable_prefix_caching=True,
)
params = SamplingParams(temperature=0.2, max_tokens=256)
outs = llm.generate(["Summarise PagedAttention for a platform engineer."], params)
print(outs[0].outputs[0].text)
反模式(这是 不是 PagedAttention):
# Classifier forward pass — logits, not paged KV serving
import torch
from transformers import AutoModelForSequenceClassification
model = AutoModelForSequenceClassification.from_pretrained("bert-base-uncased")
out = model(torch.tensor([[1, 2, 3]]), attention_mask=torch.tensor([[1, 1, 1]]))
print(out.logits)
观察:野外服务系统
情境服务谈话。规范写作: vLLM 博客 (PagedAttention) · 引擎: vllm-项目/vllm.
4. Self-Debugging:每个候选人的质量更高,而不是更多的候选人
陈、林、克莱因等人。结果表明,教 LLM 通过几次演示来调试其预测程序可以匹配或击败生成超过 10 倍候选数量的基线 [arXiv:2304.05128]。循环是:生成→执行或单元测试→反馈跟踪→修复。
生产权衡:每个反馈消息都是另一个预填充+解码(或长上下文附加)。回合数越多,准确度通常越高;延迟和成本也是如此。 Workstation 代理指南(另请参阅 Muse Glimmer / 当地代理):
- 每次工具调用的调试轮数有硬性上限(例如 2-4 轮)。
- 预算令牌与用户可见的聊天分开。
- 升级为人类或专家模型,而不是无限重试。
- 评估的日志跟踪 — 没有遥测的 Self-Debugging 是民间传说。
5. PowerInfer:位置感知令牌生成
PowerInfer(SJTU IPADS /相关存储库)是一个利用激活局部性的令牌生成系统:GPU 上设置的小型“热”神经元,CPU 上流式传输或执行的较冷权重。已发布的操作点包括 平均 13.20 个令牌/秒 和 峰值 29.08 个令牌/秒 在单个 NVIDIA RTX 4090 上,最多 11.69× 与保留精度的 llama.cpp 相比 [PowerInfer GitHub]。 (Tiiny-AI/PowerInfer 等面向用户的分叉跟踪相同的工作线。)
横向扩展是困难的部分。单个 4090 位置配置文件不会自动成为健康的 Kubernetes 部署。您需要:
- 如果 CPU 专家运行,诚实的 GPU 请求/限制和 NUMA 感知的 CPU 固定。
- 如果模型不再适合,则采用分布式计划:张量并行、管道并行、专家并行。
- SLO 拆分:交互式聊天、批量完成、代理工具循环。
在工作站和边缘盒上使用 PowerInfer(或 llama.cpp、或 MLX);当您使用并发 OpenAI 类型的流量填充数据中心 GPU 时,请使用 vLLM(或 TensorRT-LLM 或 SGLang)。测量两者。我们的 企业人工智能实验室 立场与Polyglot Benchmarks相同:证据,然后是ADR。
6. EG-MLA:在架构上压缩注意力
服务技巧无法修复 KV 本质上巨大的模型。 EG-MLA(嵌入门控多头潜在注意力)报告 KV 缓存大小减少超过 91.6% 与多头注意力 (MHA) 相比,性能下降可以忽略不计,与 MLA 相比,节省了更多成本(高达 59.9%),并且提高了推理基准准确性。作者认为嵌入门控会引发隐含的高阶相互作用,并显示出超过 1B 参数的缩放 [EG-MLA,arXiv].
工程意义:这是一个 培训/架构 决定。您无法在 Llama-3 的每晚随机 vLLM 上翻转 EG-MLA 并期望论文的百分比。如果您控制预训练或持续预训练,EG-MLA 是您购买另一个 GPU 之前削减 HBM 的候选者。如果您只提供公共权重,请继续使用引擎已支持的 PagedAttention + 量化 + MLA 变体,并在 EG-MLA 检查点落地时对其进行跟踪。
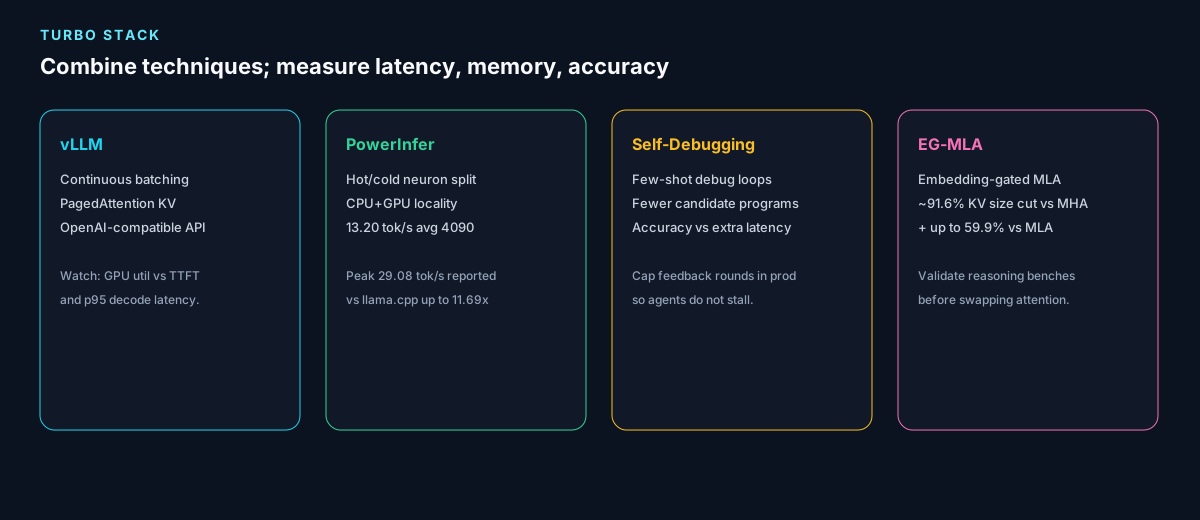
7. 无需进行货物崇拜即可组合堆栈
| 层 | 使用时 | 当心 |
|---|---|---|
| PagedAttention / vLLM | 并发 API 服务、长上下文、共享前缀 | 前缀缓存与正确性;高利用率时 OOM |
| PowerInfer | 单胖GPU/工作站代币率 | 地点不匹配;混乱的横向扩展 |
| Self-Debugging | 可以执行测试的代码/代理循环 | 无限回合;额外的预填充费用 |
| EG-MLA | 您训练或微调骨干 | 不是服役旗帜;重新运行完整评估 |
8. Kubernetes 上的可扩展性
精心设计的分布式架构会提高吞吐量,但也会引发故障模式:落后者、KV 缓存传输、分词器倾斜以及杀死热前缀的自动缩放器。实用模式(与我们的 Kubernetes 上的 Ollama / vLLM 写):
- 专用GPU节点池;切勿将解码盒与随机 CPU 作业打包在一起。
- 如果 TTFT SLO 和令牌 SLO 发生冲突,则将预填充和解码分开。
- HPA 对队列深度或 GPU KV 占用率的影响,而不仅仅是 CPU。
- 通过环提升服务堆栈(Ring Promoter)所以糟糕的引擎构建不能跳过测试。
9. 结论
涡轮增压 LLMs 不是一种算法。它对 KV 缓存进行分页 (PagedAttention),一个不会浪费这些页面的服务引擎 (vLLM),当硬件是工作站 GPU (PowerInfer) 时进行位置感知生成,调试而不是喷射候选者的代理循环 (Self-Debugging),以及 - 当你拥有权重时 - 只存储较少的注意力 (EG-MLA)。每一层都会以内存、延迟和准确性为代价。衡量您的流量。发布 ADR。船。
参考
- 权等人。 — 使用 PagedAttention 进行大型语言模型的高效内存管理 (arXiv:2309.06180,2023 年 9 月 14 日)。
- 陈等人。 — 教授大型语言模型进行自调试 (arXiv:2304.05128,2023 年 4 月 12 日)。
- PowerInfer— 上海交通大学-IPADS/PowerInfer (以及相关的Tiiny-AI 分叉)。
- EG-MLA— 嵌入门控多头潜在注意力 (arXiv,2025 年 9 月 20 日)。
- vLLM 博客 — 简单、快速且便宜的 LLM 与 PagedAttention 一起服务.
发布者: Workstation。引用原作者发表的论文数据;您集群上的生产数量会有所不同。


