GPU 私有云
您自己的 AI 雲:位於您掌控的資料中心內的 GPU、儲存與軟體
在專屬於您的 GPU 上,緊鄰您的資料,以可預測的成本執行 AI 助理、代理程式、搜尋與模型訓練。我們設計、建置並營運 GPU 私有雲,從單台伺服器到完整機櫃,部署在您的場所或英國資料中心。
您自己的 AI 雲:位於您掌控的資料中心內的 GPU、儲存與軟體
在專屬於您的 GPU 上,緊鄰您的資料,以可預測的成本執行 AI 助理、代理程式、搜尋與模型訓練。我們設計、建置並營運 GPU 私有雲,從單台伺服器到完整機櫃,部署在您的場所或英國資料中心。
GPU 私有雲讓您的團隊在僅供您使用的 GPU 伺服器上,享有公有雲的自助式體驗(挑選模型、啟動 Notebook、部署助理)。硬體位於您自己的場所或託管資料中心,平台軟體、安全政策與資料全都由您掌控。
公有雲非常適合嘗試構想與應付短期尖峰。但 AI 助理與代理全天候運行,每次互動都要計費,而且它們所需的資料往往正是您最不能承擔搬移風險的資料。一旦使用量穩定,私有雲通常能讓成本可預測、將敏感資料集中一處,並降低模型與您系統之間的延遲。
它不是單一產品。私有 AI 雲端是一個技術堆疊:電力與散熱、GPU 伺服器、高速網路、能讓 GPU 持續忙碌的儲存、容器與排程平台、模型服務與資料工具,以及圍繞它們的治理。本頁其餘部分會逐層說明,再讓您針對自己的工作負載試用各種選項。
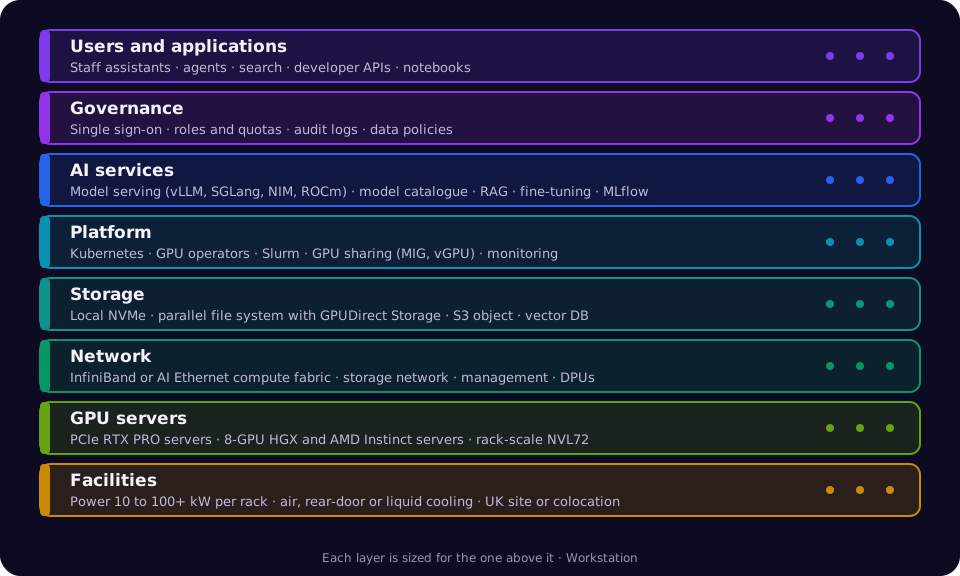
我們最常聽到的原因,以及每一項在實務上的意義。
全天候 24/7 運行的助理、代理程式與 API,在您自有或租賃的硬體上每月成本固定,而不是隨每個權杖與每位使用者增長的帳單。
將客戶、病患、法律或財務資料保留在英國、您自己的場地或完全離線,並向稽核人員與監管機關證明這一點。
模型與您的資料庫、文件和應用程式並排運行,因此檢索與代理程式的工具呼叫不必在每一步都經過網際網路。
並行執行開放權重模型、您的微調模型與商用模型,並可隨時更換而無需重新建置平台。不被單一供應商的目錄綁定。
單一登入、以角色為基礎的存取、每個團隊的配額、每次模型呼叫的稽核日誌,以及規範各助理可存取哪些資料的政策。
資料科學家啟動筆記本與微調作業,開發人員部署模型端點,IT 則以單一主控台管理容量、健康狀態與成本。
專案開始時您的 GPU 就在那裡,不會在您所需的區域被搶購一空。由排程決定哪個團隊使用,而不是在供應商那裡排隊。
新 GPU 到位後,舊款 GPU 轉為推論、開發與教學使用,讓每一代硬體都能持續創造多年價值。
影片從各製造商自己的 YouTube 頻道播放。每支影片僅在您按下播放時才會載入。
GPU 記憶體(VRAM)決定哪些模型放得下,以及每顆 GPU 能服務多少使用者;記憶體頻寬則決定回應速度。這些是我們最常用來打造私有雲的資料中心 GPU。
| GPU | 創客 | 每張 GPU 的記憶體 | 記憶體頻寬 | 外形 | 適合 |
|---|---|---|---|---|---|
| RTX PRO 6000 Blackwell Server Edition | NVIDIA | 96 GB GDDR7 | 1.6 TB/s | PCIe 卡,氣冷 | 推論、RAG、中小型模型微調、繪圖與模擬 |
| L40S | NVIDIA | 48 GB GDDR6 | 864 GB/s | PCIe 卡,氣冷 | 小型模型推論、視覺、算圖 |
| H200 | NVIDIA | 141 GB HBM3e | 4.8 TB/s | 8 GPU HGX 主板 | 大型模型推論與微調 |
| B200 | NVIDIA | 180 GB HBM3e | 8 TB/s | 8 GPU HGX 主板 | 訓練與高吞吐量推論 |
| B300 (Blackwell Ultra) | NVIDIA | 288 GB HBM3e | 8 TB/s | 8-GPU HGX 基板,氣冷或液冷 | 推理模型、超大型模型、訓練 |
| GB300 NVL72 | NVIDIA | 每張 GPU 288 GB HBM3e,每個機櫃 72 張 GPU | 每顆 GPU 8 TB/s | 液冷機櫃 | 前沿訓練與最大型的推論服務 |
| Instinct MI325X | AMD | 256 GB HBM3E | 6 TB/s | 8-GPU OAM 平台 | 具備大量每顆 GPU 記憶體的大型模型推論 |
| Instinct MI355X | AMD | 288 GB HBM3E | 8 TB/s | 8 GPU OAM 平台,液冷 | 超大型模型的訓練與推論 |
| DGX Spark(GB10) | NVIDIA | 128 GB 統一記憶體 | 273 GB/s | 桌邊系統 | 叢集上線前的開發、原型製作與試行 |
數據為製造商公布的規格。合作夥伴的伺服器可能以不同的功耗上限運行 GPU。
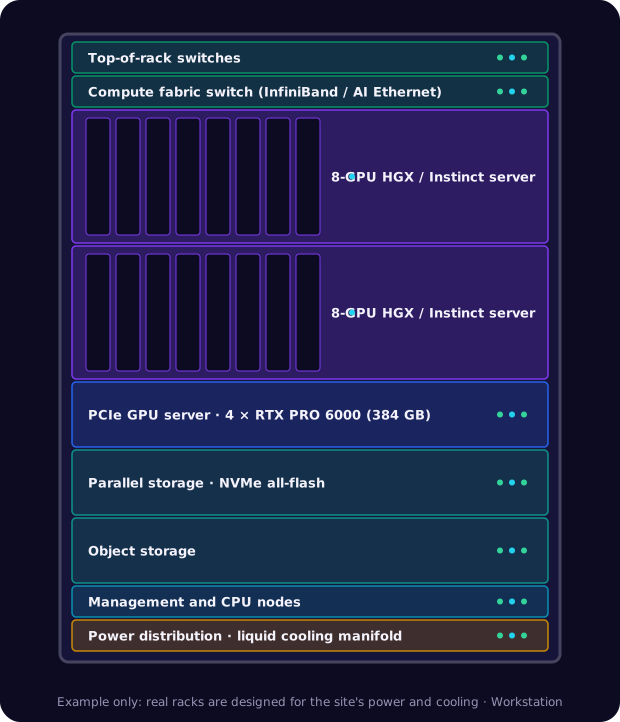
在標準氣冷伺服器中配置兩至八張 PCIe GPU,例如 RTX PRO 6000 或 L40S,如 Dell PowerEdge XE7745 或 R760xa。這是進入私有雲最簡單的方式:適用於多數機櫃與電力預算。
以 NVLink 或 AMD Infinity Fabric 連接的八顆 GPU,例如 Dell PowerEdge XE9680(H200 或 AMD Instinct MI300X)、XE9780(B300)與 XE9785(AMD Instinct MI355X),或 NVIDIA DGX B200 與 DGX B300。
整個液冷機櫃就像一顆巨大的 GPU,例如 NVIDIA GB300 NVL72 或 AMD Helios。適合訓練或提供最大型模型服務的組織,部署於專為其打造的資料中心。
適用於開發人員與試行專案的 DGX Spark 與 AI 工作站。軟體堆疊與叢集相同,工作可無縫轉移。
在與任何人洽談之前,快速評估 GPU 記憶體需求的方法。請使用下方的容量評估工具輸入您自己的數字。
| 模型大小 | 精度 | 權重所需記憶體 | 可容納(並為使用者保留空間) |
|---|---|---|---|
| 80 億參數 | 16 位元 | 約 16 GB | 一個 L40S 或 RTX PRO 6000;DGX Spark |
| 320 億參數 | 8 位元 | 約 32 GB | 一張 RTX PRO 6000 |
| 700 億參數 | 8 位元 | 約 70 GB | 一張 H200,或兩張 RTX PRO 6000 |
| 1200 億參數(MoE) | 4 位元 | 約 60 至 65 GB | 一張 RTX PRO 6000 或 H200 |
| 4,050 億參數 | 8 位元 | 約 405 GB | 一台 8-GPU 的 H200、B200 或 MI325X 伺服器 |
| 6,700 億參數以上(MoE) | 8 位元 | 約 670 GB 或更多 | 一台 8-GPU B300 或 MI355X 伺服器,或數台伺服器 |
等待資料的 GPU 是在浪費金錢。AI 儲存通常分為三層,依訓練所需的讀取速度與資料所需的容量來規劃。
供資料集、檢查點與模型快取使用的高速暫存空間,靠近 GPU。通常每台 GPU 伺服器配備數個 NVMe 磁碟。
每台 GPU 伺服器內的 NVMe SSD
所有伺服器可並行讀取的單一命名空間,速度足以供應訓練並在數秒內載入模型。請尋找支援 GPUDirect Storage 的方案,它能將資料直接搬入 GPU 記憶體。
Dell PowerScale、VAST Data、WEKA、DDN、IBM Storage Scale、Lustre
大容量、低成本的容量,用於原始資料、資料集、模型版本與備份,並採用多數 AI 工具已支援的 S3 介面。
Dell ECS 或 ObjectScale、Ceph、相容 S3 的設備、磁帶或雲端作為異地備份
根據您的文件回答的助理,需要向量資料庫與原始檔案,並套用與來源系統相同的存取控制。例如 pgvector、Milvus、Qdrant 或 Elasticsearch。
在伺服器內部,GPU 透過 NVLink 或 Infinity Fabric 通訊。伺服器之間,則由網路決定眾多 GPU 能否作為一體運作。
適用於跨伺服器的訓練或服務:NVIDIA Quantum InfiniBand(每連接埠 400 至 800 Gb/s)、NVIDIA Spectrum-X Ethernet,或搭配 AMD Pensando Pollara AI NIC 的乙太網路。通常每張 GPU 配一個 400 或 800 Gb/s 連接埠。
用於儲存流量、使用者與應用程式的獨立乙太網路,通常每台伺服器 100 至 400 Gb/s,因此絕不會與運算網路架構爭用頻寬。
每台伺服器皆有頻外管理,並以 NVIDIA BlueField 等 DPU 隔離租戶、卸載安全功能,且在 AI 雲端與企業其他部分之間設置防火牆。
我們為團隊真正會使用的私有 AI 雲所設計的檢查清單。我們在設計、建置與交接階段逐項確認。
常見的取捨。多數組織最終採用混合模式:以私有基礎承擔穩定工作,並以公有雲或租賃容量因應尖峰。
| 公有雲 AI 服務 | 主機代管資料中心內的 GPU 私有雲 | 位於您場所的 GPU 私有雲 | 混合式 | |
|---|---|---|---|---|
| 付款方式 | 依 token、依小時或依使用者,按月計費 | 硬體採購、融資或租賃,另含機架空間與電力 | 硬體採購、融資或租賃;自有電力與冷卻 | 私有基礎加上按用量計費的雲端以因應尖峰 |
| 最適合 | 嘗試想法、尖峰或短期工作負載 | 穩定使用 AI,但缺乏合適的機房 | 穩定使用、嚴格的資料規範,且場址具備電力與冷卻 | 穩定的基礎負載,偶爾出現大幅尖峰 |
| 資料存放位置 | 供應商的區域 | 由您選擇的英國資料中心 | 您自己的建築,可以實體隔離 | 敏感資料保持私有,其餘放在最便宜的地方 |
| 開始時間 | 分鐘 | 數週至數月:硬體交期與安裝 | 數週至數月,若場地需要電力或冷卻工程則更久 | 先從雲端開始,隨著硬體到貨再把穩定的工作移入 |
| 隨用量成長的成本 | 隨每位使用者與每次呼叫而增加 | 在需要更多 GPU 之前維持固定 | 在需要更多 GPU 之前維持固定 | 固定基本費,尖峰按用量計費 |
| 與您系統之間的延遲 | 透過網際網路或專線連線 | 低,並以私有連線連接您的各個據點 | 最低,在您自己的網路上 | 私有工作負載的需求低 |
| 模型與工具選擇 | 供應商的目錄與限制 | 任何您能執行的東西 | 任何您能執行的東西 | 兩者皆可 |
| 所需技能 | 雲端與應用程式技能 | 平台與 GPU 營運,或託管服務 | 平台、GPU 與設施營運,或託管服務 | 兩者皆有,外加工作負載配置 |
| GPU 供應情況 | 最新的 GPU 常被搶購一空或限量配給 | 安裝後即有保證 | 安裝後即有保證 | 保證基本量,尖峰時盡力而為 |
| 硬體汰換 | 由供應商決定 | 由您選擇,每 3 至 5 年一次;較舊的 GPU 轉為較輕量的工作 | 由您決定,每 3 至 5 年 | 您為基礎層做的選擇 |
我們為每個私有雲所經歷的八個階段,從第一場工作坊到團隊每天使用的平台。
列出您想執行的助理、代理、搜尋與訓練工作,以及模型、使用者與資料。我們會將其轉換為 GPU、VRAM、儲存與網路。
由您決定: 先處理哪些工作負載,以及成功的樣貌
您自己的機房、您的資料中心,或英國的託管機房。我們會勘查電力、散熱、地板承重與連線條件,或尋找專為 GPU 機櫃打造的託管空間。
由您決定: 地端或託管機房
GPU 伺服器(NVIDIA 或 AMD、Dell 或 NVIDIA DGX)、CPU 節點、儲存層級、運算網路架構與管理網路,並預留備品與擴充空間。
由您決定: GPU 系列、廠商,以及預留多少成長空間
可直接買斷、以融資租賃或租購方式分攤成本,或在自有硬體到貨前先租用部分容量。
由您決定: 資本支出、融資租賃或租用容量
交付、上架、佈線與開機,接著是韌體基準、網路架構測試、儲存效能基準測試,以及每顆 GPU 為期數日的燒機測試。
由您決定: 驗收測試與日期
Kubernetes 與 GPU 運算子、排程器、GPU 共享、映像檔登錄庫、身分識別、機密管理與監控,全部以程式碼管理,因此可以重建。
由您決定: Kubernetes、Slurm 或兩者皆有
模型服務、模型目錄、員工助理、針對您文件的 RAG、筆記本與微調,並與您的系統連接。
由您決定: 經核准的模型,以及每項服務可使用的資料
運行手冊、團隊訓練、成本與使用報告,以及自行營運或由我們提供的託管服務。
由您決定: 誰負責日常營運
四種方式,探索適合您自身 AI 工作負載的選項。除非您選擇傳送給我們,否則您輸入的任何內容都不會離開您的瀏覽器。
六個問題,每站一題。最後您會得到一份起始設計:硬體、VRAM、儲存、網路、電力與平台,以及後續該往哪裡走。
1 of 6