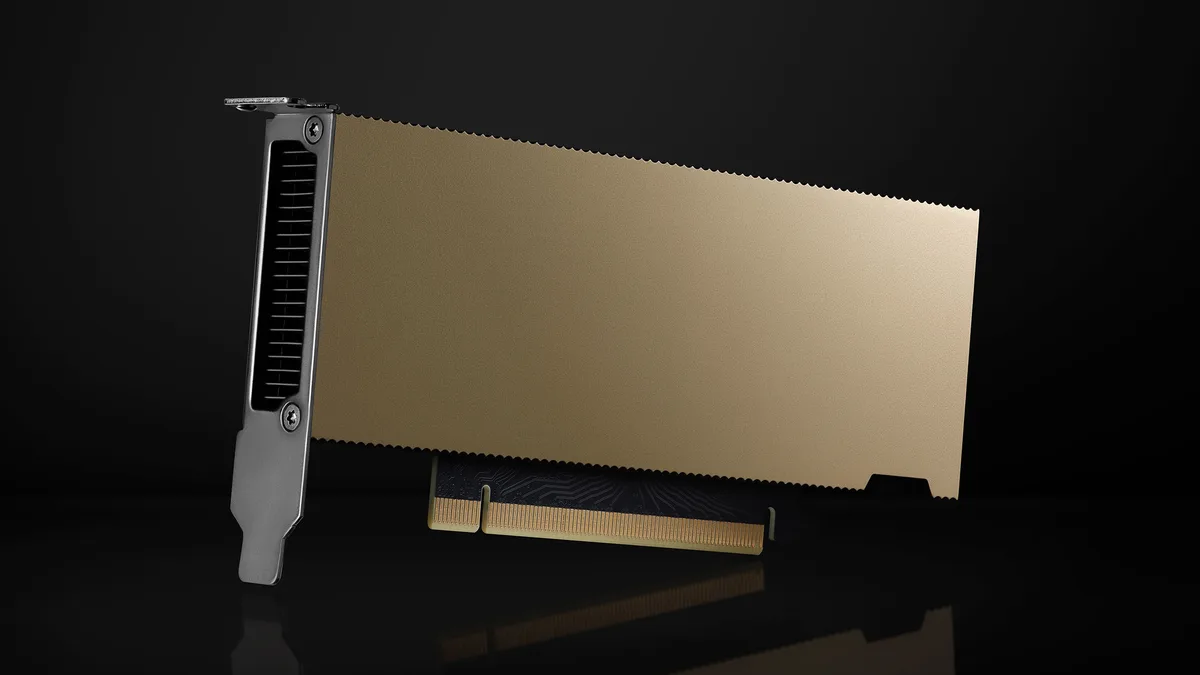
商店現已上線

我們打造用於網站、AI 智慧體和 LLM 訓練的 Workstation AI 機器——線上配置併購買。

獲取同行價格
AI 產品
AI 實驗室OpenAI 智慧體Claude 代理Grok BotWorkstation AI 原生 CRM營銷所有產品
AI 解決方案
應用型 AIAI 智慧體生成式 AIAI 自動化AI 技能提升中小企業 AI 套餐企業 AI 實驗室AI 工作站NVIDIA 硬體與軟體NVIDIA 加速計算私有 AIGPU 私有云GPU 叢集邊緣 AI行業 AI
AI 服務
平臺現代化數字工程資料基礎與 AI自主運營AI 諮詢DevOps 自動化網路安全軟體開發智慧體構建MLOps 搭建GPU 租賃GPU 私有云
關於我們
公司我們的故事合作伙伴客戶案例
AI 資料中心
AI 資料中心GPU 私有云GPU 叢集GPU 租賃
AI 洞察Jev 系列基準測試實驗室模型選擇
技術說明
文件
Linux 作業系統UbuntuRed Hat Enterprise LinuxSUSE LinuxAlpine LinuxDebian、Rocky 與 AlmaLinux
AI 雲平臺AWS 與 Amazon BedrockGoogle Cloud 與 Vertex AIMicrosoft Azure 與 AI FoundryGPU 雲與算力市場
私有 AI 資料中心面向律師事務所面向會計師事務所本地部署平臺全面安全的雲
工具Ring PromoterJobshout
新聞
部落格
聯絡我們登入

面向現代企業的 AI 工作站、AI 多智慧體軟體、GPU 基礎設施和智慧代理解決方案。

聯絡我們

AI 解決方案

應用型 AIAI 智慧體生成式 AIAI 自動化AI 技能提升中小企業 AI 套餐企業 AI 實驗室行業 AI

產品

所有產品Workstation AI native CRM 與 ERP營銷OpenAI 智慧體Ring PromoterJobshout

公司

關於我們公司AI 資料中心為什麼選擇Workstation合作伙伴客戶案例定價聯絡TenthMatrix

資源

AI 洞察技術說明文件Linux 作業系統AI 雲平臺私有 AI 資料中心部落格搜尋網站地圖
英國總部
77-79 Marlowes, Hemel Hempstead HP1 1LF路線指引 — 從 M25 外環倫敦 20 號出口駛出公司編號: 11641870週一至週五:上午 9:00 - 下午 6:00 GMT
+44 7515 356 146
比利時辦公室
Workstation SRL, Rue Vanderkindere 34, 1180 Uccle, BrusselsBE 0751.518.683週一至週五:上午 9:00 - 下午 6:00 CET
+32 492 45 67 46
印度辦公室
#159 Sector 9, Pocket 1, DDA Flats, 110077 Dwarka, New Delhi
+91 98881 98841
台灣辦公室
3F, No. 2-4, Aisi Rd., Ren'ai Dist., Keelung City 200, Taiwan基隆市仁愛區愛四路2之4號3樓週一至週五:上午 9:00 - 下午 6:00 臺灣時間(GMT+8)
+886 926 892 701+32 492 45 67 46

© 2026 Workstation AI。保留所有權利。

隱私資料刪除Cookie服務條款網站地圖

NVIDIA、NVIDIA 標誌、RTX、RTX PRO、Blackwell、CUDA、NVLink、MGX、Omniverse、Spectrum-X、Quantum、BlueField、DGX 與 HGX 為 NVIDIA Corporation 在美國及其他國家的商標及/或註冊商標。AMD、AMD Arrow 標誌、EPYC、Instinct、Ryzen 與 Threadripper 為 Advanced Micro Devices, Inc. 的商標。Dell 與 PowerEdge 為 Dell Inc. 或其子公司的商標。Intel 與 Xeon 為 Intel Corporation 或其子公司的商標。AMAX、AceleMax 與 LiquidMax 為 AMAX Engineering Corporation 的商標。所有其他產品名稱、標誌與品牌均為其各自所有者之財產。我們使用它們僅為識別我們所描述、供應或支援的產品;使用這些名稱並不表示其所有者為我們背書。

NVIDIA 合作伙伴 · 英國

NVIDIA 加速計算解決方案

從單塊資料中心 GPU 到液冷機架級 AI 工廠,Workstation 為英國機構提供 NVIDIA 全系列加速計算產品的選型、供貨、組裝、安裝與支援。

瀏覽產品系列諮詢工程師
  • 34NVIDIA 系統、GPU、網路與軟體產品
  • 5個步驟,從選型到長期支援
  • UK工程設計、組裝與老化測試

加速計算,免除整合風險

加速計算將工作負載中最繁重的部分,如 AI 訓練、推理、模擬、分析和渲染,從通用 CPU 轉移到 GPU 和專用處理器上。這樣每個機架、每瓦電力能完成更多工作,結果在數小時內即可得出,而不是數天。

實現這一點不僅需要 GPU。每個加速器都需要能為其供電和散熱的伺服器、能持續供給資料的網路,以及已獲授權並有支援保障的軟體。作為擁有自有工程師團隊的 NVIDIA 合作伙伴,我們將這些元件整合為一套經過測試的系統,並在系統上線後繼續為您提供服務。

  • 獨立建議,幫您判斷哪種 NVIDIA 平臺最適合您的工作負載
  • 完整的 NVIDIA-Certified 配置,而非零散部件
  • 在我們的英國車間完成組裝、系統映象部署和老化測試
  • 在您的現場完成安裝、佈線和除錯
  • 英國本地單一聯絡人,負責支援、升級和保修

加速系統由哪些部分組成

四個層級協同工作。我們對四個層級統一規劃,確保任何一層都不會成為瓶頸。

GPU

承擔 AI、模擬和圖形背後的平行計算。視訊記憶體容量和頻寬通常決定了您需要哪款 GPU。

CPU 與系統

為 GPU 供給資料、執行作業系統並在記憶體中儲存資料。機箱決定了供電、散熱以及可容納的 GPU 數量。

網路與 DPU

在 GPU、伺服器和儲存之間傳輸資料。DPU 可將網路、儲存和安全任務從 CPU 上解除安裝。

軟體

驅動、CUDA、AI 框架和叢集工具將硬體轉化為團隊可直接使用的平臺。

為什麼機構紛紛轉向加速計算

工作負載超出 CPU 能力

AI 模型和資料集的增長速度超過 CPU 效能提升。任務超時、服務水平下降、電費上漲。

工作流程日益複雜

資料準備、訓練、推理和視覺化常常執行在不同裝置上。統一的加速平臺可簡化整個流程。

新應用帶來新孤島

在現有應用旁邊增加 AI,可能形成硬體孤島。共享且經過認證的平臺讓一切易於管理。

產品系列

NVIDIA 加速計算產品

以下所有系統、GPU、網路產品和軟體許可證均可單獨供貨,也可作為完整方案的一部分。可按型別篩選、比較主要規格並索取報價。

系統與平臺

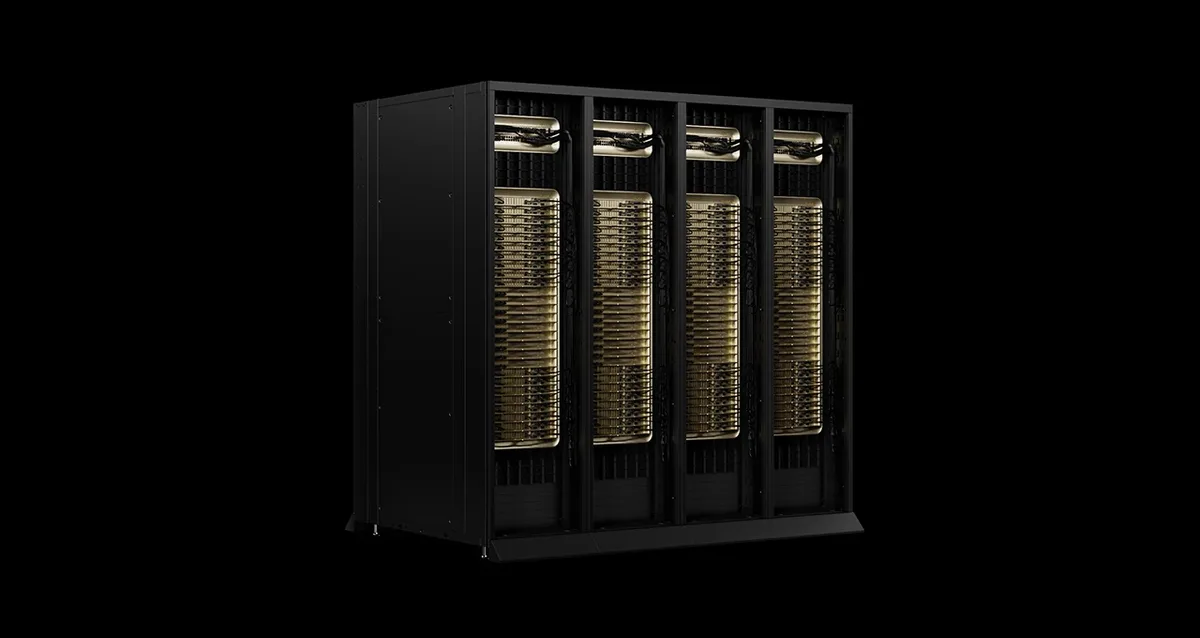
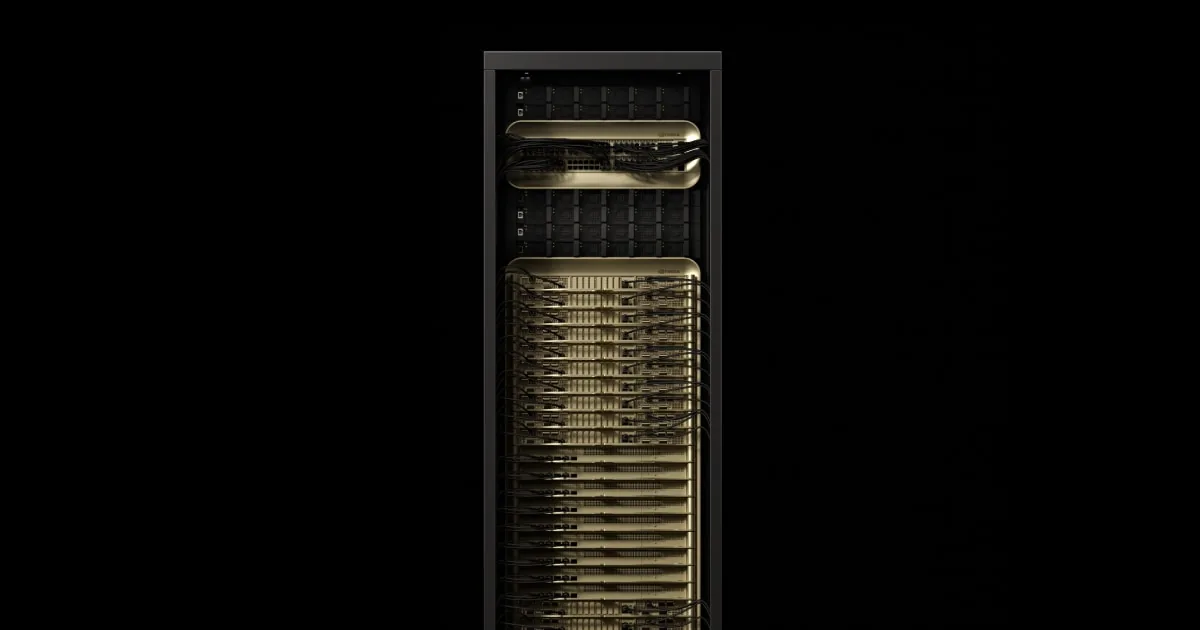
NVIDIA Vera Rubin NVL72

面向代理式 AI 和超大模型的機架級系統

NVIDIA 最新一代機架級系統將 72 個 Rubin GPU 和 36 個 Vera CPU 整合在同一個 NVLink 域中,讓單個機架如同一臺超大型加速器。

適用物件: 正在規劃下一次大規模部署的 AI 工廠、模型開發者和服務提供商

優勢

  • 據 NVIDIA 資料,每兆瓦產生的 token 數遠超 Grace Blackwell 一代
  • HBM4 記憶體容量足以支撐萬億引數和長上下文模型
  • 模組化、免線纜托盤,讓機架內維護更簡單

主要規格

配置72× Rubin GPU, 36× Vera CPU
GPU 視訊記憶體20.7 TB HBM4 | 1,400 TB/s
NVFP4 推理3,600 PFLOPS (sparse)
NVLink 頻寬216 TB/s (sixth generation)
CPU 記憶體Up to 54 TB LPDDR5X
外形規格Rack, third-generation MGX NVL72

Workstation 提供的服務: 我們會盡早核查現場供電、散熱和地板承重,鎖定供貨配額,並圍繞您的資料機房規劃交付、安裝和除錯。

價格請詢價索取報價 ↗
在 NVIDIA.com 上檢視 ↗
系統與平臺

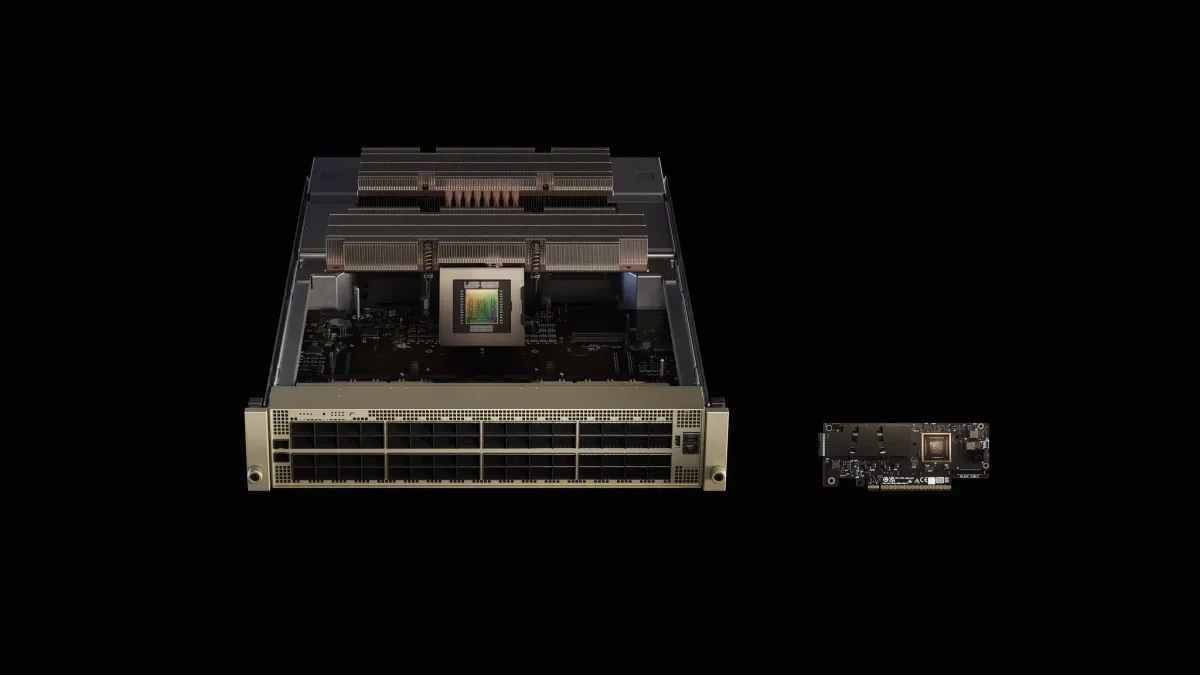
NVIDIA GB300 NVL72 (DGX GB300)

面向 AI 推理的液冷 Blackwell Ultra 機架

36 個 Grace CPU 與 72 個 Blackwell Ultra GPU 在單個液冷機架內共享同一 NVLink 網路。NVIDIA 也以 DGX GB300 的形式供貨。

適用物件: 為大量使用者提供推理模型服務的機構,以及進行前沿規模訓練的團隊

優勢

  • 與基於 Hopper 的系統相比,每使用者每秒 token 數大幅提升
  • 37 TB 高速記憶體可將長上下文和大模型保留在同一域內
  • ConnectX-8 SuperNIC 為每個 GPU 提供 800 Gb/s 的網路通道

主要規格

GPU72× Blackwell Ultra
CPU36× Grace (2,592 Arm Neoverse V2 cores)
GPU 視訊記憶體20 TB | up to 576 TB/s
高速記憶體37 TB
FP4 Tensor Core1,440 PFLOPS (sparse)
NVLink 頻寬130 TB/s

Workstation 提供的服務: 我們與您的設施團隊共同規劃液冷和供電,協調整機櫃的交付,並按經過驗證的基準完成除錯。

價格請詢價索取報價 ↗
在 NVIDIA.com 上檢視 ↗
系統與平臺

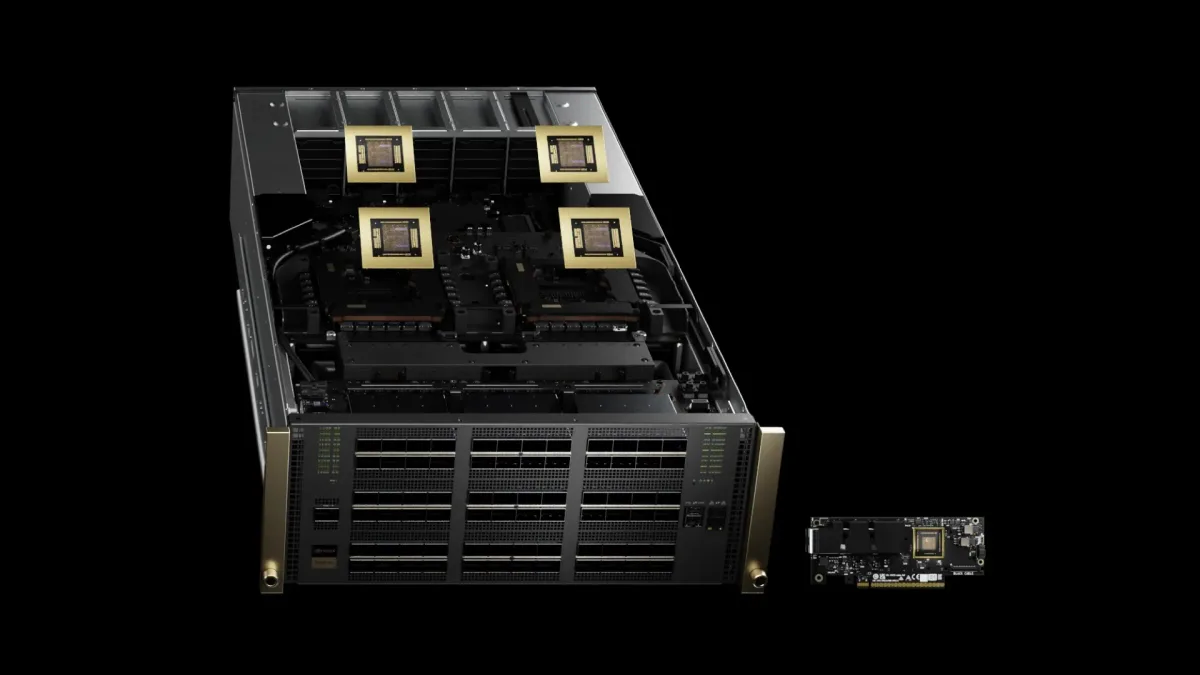
NVIDIA GB200 NVL72 (DGX GB200)

單一 NVLink 域內的 Grace Blackwell 機架級系統

首款 Grace Blackwell 機架:72 個 Blackwell GPU 與 36 個 Grace CPU 透過 NVLink 互連並採用液冷,適用於超大規模訓練和實時推理。

適用物件: 訓練或部署萬億引數模型、需要大型共享 GPU 記憶體池的團隊

優勢

  • 據 NVIDIA 資料,超大語言模型的實時推理速度是 H100 的數倍
  • 液冷提升密度和能效
  • 第五代 NVLink 在任意兩個 GPU 之間提供 1.8 TB/s 頻寬

主要規格

配置72× Blackwell GPU, 36× Grace CPU
GPU 視訊記憶體13.4 TB HBM3E | 576 TB/s
NVFP4 Tensor Core1,440 PFLOPS sparse | 720 PFLOPS dense
NVLink 頻寬130 TB/s
CPU 記憶體17 TB LPDDR5X | 14 TB/s
冷卻Liquid cooled

Workstation 提供的服務: 我們評估您的現場是否適合液冷,負責交付以及與您網路和儲存的整合,並在上線後為機架提供支援。

價格請詢價索取報價 ↗
在 NVIDIA.com 上檢視 ↗
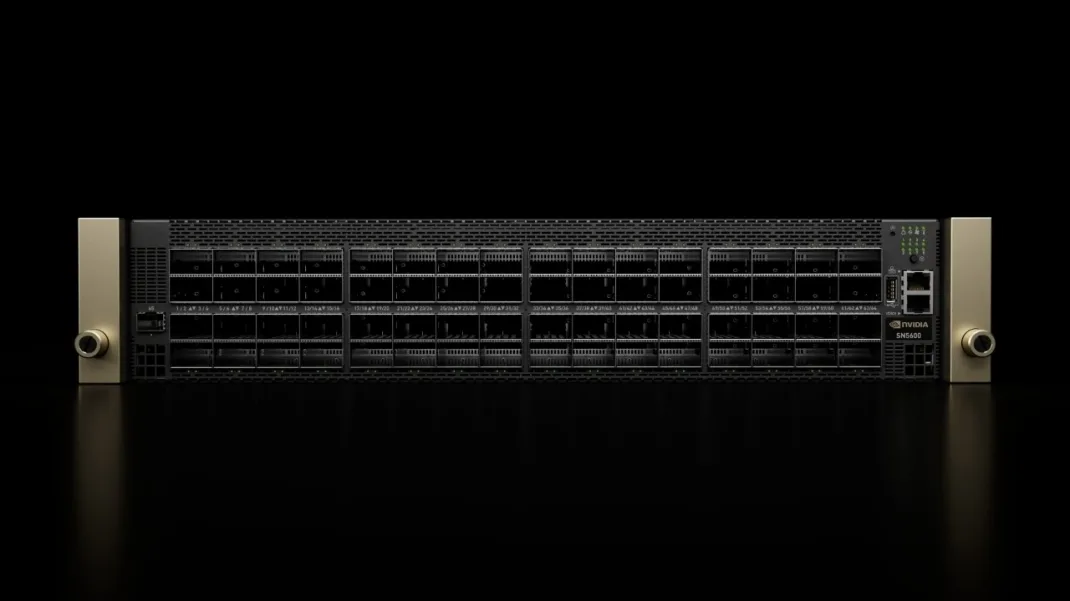
系統與平臺

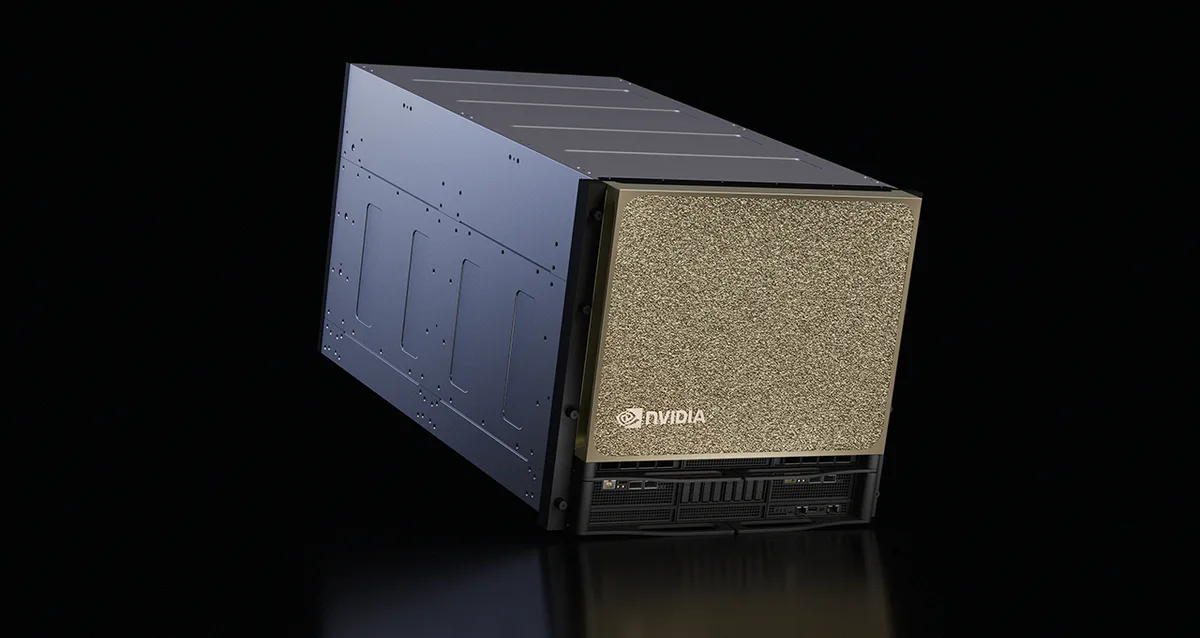
NVIDIA DGX B300

單臺 DGX 系統整合八個 Blackwell Ultra GPU

一臺獨立完整的 DGX 伺服器,配備八個 Blackwell Ultra GPU、NVIDIA 網路和完整的 DGX 軟體棧,可獨立執行,也可加入 BasePOD 或 SuperPOD。

適用物件: 正在建設首個正式 AI 工廠的企業,以及希望採用 NVIDIA 參考設計而非定製方案的團隊

優勢

  • 單節點 2.3 TB GPU 記憶體,適合大模型
  • 內建 ConnectX-8 和 BlueField-3 網路,便於橫向擴充套件
  • DGX 軟體從第一天起就確保叢集中每個節點保持一致

主要規格

GPU8× Blackwell Ultra
GPU 視訊記憶體2.3 TB total
AI 效能72 PFLOPS FP8 training, 144 PFLOPS FP4 inference
網路8× ConnectX-8, 2× BlueField-3 DPU

Workstation 提供的服務: 我們核查機架供電和氣流,交付並上架系統,接入您的網路架構,並在 DGX OS 和驅動驗證完畢後交付。

價格請詢價索取報價 ↗
在 NVIDIA.com 上檢視 ↗
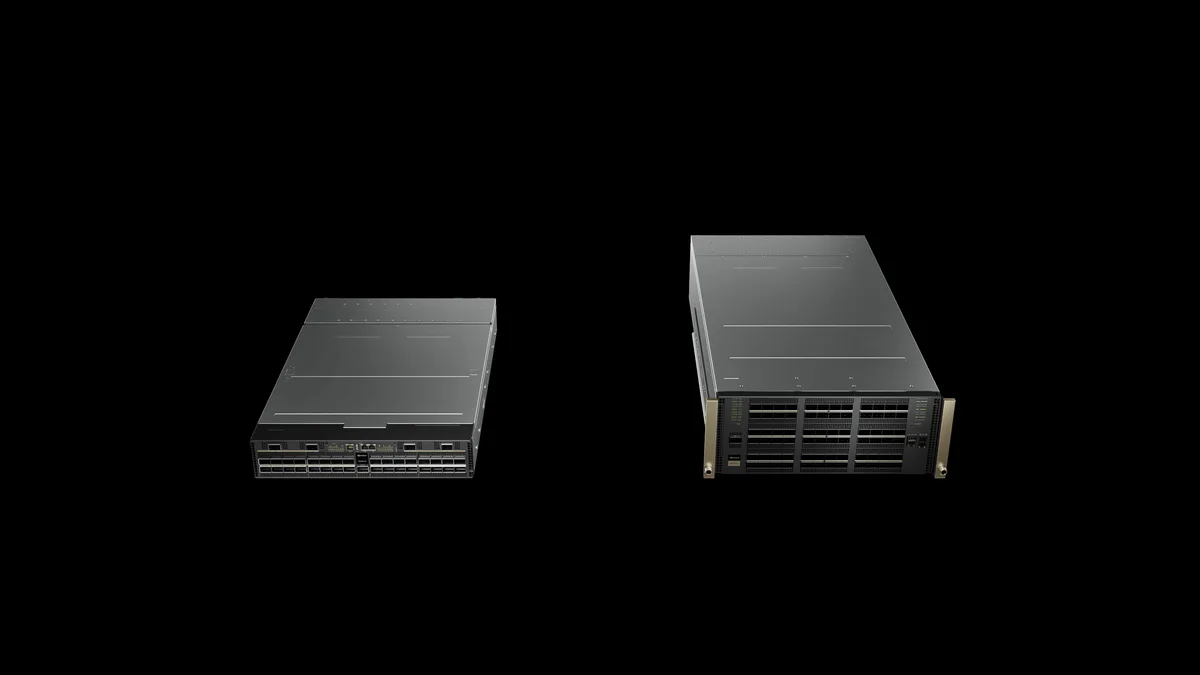
系統與平臺

NVIDIA DGX B200

久經驗證的 Blackwell DGX,適用於訓練和推理

單個 DGX 機箱內整合八個 NVLink 互連的 Blackwell GPU,是本地部署 AI 廣泛採用的基礎構建模組。

適用物件: 從 Hopper 或雲端 GPU 遷移到自有 Blackwell 平臺的團隊

優勢

  • 一個平臺滿足訓練、微調和推理需求
  • 八個 NVLink 互連 GPU 共 1,440 GB GPU 記憶體
  • 隨業務增長,可融入 BasePOD 和 SuperPOD 參考設計

主要規格

GPU8× Blackwell
GPU 視訊記憶體1,440 GB total
AI 效能72 PFLOPS training, 144 PFLOPS inference
網路8× ConnectX-7, 2× BlueField-3 DPU

Workstation 提供的服務: 我們根據您的模型進行選型,完成交付和安裝,並在交付前配置好驅動、CUDA 和 NVIDIA AI Enterprise。

價格請詢價索取報價 ↗
在 NVIDIA.com 上檢視 ↗
系統與平臺

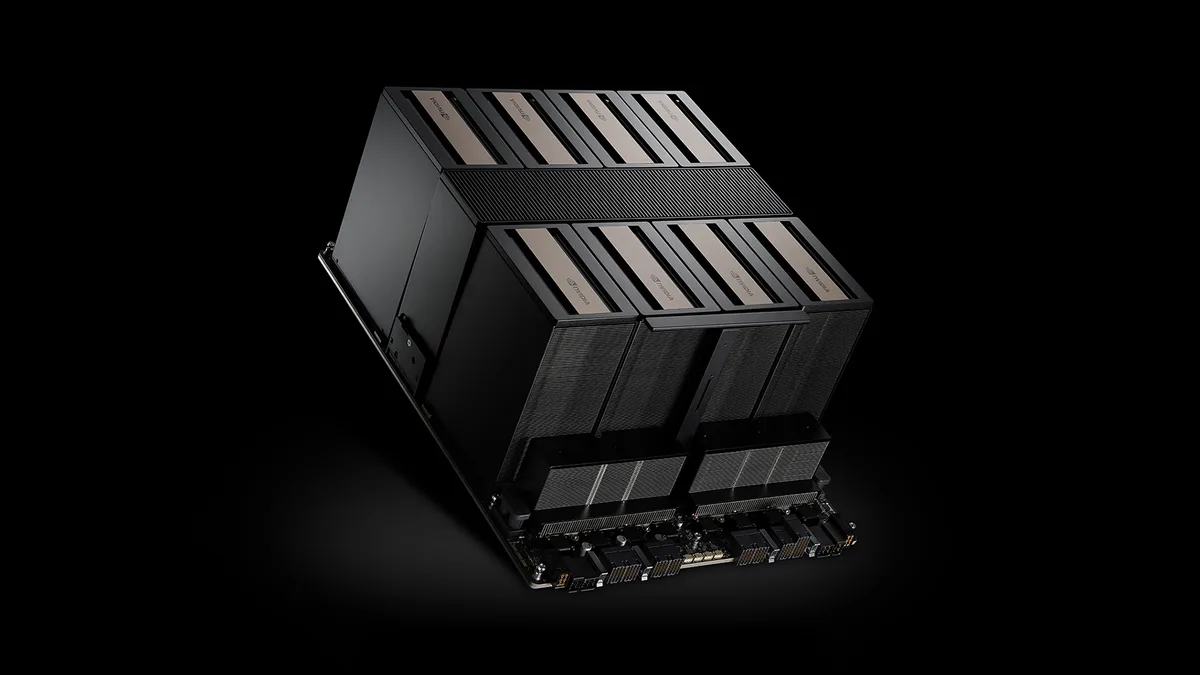
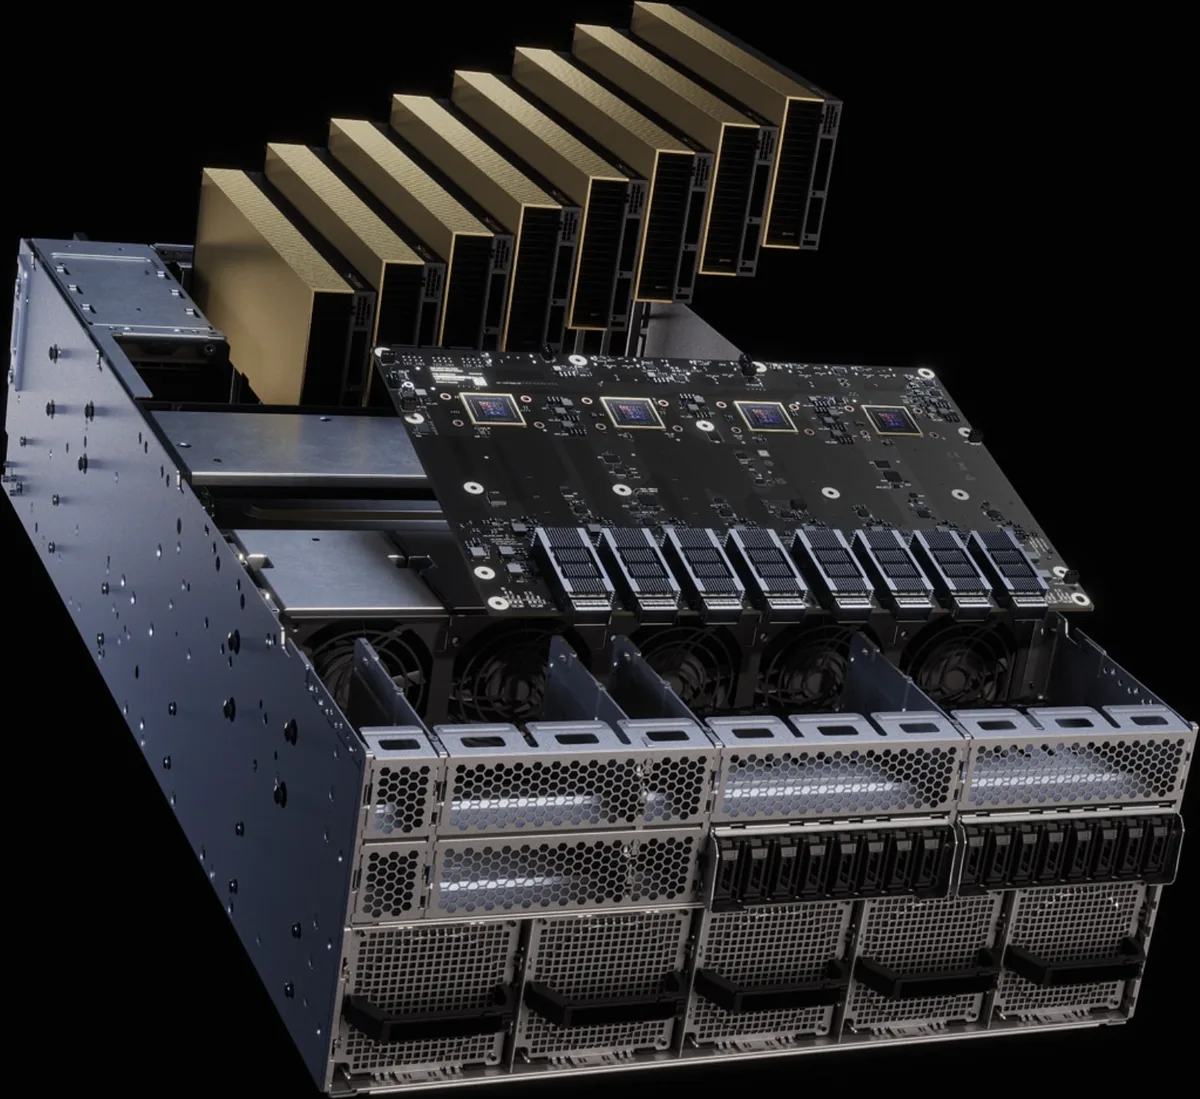
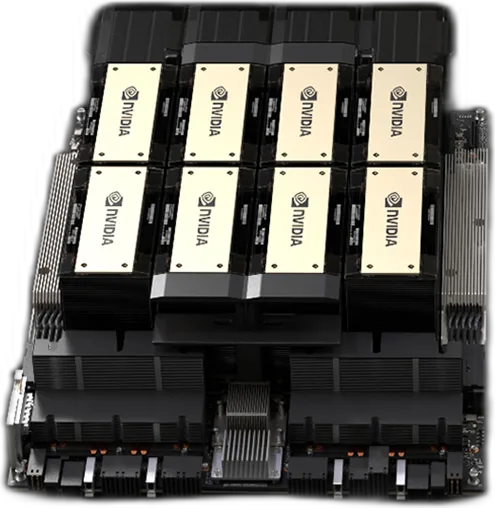
NVIDIA HGX

合作伙伴伺服器內的八 GPU 基板

HGX 是 NVIDIA 採用 NVLink 互連的 GPU 基板,由伺服器廠商整合到自有系統中,讓您在獲得頂級 GPU 的同時自由選擇機箱、CPU 和支援品牌。

適用物件: 希望從首選伺服器廠商處獲得旗艦 GPU 的機構

優勢

  • 自由選擇適合您現有環境的伺服器品牌、CPU 和儲存
  • NVLink 和 NVSwitch 以全速連線全部八個 GPU
  • 涵蓋 Blackwell、Blackwell Ultra 和 Rubin 各代產品

主要規格

HGX B3008× Blackwell Ultra SXM, 2.1 TB, 144 PFLOPS FP4 (sparse)
HGX B2008× Blackwell SXM, 1.4 TB, 144 PFLOPS FP4 (sparse)
HGX Rubin NVL88× Rubin SXM, 2 TB HBM4, 400 PFLOPS NVFP4 inference
NVLink 頻寬14.4 TB/s total (HGX B300 and B200)

Workstation 提供的服務: 我們從您首選的品牌採購 HGX 伺服器,在我們的車間進行滿負載老化測試,並與您的網路一同安裝。

價格請詢價索取報價 ↗
在 NVIDIA.com 上檢視 ↗
系統與平臺

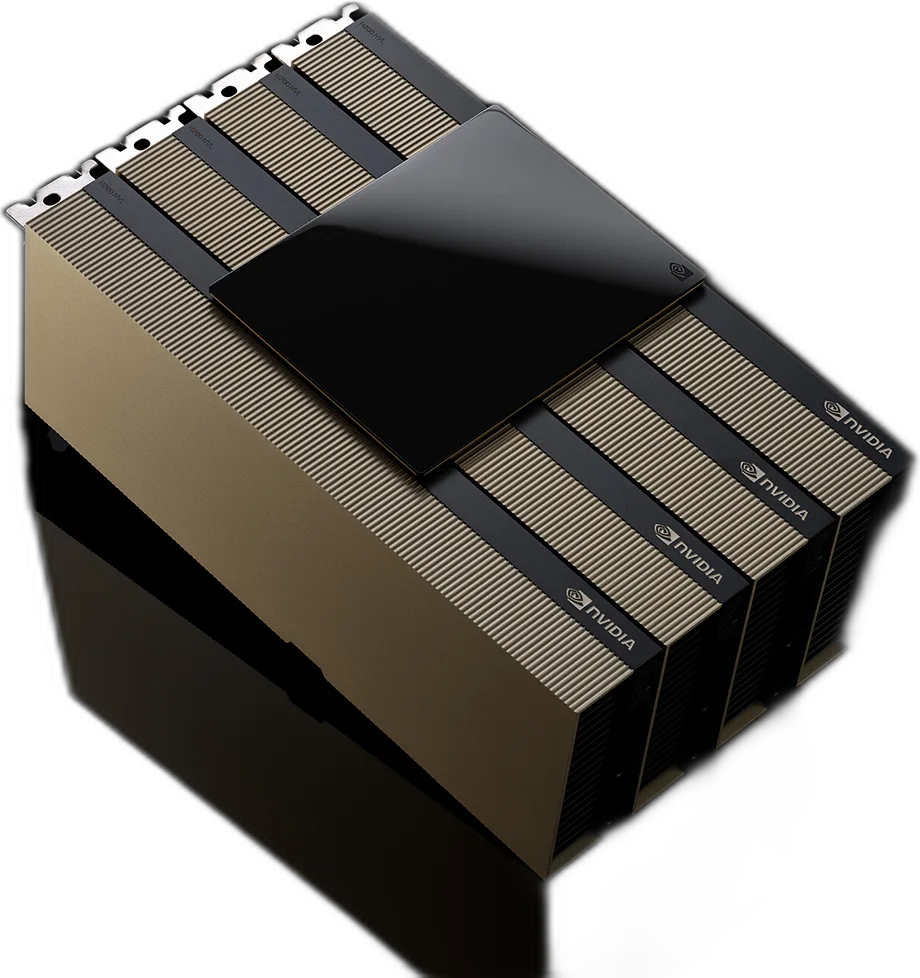
NVIDIA RTX PRO Server

面向企業 AI 與圖形的通用 Blackwell 伺服器

一款資料中心伺服器,最多配備八個 RTX PRO 6000 Blackwell Server Edition GPU,在同一平臺上執行 AI、模擬、渲染和虛擬工作站。這是 NVIDIA 的主流加速伺服器,其 EGX 頁面現已指向該產品。

適用物件: 在推出新 AI 服務的同時,將現有資料中心工作負載遷移到 GPU 的企業

優勢

  • 一種伺服器即可滿足 AI 推理、視覺計算和資料科學需求
  • 風冷選項適合大多數現有伺服器機房
  • 已透過 NVIDIA AI Enterprise 和 Omniverse 驗證

主要規格

GPUUp to 8× RTX PRO 6000 Blackwell Server Edition
GPU 視訊記憶體800 GB (8-GPU configuration)
記憶體頻寬13 TB/s (8-GPU configuration)
RTX 圖形3 PFLOPS
配置MGX 2U, 4U and 6U (6U liquid cooled)

Workstation 提供的服務: 我們根據您的工作負載確定機箱和 GPU 數量,確認其為 NVIDIA-Certified,然後完成組裝、老化測試和安裝。

價格請詢價索取報價 ↗
在 NVIDIA.com 上檢視 ↗
系統與平臺

NVIDIA DGX SuperPOD

面向大規模 AI 工廠的交鑰匙藍圖

一套全棧參考架構,將 DGX 系統、NVIDIA 網路、認證儲存和管理軟體組合為可複製的可擴充套件單元。

適用物件: 構建數百乃至數千 GPU 叢集的研究實驗室、大型企業和 AI 服務提供商

優勢

  • 經過測試的設計大幅降低整合風險
  • 以可複製單元擴充套件至數萬個 GPU
  • 包含用於運維的 Mission Control 和 Base Command Manager

主要規格

型別Reference architecture
構建模組Scalable units of DGX systems
規模Up to tens of thousands of GPUs
儲存NVIDIA-certified partner storage
軟體NVIDIA AI Enterprise, Base Command Manager, Mission Control

Workstation 提供的服務: 我們與 NVIDIA 及儲存合作伙伴共同主導設計,執行專案計劃,安裝可擴充套件單元,並持續擔任您的支援聯絡人。

價格請詢價索取報價 ↗
在 NVIDIA.com 上檢視 ↗
系統與平臺

NVIDIA DGX BasePOD

適用於您首個 DGX 叢集的參考設計

一套經過驗證的設計,適用於兩臺或更多 DGX 系統,並配有匹配的網路、儲存和叢集軟體:規模小於 SuperPOD,但構建方式相同。

適用物件: 從單臺 DGX 系統發展為小型共享叢集的團隊

優勢

  • 從兩臺系統起步,擴容無需重新設計
  • 網路和儲存與 GPU 相匹配
  • 包含用於排程和監控的叢集軟體

主要規格

型別Reference architecture
規模2 or more DGX systems
網路Per reference architecture
儲存Partner storage
軟體NVIDIA AI Enterprise, Base Command

Workstation 提供的服務: 我們為叢集選型,供應全部部件,完成上架和佈線,並配置排程,讓您的團隊從第一天起即可共享使用。

價格請詢價索取報價 ↗
在 NVIDIA.com 上檢視 ↗
系統與平臺

NVIDIA Grace 與 Vera CPU

專為 AI 工廠打造的 Arm 資料中心 CPU

NVIDIA 自研 CPU 透過 NVLink-C2C 與其 GPU 相連。Grace CPU Superchip 目前已搭載於合作伙伴伺服器中,其後繼產品 Vera 面向代理式 AI。

適用物件: HPC 中心、雲構建者,以及在 GPU 之外還執行 CPU 密集型流程的使用者

優勢

  • LPDDR5X 帶來高記憶體頻寬
  • 據 NVIDIA 資料,同等功耗下效能是領先傳統 CPU 的兩倍
  • 與 NVIDIA GPU 的一致性高速互連

主要規格

Grace CPU Superchip144 Arm Neoverse V2 cores, 2 CPUs over 900 GB/s NVLink-C2C
Grace 記憶體頻寬Up to 1 TB/s LPDDR5X
Vera CPU88 Olympus cores, up to 1.5 TB memory at up to 1.2 TB/s
Vera NVLink-C2CUp to 1.8 TB/s

Workstation 提供的服務: 我們為您的軟體棧尋找合適的合作伙伴伺服器,與您一同在 Arm 上測試應用,然後完成構建並提供支援。

價格請詢價索取報價 ↗
在 NVIDIA.com 上檢視 ↗
系統與平臺

NVIDIA OVX

面向 Omniverse 和數字孿生的 L40S 伺服器

OVX 是 NVIDIA 針對 Omniverse 驗證的伺服器設計,將 L40S GPU 與 ConnectX-7 或 BlueField-3 網路結合,用於模擬、渲染和 AI。

適用物件: 構建工業數字孿生的製造商、建築師和工程團隊

優勢

  • 一臺伺服器兼顧圖形、模擬和 AI 推理
  • 已透過 Omniverse 和 NVIDIA AI Enterprise 驗證
  • 可在高速網路上擴充套件至數百臺伺服器

主要規格

GPU4× or 8× NVIDIA L40S
CPU2× Intel Xeon Gold or 2× AMD EPYC
主機記憶體384 GB (4-GPU) or 768 GB (8-GPU) DDR5 ECC minimum
儲存1 TB NVMe boot, 2× 4 TB NVMe
網路ConnectX-7 or BlueField-3

Workstation 提供的服務: 我們採用認證合作伙伴的產品構建 OVX 架構伺服器,配置 Omniverse 和驅動,並將其連線到您的設計工具。

價格請詢價索取報價 ↗
在 NVIDIA.com 上檢視 ↗
系統與平臺

NVIDIA AGX (Jetson AGX Thor)

面向機器人和自主機器的 AI 計算機

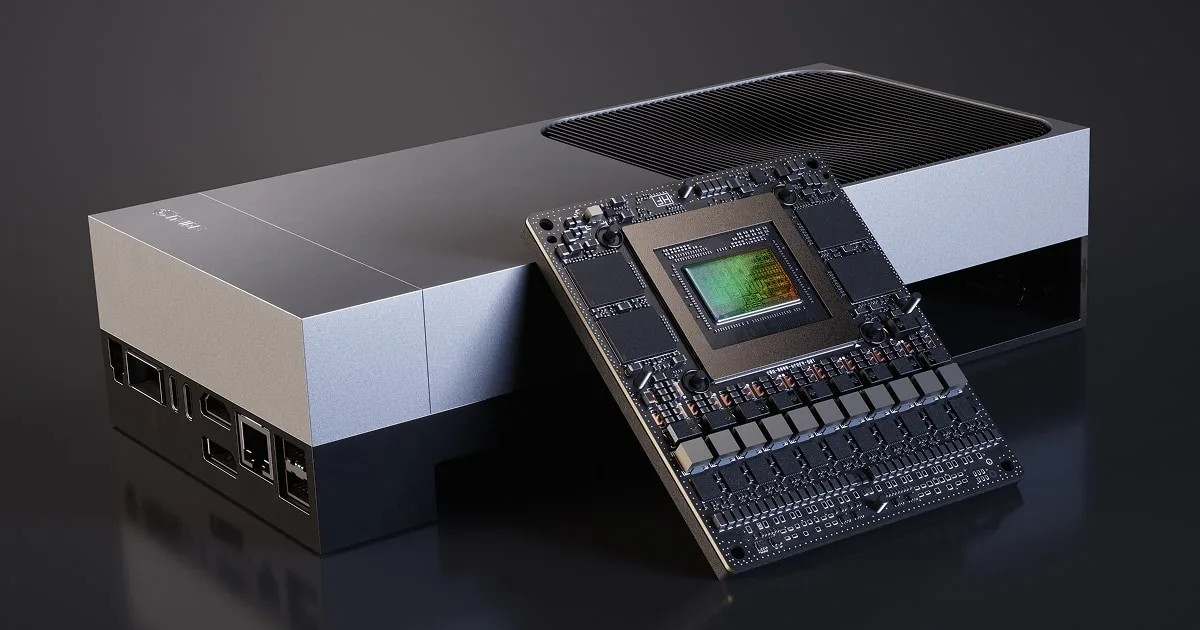
AGX 是 NVIDIA 面向自主機器的平臺。其當前旗艦 Jetson AGX Thor 將 Blackwell GPU 帶入機器人、車輛和智慧機器。

適用物件: 將 AI 融入機器的機器人、汽車和工業團隊

優勢

  • 在機器本地執行感知和生成式 AI 模型
  • 低功耗,適合移動和嵌入式設計
  • 使用與 NVIDIA 資料中心平臺相同的 CUDA 軟體

主要規格

GPUBlackwell, 2560 CUDA cores, 96 fifth-generation Tensor Cores
AI 效能2070 TFLOPS (FP4)
選項Developer kit, or T5000 and T4000 production modules

Workstation 提供的服務: 我們供應開發者套件和量產模組,協助選擇載板和外殼,併為您提供從原型到量產部署的全程支援。

價格請詢價索取報價 ↗
在 NVIDIA.com 上檢視 ↗
系統與平臺

NVIDIA IGX Thor

具備功能安全的工業邊緣 AI

IGX 是 NVIDIA 面向工業和醫療邊緣物理 AI 的企業級平臺,配備專用安全島和長期軟體支援。

適用物件: 需要安全認證和長期支援週期的醫療裝置製造商、工廠和基礎設施運營商

優勢

  • 功能安全設計面向 ISO 26262 和 IEC 61508
  • 十年 NVIDIA 企業級軟體支援
  • 可選配 RTX PRO Blackwell GPU,執行更大模型

主要規格

AI 效能Up to 5,581 TFLOPS FP4 (sparse) with discrete GPU
整合 GPU2,560-core Blackwell
CPU14-core Arm Neoverse-V3AE, 2.6 GHz
記憶體128 GB LPDDR5X, 273 GB/s
功耗40–130 W, up to 300 W for the discrete GPU

Workstation 提供的服務: 我們供應開發者套件和量產系統,協助您規劃認證所需材料,並支援在您現場的部署。

價格請詢價索取報價 ↗
在 NVIDIA.com 上檢視 ↗

系統與平臺

NVIDIA Groq 3 LPX

面向 Vera Rubin 的低延遲推理機架

LPX 是由 256 個 LPU 推理加速器組成的機架,與 Vera Rubin NVL72 協同工作,為互動式和代理式 AI 快速、穩定地生成 token。

適用物件: 使用者需要快速、穩定響應時間的 AI 服務提供商

優勢

  • 確定性的低延遲 token 生成
  • 據 NVIDIA 預測,萬億引數模型的每兆瓦吞吐量大幅提升
  • 與 NVL72 機架直接低延遲互連

主要規格

加速器256 LPUs per rack
片上記憶體128 GB SRAM per rack (500 MB per LPU)
SRAM 頻寬40 PB/s per rack
縱向擴充套件頻寬640 TB/s per rack
外形規格NVIDIA MGX ETL rack

Workstation 提供的服務: 我們評估其如何契合您的 Vera Rubin 規劃,與 NVIDIA 確認供貨情況,並與您的其他機架統籌規劃安裝。

價格請詢價索取報價 ↗
在 NVIDIA.com 上檢視 ↗

資料中心 GPU

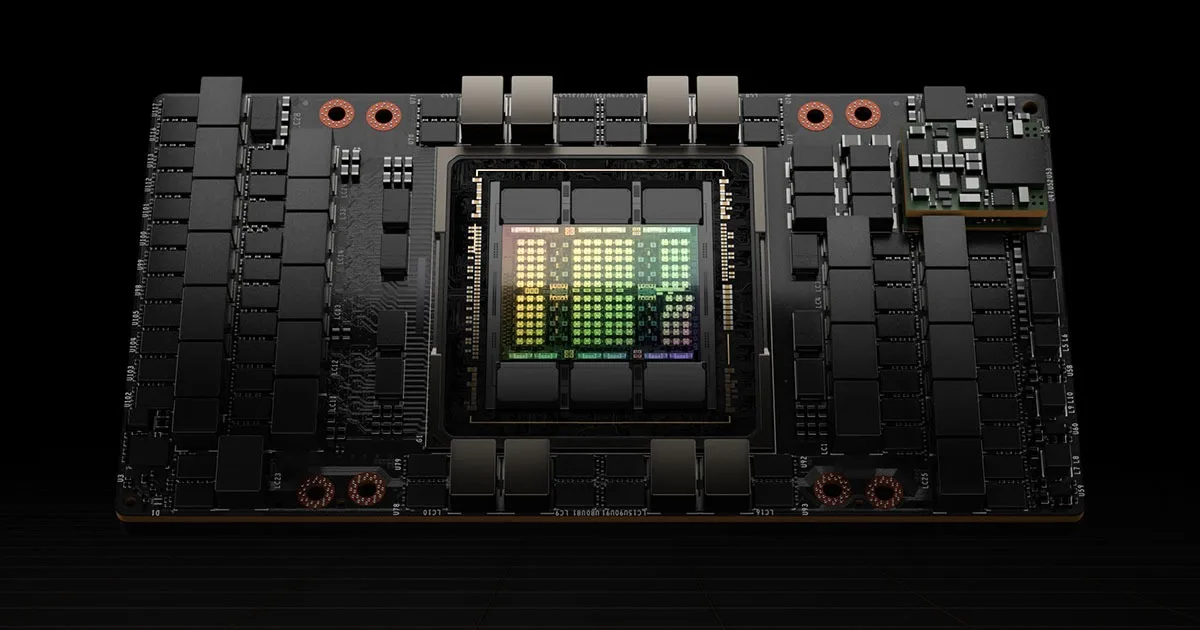
NVIDIA H200 (SXM)

配備 141 GB HBM3e 的 Hopper GPU

H200 延續 Hopper 架構,但視訊記憶體容量更大、速度更快,有助於大模型推理和受記憶體限制的 HPC 任務。SXM 版本用於 HGX 伺服器。

適用物件: 在 HGX 伺服器上執行大語言模型和 HPC 程式碼的團隊

優勢

  • 每 GPU 141 GB,可容納更大模型而無需拆分
  • 更高記憶體頻寬加速受記憶體限制的任務
  • 執行與 H100 相同的 CUDA 軟體

主要規格

架構NVIDIA Hopper
GPU 視訊記憶體141 GB HBM3e
外形規格SXM (HGX)
冷卻Passive (server airflow)

Workstation 提供的服務: 我們以認證 HGX 伺服器的形式供應 H200,完成老化測試,並與您的驅動和軟體棧一同安裝。

價格請詢價索取報價 ↗
在 NVIDIA.com 上檢視 ↗

資料中心 GPU

NVIDIA H200 NVL

面向風冷 PCIe 伺服器的 141 GB Hopper GPU

適用於標準企業機架的 H200 PCIe 版本。NVLink 橋接器可將顯示卡兩兩配對,滿足需要更大記憶體的模型。

適用物件: 在現有風冷伺服器機房中增加大模型推理能力的企業

優勢

  • 無需改用液冷即可獲得大容量 GPU 記憶體
  • NVLink 橋接器連線多個 GPU,支援更大模型
  • 適配主流 NVIDIA-Certified 伺服器

主要規格

架構NVIDIA Hopper
GPU 視訊記憶體141 GB HBM3e
外形規格PCIe, dual slot
冷卻Passive (server airflow)

Workstation 提供的服務: 我們核查您機箱的供電、氣流和插槽佈局,然後安裝、測試並交付顯示卡或整機伺服器。

價格請詢價索取報價 ↗
在 NVIDIA.com 上檢視 ↗

資料中心 GPU

NVIDIA H100 PCIe 80 GB

面向 PCIe 伺服器訓練與推理的 Hopper GPU

PCIe 版 H100 將 Hopper 的 Transformer Engine 和機密計算能力帶到標準伺服器上。

適用物件: 已有 PCIe GPU 伺服器、需要成熟 Hopper 效能的團隊

優勢

  • Transformer Engine 加速語言模型的訓練和推理
  • Multi-Instance GPU 可將一張顯示卡劃分為多個隔離例項
  • 硬體支援機密計算

主要規格

架構NVIDIA Hopper
GPU 視訊記憶體80 GB HBM2e
外形規格Dual-slot, full height, full length
冷卻Passive (server airflow)
介面PCIe

Workstation 提供的服務: 我們將 H100 安裝到經認證的伺服器中,完成老化測試,並配置 CUDA、驅動以及所需的 vGPU 或 AI Enterprise 許可證。

價格請詢價索取報價 ↗
在 NVIDIA.com 上檢視 ↗

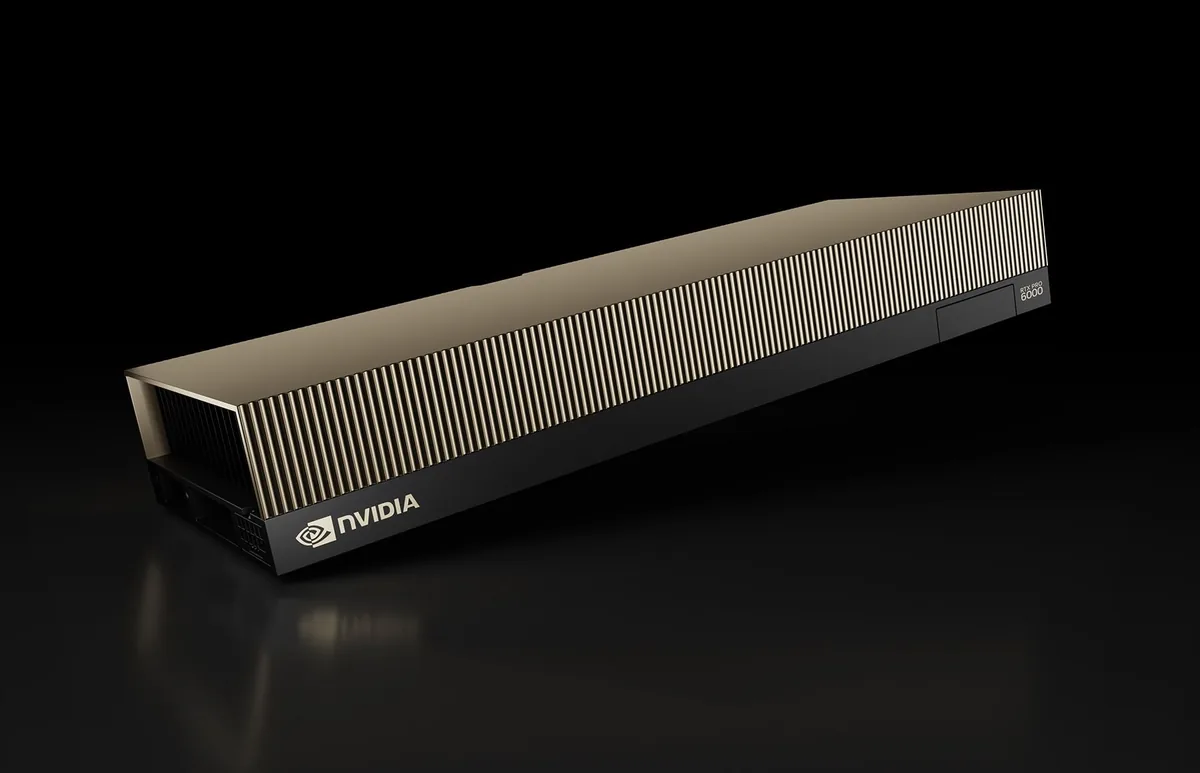
資料中心 GPU

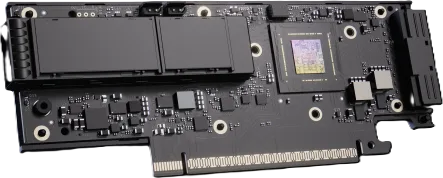
NVIDIA RTX PRO 6000 Blackwell Server Edition

面向機架伺服器的 96 GB Blackwell GPU

一款被動散熱的 Blackwell 顯示卡,配備 96 GB 視訊記憶體,適用於資料中心的 AI 推理、渲染、模擬和虛擬工作站。

適用物件: 將 AI 與圖形工作負載整合到同一類 GPU 上的企業

優勢

  • 每 GPU 96 GB,可處理大模型和大型場景
  • 同時支援 AI 和專業圖形
  • 功耗可配置,適配不同伺服器

主要規格

架構NVIDIA Blackwell
GPU 視訊記憶體96 GB GDDR7 with ECC
最大功耗Up to 600 W (configurable)
介面PCIe 5.0 x16
外形規格Dual-slot, passive (server airflow)

Workstation 提供的服務: 我們可單獨供應顯示卡,也可整合在 RTX PRO Server 中供貨,並在交付前進行滿負載測試。

價格請詢價索取報價 ↗
在 NVIDIA.com 上檢視 ↗

資料中心 GPU

NVIDIA RTX PRO 4500 Blackwell Server Edition

面向高密度伺服器的單槽 Blackwell GPU

一款緊湊型被動散熱 32 GB Blackwell GPU,可在單臺伺服器中安裝多張顯示卡,用於推理、影片和虛擬桌面。

適用物件: 以更低單 GPU 成本為大量使用者擴充套件推理或虛擬桌面的團隊

優勢

  • 單槽設計,每臺伺服器可容納更多 GPU
  • 32 GB GDDR7,適合中等規模模型
  • 功耗更低,適合現有機架

主要規格

架構NVIDIA Blackwell
GPU 視訊記憶體32 GB GDDR7
外形規格Single slot, 4.4" H × 10.5" L
冷卻Passive (server airflow)

Workstation 提供的服務: 我們測算您的伺服器可供電和散熱的顯示卡數量,然後完成配置的組裝與測試。

價格請詢價索取報價 ↗
在 NVIDIA.com 上檢視 ↗

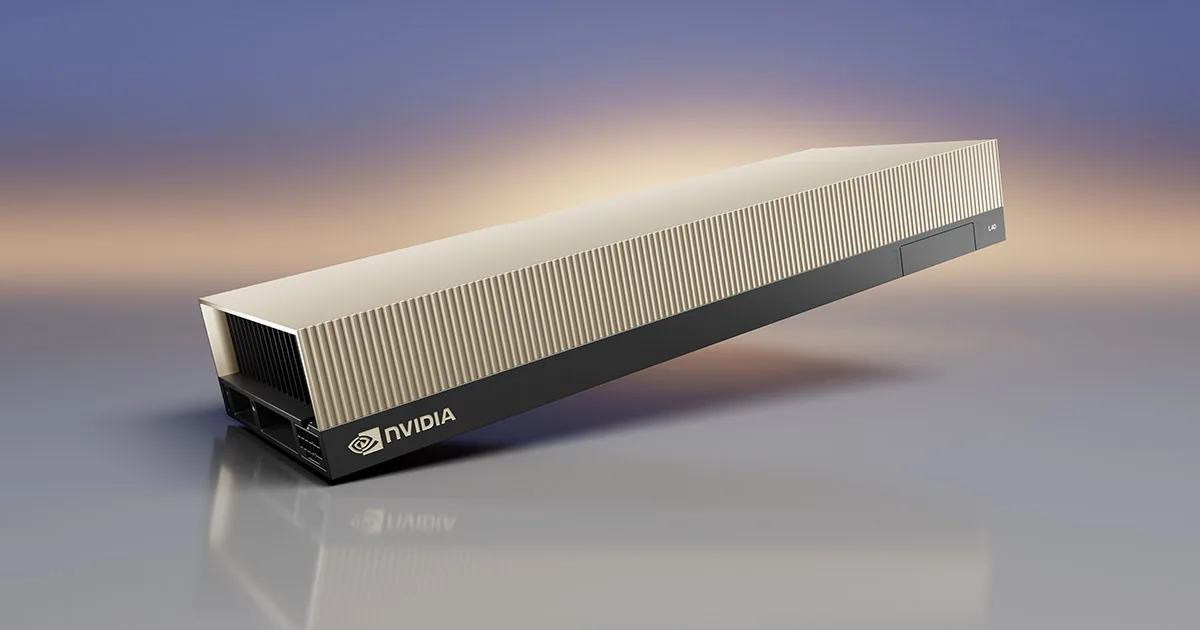
資料中心 GPU

NVIDIA L40S

48 GB 全能型 GPU,兼顧 AI 與圖形

一款 Ada Lovelace 資料中心 GPU,在推理、微調和 3D 圖形之間取得平衡,也是 NVIDIA OVX 設計所採用的 GPU。

適用物件: 需要一款 GPU 同時處理 AI 和視覺工作負載的團隊

優勢

  • 推理和微調效能出色,價效比高
  • 硬體光線追蹤,適用於渲染和 Omniverse
  • 適用於主流伺服器的標準 PCIe 顯示卡

主要規格

架構NVIDIA Ada Lovelace
GPU 視訊記憶體48 GB GDDR6 with ECC
外形規格Dual-slot, 4.4" H × 10.5" L
冷卻Passive (server airflow)
介面PCIe

Workstation 提供的服務: 我們為 L40S 匹配經認證的伺服器,完成老化測試,並在配置好驅動和許可證後安裝交付。

價格請詢價索取報價 ↗
在 NVIDIA.com 上檢視 ↗

資料中心 GPU

NVIDIA L40

面向渲染和虛擬工作站的 48 GB GPU

L40 專注於圖形:資料中心內的渲染、Omniverse 和虛擬工作站。

適用物件: 將工作站遷入資料中心的設計和媒體團隊

優勢

  • 48 GB,滿足大型場景和素材需求
  • 支援 NVIDIA 虛擬 GPU 軟體
  • 被動散熱,適用於標準伺服器

主要規格

架構NVIDIA Ada Lovelace
GPU 視訊記憶體48 GB GDDR6 with ECC
外形規格Dual-slot, 4.4" H × 10.5" L
冷卻Passive (server airflow)
介面PCIe

Workstation 提供的服務: 我們配置 vGPU 配置檔案和許可證,讓使用者獲得如同本地般流暢的遠端工作站。

價格請詢價索取報價 ↗
在 NVIDIA.com 上檢視 ↗

資料中心 GPU

NVIDIA L4

面向高效推理和影片的半高 GPU

一款小巧低功耗的 Ada Lovelace 顯示卡,適用於從邊緣到資料中心的影片 AI、推理和虛擬桌面。

適用物件: 在大量伺服器或電力預算緊張的邊緣站點上增加 AI 能力的機構

優勢

  • 低功耗、半高顯示卡,幾乎適配任何伺服器
  • 非常適合影片分析和推理
  • 可經濟高效地擴充套件到大量節點

主要規格

架構NVIDIA Ada Lovelace
GPU 視訊記憶體24 GB GDDR6
外形規格Single-slot, low profile
冷卻Passive (server airflow)
介面PCIe

Workstation 提供的服務: 我們檢查與您現有伺服器的相容性,供應顯示卡,並配置驅動和推理軟體。

價格請詢價索取報價 ↗
在 NVIDIA.com 上檢視 ↗

網路

NVIDIA Spectrum-X 乙太網平臺

專為 AI 工廠最佳化的乙太網

Spectrum-X 將 Spectrum 乙太網交換機與 Spectrum-X SuperNIC 相結合,為 AI 叢集提供可預測的高吞吐量乙太網。

適用物件: 希望採用網路團隊已熟悉運維方式的 AI 網路的機構

優勢

  • GPU 間流量的有效頻寬高於標準乙太網
  • 沿用熟悉的乙太網工具和技能
  • 屬於 NVIDIA 經過驗證的 AI 工廠設計的一部分

主要規格

型別Ethernet networking platform
元件NVIDIA Spectrum Ethernet switches + Spectrum-X SuperNICs
使用場景AI clusters and AI factories

Workstation 提供的服務: 我們設計網路架構,供應交換機、SuperNIC 和線纜,完成安裝和測試,併為您的團隊編寫文件。

價格請詢價索取報價 ↗
在 NVIDIA.com 上檢視 ↗

網路

NVIDIA Quantum-X800 InfiniBand 平臺

面向大規模訓練的新一代 InfiniBand

Quantum-X800 交換機與 ConnectX-8 SuperNIC 組成 NVIDIA 效能最高的 InfiniBand 網路,適用於 AI 訓練和 HPC。

適用物件: 開展大規模訓練的 HPC 中心和 AI 團隊

優勢

  • 為緊耦合任務提供極低延遲
  • 專為最大規模的訓練和 HPC 叢集設計
  • 透過 UFM 進行管理和監控

主要規格

型別InfiniBand networking platform
元件NVIDIA Quantum-X800 InfiniBand switches + ConnectX-8 SuperNICs
使用場景Large-scale AI training and HPC

Workstation 提供的服務: 我們設計拓撲,供應並連線每條鏈路,並在 UFM 監控就緒的情況下啟用網路。

價格請詢價索取報價 ↗
在 NVIDIA.com 上檢視 ↗

網路

NVIDIA Spectrum 乙太網交換機

速率高達 800 Gb/s 的資料中心乙太網交換機

Spectrum 交換機承載 AI、儲存和雲流量,可單獨使用,也可作為 Spectrum-X 的一部分。

適用物件: 更新 leaf-spine 交換架構的資料中心和網路團隊

優勢

  • 埠速率高達 800 Gb/s
  • 適用於 AI 網路和通用資料中心網路
  • 可搭配 NetQ 進行網路運維和遙測

主要規格

型別Ethernet switch family
埠速率Up to 800 Gb/s
用途AI and cloud data-centre fabrics

Workstation 提供的服務: 我們規劃埠和光模組,配置交換機,並將其與您的現有網路整合。

價格請詢價索取報價 ↗
在 NVIDIA.com 上檢視 ↗

網路

NVIDIA Quantum InfiniBand 交換機

面向 HPC 和 AI 的低延遲交換

Quantum InfiniBand 交換機構建 HPC 和 AI 叢集所依賴的低延遲網路。

適用物件: 擁有緊耦合工作負載的科研計算和 AI 團隊

優勢

  • 節點間延遲極低
  • 已在 HPC 和 AI 叢集中得到驗證
  • 透過 UFM 集中管理

主要規格

型別InfiniBand switch family
用途HPC and AI data centres

Workstation 提供的服務: 我們規劃拓撲,供應線纜和光模組,並完成網路的安裝與驗證。

價格請詢價索取報價 ↗
在 NVIDIA.com 上檢視 ↗

網路

NVIDIA ConnectX NIC 與 SuperNIC

適用於乙太網和 InfiniBand 的網路介面卡

ConnectX 介面卡將伺服器接入網路。ConnectX-8 等 SuperNIC 專為 AI 叢集中的 GPU 間流量最佳化。

適用物件: 需要將 GPU 伺服器或儲存接入高速網路的使用者

優勢

  • 同一產品系列覆蓋乙太網和 InfiniBand
  • SuperNIC 為每個 GPU 提供專屬高速通道
  • 硬體解除安裝降低 CPU 負載

主要規格

型別Network adapter and SuperNIC family
網路型別Ethernet and InfiniBand
最高速率800 Gb/s per GPU (ConnectX-8 SuperNIC)

Workstation 提供的服務: 我們為您的交換機和伺服器匹配介面卡、線纜和光模組,並安裝韌體和驅動。

價格請詢價索取報價 ↗
在 NVIDIA.com 上檢視 ↗

網路

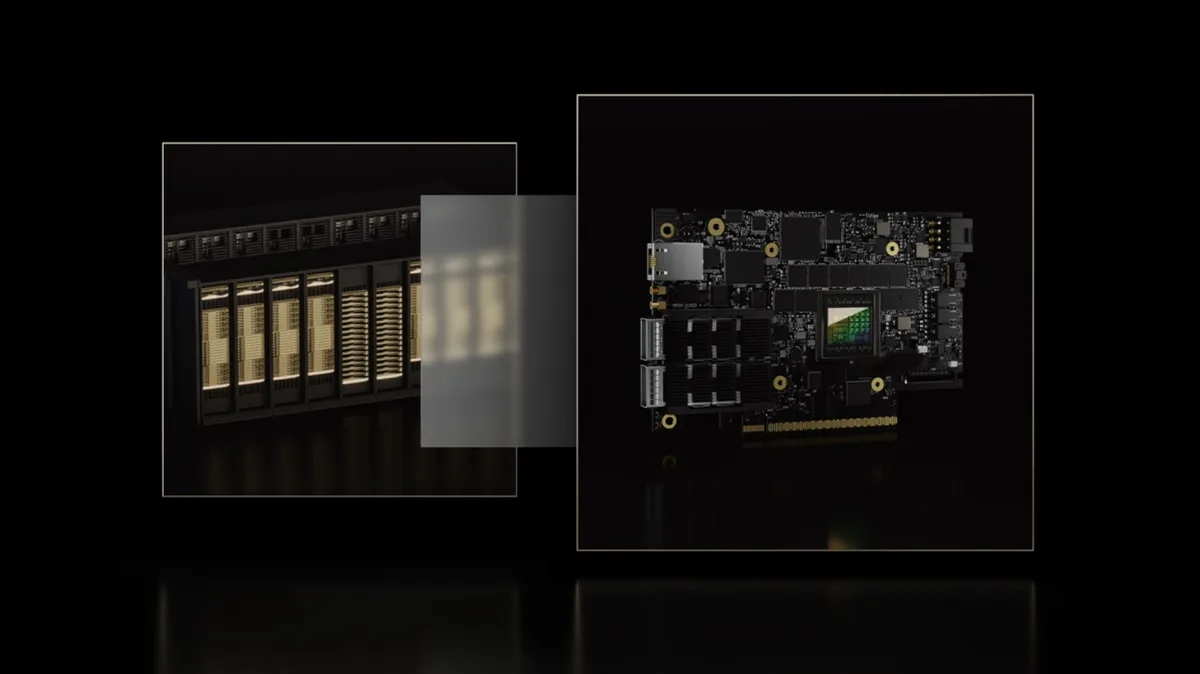
NVIDIA BlueField DPU

面向網路、儲存和安全的資料處理器

BlueField DPU 將網路、儲存和安全任務從伺服器 CPU 上解除安裝,並在專用硬體中隔離執行。

適用物件: 雲構建者、AI 工廠和重視安全的機構

優勢

  • 為應用釋放 CPU 核心
  • 將基礎設施服務與租戶工作負載隔離
  • 可透過 NVIDIA DOCA 程式設計

主要規格

型別Data processing unit (DPU) family
產品代際BlueField-3, BlueField-4
軟體NVIDIA DOCA

Workstation 提供的服務: 我們供應並安裝 BlueField 卡,並協助您部署所需的 DOCA 服務。

價格請詢價索取報價 ↗
在 NVIDIA.com 上檢視 ↗

軟體

NVIDIA AI Enterprise

面向生產環境 AI 的受支援軟體

NVIDIA 的 AI 框架、NIM 微服務和工具套件,提供企業級支援和長期釋出分支。

適用物件: 任何在 NVIDIA GPU 上將 AI 投入生產的機構

優勢

  • 企業級支援和穩定的釋出分支
  • NIM 微服務讓模型部署更快捷
  • 可在本地或雲端的 NVIDIA-Certified 系統上執行

主要規格

許可方式Per GPU subscription
包含AI frameworks, NIM microservices, pretrained models
支援NVIDIA Enterprise Business Standard Support
試用90-day evaluation

Workstation 提供的服務: 我們提供許可證報價並完成啟用,隨硬體一同安裝軟體,並在續訂前提醒您。

價格請詢價索取報價 ↗
在 NVIDIA.com 上檢視 ↗

軟體

NVIDIA Mission Control

面向 AI 工廠的運維軟體

Mission Control 將大型 GPU 叢集的日常執行自動化,涵蓋從工作負載編排到健康檢查和故障恢復的各個環節。

適用物件: DGX SuperPOD 及其他大型 AI 叢集的運營方

優勢

  • 自動化日常叢集運維
  • 透過檢測故障並自動恢復提升系統韌性
  • 統一檢視檢視工作負載和基礎設施

主要規格

型別AI-factory operations and cluster management software
功能Workload orchestration, infrastructure resiliency, cluster automation
許可依據Confirmed on quote

Workstation 提供的服務: 我們隨您的叢集一同部署 Mission Control,並培訓您的運維人員使用。

價格請詢價索取報價 ↗
在 NVIDIA.com 上檢視 ↗

軟體

NVIDIA Run:ai

GPU 編排與排程

Run:ai 將各團隊的 GPU 彙整合資源池並按需分配,讓昂貴的硬體持續運轉而非閒置。

適用物件: 在眾多資料科學家或專案之間共享 GPU 的機構

優勢

  • 透過動態資源池提升 GPU 利用率
  • 配額、優先順序和訪問控制,確保公平共享
  • 適用於本地、混合和雲環境

主要規格

型別GPU orchestration and scheduling platform
執行平臺Kubernetes
部署方式On premises, hybrid or cloud
許可依據Confirmed on quote

Workstation 提供的服務: 我們在您的 Kubernetes 叢集上安裝 Run:ai,與您的團隊一起設定配額,並提供支援。

價格請詢價索取報價 ↗
在 NVIDIA.com 上檢視 ↗

軟體

NVIDIA Base Command Manager

叢集配置與監控

Base Command Manager 可對 GPU 叢集進行配置、監控和管理,從少量節點起即可使用。

適用物件: 運維各種規模 GPU 叢集的 IT 團隊

優勢

  • 在 Arm 和 x86 上自動化配置
  • 健康儀表板和實時監控
  • Web 介面、命令列和 API

主要規格

型別Cluster management software
免費許可證Up to 8 accelerators per system
當前版本Base Command Manager 11
介面BaseView web UI, CLI, API

Workstation 提供的服務: 我們在構建叢集時一併安裝和配置 Base Command Manager。

價格請詢價索取報價 ↗
在 NVIDIA.com 上檢視 ↗

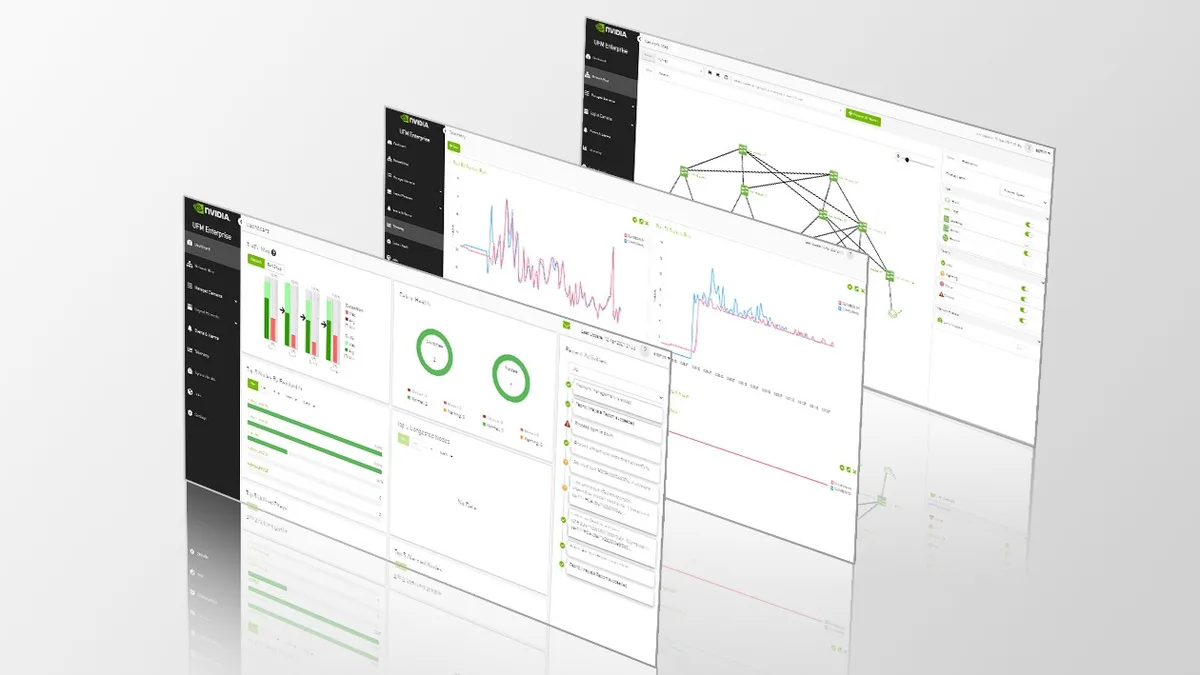
軟體

NVIDIA UFM

面向 InfiniBand 的 Unified Fabric Manager

UFM 用於監控、管理 InfiniBand 網路並協助排查故障。

適用物件: 運維 InfiniBand 叢集的團隊

優勢

  • 實時網路遙測
  • 更快定位故障
  • 集中管理交換機和鏈路

主要規格

型別InfiniBand fabric management and telemetry software
相容NVIDIA Quantum InfiniBand switches

Workstation 提供的服務: 我們隨您的網路一同部署 UFM,並按照您的運維流程設定告警。

價格請詢價索取報價 ↗
在 NVIDIA.com 上檢視 ↗

軟體

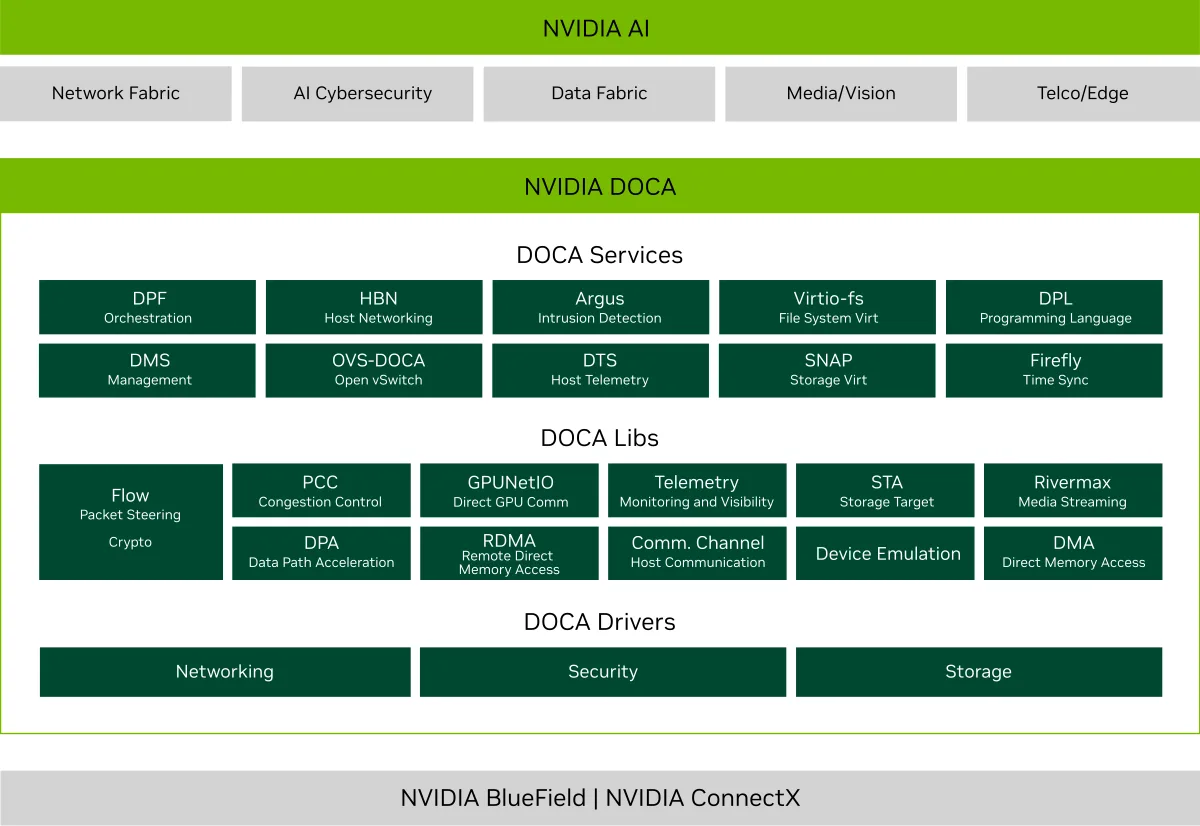
NVIDIA DOCA

面向 BlueField 和 SuperNIC 的軟體框架

DOCA 是用於構建在 BlueField DPU 和 SuperNIC 上執行的服務的 SDK 和執行時。

適用物件: 基於 BlueField 進行開發的開發者和平臺團隊

優勢

  • 一個框架覆蓋各代 DPU 和 SuperNIC
  • 加快解除安裝服務的開發
  • 用於在生產環境中部署這些服務的執行時

主要規格

型別SDK and runtime framework
執行平臺NVIDIA BlueField DPUs and SuperNICs

Workstation 提供的服務: 我們協助搭建 DOCA 環境,並在我們供應的 BlueField 卡上部署服務。

價格請詢價索取報價 ↗
在 NVIDIA.com 上檢視 ↗

規格摘自 NVIDIA 公開發布的資訊,不同版本之間可能有所變化。標註為“稀疏”的資料基於稀疏性計算。每份報價都會確認具體配置、價格和交付週期。

Workstation 在每筆訂單中提供的服務

無論您購買一塊 GPU 還是一整排機架,都遵循相同的五個步驟

選型

我們從您的模型、資料、使用者和現場出發,規劃計算、記憶體、網路、供電和散熱。

供貨

我們透過 NVIDIA 及其伺服器合作伙伴採購,確認交付週期,並持續向您通報進展直至交付。

組裝與老化測試

系統在發貨前於我們的英國車間完成組裝、映象部署和滿負載壓力測試。

安裝

我們的工程師現場完成交付、上架、佈線和除錯,並隨附文件進行交接。

支援

同一團隊負責處理軟體問題、升級、許可證續訂和保修索賠。

所有 NVIDIA 類別

Trade 會員

Trade 會員的每筆訂單均享受免費技術支援和不限時的工程師服務 — 涵蓋配置、驅動、軟體和故障排查,只要您仍在使用裝置,服務就一直有效。

瞭解 Trade 會員

NVIDIA Blackwell:從晶片到資料中心

NVIDIA Blackwell: The Journey From Die to Data Center. 透過 NVIDIA 官方 YouTube 頻道播放。 在 YouTube 上觀看NVIDIA、Blackwell、DGX、Grace 和 RTX PRO 是 NVIDIA Corporation 的商標和/或註冊商標。此處僅用於描述我們供應的產品,並不表示獲得 NVIDIA 的認可。

查看 NVIDIA RTX PRO 6000 Blackwell Server Edition

NVIDIA RTX PRO:RTX PRO 6000 Blackwell Server Edition 上的 AI 與視覺運算。影片:NVIDIA Corporation。 透過 NVIDIA 官方 YouTube 頻道播放。 在 YouTube 上觀看閱讀 RTX PRO 6000 Server Edition 相關資訊 →NVIDIA、RTX PRO 與 Blackwell 為 NVIDIA Corporation 的商標及/或註冊商標。顯示僅為描述我們供應的產品;不代表獲得 NVIDIA 背書。

常見問題

為什麼所有產品都需要詢價?

加速計算的價格和供貨配額變化很快,而且大多數訂單取決於具體配置、現場條件和軟體。透過報價,我們可以針對您的實際需求確認當前價格、供貨情況和交付週期。

能否只供應單塊 GPU,而不是整套系統?

可以。我們供應單塊資料中心 GPU,但始終會確認您的伺服器已獲認證、能夠為其供電和散熱,我們也可以為您完成安裝和測試。

你們是否安裝機架級和液冷系統?

是的。對於 GB300 NVL72 等系統,我們會在交付前很早就與您的設施團隊就供電、散熱和地板承重展開協作,然後在現場完成安裝和除錯。

我們應從哪種 NVIDIA 平臺起步?

這取決於您的模型、使用者和現場。許多團隊先從 RTX PRO Server 或 L40S 起步,兼顧 AI 和圖形混合負載,再轉向 HGX 或 DGX 進行大規模訓練。諮詢我們的工程師,我們將為您推薦合適的起點。

規劃您的 NVIDIA 加速計算專案

告訴我們您需要執行什麼、部署在哪裡。工程師將回復您推薦配置和報價。

諮詢工程師