AI 知識庫 · Linux 作業系統
為 AI 調校的 Linux
我們出貨的每套 AI 系統都運行於 Linux。本指南涵蓋 Workstation 團隊支援的發行版、我們如何強化其安全性、對 GPU 重要的核心與驅動程式設定、我們如何在 Kubernetes 與 Docker 下運行它們、LLM API 如何在其上擴展,以及將模型、代理與資料安全送至正式環境的 CI/CD 管線。
- Ubuntu
- Red Hat Enterprise Linux
- SUSE Linux
- Alpine Linux
- Debian
- Rocky 與 AlmaLinux
選擇發行版
沒有單一最佳的 AI 用 Linux。正確的選擇取決於它在哪裡運行、由誰支援,以及還需要與哪些系統配合。這是我們通常的決策方式。
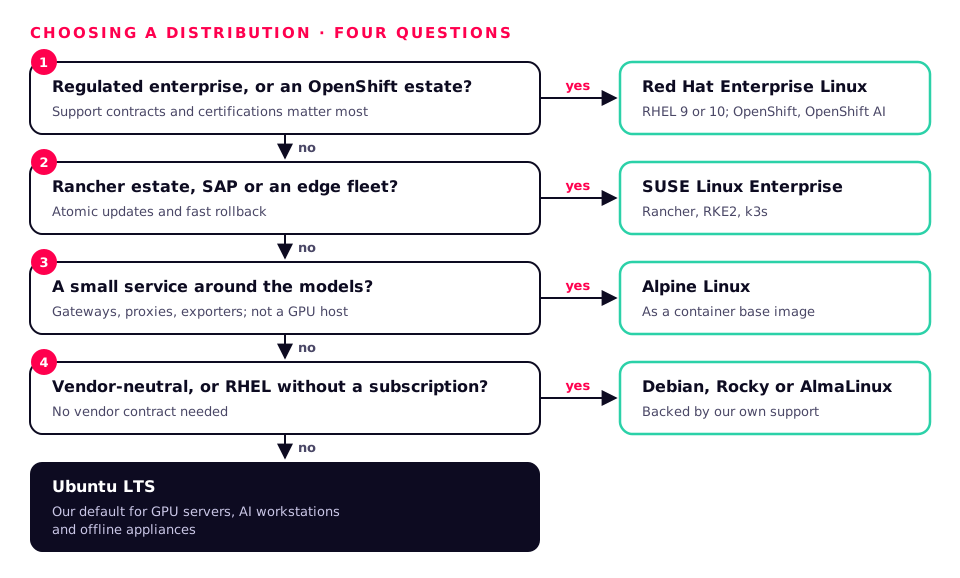
| 發行版 | 最適合 | GPU 與 CUDA | Kubernetes | 生命週期 |
|---|---|---|---|---|
| Ubuntu LTS | GPU 伺服器、工作站,以及大多數 AI 團隊 | 一級支援:NVIDIA 優先在此建置與測試;簽署驅動程式 | Canonical Kubernetes、MicroK8s、k3s、RKE2 | 5 年,使用 Ubuntu Pro 可達 10 年以上 |
| Red Hat Enterprise Linux | 受監管的企業、OpenShift 環境 | NVIDIA CUDA 軟體庫與驅動程式串流;RHEL AI | OpenShift、OpenShift AI | 10 年,另有延伸支援 |
| SUSE Linux Enterprise | Rancher 環境、SAP 與邊緣機群 | 已簽署的 NVIDIA 開放核心驅動程式套件;SUSE AI | Rancher, RKE2, k3s | 具 LTSS 的長生命週期 |
| Alpine Linux | 精簡容器、閘道與邊緣服務 | 不適用於 GPU 主機(musl,無 CUDA) | 作為容器基礎映像檔 | 每個版本約 2 年 |
| Debian | 穩定、不綁定廠商的伺服器與實驗環境 | NVIDIA 驅動程式位於 non-free;CUDA 儲存庫 | k3s、kubeadm、RKE2 | 搭配 LTS 約 5 年 |
| Rocky 與 AlmaLinux | 相容 RHEL 且無須訂閱 | 與 RHEL 相同的套件 | kubeadm、RKE2、k3s、OKD | 約 10 年 |
我們支援的發行版
Ubuntu
GPU 伺服器與 AI 工作站的預設選擇。
大多數 AI 生態系優先在 Ubuntu 上建置與測試。NVIDIA 的 NGC 容器、CUDA 文件與許多框架安裝程式都以它為前提,這意味著新 GPU、驅動程式或模型發布時,意外狀況更少。
我們部署的版本: Ubuntu 24.04 LTS(Server 與 Desktop),既有環境使用 22.04 LTS
GPU、CUDA 與 AI 堆疊
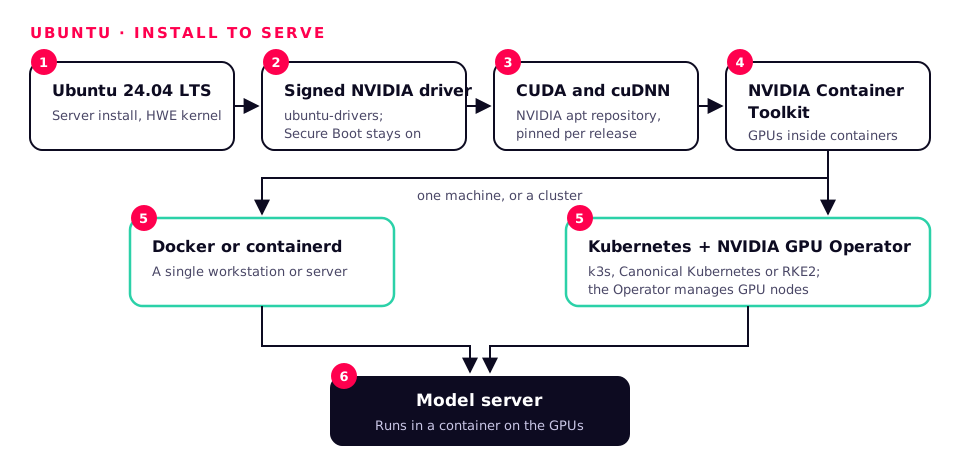
- ubuntu-drivers 會安裝 Canonical 簽署的 NVIDIA 核心模組,因此無需註冊您自己的金鑰即可保持 UEFI 安全開機。
- CUDA、cuDNN 與 NVIDIA Container Toolkit 來自 NVIDIA 的 apt 套件庫,並依發行版本固定版本。
- HWE 核心讓 LTS 版本支援最新的 CPU、GPU 與網路卡。
我們如何為 AI 調校
- 伺服器安裝、最小化套件,在設備上保留或移除 snap。
- 效能型 CPU 調控器、NUMA 感知的配置,以及 GPU 的持續模式(請見核心章節)。
- 無人值守的安全性更新排定在維護時段進行,或為氣隙隔離(air-gapped)的場所提供離線更新套件。
Kubernetes 與容器
- Docker 或 containerd 搭配 NVIDIA Container Toolkit。
- 單節點與邊緣使用 k3s,叢集使用 Canonical Kubernetes 或 RKE2,其上再搭配 NVIDIA GPU Operator。
安全
- Ubuntu Pro 新增 Livepatch、FIPS 140 模組、延伸安全維護,以及用於 CIS 與 DISA-STIG 強化的 Ubuntu Security Guide。
- AppArmor 強制執行,並為我們運行的服務設定設定檔。
我們的看法: 除非機房已統一採用其他系統,否則這是我們針對 GPU 伺服器、AI 工作站與離線設備的預設選擇。
Red Hat Enterprise Linux
適用於受監管的企業與 OpenShift 環境。
RHEL 提供十年的生命週期、經認證的硬體,以及採購與稽核人員認可的支援合約。Red Hat 的 AI 產品組合,包括 RHEL AI、OpenShift AI 與基於 vLLM 的 Red Hat AI Inference Server,都建構於其上。
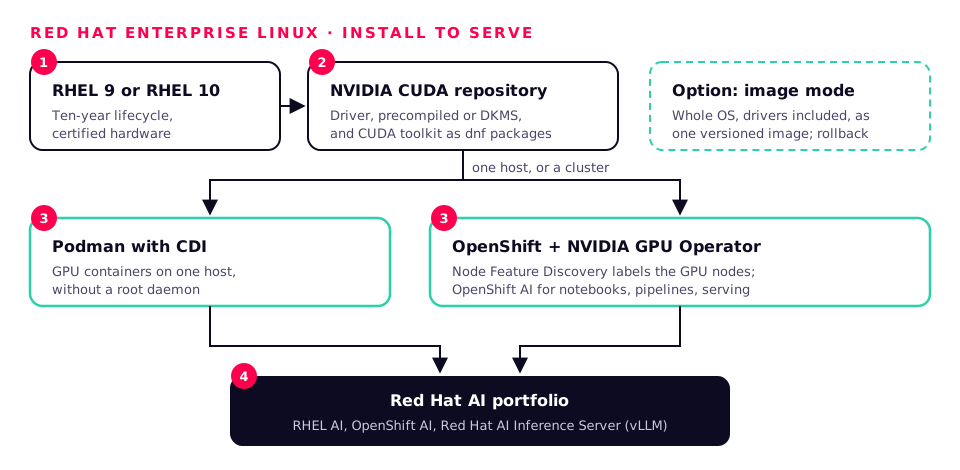
我們部署的版本: RHEL 9 與 RHEL 10
GPU、CUDA 與 AI 堆疊
- NVIDIA 針對 RHEL 提供的 CUDA 儲存庫,以 dnf 套件提供驅動程式(預先編譯或 DKMS)與 CUDA 工具組。
- 搭配 CDI(Container Device Interface)的 Podman,可在無 root 常駐程式的情況下執行 GPU 容器。
- 映像模式(可開機容器)讓包含驅動程式的整個作業系統,能以單一版本化映像檔的形式部署與回復。
我們如何為 AI 調校
- 以 throughput-performance 或 accelerator-performance 等 tuned 設定檔作為起點,再針對各工作負載調整。
- 以程式碼管理的 NUMA、IRQ 親和性與大頁面設定。
Kubernetes 與容器
- OpenShift 搭配 NVIDIA GPU Operator 與 Node Feature Discovery;OpenShift AI 用於筆記本、管線與模型服務。
安全
- 預設啟用 SELinux enforcing、FIPS 模式,以及搭配 SCAP Security Guide 的 OpenSCAP,用於 CIS 與 STIG 設定檔。
- kpatch 即時核心修補,實現零停機的安全性修復。
我們的看法: 當支援合約、認證或既有 OpenShift 平台比擁有最新套件更重要時,這是正確的選擇。
SUSE Linux
適用於 Rancher 管理的機群、SAP 與邊緣端。
SUSE 將企業級 Linux 與 Rancher(管理多個 Kubernetes 叢集最廣泛使用的方式之一)搭配,並提供 SUSE AI,用於在該平台上執行私有 AI。其快照與交易式更新工具讓回復成為例行作業。
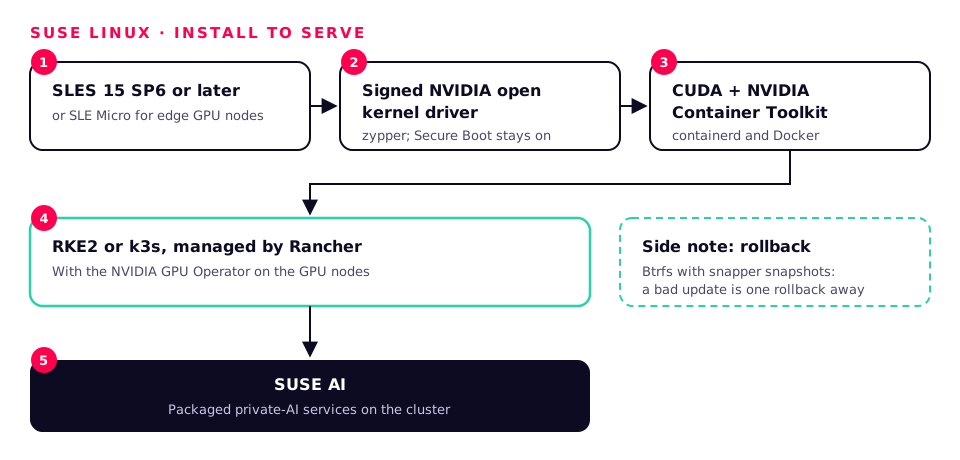
我們部署的版本: SUSE Linux Enterprise Server 15 SP6 及更新版本、適用於邊緣的 SLE Micro,以及適用於實驗室的 openSUSE Leap
GPU、CUDA 與 AI 堆疊
- SUSE 提供已為 Secure Boot 簽署的 NVIDIA 開源 GPU 核心模組套件,可透過 zypper 安裝。
- CUDA 來自 NVIDIA 的 SUSE 儲存庫;NVIDIA Container Toolkit 則適用於 containerd 與 Docker。
我們如何為 AI 調校
- 採用 Btrfs 與 snapper 快照,因此驅動程式或核心更新出問題時,只需一次回復即可復原。
- SLE Micro 的唯讀、交易式作業系統,適用於必須原子更新的邊緣 GPU 節點。
Kubernetes 與容器
- 由 Rancher 管理的 RKE2 或 k3s,搭配 NVIDIA GPU Operator;SUSE AI 提供封裝好的私有 AI 服務。
安全
- 強制存取控制(AppArmor 或 SELinux)、FIPS 認證模組、OpenSCAP 強化設定檔。
- SUSE Live Patching 可在不重新開機的情況下修補核心。
我們的看法: 最適合 Rancher 已在運行叢集的環境,或需要原子更新與快速回復的邊緣機群。

Alpine Linux
小巧、快速且經過強化,適用於容器而非 GPU 主機。
Alpine 的基礎映像檔只有幾 MB,建立在 musl libc 與 BusyBox 之上,並配備強化的工具鏈。這使它非常適合 AI 系統周邊的小型服務,但不適合 GPU 工作本身。
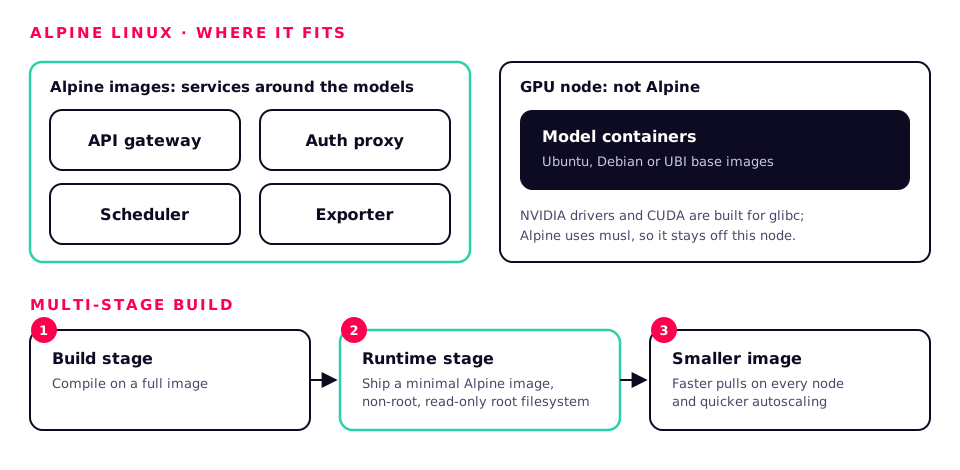
我們部署的版本: 目前的 Alpine 穩定版本,作為容器基礎映像檔
GPU、CUDA 與 AI 堆疊
- NVIDIA 驅動程式與 CUDA 是針對 glibc 建置,且 PyTorch 並未發布 musl wheel,因此 GPU 與多數訓練映像檔應使用 Ubuntu、Debian 或 UBI 基底。
- 適合 API 閘道、驗證代理、排程器、匯出器,以及使用編譯式執行環境的輕量 CPU 推論。
我們如何為 AI 調校
- 多階段建置,在完整映像檔上編譯,並交付精簡的 Alpine 執行環境。
- 較小的映像意味著每個節點拉取更快、自動擴縮更迅速。
Kubernetes 與容器
- 適用於任何 Kubernetes 發行版中 sidecar、init 容器與邊緣服務的基礎映像檔。
安全
- 套件集小,意味著攻擊面小、弱點掃描報告簡短。
- 以非 root 身分執行,並使用唯讀的根檔案系統。
我們的看法: 用於模型周邊的服務,而不是 GPU 節點或模型容器本身。

Debian、Rocky 與 AlmaLinux
我們在正式環境中支援的社群發行版。
Debian 是 Ubuntu 與許多設備底層穩定、中立於廠商的基礎。Rocky Linux 與 AlmaLinux 與 RHEL 二進位相容,適合想要 RHEL 生態系卻不想訂閱的團隊。
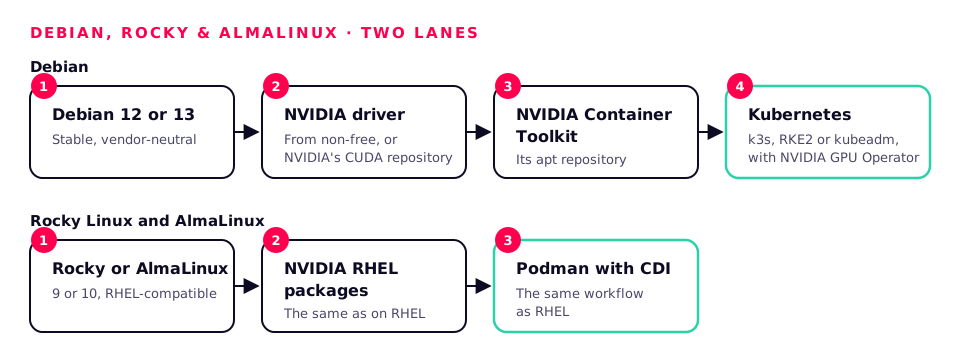
我們部署的版本: Debian 12 與 13;Rocky Linux 與 AlmaLinux 9 與 10
GPU、CUDA 與 AI 堆疊
- Debian:NVIDIA 驅動程式來自 non-free 套件庫或 NVIDIA 的 CUDA 套件庫;NVIDIA Container Toolkit 的 apt 套件庫。
- Rocky 與 AlmaLinux:與 RHEL 相同的 NVIDIA RHEL 套件及 Podman CDI 工作流程。
我們如何為 AI 調校
- 與其商用版本相同的核心、NUMA 與儲存設定,並透過 Ansible 套用。
- Debian 也是 Proxmox VE 的基礎,我們用它來進行 GPU 直通實驗室。
Kubernetes 與容器
- 搭配 NVIDIA GPU Operator 的 k3s、RKE2 或 kubeadm 叢集。
安全
- 透過 OpenSCAP 的 CIS 基準、Debian 上的 AppArmor、Rocky 與 AlmaLinux 上的 SELinux,並搭配自動化安全更新。
我們的看法: 在您不需要廠商合約時,這是穩固且具成本效益的選擇,並由我們自己的支援做後盾。
針對 AI 工作負載的核心與作業系統最佳化
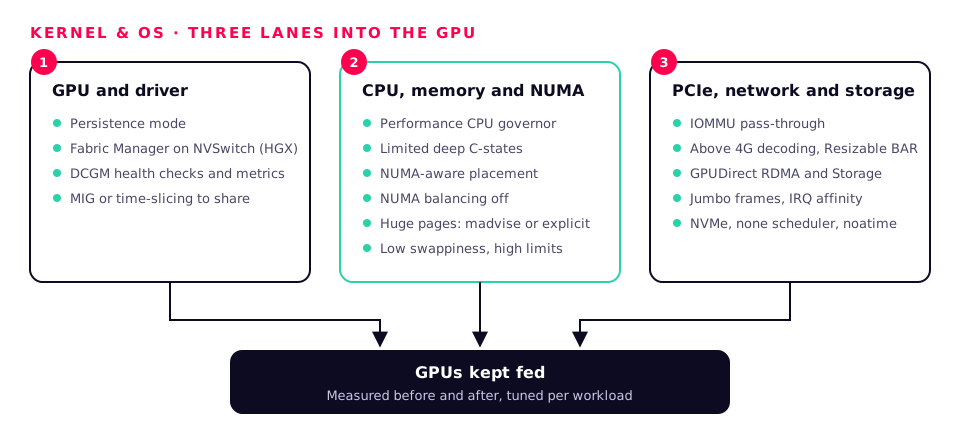
GPU 只有在主機持續餵料時才會跑得快。以下是我們在每套 AI 系統上檢查的設定,之後再針對客戶自己的工作負載調校。沒有任何一項是通用的:我們在調整前後都會量測。
GPU 與驅動程式
- 持續模式(nvidia-persistenced),讓驅動程式保持載入,首次請求才不會變慢。
- NVSwitch 系統(HGX)上的 NVIDIA Fabric Manager:沒有它,GPU 將無法為 CUDA 初始化。
- DCGM 用於健康檢查、診斷與每 GPU 指標。
- 當許多小型模型共用一張大型 GPU 時,使用 MIG 分割或時間切片。
CPU、記憶體與 NUMA
- 在對延遲敏感的推論主機上使用效能型 CPU 調控器並限制深層 C-state。
- NUMA 感知的配置:每顆 GPU 的工作都綁定在離它最近的 CPU 插槽與記憶體上(nvidia-smi topo -m 可顯示對應圖)。
- 在專用 GPU 主機上關閉自動 NUMA 平衡,讓記憶體頁面不會在負載下遷移。
- 透明大型頁面預設為 madvise;RDMA 與 DPDK 工作負載則使用明確的大型頁面。
- 低 swappiness,並為資料載入器與 RDMA 提供充裕的 memlock 與檔案描述符上限。
PCIe、網路與儲存
- 在韌體中將 IOMMU 設為直通模式,並啟用 Above 4G decoding / Resizable BAR。
- GPUDirect RDMA(nvidia-peermem)與 GPUDirect Storage(nvidia-fs),讓資料繞過 CPU。
- 儲存與 RoCE 網路架構全程使用巨型封包,並將 IRQ 親和性分散到各核心。
- 採用 none 排程器的 NVMe,資料集與檢查點使用帶 noatime 的 XFS 或 ext4。
起點(依各工作負載測試,絕不盲目照搬)
# /etc/sysctl.d/90-ai.conf
kernel.numa_balancing = 0
vm.swappiness = 10
vm.max_map_count = 1048576
net.core.rmem_max = 268435456
net.core.wmem_max = 268435456

# kernel command line (GRUB)
iommu=pt transparent_hugepage=madvise

# services
systemctl enable --now nvidia-persistenced
systemctl enable --now nvidia-fabricmanager   # NVSwitch (HGX) systems
cpupower frequency-set -g performance
適用於 AI 的 Kubernetes 與 Docker
我們建置的 AI 系統大多在容器中運行,從單一工作站上執行的 Docker 到多節點 GPU 叢集。無論哪種發行版,建構模組都相同。
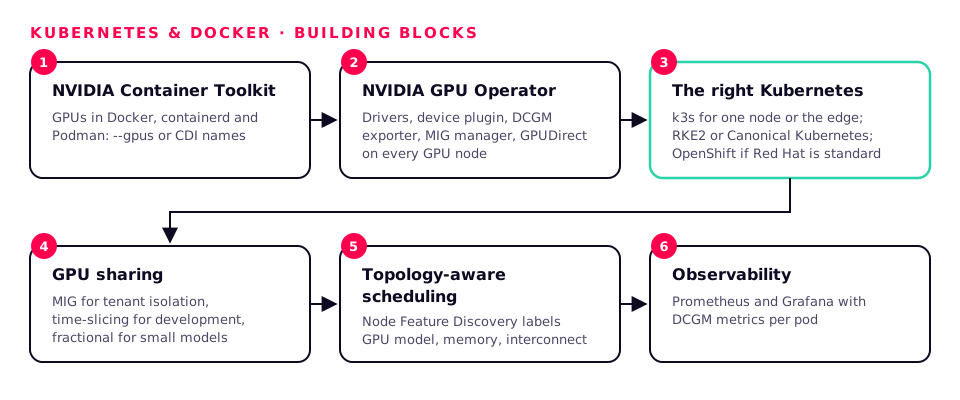
NVIDIA Container Toolkit
讓 Docker、containerd 與 Podman 透過 --gpus 旗標或 CDI 裝置名稱存取 GPU。
NVIDIA GPU Operator
在每個 Kubernetes GPU 節點上安裝並管理驅動程式、裝置外掛程式、DCGM exporter、MIG 管理器與 GPUDirect 元件。
合適的 Kubernetes
單節點或邊緣使用 k3s,叢集使用 RKE2 或 Canonical Kubernetes,以 Red Hat 為標準的環境使用 OpenShift。
GPU 共享
MIG 用於租戶之間的硬隔離,時間切片用於開發,分數式排程用於眾多小型模型。
拓撲感知排程
Node Feature Discovery 會標註 GPU 型號、記憶體與互連,使大型作業落在適合的節點上。
可觀測性
Prometheus 與 Grafana 搭配 DCGM 指標:每個 Pod 的 GPU 使用率、記憶體、溫度、功耗與錯誤。
原生 LLM API 及其擴充方式
我們在相容 OpenAI 的 API 之後提供模型服務,因此應用程式不必在意背後是哪個模型或引擎。擴展隨後朝四個方向進行。
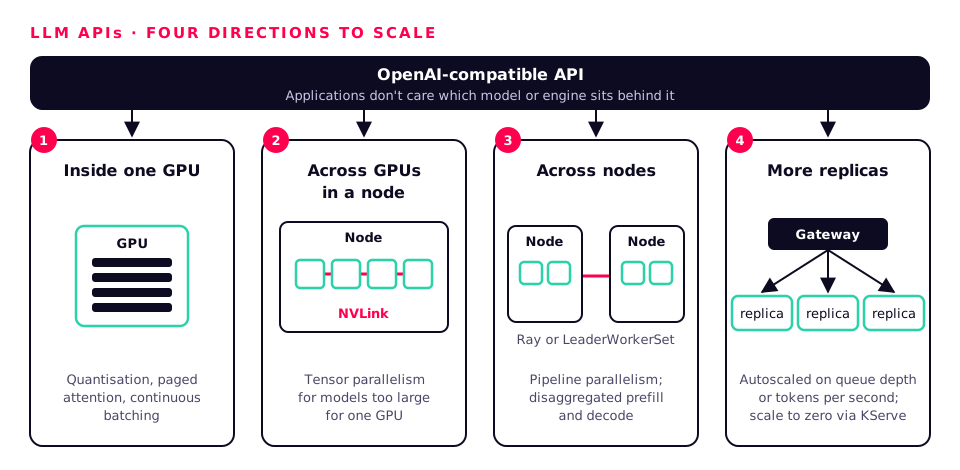
- 1
單一 GPU 內部
量化(FP8、Blackwell 上的 NVFP4、AWQ)、分頁注意力與 vLLM、SGLang 或 TensorRT-LLM 中的連續批次處理,讓每顆 GPU 能容納更多使用者。
- 2
節點內跨 GPU
透過 NVLink 的張量平行,以最低延遲服務單一 GPU 放不下的超大型模型。
- 3
跨節點
針對最大型的模型,使用 Ray 或 Kubernetes LeaderWorkerSet 進行管線平行化,並在叢集規模下採用分離式 prefill 與 decode(NVIDIA Dynamo、llm-d)。
- 4
更多副本
在閘道後方進行水平擴展,並以 KEDA 或 HPA 依佇列深度或每秒 token 數自動擴縮,搭配感知 KV 快取的路由,並透過 KServe 縮減至零。
我們部署的引擎:vLLM、SGLang、搭配 Triton Inference Server 的 TensorRT-LLM、NVIDIA NIM,以及供桌邊與邊緣系統使用的 Ollama 或 llama.cpp。許多 LoRA 配接器可在相同 GPU 上共用同一個基礎模型。
LLM、代理與資料管線的 CI/CD
AI 的變動比一般軟體更頻繁:新的模型版本、新的提示詞、新的資料。我們為這三者各建一條管線,並遵循相同的紀律:一切皆有版本控管、經過測試、簽署,並透過環形逐級晉升。
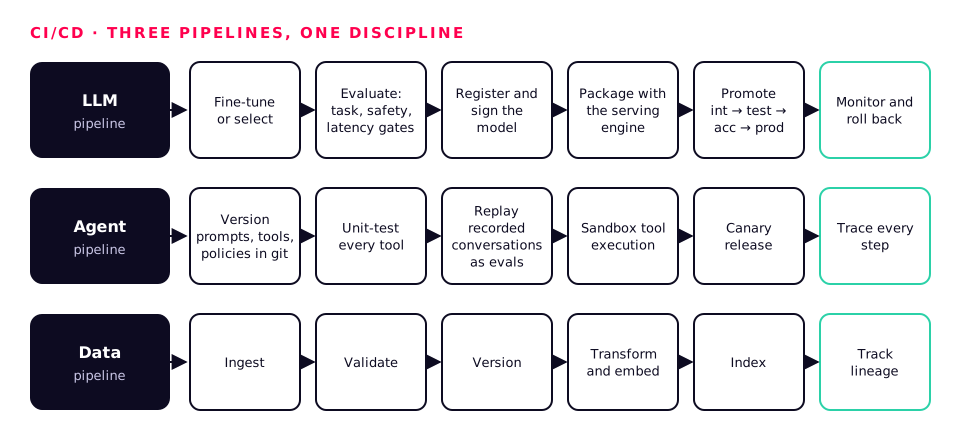
LLM 管線
- 微調或選用
- 依任務、安全與延遲關卡進行評估
- 註冊並簽署模型
- 與服務引擎一同封裝
- 晉升 int → test → acc → prod
- 監控與回復
以 Kubeflow 或 Ray 進行訓練、MLflow 登錄庫、cosign 簽章、Argo CD 實現 GitOps,並以 Ring Promoter 進行具健康檢查、逐 ring 推送的發佈。
代理程式管線
- 在 git 中對提示詞、工具與政策進行版本控管
- 對每個工具進行單元測試
- 將錄製的對話重播為評估
- 沙箱化工具執行
- 金絲雀發布
- 追蹤每個步驟
容器化的工具沙箱、CI 中的評估套件、OpenTelemetry 追蹤,以及每個代理程式的成本與速率預算。
資料管線
- 擷取
- 驗證
- 版本
- 轉換與嵌入
- 索引
- 追蹤血緣
Airflow、Dagster 或 Argo Workflows;以 Great Expectations 驗證;以 lakeFS 或 DVC 做版本管理;以 Spark 或 Ray 擴展規模;以 pgvector、Qdrant 或 Milvus 做檢索;以 OpenLineage 追蹤資料血緣。
CI 在您網路內的自託管 Runner 上執行,包括用於評估的 GPU Runner,因此模型與資料永遠不會離開網路。
我們如何為 AI 保護 Linux
AI 伺服器存放著您最有價值的資料與一些最昂貴的硬體。我們分層加以保護,讓任何單一疏失都不會同時暴露兩者。
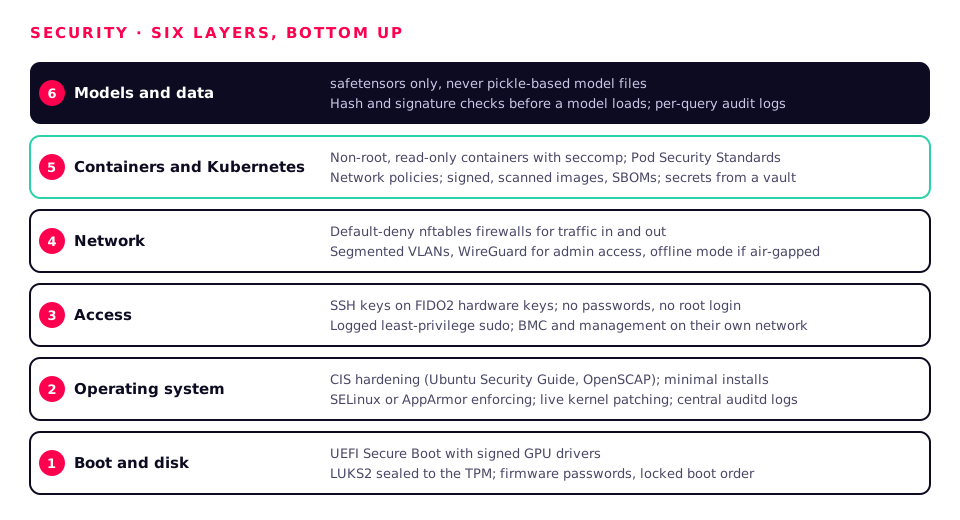
01
開機與磁碟
- UEFI 安全開機,搭配已簽署的 GPU 驅動程式
- 全磁碟加密(LUKS2)並封存至 TPM,支援無人值守重新啟動
- 韌體密碼與鎖定開機順序
02
作業系統
- CIS 基準強化(Ubuntu Security Guide、OpenSCAP)
- 強制執行 SELinux 或 AppArmor
- 最小化安裝與即時核心修補
- auditd 日誌傳送至集中儲存
03
存取
- SSH 金鑰存放於 FIDO2 硬體金鑰,不使用密碼,不允許 root 登入
- 具記錄功能的最小權限 sudo
- BMC 與管理功能使用獨立網路
04
網路
- 對進出流量採用預設拒絕的防火牆(nftables)
- 分段的 VLAN,並以 WireGuard 供管理存取
- 適用於實體隔離場域的完全離線模式
05
容器與 Kubernetes
- 非 root、唯讀的容器,並搭配 seccomp 設定檔
- Pod Security Standards 與網路政策
- 已簽署的映像檔、弱點掃描與 SBOM
- 機密從保管庫取得,絕不放在映像檔或 git 中
06
模型與資料
- 僅使用 safetensors,絕不使用基於 pickle 的模型檔案
- 模型載入前先進行雜湊與簽章檢查
- 逐筆查詢的稽核紀錄,以及案件或租戶層級的存取控制
由 Workstation 團隊提供支援
選擇適合貴組織的發行版,我們交付已就緒可執行 AI 工作的系統,並持續維持該狀態。
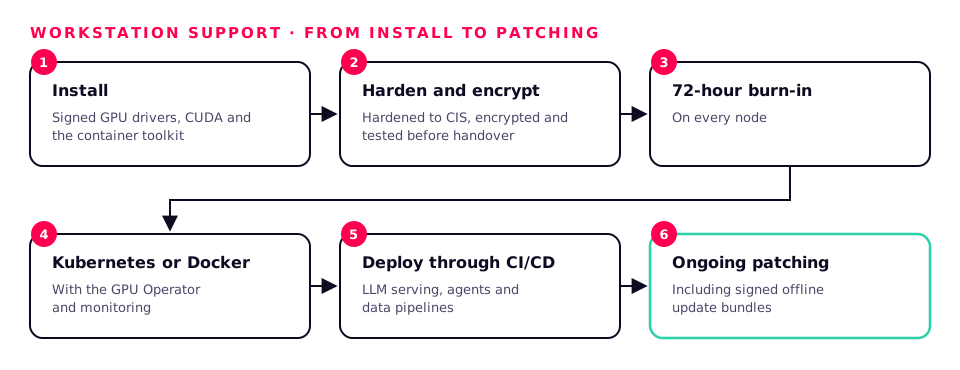
- 安裝時附帶已簽署的 GPU 驅動程式、CUDA 與容器工具組
- 交付前已依 CIS 強化、加密並完成測試
- 每個節點皆經 72 小時燒機測試
- 設定好 Kubernetes 或 Docker,並搭配 GPU Operator 與監控
- 透過 CI/CD 部署的 LLM 服務、代理與資料管線
- 持續修補,包含已簽署的離線更新套件
標誌為其各自所有者之商標,僅用於識別我們所支援的產品。Debian、Rocky Linux 與 AlmaLinux 標誌係依據 Wikimedia Commons 的 CC BY-SA 授權使用。