
Muse Glimmer es el modelo de lenguaje causal de 30 mil millones de parámetros de Meta con un codificador de percepción dedicado, destilado de Muse Spark y publicado para cargas de trabajo agentes autónomas en hardware de consumidores y estaciones de trabajo. Distribuido a través de Ollama bajo Apache 2.0, apunta al uso confiable de herramientas, tareas a largo plazo, comprensión multimodal y recuperación de fallas, sin requerir inferencia en la nube. Este informe técnico de Workstation reescribe y amplía la tarjeta de modelo público para ingenieros que envían agentes locales.
- Clase: 30B codificador de percepción LM + causal; destilado de Muse Spark; visión + herramientas + pensamiento.
- Atender:
ollama run muse-glimmer(~18GB, 128K, texto+imagen); Apple Silicon:muse-glimmer:30b-mlx(~21GB, DFlash). - Adaptar: Agentes locales/aislados siempre activos en un GPU o Mac Silicon, no en un modelo de clúster MoE de varios TB.
- Señal de fuerza: lidera la matriz de clases de tamaño informada por Meta en MCP-Atlas, DeepSearch QA, WildClawBench, SWE-Bench Pro, AA-LCR, Beam128K (razonamiento alto).
- Operaciones: andamio a través de
ollama launch(Claude Code, OpenCode, Hermes, OpenClaw); gobernar con evaluaciones, HITL, autenticación MCP.
Fuentes primarias: Biblioteca Ollama - muse-glimmer; Metodología de metaevaluación — Metodología Muse Glimmer. Los números y etiquetas cambian; Verifique la tarjeta del modelo en vivo antes de la adquisición.
1. Intención de arquitectura y diseño
Muse Glimmer no está posicionado como un MoE de chat general. El encuadre de Meta es finalización de tareas de agente de un extremo a otro En hardware, puedes comprar para un escritorio o un pequeño estante de laboratorio:
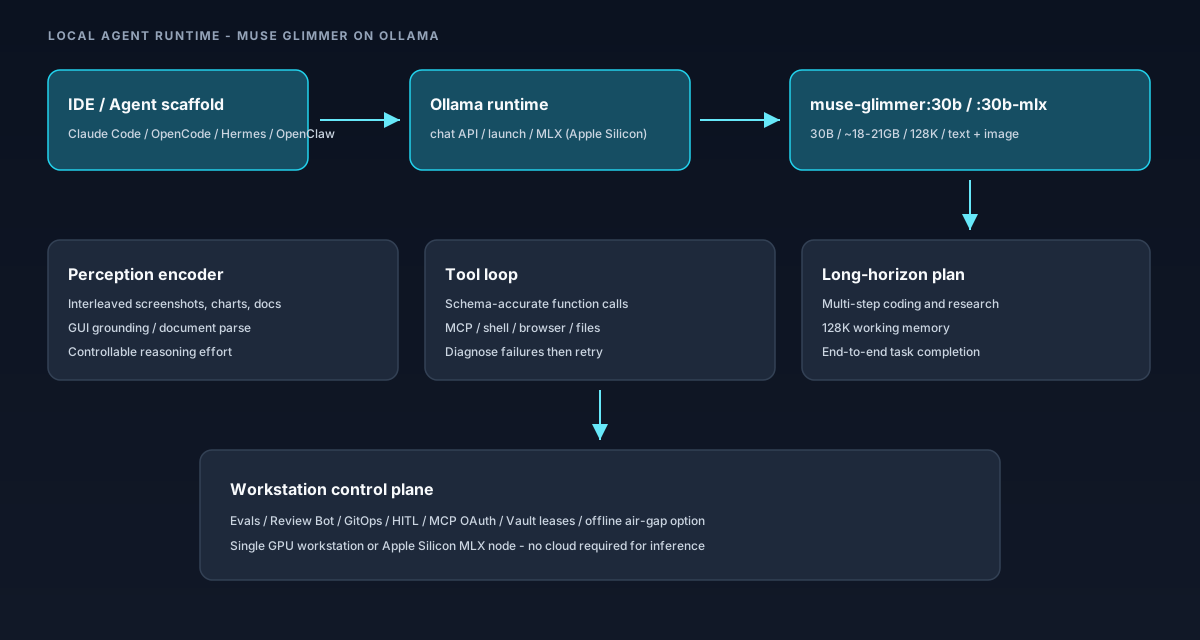
- Columna vertebral causal de LM (30B) – próxima generación de tokens con cadenas de razonamiento de varios pasos sostenidas a lo largo de largos flujos de trabajo.
- Codificador de percepción dedicado — acepta texto e imágenes entrelazados para que los agentes puedan razonar sobre capturas de pantalla, gráficos y documentos en la misma ventana contextual que las transcripciones de herramientas.
- Destilación de Muse Spark — transferencia de capacidad a un espacio que apunta a la implementación de un único GPU/clase de consumidor en lugar del servicio exclusivo del centro de datos.
- Comportamiento de recuperación de fallas — cuando una llamada a una herramienta falla o devuelve una carga útil inesperada, el modelo se entrena/ajusta para diagnosticar y volver a intentar en lugar de detener el episodio.
- Esfuerzo controlable — La intensidad del razonamiento se puede seleccionar para que los operadores puedan intercambiar latencia por calidad por ruta.
- Cobertura de formación multilingüe — Datos de entrenamiento de metaestados de más de 100 idiomas.
Para las pilas Workstation, la implicación del producto es: tratar a Glimmer como un cerebro en tiempo de ejecución del agente detrás de las herramientas, shells, navegadores y editores de archivos de MCP, no como un reemplazo directo para cada llamada API de frontera cerrada.
2. Distribución de Ollama (etiquetas, huella, E/S)
Según lo publicado en la tarjeta de la biblioteca Ollama (verifique los tamaños en vivo):
| Etiqueta | Aprox. tamaño | Contexto | Aporte | Notas |
|---|---|---|---|---|
muse-glimmer:latest / :30b | ~18GB | 128K | Texto, Imagen | Ruta predeterminada de GPU único |
muse-glimmer:30b-mlx | ~21GB | 128K | Texto, Imagen | Motor Ollama MLX; DFlash + imagen en Apple Silicon |
# Pull + interactive
ollama run muse-glimmer

# Apple Silicon (MLX)
ollama run muse-glimmer:30b-mlx

# HTTP chat (localhost Ollama)
curl http://localhost:11434/api/chat \
  -d '{"model":"muse-glimmer","messages":[{"role":"user","content":"Hello!"}]}'

# Scaffold launchers (from Ollama applications list)
ollama launch claude --model muse-glimmer
ollama launch opencode --model muse-glimmer
ollama launch hermes --model muse-glimmer
ollama launch openclaw --model muse-glimmer
Los clientes de Python/JS deben fijar la etiqueta que validaste (muse-glimmer vs :30b-mlx) en la configuración, no en el código fijo latest en agentes de producción.
3. Superficie de capacidad (lectura de ingeniería)
- Finalización de agentes de extremo a extremo — Meta cita resultados sólidos en las tareas de la familia DeepSearch QA, MCP-Atlas, τ3-Bench (banca) y SWE-Bench que miden el éxito de varios turnos andamiados, no trivias de un solo disparo.
- Uso confiable de herramientas — amplia cobertura de llamadas de funciones con precisión de esquema en flujos de trabajo extendidos (crítico para flotas de herramientas MCP).
- Razonamiento de varios pasos — planificar la coherencia a largo plazo; se combina con la ventana de contexto de 128K para transcripción + retención de documentos.
- Recuperación de fallas — diagnosticar resultados inesperados de la herramienta y volver a intentarlo; Reduce los abortos por "agentes frágiles" en trabajos nocturnos.
- razonamiento multimodal — El codificador de percepción permite capturas de pantalla/gráficos/documentos intercalados con texto (bancos de conexión a tierra de GUI y análisis de documentos incluidos en la matriz de Meta).
- Compatibilidad con andamios — OpenClaw, Hermes Agent y patrones de orquestación similares; Ollama enumera los lanzadores Claude Code y OpenCode como aplicaciones de primera clase.
4. Matriz de referencia (metainformada, razonamiento alto)
Meta compara Muse Glimmer-30B (razonamiento alto) con Gemma4-31B y Qwen3.6-27B en modo de pensamiento. Lectura del titular Workstation: Glimmer lidera varios agente suites públicas (MCP-Atlas, DeepSearch QA, WildClawBench, Gaia2, SWE-Bench Pro) mientras siguen o empatan a sus pares en algunas métricas de agente de escritorio y GDP-val. Vuelva a ejecutar siempre su aprovechar.
| Categoría | Punto de referencia | Luz tenue-30B | Gemma4-31B | Qwen3.6-27B |
|---|---|---|---|---|
| agente general | MCP-Atlas (público) | 75.5 | 54.2 | 62.5 |
| Control de calidad de búsqueda profunda | 74.6 | 61.7 | 71.1 | |
| τ3-Banca | 23.5 | 15.1 | 16.7 | |
| Banco De Garra Salvaje | 47.6 | 37.6 | 43.2 | |
| GDPVal-AA v2 | 953 | 811 | 1141 | |
| Gaia2 | 43.3 | 36.4 | 40.0 | |
| SkillsBench (con habilidades) | 44.3 | 32.4 | 46.6 | |
| OSWorld-Verified | 65.9 | 58.5 | 75.6 | |
| Codificación agente | SWE-Bench Pro | 51.2 | 36.9 | 50.2 |
| SWE-Bench Verificado | 76.0 | 66.6 | 77.2 | |
| Banco de terminales 2.1 | 51.7 | 43.4 | 60.7 | |
| Código de ciencia | 43.6 | 43.4 | 39.8 | |
| Multimodal | Razonamiento CharXiv | 78.8 | 77.7 | 78.4 |
| ScreenSpotPro | 75.4 | 75.9 | 76.1 | |
| OmniDocBench v1.5 | 75.8 | 72.5 | 77.8 | |
| MMMU Pro | 74 | 73 | 75 | |
| Razonamiento / LCR | IFBanco | 77.0 | 76.0 | 70.8 |
| OBJETIVO 2026 | 94.7 | 89.2 | 94.1 | |
| Diamante GPQA (AA) | 83.5 | 85.7 | 84.2 | |
| Texto HLE (AA) | 22.0 | 23.6 | 23.1 | |
| AA-LCR | 80.0 | 68.3 | 73.3 | |
| Haz128K | 65.1 | 58.2 | 63.0 |
Los bancos de seguridad (CI Memories, Siren AgentDojo) muestran compensaciones: Glimmer informa una gran utilidad bajo las inyecciones de AgentDojo con ASR de paquete medio; Trate la seguridad como un problema de control de implementación (firewalls rápidos, listas de herramientas permitidas, HITL), no como una propiedad del modelo resuelta. Consulte el PDF de metodología de Meta para conocer modelos de jueces, recuentos de intentos y advertencias sobre los arneses.
5. Metodología de evaluación (qué significan los números)
La nota metodológica de Meta es esencial antes de citar cualquier celda en un tablero:
- Selección de pares: modelos abiertos de clase de tamaño (Gemma4-31B, Qwen3.6-27B); los compañeros pueden utilizar puntuaciones autoinformadas o reproducidas internamente; Se utiliza análisis artificial cuando está disponible para los tres.
- Muestreo: Glimmer informó una alta capacidad de razonamiento con temperatura = 1,0 / top_p = 0,95 / top_k = 64; los pares usan configuraciones de pensamiento recomendadas por los proveedores (Qwen usa temperaturas más frías en algunos bancos de agentes).
- Advertencia sobre el sesgo del arnés: Es posible que los modelos de terceros de Meta Notes no estén ajustados a las indicaciones del sistema/herramienta de Meta: las clasificaciones absolutas pueden cambiar bajo andamios nativos de pares.
- MCP-Atlas: uso de herramientas de múltiples turnos en más de 20 servidores MCP; Tasa de aprobación del juez LLM (umbral 0,75) en 500 tareas públicas, promediada en 4 ejecuciones.
- Control de calidad de búsqueda profunda: bucle de navegación autónomo (buscar/abrir/encontrar) en 900 preguntas de investigación difíciles; F1 mediante extracción de juez.
- Banco WildClaw / Gaia2: Tareas de agente Dockerizado de largo horizonte bajo arneses estilo OpenClaw con inyección de eventos y clasificación mixta determinista/LLM.
- SWE-Bench: bash + andamio de herramientas de archivos; Pro y Verified promediados en múltiples ejecuciones: las comparaciones Pro evitan la variante de tarea refinada de Qwen.
- OSWorld-Verificado: Control de VM Ubuntu solo mediante GUI a partir de capturas de pantalla (sin shell directo); Las diferencias en el espacio de acción entre modelos son importantes.
- Haz 128K: Sonda de memoria de contexto largo no agente a 128K: relevante si mantiene transcripciones grandes en contexto sin RAG.
Política Workstation: publique la matriz de Meta para orientación, luego inicie la producción en un conjunto dorado interno (sus herramientas MCP, sus repositorios, su SLO de latencia).
6. Hardware y servicio a la realidad
- Clase GPU única: ~18GB huella de peso implica un moderno 24GB+ consumidor/profesional GPU es el piso práctico de NVIDIA una vez que se consideran las activaciones de visión y caché de KV; perfil con su contexto máximo y sesiones simultáneas.
- Apple Silicon: preferir
:30b-mlx(~21GB) para la ruta MLX de Ollama con decodificación especulativa DFlash y entrada de imagen nativa: las configuraciones Mac Studio/Mac mini Max son nodos SME de primera clase. - No clase Kimi-K3: Este no es un MoE de múltiples nodos. Si necesita agentes abiertos de billones de parámetros, consulte nuestro guía de pesos abiertos; Glimmer es dueño del siempre activo en el escritorio nicho.
- Kubernetes: paquete Ollama o un sidecar compatible con OpenAI por nodo; mantenga las extracciones de modelos en su registro/caché privado; no exponga Ollama sin vincular a Internet.
7. Seguridad y gobernanza para agentes siempre activos
Los pesos locales reducen la salida de datos pero aumentan el radio de explosión de un host de agente comprometido. Línea base mínima de Workstation:
- MCP OAuth 2.1 + secretos de corta duración (arrendamientos de Vault) — consulte artículo de seguridad agente.
- Listas de herramientas permitidas y políticas de salida de red por identidad de agente.
- HITL bloquea acciones irreversibles (pagos, implementaciones de productos, correo electrónico masivo).
- Monitoreo de inyección rápida en contenido devuelto por herramientas (modelo de amenaza estilo Siren AgentDojo).
- El modo sin conexión/air-gap probado como un runbook de primera clase, no una esperanza.
8. Lista de verificación de producción
- Fijar la etiqueta Ollama (
30bvs30b-mlx) y registrar resumen/hash en GitOps. - Cree un paquete dorado de entre 20 y 50 tareas que refleje sus herramientas MCP y sus flujos de trabajo de codificación; seguimiento de la latencia pass@1 y p95 en cada nivel de esfuerzo.
- Andamio de alambre (
ollama launch …o personalizado) con registro estructurado de llamadas y reintentos de herramientas. - Definir enrutador híbrido: Glimmer local para RAG/agentes privados; conmutación por error en la nube para desbordamiento/pico de IQ.
- Documente el espacio libre de VRAM/memoria unificada a 32 K/64 K/128 K con la visión activada.
- Legal: revisión de Apache 2.0 para su modelo de distribución (generalmente licencias de peso abierto sencillas versus restrictivas).
- Bot de revisión de envíos + puertas de evaluación antes de habilitar agentes nocturnos desatendidos.
Publicado por Workstation. Tarjeta modelo: ollama.com/library/muse-glimmer.


