Desembalaje de Mac Studio M4 y ejecución de su primer LLM
Lecturas reales de mactop en una instalación nueva de M4 Max, Ollama, Llama 3 localmente y una canalización privada de RAG en una tarde
 Balinder Walia15 de mayo de 20265 min read

Un complemento breve y de fácil lectura para una inmersión profunda y extensa. Para ver el tutorial completo, vaya a el artículo largo.
La caja sobre el escritorio ahora es un dispositivo de IA
Saqué de la caja un nuevo Mac Studio con el chip M4 Max, 128 GB de memoria unificada, 40 núcleos GPU, 16 núcleos CPU y un SSD de 2 TB. En una tarde, estaba ejecutando Llama 3.1 8B localmente a través de Ollama, incorporando mis propios documentos y respondiendo preguntas sobre ellos a través de un pequeño canal RAG. Sin factura en la nube, sin clave API, sin datos saliendo de la habitación.
Este blog es la versión corta. El artículo completo analiza en profundidad el mismo flujo de trabajo.
El unboxing en 60 segundos
Mire el corto de unboxing en YouTube: https://youtube.com/shorts/HUlUoHNsyNM
Unboxing clásico de Apple: cartón mínimo, la máquina en un hueco moldeado, un cable de alimentación. El gabinete Mac Studio tiene aproximadamente 7,7 pulgadas cuadradas y es denso; Sientes la calidad de construcción en el momento en que lo levantas. La configuración es realmente rápida: ID de Apple, idioma, FileVault, listo.
Primer arranque: lecturas reales desde mactop
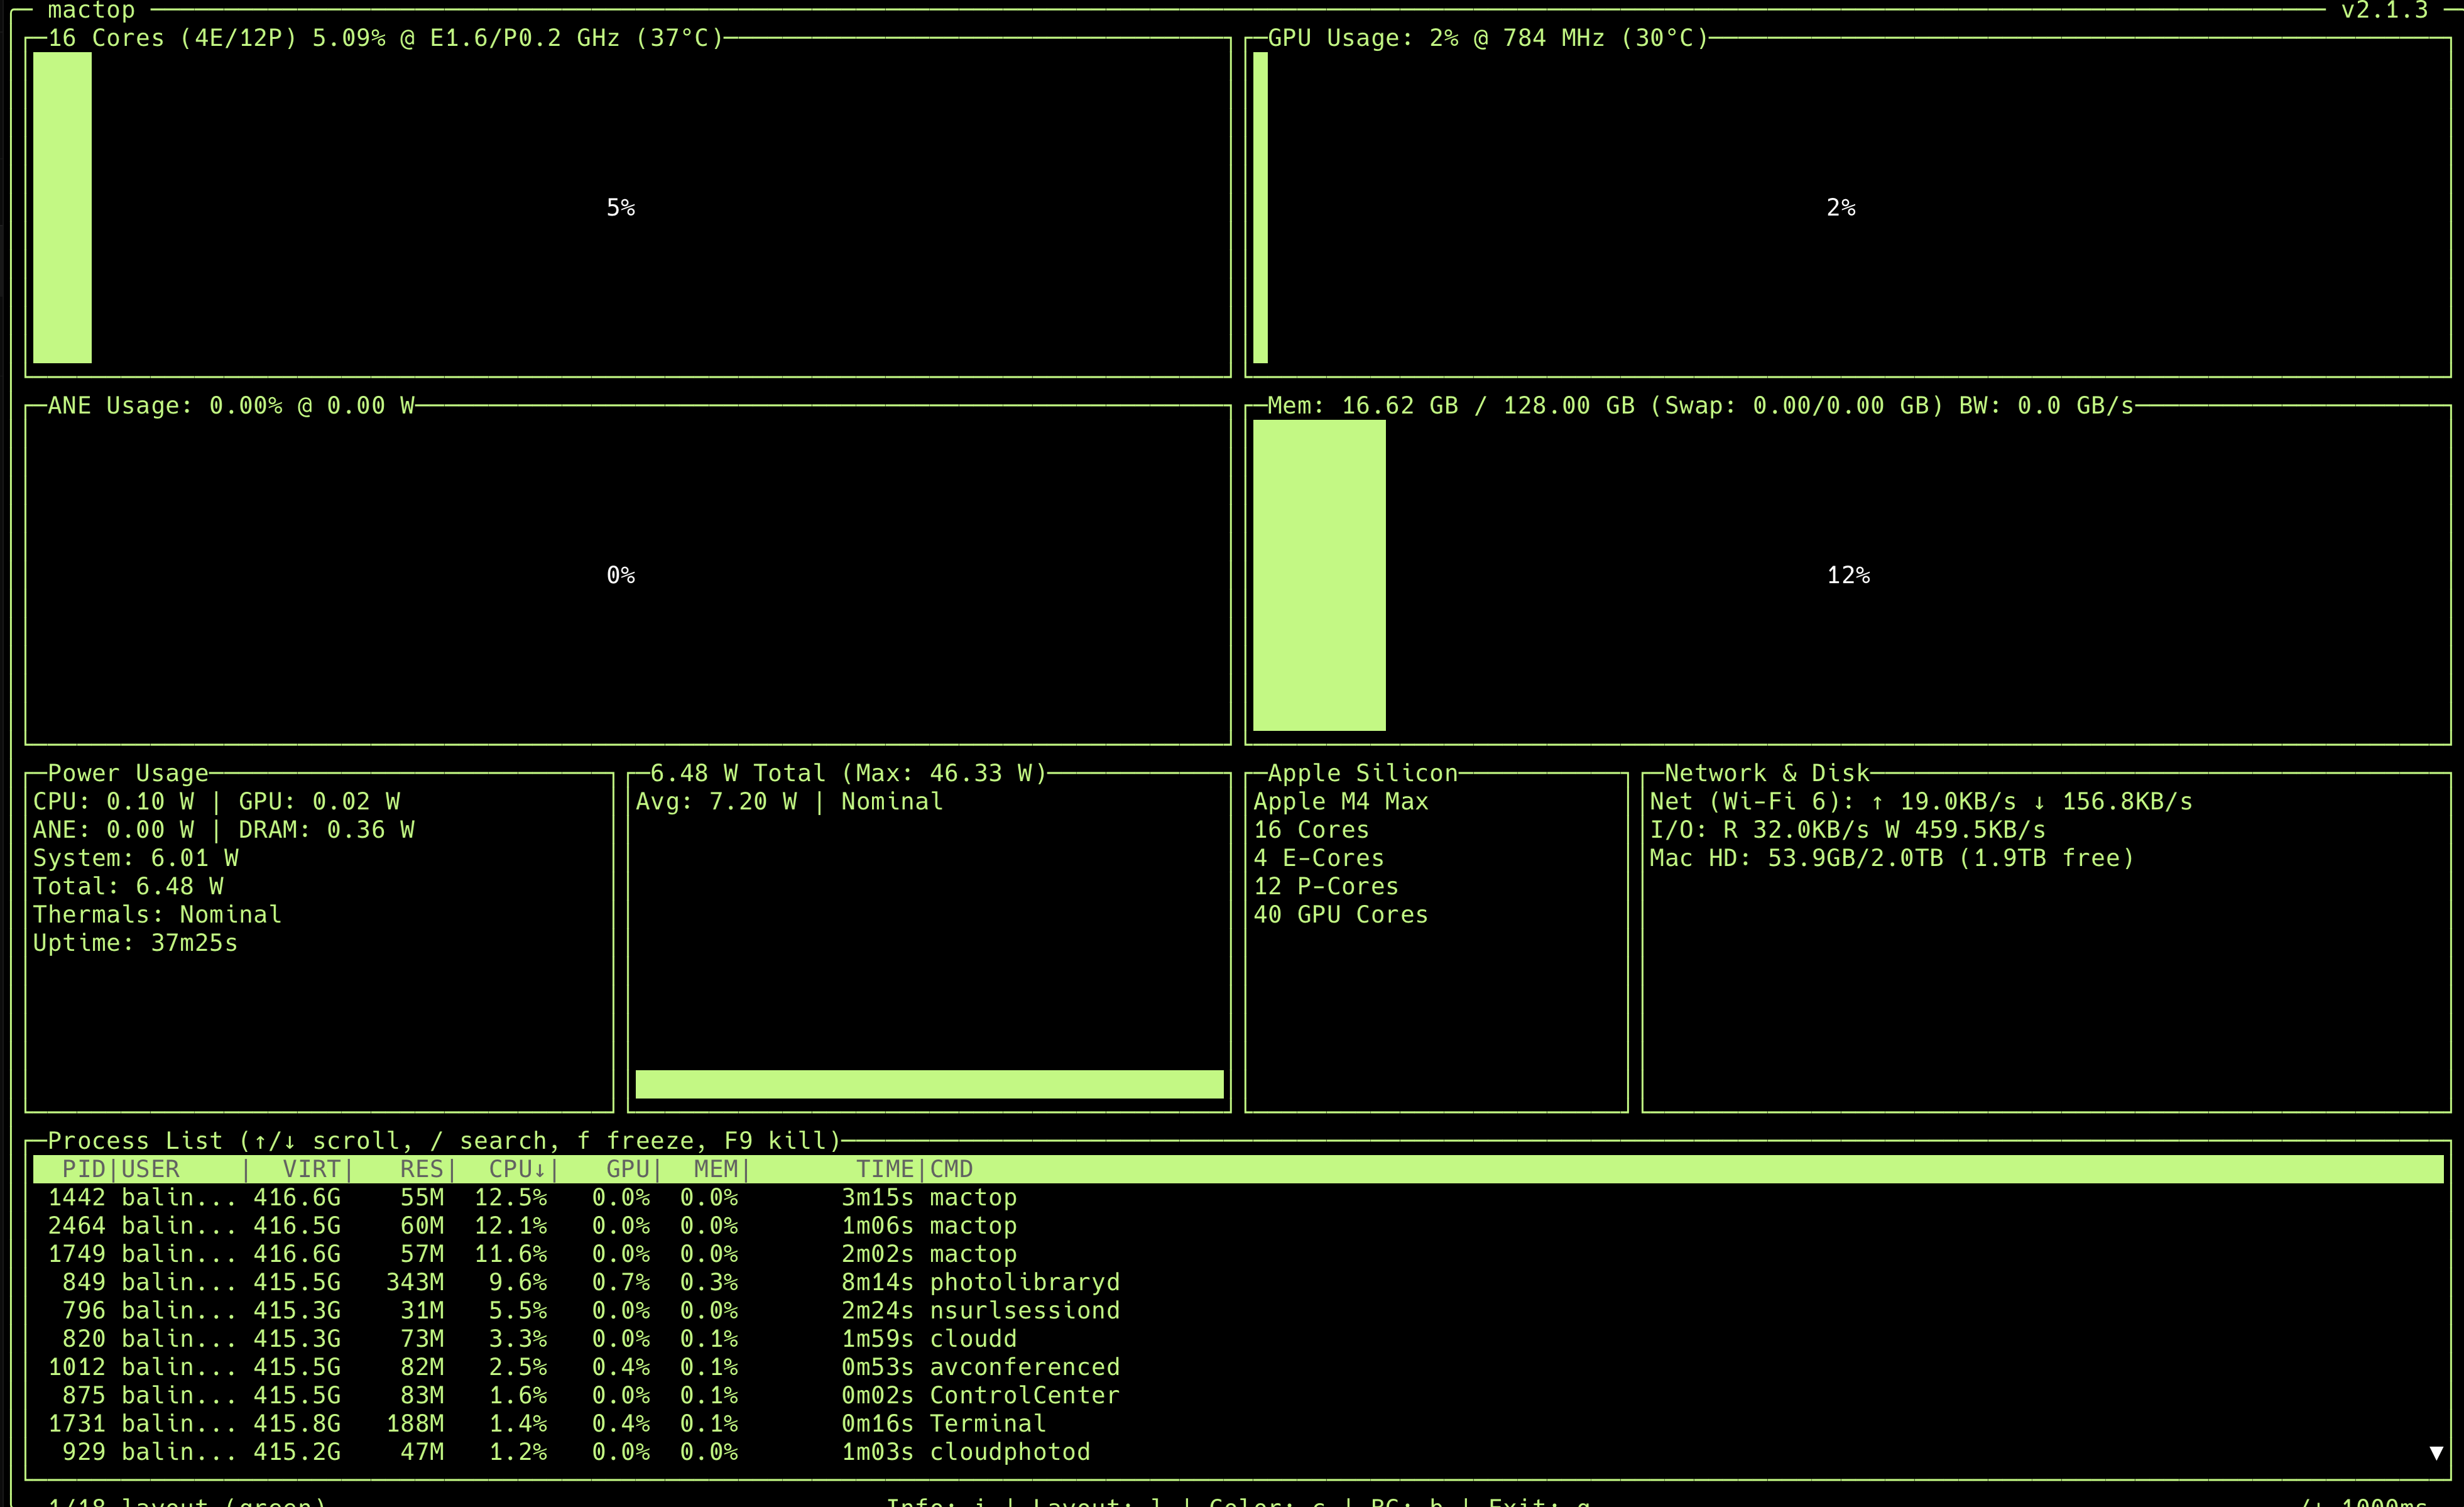
/img/mac-studio-mactop-firstboot.png para cambiarlo más tarde.Las cifras anteriores son las únicas cifras concretas que citaré. Son la verdad fundamental de mactop en mi máquina a los 37 minutos de tiempo de actividad:
- M4 Max - 16 núcleos (4 E + 12 P), 40 núcleos GPU a 784 MHz, ANE de 16 núcleos.
- 128 memoria unificada GB - 16,62 GB en uso en ralentí (alrededor del 13%).
- 6,48W potencia total en reposo, 46,33 W máximo observado. Térmicas: Nominal.
- SSD de 2 TB, 1,9 TB libres después de la configuración inicial.
6,48 W en inactivo para una computadora de escritorio con 128 GB de memoria utilizable es el número principal para mí. Esta caja es realmente un dispositivo de inteligencia artificial siempre encendido y de bajo consumo que puede dejar funcionando las 24 horas del día, los 7 días de la semana sin pensar en la factura de electricidad.
Por qué este hardware es especial: memoria unificada en un párrafo
En una PC tradicional, su CPU tiene RAM del sistema y su GPU tiene VRAM separada. Se debe copiar un modelo a través de PCIe antes de que el GPU pueda ejecutarlo; si el modelo es mayor que la VRAM, no encaja. En Apple Silicon, CPU, GPU, Neural Engine y los motores multimedia comparten uno Piscina 128 GB. No se copia nada. Un LLM de 70B de parámetros en Q4_K_M (alrededor de 40 GB en disco, estimación pública) se carga con aproximadamente 80 GB aún libres para contexto, aplicaciones y herramientas. Es por eso que los LLM locales se sienten diferentes en una Mac.
Del cuadro al primer LLM en tres comandos
brew install ollama
ollama serve &
ollama run llama3.1:8b "Explain unified memory in 3 sentences."
Esa es realmente toda la cuestión. La primera ejecución descarga el modelo (Llama 3.1 8B Q4_K_M tiene alrededor de 4,7 GB en disco, estimación pública) y lo carga en la memoria unificada. Después de eso, la transmisión conversacional es fluida, con un retraso notable en el primer token y una salida constante a través de la respuesta. Deliberadamente no publico aquí números de tokens por segundo sin una metodología de referencia adecuada; el artículo extenso entra en el razonamiento.
RAG local en menos de 60 líneas de Python
Lo más útil que puede hacer con un LLM local es apuntar a sus propios documentos. La pila mínima viable es:
- PyMuPDF o
unstructuredpara analizar - nomic-embed-text a través de Ollama para incrustaciones
- ChromaDB para la tienda de vectores
- Llama 3.1 8B a través de Ollama para generación
El código completo está en el artículo largo. El titular es: todo se ejecuta en el Mac Studio, sin claves API externas, sin facturación por token, sin datos que salen de la máquina.
Mac Studio vs nube: la matriz de decisión honesta
Mac Studio gana por: inferencia privada siempre activa, RAG con sus propios datos, copilotos IDE, creación de prototipos de agentes, aprendizaje de la pila y laboratorios domésticos. La nube gana por: trabajos de capacitación en ráfagas, producción de >70 mil millones a escala, tráfico global impredecible y cargas de trabajo que necesitan un paralelismo 8x A100/H100. La mayoría de los equipos terminarán usando ambos. El artículo extenso tiene una matriz de decisión completa como SVG.
Cinco lecciones después de una semana
- La privacidad desbloquea nuevos casos de uso. Cuando el modelo es local, pego registros de producción, documentos internos y correos electrónicos de clientes sin dudarlo. Eso cambia mi forma de trabajar.
- El costo por consulta es tanto psicológico como financiero. Sin factura significa más consultas, más experimentos, más curiosidad.
- 128 GB es el punto ideal. 64 GB es el suelo para trabajos serios. 128 GB te da margen para ejecutar 70B en Q4_K_M y aún tienes espacio para todo lo demás.
- Ollama es la rampa de acceso fácil. LM Studio es excelente como navegador modelo, MLX es excelente si estás comenzando desde cero en Python, llama.cpp lo sustenta todo.
- La nube no está muerta. Sigue siendo la herramienta adecuada para la capacitación, el servicio escalable y las cargas de trabajo de carga desconocida.
¿Qué sigue?
Los artículos futuros cubrirán el ajuste fino de MLX en Apple Silicon, clústeres de inferencia multi-Mac con EXO, pilas de agentes (LangGraph + Ollama) y una pieza de metodología de referencia más profunda. Si desea la versión larga con todos los diagramas, código y matriz de decisión, lea el artículo largo. Si quieres la versión visual, mira el Cortometraje de YouTube. De cualquier manera, suscríbete para ver el resto de la serie.