Esta es la inmersión profunda en formato largo. Para obtener una versión más rápida y de lectura rápida, consulte el publicación de blog complementaria.
1. Introducción: ¿por qué un Mac Studio para IA local?
La IA local ya no es la curiosidad de un aficionado. Con los modelos de peso abierto de Meta, Mistral, Qwen y Microsoft madurando rápidamente, y la memoria unificada de Apple Silicon cruzando el umbral de 128 GB, ahora puede ejecutar modelos de lenguaje grandes, canalizaciones de incorporación y pilas RAG completas en una sola máquina de escritorio, silenciosamente, en una fracción del presupuesto de energía de una estación de trabajo típica GPU.
Este artículo explica cómo desempaquetar un Mac Studio con el chip M4 Max, el primer arranque, las lecturas reales en el dispositivo de mactopy un camino práctico desde "la caja está en mi escritorio" hasta "Estoy chateando con Llama 3 ejecutándose localmente y consultando mis propios documentos con RAG". Cada recomendación aquí se basa en lo que realmente observé en la máquina. Sin números de referencia inventados, sin tonterías de marketing: solo el flujo de trabajo.
Si es ingeniero, creador de IA, SRE o líder tecnológico y decide si un Mac Studio pertenece a la combinación de hardware de su equipo, esta guía es para usted.

2. Desembalaje del Mac Studio M4 Max
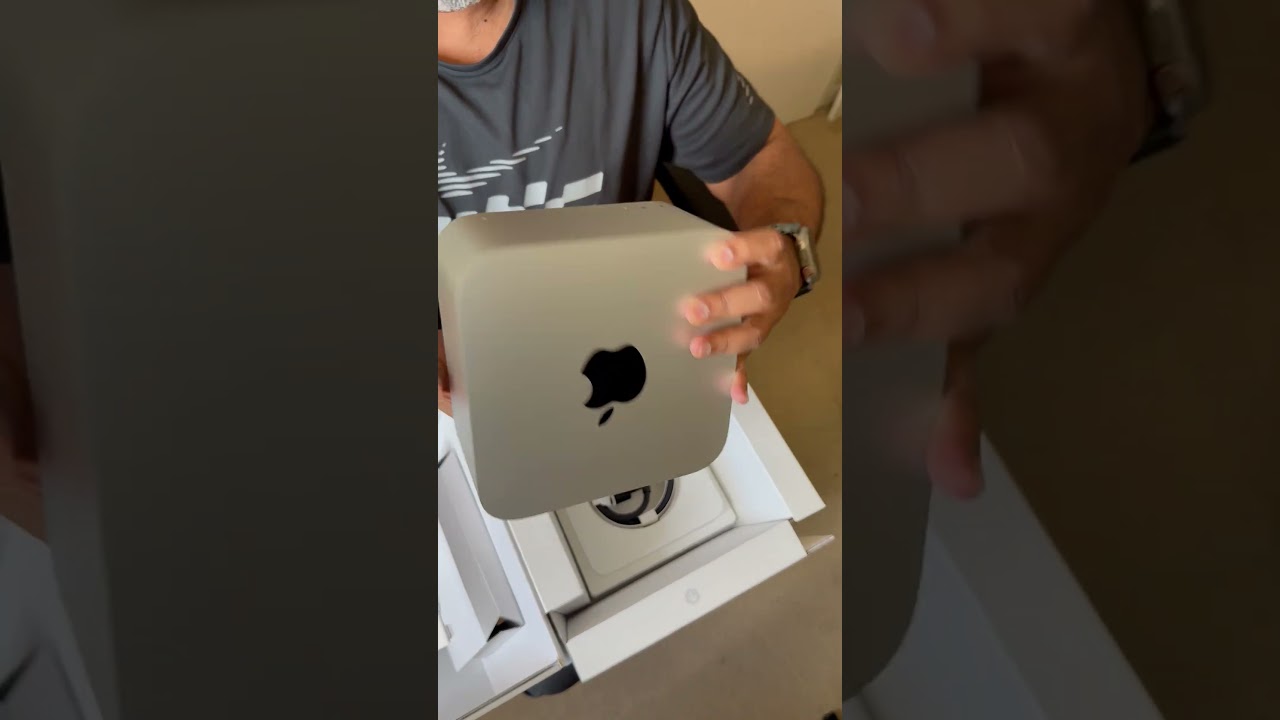
La experiencia de desempacar es la clásica de Apple: cartón mínimo, la máquina colocada en un hueco moldeado, un cable de alimentación negro corto, y eso es todo. Sin paquete de accesorios hinchado. El Mac Studio en sí es el mismo gabinete compacto de extrusión de aluminio presentado con el M1 Ultra original: aproximadamente 7,7 pulgadas cuadradas, denso en la mano, con la familiar entrada de listones en la parte inferior y una serie de puertos en la parte posterior.
Mire el corto de unboxing en YouTube: https://youtube.com/shorts/HUlUoHNsyNM
Grabé un breve clip del unboxing; mira el corto de YouTube arriba. La razón por la que un Short funciona tan bien para este formato es que la configuración real es realmente rápida. Primer complemento, activación del monitor, inicio de sesión con ID de Apple, idioma y región, FileVault, y en unos minutos estará en un escritorio utilizable.
2.1 Primer arranque: lecturas reales de mactop
Lo primero que hice después de que el sistema terminó su sincronización inicial fue instalar mactop - un excelente panel TUI de código abierto que muestra los contadores internos de Apple Silicon en tiempo real. Así es como se veía el panel recién instalado con 37 minutos de tiempo de actividad:

/img/mac-studio-mactop-firstboot.png para cambiarlo más tarde.Los números en esa captura de pantalla son los únicos números concretos que citaré en este artículo. Son la verdad fundamental para mi máquina inactiva en una configuración nueva:
- Apple Silicon: M4 Max
- CPU: 16 núcleos en total: 4 núcleos de eficiencia + 12 núcleos de rendimiento; Clúster E a 1,6 GHz, clúster P a 0,2 GHz; paquete a 37 C
- GPU: 40 núcleos a 784 MHz, 30 C
- Motor neuronal (ANE): 16 núcleos, consumiendo 0,00 W en reposo
- Memoria unificada: 128,00 GB en total, 16,62 GB en uso (aproximadamente 13%) en reposo
- Fuerza: 6,48 W en total: CPU 0,10 W, GPU 0,02 W, ANE 0 W, DRAM 0,36 W, Sistema 6,01 W. El máximo observado en la sesión fue 46,33 W. Térmicas: Nominal.
- Almacenamiento: Mac HD de 2,0 TB, 1,9 TB libres; 53.9 GB utilizado por el sistema operativo y la configuración inicial
- Red: Wi-Fi 6, con una lectura de muestra de 19,0 KB/s de carga y 156,8 KB/s de descarga durante la sincronización en segundo plano
Destacan dos cosas. Primero, 6,48 W en ralentí para una computadora de escritorio con 128 GB de memoria utilizable es notable: eso es menos de lo que muchas computadoras portátiles consumen con la pantalla apagada. En segundo lugar, el GPU tiene una frecuencia de 784 MHz con 40 núcleos disponibles; ese grupo está listo para hacer un trabajo real tan pronto como coloques un LLM frente a él.
3. Por qué el Mac Studio M4 Max es fantástico para la IA local
Para comprender por qué este hardware es tan adecuado para la IA local - y por qué la "memoria unificada" es más que una línea de marketing - es útil compararlo directamente con la alternativa canónica: una tarjeta GPU discreta en una PC, que se comunica con la RAM del sistema a través de PCIe.

3.1 Memoria unificada en lenguaje sencillo
En una plataforma de PC AI tradicional, tienes dos grupos de memoria. La RAM del sistema (generalmente 64-256 GB de DDR5) contiene los pesos del sistema operativo, la aplicación y el modelo cuando los carga desde el disco. El GPU tiene su propia VRAM: 24 GB en un RTX 4090, 32 GB en un 5090, 80 GB en un A100. Antes de que el GPU pueda ejecutar un solo matmul, el modelo debe ser copiado desde la RAM del sistema a la VRAM a través del bus PCIe. Si el modelo es más grande que VRAM, no se carga en absoluto o se pasa a través de PCIe a un costo brutal (a menudo entre 10 y 100 veces más lento que si se ejecuta completamente en VRAM).
Apple Silicon colapsa estos dos grupos en uno. El CPU, el GPU, el Neural Engine y los motores de medios ven el misma memoria física. No hay copia. No hay cuello de botella PCIe. Un modelo que tiene 40 GB en el disco tiene 40 GB en la memoria unificada y el GPU puede leerlo directamente.
Para los LLM locales, esta es la característica principal. Un modelo de parámetros 70B cuantificado a Q4_K_M tiene alrededor de 40 GB en disco (cifra citada públicamente para los pesos de clase Llama en ese nivel cuantitativo; trátelos como aproximados). En un GPU de consumo 24 GB, ese modelo simplemente no encaja. En la memoria unificada 128 GB, se carga con alrededor de 80 GB aún libres para contexto, código de aplicación y herramientas.
3.2 Eficiencia energética difícil de creer
La captura de pantalla de Mactop muestra 6,48 W en inactivo y un máximo de 46,33 W observado durante la sesión. Para poner eso en perspectiva: un solo RTX 4090 está inactivo a 15-25 W con el resto del sistema en la parte superior y consume hasta 450 W bajo carga. Un Mac Studio es una caja de IA de escritorio que puede dejar funcionando las 24 horas del día, los 7 días de la semana sin notarlo en la factura de electricidad. Está en silencio. Los ventiladores casi nunca giran durante las cargas de trabajo de inferencia. Esto es lo que lo hace viable como cuadro de desarrollo siempre activo de una manera que rara vez lo es una PC GPU discreta.
3.3 Qué hace realmente el Apple Neural Engine
El ANE es un acelerador de función fija de 16 núcleos optimizado para los tipos de operaciones tensoriales que produce CoreML. Para la mayoría de las cargas de trabajo LLM de peso abierto en 2026 (formato GGUF que se ejecuta a través de llama.cpp o Ollama), el ANE no está en la ruta activa; el GPU sí, a través de Metal Performance Shaders. El ANE brilla en modelos convertidos a CoreML, reconocimiento de voz en el dispositivo, segmentación de imágenes y cargas de trabajo similares de forma fija. También es extremadamente eficiente energéticamente cuando está en funcionamiento. Es útil saber que está ahí; no espere que todas las pilas LLM lo utilicen.
4. Configurar el Mac Studio para el trabajo con IA
Después de la incorporación estándar de macOS, aquí está el mensaje exacto que sigo para un Mac Studio nuevo que quiero usar como caja de desarrollo de IA local.
4.1 Instalar Homebrew, Xcode CLT y los conceptos básicos
/bin/bash -c "$(curl -fsSL https://raw.githubusercontent.com/Homebrew/install/HEAD/install.sh)"

xcode-select --install

brew install git wget jq python@3.12 node pyenv
brew install --cask iterm2 visual-studio-code
Homebrew trae las herramientas de Unix, Xcode Command Line Tools proporciona los compiladores y enlazadores, Python y Node le brindan un tiempo de ejecución para el código de la aplicación, y iTerm2 + VS Code son el par editor + terminal que utilizo de forma predeterminada.
4.2 Instalar Ollama
Ollama es la forma más fácil de descargar, ejecutar y servir LLM de peso abierto en macOS. Debajo del capó se envuelve llama.cpp con aceleración Metal y proporciona un HTTP API simple en el puerto 11434.
brew install ollama

ollama serve &

ollama --version
También puedes instalar a través del sitio oficial. .dmg de ollama.com, que configura una aplicación de barra de menú. Cualquiera de los dos caminos funciona. Prefiero la instalación Brew para cajas sin cabeza y dmg para Mac con controlador diario.
4.3 Instalar LM Studio (opcional pero vale la pena)
Estudio LM es una interfaz de usuario de escritorio para navegar, descargar y chatear con modelos GGUF. También expone un API compatible con OpenAI. Lo instalo junto con Ollama porque el navegador de modelo es excelente y la interfaz de usuario de ajuste de rendimiento por modelo es amigable cuando se decide entre Q4_K_M y Q5_K_M.
4.4 Instalar Continue.dev en VS Code
Continue.dev le brinda asistencia estilo ChatGPT dentro de VS Code, pero apunta a su Ollama local. Después de instalar la extensión, colóquela en su ~/.continue/config.json:
{
  "models": [
    {
      "title": "Llama 3.1 8B (local)",
      "provider": "ollama",
      "model": "llama3.1:8b",
      "apiBase": "http://localhost:11434"
    },
    {
      "title": "Qwen 2.5 Coder 14B (local)",
      "provider": "ollama",
      "model": "qwen2.5-coder:14b",
      "apiBase": "http://localhost:11434"
    }
  ],
  "tabAutocompleteModel": {
    "title": "Codestral (local)",
    "provider": "ollama",
    "model": "codestral:latest",
    "apiBase": "http://localhost:11434"
  }
}
Ahora tiene chat en línea, edición y autocompletado: todos los modelos de acceso que viven en el mismo escritorio que su editor. Cero datos salen de la máquina.
5. Ejecutando tu primer LLM

Llegó el momento de la verdad. Saque un modelo y ejecútelo.
5.1 Tirando de Llama 3.1 8B
ollama pull llama3.1:8b

ollama list

ollama run llama3.1:8b "Explain unified memory architecture to me in 3 sentences."
El pull descarga el Q4_K_M GGUF (Llama 3.1 8B en Q4_K_M tiene alrededor de 4.7 GB en el disco; cifra citada públicamente, trátela como aproximada). En una conexión Wi-Fi 6 como la mía, la descarga tarda unos minutos; en gigabit cableado es más rápido. Una vez que aterriza, el primero ollama run incluye una carga única del modelo en la memoria unificada (notará una breve pausa antes de que se transmita el primer token) y luego las ejecuciones posteriores son rápidas.
Deliberadamente no citaré aquí números de tokens por segundo para mi propia máquina, porque no he ejecutado un conjunto de pruebas comparativas controladas con una metodología emparejada. Lo que diré es que en esta clase de hardware (M4 Max con 40 núcleos GPU) deberías esperar transmisión fluida y conversacional de un modelo 8B en Q4_K_M, con un retraso de carga inicial notable y una salida constante durante toda la respuesta. Si ha leído afirmaciones como "Recibo 60 tokens por segundo en mi Mac" en otro lugar, trátelas como una guía aproximada; sus números reales variarán según la duración del mensaje, la ventana de contexto, el nivel de cuantificación, la arquitectura del modelo y qué más se está ejecutando.
5.2 Elección de una cuantificación: Q4_K_M, Q5_K_M, Q8_0
La cuantificación reduce la precisión de los pesos del modelo para reducirlos en el disco y en la memoria. La compensación es la calidad. Aquí está el modelo mental aproximado que utilizo cuando elijo un cuanto para la inferencia local:
| cuantitativo | Tamaño aproximado para 8B | Calidad frente al FP16 | cuando usar |
|---|---|---|---|
| Q4_K_M | ~4.7 GB | Muy bien, pequeña caída. | Por defecto. El mejor equilibrio entre velocidad y calidad para chat y código. |
| Q5_K_M | ~5.7 GB | Más cerca del 16º PM | Cuando necesitas un toque más de precisión y tienes memoria de sobra. |
| Q8_0 | ~8.5 GB | Casi sin pérdidas | Cuando necesitas máxima calidad y mínimo ruido en modelos pequeños. |
Todos los tamaños son cifras aproximadas citadas públicamente para pesas Llama clase 8B. El orden relativo es lo que importa.
5.3 Qué cabe en 32, 64 y 128 GB
| Memoria unificada | Zona de confort realista (Q4_K_M) | Estirar (con cuidado) |
|---|---|---|
| 32GB | 7B/8B/13B | 20-22B en un contexto ajustado |
| 64GB | 13B/20B/34B | 40-50B en un contexto ajustado |
| 128GB | 34B / 70B / variantes mezcla de expertos | 100-120B en un contexto ajustado |
"Zona de comodidad" significa que el modelo se carga con suficiente espacio para una ventana de contexto generosa, un caché KV y otras aplicaciones en ejecución. "Estirar" significa que se carga pero comienzas a hacer malabarismos con la longitud del contexto y otras cargas de trabajo. En mi caja 128 GB puedo ejecutar un 70B en Q4_K_M y aún tener aproximadamente 80 GB de espacio libre para VS Code, Chrome y un par de procesos Python, lo cual es, francamente, una sensación de lujo.
5.4 Llamar a Ollama desde Node y Python
Ollama expone un HTTP API en http://localhost:11434. Una pequeña búsqueda de nodo se ve así:
// node 20+
const res = await fetch("http://localhost:11434/api/generate", {
  method: "POST",
  headers: { "Content-Type": "application/json" },
  body: JSON.stringify({
    model: "llama3.1:8b",
    prompt: "Write a one-paragraph summary of unified memory architecture.",
    stream: false
  })
});

const data = await res.json();
console.log(data.response);
Y de Python:
import requests

r = requests.post(
    "http://localhost:11434/api/generate",
    json={
        "model": "llama3.1:8b",
        "prompt": "Explain HNSW indexes briefly.",
        "stream": False,
    },
    timeout=120,
)
print(r.json()["response"])
Esto es todo lo que necesita para conectar un LLM local a una herramienta CLI, un bot de Slack, un acceso directo, un microservicio o una automatización interna. Sin claves, sin límites de tarifas, sin cuotas.
6. Los mejores modelos para ejecutar en Mac Studio
Elegir un modelo es en parte rendimiento, en parte licencia y en parte vibra. Esto es lo que realmente ejecuto en el cuadro, agrupado por nivel de tamaño.
6.1 Pequeño (menos de 10B): rápidos caballos de batalla cotidianos
- Llama 3.1 8B - excelente charla y razonamiento de propósito general; Licencia Meta permisiva con advertencias.
- Mistral 7B / Ministral 8B - razonamiento sólido, variantes con licencia Apache disponibles.
- Qwen 2.5 7B - Rendimiento multilingüe y de código muy sólido.
- Phi-3.5 mini - pequeño, sorprendentemente capaz, ideal cuando se necesita rendimiento y baja latencia.
- Codificador Codestral / Qwen 2.5 7B - Autocompletado rápido en línea para trabajos IDE.
6.2 Mid (10B-40B): el punto óptimo en 64-128 GB
- Llama 3.1 / 3.3 70B (Q4_K_M) - si tienes 128 GB, este es el modelo principal; Calidad cercana a la frontera, funciona cómodamente.
- Qwen 2.5 32B - excelente relación calidad-tamaño; Combina bien con RAG.
- Codificador DeepSeek 33B - Fuerte en tareas de generación de código.
- Mixtral 8x7B - mezcla de expertos, solo activa 2 expertos a la vez, se adapta cómodamente.
6.3 Grande (70B y superiores): solo en 96-128 GB y solo en el cuarto trimestre
En 128 GB la puerta está abierta a los modelos de clase 70B en Q4_K_M. Ellos son Más lento que los modelos 8B, pero el salto de calidad es significativo para tareas que se benefician de un conocimiento mundial más amplio y un razonamiento más extenso. Espere que la latencia del primer token sea más larga y que el ritmo de transmisión disminuya, pero la experiencia real sigue siendo utilizable para muchos flujos de trabajo.
7. Construyendo una canalización RAG local
Una vez que tenga un LLM local, lo más útil que puede hacer con él es apuntarlo a sus propios documentos. Esta es la generación de recuperación aumentada, y es la carga de trabajo donde el Mac Studio realmente brilla como una alternativa privada a los API en la nube.

7.1 La pila
- analizador de documentos - PyMuPDF para archivos PDF,
unstructuredpara ingestión de formato mixto. - trozo - LangChain
RecursiveCharacterTextSplittero un divisor con reconocimiento de token. Tamaño de fragmento típico: 512-1024 tokens con 64-128 tokens superpuestos. - Incrustaciones -
nomic-embed-textomxbai-embed-large, ambos disponibles a través de Ollama. Ambos se ejecutan en el GPU local. - Tienda de vectores - ChromaDB por defecto. SQLite-VSS para una opción sin servidor. LanceDB si desea una opción integrada de un solo archivo que escale.
- Generador - Llama 3.1 8B para una respuesta rápida, o 70B si desea respuestas de la más alta calidad.
7.2 Ejemplo mínimo de Python: de principio a fin
pip install chromadb requests pypdf

import os, glob, requests, chromadb
from chromadb.utils import embedding_functions
from pypdf import PdfReader

OLLAMA = "http://localhost:11434"
EMBED_MODEL = "nomic-embed-text"
GEN_MODEL   = "llama3.1:8b"

def embed(text: str) -> list[float]:
    r = requests.post(f"{OLLAMA}/api/embeddings", json={
        "model": EMBED_MODEL, "prompt": text,
    }, timeout=60)
    return r.json()["embedding"]

def generate(prompt: str) -> str:
    r = requests.post(f"{OLLAMA}/api/generate", json={
        "model": GEN_MODEL, "prompt": prompt, "stream": False,
    }, timeout=300)
    return r.json()["response"]

def chunk(text: str, size: int = 1000, overlap: int = 150):
    out, i = [], 0
    while i < len(text):
        out.append(text[i:i+size])
        i += size - overlap
    return out

client = chromadb.PersistentClient(path="./rag-db")
col = client.get_or_create_collection("docs")

for path in glob.glob("./docs/**/*.pdf", recursive=True):
    reader = PdfReader(path)
    full = "\n".join(p.extract_text() or "" for p in reader.pages)
    for j, c in enumerate(chunk(full)):
        col.add(
            ids=[f"{os.path.basename(path)}::{j}"],
            documents=[c],
            embeddings=[embed(c)],
            metadatas=[{"source": path, "chunk": j}],
        )

def ask(q: str, k: int = 5) -> str:
    qe = embed(q)
    res = col.query(query_embeddings=[qe], n_results=k)
    ctx = "\n\n".join(res["documents"][0])
    prompt = (
        "Answer the question using only the context below. "
        "If the answer is not in the context, say you do not know.\n\n"
        f"Context:\n{ctx}\n\nQuestion: {q}\nAnswer:"
    )
    return generate(prompt)

print(ask("What is unified memory and why does it matter for LLMs?"))
Se trata de una canalización RAG local completa en menos de 60 líneas de Python. Todo se ejecuta en el Mac Studio. Sin claves API externas, sin facturación por token, sin datos que salen de la máquina. La primera ingesta de un conjunto de PDF de gran tamaño tardará unos minutos; Las consultas posteriores son rápidas.
7.3 Notas de afinación
- Tamaño del fragmento - empezar con 1000 caracteres y 150 de superposición; Aumente si sus fuentes tienen secciones estructuradas largas (especificaciones legales, técnicas) y el recuperador está fragmentando las respuestas.
- Top-k - 4-8 es el rango práctico. Ir mucho más alto infla la generación rápida y ralentiza sin ganancias obvias.
- Reclasificación - para obtener la más alta calidad, recupere el top 20 y vuelva a clasificar con un codificador cruzado (p. ej.
bge-reranker). En Mac Studio esto es barato. - Filtrado de metadatos - etiquetar fragmentos con su ruta de origen, fecha y sección; filtrar en el momento de la consulta antes de la búsqueda de vectores. Esta es la mayor victoria en precisión.
- Transmisión - cambiar
streamatrueen la llamada Ollama y transmite tokens al cliente para una experiencia de usuario ágil.
8. El ciclo diario del desarrollador
Después de un par de semanas en el Mac Studio, mi bucle diario se ve así:
- Abierto VS Code, Continue.dev se despierta contra Ollama.
- Abra un chat en Open WebUI (o LM Studio) para realizar preguntas y respuestas conversacionales más largas sobre mis notas.
- Para trabajo de código: autocompletar con pestañas en un modelo Codestral o Qwen Coder, chats más largos en Llama 3.1 8B, sesiones de razonamiento profundo en un 70B cuando la tarea lo amerita.
- Para RAG interno, un script de Python que apunta a la carpeta docs/ del proyecto y una base de datos Chroma.
- Para la creación de prototipos de agentes, LangGraph o un pequeño bucle personalizado que llama al punto final Ollama: el mismo patrón, diferente pegamento.
Lo que realmente cambia cuando tu LLM es local es la forma en que lo usas. No hay ningún costo incremental por una consulta, por lo que le hace más preguntas al modelo. No hay que preocuparse por la privacidad, por lo que puede pegar registros de producción, documentos internos y correos electrónicos de clientes. Escribe pequeños scripts CLI que revisan 200 documentos para extraer un resumen estructurado y no piensa dos veces en la factura por token, porque no hay factura.
9. Puntos de referencia y comparación honesta frente a la nube
Permítanme ser muy directo: no voy a publicar cifras de tokens por segundo que no haya producido con una metodología de referencia estrictamente controlada. Internet está inundado de números de este tipo, que a menudo comparan diferentes niveles de cuantificación, longitudes de contexto y formatos de indicaciones, y confunden más de lo que aclaran. Lo que haré en su lugar será publicar una matriz de decisiones que capture ¿En qué tipo de carga de trabajo Mac Studio realmente gana?, donde no es así y donde la respuesta correcta es "usar ambos".

9.1 Matemáticas de equilibrio
Un Mac Studio M4 Max con 128 memoria unificada GB y un SSD de 2 TB se ubica aproximadamente en el mismo rango de precios que unos meses de una instancia GPU en la nube siempre activa. Trate todas las cifras específicas en dólares como aproximadas y en función de la región y del descuento:
- Un Mac Studio M4 Max, bien configurado: aproximadamente entre $4000 y $6000 por única vez (aproximadamente; las configuraciones varían).
- Un AWS
g5.xlarge(A10G único, 24 GB VRAM) funcionando 24 horas al día, 7 días a la semana bajo demanda: del orden de $700-$900 por mes (según la región). - Un AWS
p4d.24xlarge(8x A100): orden de $20 000 a $30 000 por mes a pedido si de alguna manera lo dejaste encendido (no lo harías, pero hace que el contraste sea obvio).
La aritmética dice que para una caja de desarrollo siempre activa, el Mac Studio se amortiza en unos pocos meses en comparación con una instancia comparable en la nube siempre activa, y continúa amortizándose en términos de electricidad durante años. Para los trabajos de entrenamiento en ráfaga, las matemáticas cambian: alquilar por una hora, correr y devolverlo. Utilice la herramienta adecuada para el trabajo.
9.2 Cuando la nube es la respuesta correcta
- Necesita entrenar o perfeccionar un modelo más grande que el que cabe en el 128 GB.
- Debe prestar servicios a escala a una base de usuarios global con SLO estrictos y capacidad elástica.
- Está ejecutando un experimento que se beneficia del paralelismo 8x A100 o H100.
- La postura de cumplimiento de su organización establece que la inferencia debe ejecutarse en una región de nube específica con pistas de auditoría específicas.
9.3 Cuando el Mac Studio es la respuesta correcta
- Quieres un cuadro de inferencia privado siempre activo para tu equipo.
- Está creando RAG, agentes o copilotos IDE donde la residencia de los datos y la privacidad son importantes.
- Quiere una caja de desarrollo silenciosa y de bajo consumo que no requiera una sala de servidores.
- Está creando prototipos rápidamente y la facturación por token de un API en la nube se interpone en su camino.
- Quiere aprender la pila: poseer un modelo, poseer un tiempo de ejecución, poseer un almacén de vectores, poseer el bucle.
10. Desafíos y limitaciones
No le haría ningún favor a este artículo si no nombrara las asperezas. Apple Silicon es excelente para la IA local, pero existen verdaderas salvedades.
10.1 La formación sigue siendo una historia más débil que la inferencia
La historia de Apple Silicon AI es mucho más sólida para inferencia que para capacitación. El backend MPS de PyTorch ha madurado significativamente y el marco MLX de Apple es realmente bueno, pero la amplitud de las herramientas de capacitación exclusivas de CUDA es aún mayor. Si su trabajo diario son arquitecturas de modelos novedosos o ajustes finos a gran escala, encontrará agujeros que simplemente no encontrará en Linux + NVIDIA.
10.2 El ecosistema asume CUDA en muchos lugares
Muchos repositorios de IA todavía utilizan por defecto los supuestos de CUDA. La mayoría de los proyectos mantenidos ahora tienen rutas Metal/MPS, pero se esperan fricciones ocasionales: una biblioteca que requiere compilación desde el código fuente, un kernel que no tiene equivalente Metal, una suite de pruebas que solo se ejecuta en NVIDIA. Planifique tiempo para esto.
10.3 La ampliación es algo que puedes hacer tú mismo
Un Mac Studio es una sola caja. Herramientas como EXO y otros le permiten agrupar Mac para ejecutar modelos muy grandes en múltiples dispositivos, pero esta no es la historia pulida que se obtiene con un grupo Kubernetes de g5. Si su carga de trabajo necesita elasticidad horizontal, la nube es aún mejor.
10.4 Reparabilidad y actualizaciones
No puedes agregar RAM más tarde. No puedes cambiar el SSD más tarde (en la práctica). Compre lo que necesita y luego más uno, especialmente en memoria. El nivel 128 GB es el que recomendaría para trabajos serios de IA; 64 GB es el piso.
10.5 Térmicas bajo carga sostenida
El Mac Studio funciona de forma fresca y silenciosa en inactivo (la captura de pantalla anterior muestra 37 C y 30 C con los ventiladores inaudibles). Bajo una carga pesada y sostenida de LLM, los ventiladores giran (no ruidosamente, pero sí audiblemente) y el chip se calienta. Esto está dentro de los límites térmicos nominales; sólo tenga en cuenta que "silencio" es una caracterización inactiva y ligera, no absoluta.
11. El futuro de la IA local en Apple Silicon
Están convergiendo tres tendencias que hacen que los próximos 12 a 24 meses sean emocionantes para la IA local en Apple Silicon.
Primero, Los modelos de peso abierto siguen haciéndose más pequeños sin perder capacidad.. Phi-3.5, Qwen 2.5 pequeño y la familia Llama 3.x en 8B superan su categoría de peso. Un modelo 8B 2026 es aproximadamente comparable en calidad a un 70B 2023 en muchas tareas. Eso significa que más cargas de trabajo caben cómodamente en 32-64 GB de memoria unificada, y un 128 GB Mac Studio se convierte en una caja de servicio multimodelo.
Segundo, El marco MLX de Apple sigue mejorando. MLX proporciona un API similar a NumPy, evaluación diferida, reconocimiento de memoria unificada de forma predeterminada y gráficos de cálculo dinámico. La comunidad MLX ha estado portando modelos, tokenizadores y bucles de entrenamiento a un ritmo rápido. Si hoy está iniciando un nuevo proyecto de aprendizaje automático en una Mac, MLX es la elección natural; Si está utilizando PyTorch, el backend de MPS es más utilizable en cada versión.
Tercero, La cuantificación y la compresión de caché KV siguen mejorando. Técnicas como Q4_K_M, cuantificaciones de la familia IQ y mejoras en GGUF significan que el mismo modelo cabe en menos memoria que hace seis meses, con menos pérdida de calidad. La IA local está en una curva en la que cada generación de emparejamiento modelo + cuantitativo amplía el alcance práctico del hardware a precio de consumidor.
Agregue a todo esto los rumores sobre los futuros chips de la serie M (M5, futuros Ultras, actualizaciones de Studio), y la trayectoria es clara: La caja de IA del escritorio está aquí y sigue mejorando.
12. Fortalecer el Mac Studio como una caja de IA de equipo
Si desea compartir su Mac Studio con un equipo pequeño (por ejemplo, exponer Ollama, una instancia de Open WebUI y un punto final RAG a un puñado de colegas), aquí está el refuerzo aproximado que hago:
- FileVault activado y una contraseña de inicio de sesión segura. Guárdelo en un UPS.
- Escala de cola en la caja para que sea accesible desde los dispositivos de su equipo sin exponerlo a la Internet pública.
- Vincular Ollama al host local y enfréntelo con un proxy de autenticación delgado (Caddy, Traefik o un pequeño servidor Node/Python) que maneja la autenticación y la limitación de velocidad antes de reenviar a
11434. - Ejecute Open WebUI en Docker Desktop con un volumen persistente; apúntelo al punto final local Ollama.
- Copias de seguridad para la base de datos RAG a un SSD externo cifrado o a un destino Time Machine.
- Actualización automática Paquetes macOS y Homebrew según un cronograma; fije Ollama y las versiones del modelo intencionalmente en lugar de extraer automáticamente la última versión.
Si se hace bien, tendrá un punto final de IA privado y apto para auditorías que su equipo usa todos los días y que nunca envía un token fuera de la red del edificio.
13. Conclusión: una revolución silenciosa sobre el escritorio
Desembalar un Mac Studio M4 Max en 2026 se parece menos a comprar una computadora de escritorio y más a comprar un pequeño dispositivo de inteligencia artificial que también es una Mac. 128 GB de memoria unificada, 40 núcleos GPU, 16 núcleos CPU, un Neural Engine, codificadores de medios de hardware, un SSD de 2 TB y un consumo de energía inactivo medido en vatios individuales, todo en una caja que puede tomar con una mano.
La configuración es rápida, el primer LLM se ejecuta en una hora y en una tarde tiene un canal RAG privado que responde preguntas sobre sus propios documentos. Todo sucede en su escritorio, sin que la factura de la nube suba de fondo. Eso cambia la forma de construir con IA de una manera que es difícil de transmitir hasta que la pruebas.
Si está evaluando si un Mac Studio pertenece a la combinación de hardware de su equipo, espero que este artículo le brinde una visión fundamentada: qué es sorprendente, qué es difícil, dónde sigue ganando la nube y dónde la caja de su escritorio es la mejor respuesta. el compañero blog corto resume el mismo flujo de trabajo en una lectura de 5 minutos para compartir.
Si esto fue útil - mira el unboxing en YouTube (https://youtube.com/shorts/HUlUoHNsyNM), suscríbase al canal para ver tutoriales de seguimiento (ajuste fino de MLX, inferencia multi-Mac, pilas de agentes) y vuelva a consultar aquí para ver el siguiente artículo de la serie. La IA local en Apple Silicon recién está comenzando y seguiré escribiendo a medida que la pila madure.
Instantánea de SEO para este artículo
- Título SEO: Unboxing Mac Studio M4: ejecute su primer LLM localmente
- Meta descripción: Desembale un Mac Studio M4 Max con 128 memoria unificada GB, instale Ollama, ejecute Llama 3 localmente y cree una canalización RAG privada. Lecturas reales, comparaciones honestas.
- Palabras clave principales: Mac Studio AI, Mac Studio LLM, Ejecución de LLM en Mac Studio, Ollama Mac Studio, Apple Silicon AI, Configuración de AI local, Mac Studio RAG, Tutorial de LLM local, Ejecute Llama localmente, Revisión de Mac Studio M4.
- Twitter / X (menos de 280 caracteres): Un Mac Studio M4 Max sin caja. 128 memoria unificada GB. Está inactivo a 6,48 W. Sacó Llama 3.1 8B a través de Ollama, construyó una tubería RAG local en una tarde, sin factura de nube. Tutorial completo de 4000 palabras + 6 diagramas + el corto de YouTube. #AppleSilicon #LocalLLM
- Publicación de LinkedIn: El nuevo Mac Studio M4 Max aterrizó en mi escritorio y lo traté como un dispositivo de inteligencia artificial: lecturas reales de mactop (6,48 W inactivo, 128 GB UMA, 40 núcleos GPU), instalación de Ollama, Llama 3.1 8B ejecutándose localmente, un canal RAG completo con mis propios documentos, todo en una tarde. Escribí todo el flujo de trabajo, con seis diagramas originales, una matriz de decisión honesta entre la nube y la ubicación local y una sección sobre dónde sigue ganando la nube. Si está evaluando la IA local para su equipo, este es un buen punto de partida.