El Kimi K3 de Moonshot AI no inventó los pesos abiertos: Llama, DeepSeek, Qwen y otros ya probaron la categoría. Lo que cambió a finales de julio de 2026 es que un modelo open-weight de ~2,8 billones de parámetros, con contexto de 1M tokens y serving de producción day-0, ahora compite en cargas de trabajo agent antes reservadas a Anthropic y OpenAI. Esta guía Workstation es para desarrolladores y líderes tecnológicos que deben decidir: self-host, API gestionada o híbrido — y qué otros modelos abiertos merecen estar en el radar.
1. Qué envió Moonshot
Según el GitHub y materiales técnicos de Moonshot (pesos públicos ~27 jul 2026):
- Kimi K3 — open-weight, modelo agentic multimodal nativo; ~2,8T parámetros totales (MoE).
- Arquitectura: Kimi Delta Attention (KDA), Attention Residuals (AttnRes), Stable LatentMoE; activación sparse de expertos (orden de 16 de 896 expertos / ~100B params activos por token — confirmar en la model card en vivo).
- Contexto de 1M tokens; visión + tool use + coding/knowledge work de largo horizonte.
- Pesos: Hugging Face
moonshotai/Kimi-K3(suele distribuirse en MXFP4; huella ~1,4 TB). - Motores de inferencia day-0: vLLM, SGLang, TokenSpeed; API alojada en platform.kimi.ai.
Licencia: Kimi K3 License — no es un permiso SaaS libre. Empresas y proveedores Model-as-a-Service deben revisar legalmente antes de productizar (VentureBeat y análisis independientes señalaron umbrales comerciales). Open weights ≠ abierto para todo modelo de negocio.
2. ¿Puede seguir el ritmo de Anthropic y OpenAI?
Respuesta corta para builders: en varios benches relevantes para agents, sí — lo bastante cerca como para que el default ya no sea «solo closed».
Evaluaciones de comunidad y vendors tras el lanzamiento situaron a K3 en la misma banda que los modelos propietarios líderes en SWE-bench Verified y suites tipo LiveCodeBench, con tool-use competitivo frente a baselines Claude Sonnet y GPT-4o-class. Ese es el hito: los open weights superan el listón en tareas agent, no solo trivia MMLU.
Caveats que Workstation insiste:
- Los benchmarks son sensibles al harness — ejecuta tu golden set.
- Las ganancias de latencia p50 pueden ocultar dolor p95/p99 en cadenas multi-tool.
- Los labs closed siguen liderando en pulido de producto, tooling de seguridad y SLAs de soporte.
- El routing híbrido (open para datos privados + closed para peak-critical) sigue siendo la arquitectura pragmática.
3. Por qué la infraestructura se movió en días, no meses
El giro estratégico es la madurez del serving:
- vLLM publicó guía de producción day-0: prefix caching KDA-aware, kernels NVIDIA/AMD, disaggregación prefill/decode, speculative decoding (draft models DSpark), tool calling, structured output.
- Los motores de inferencia cloud e hiperescaladores (incluidas recetas AWS SageMaker HyperPod / EKS) publicaron rutas de despliegue la misma semana que aparecieron los pesos.
- Resultado: elegir self-host vs managed es cada vez más una decisión de config y FinOps, no un proyecto de investigación de un trimestre — si ya tienes capacidad GPU y músculo MLOps.
4. Realidad del hardware (no lo saltes)
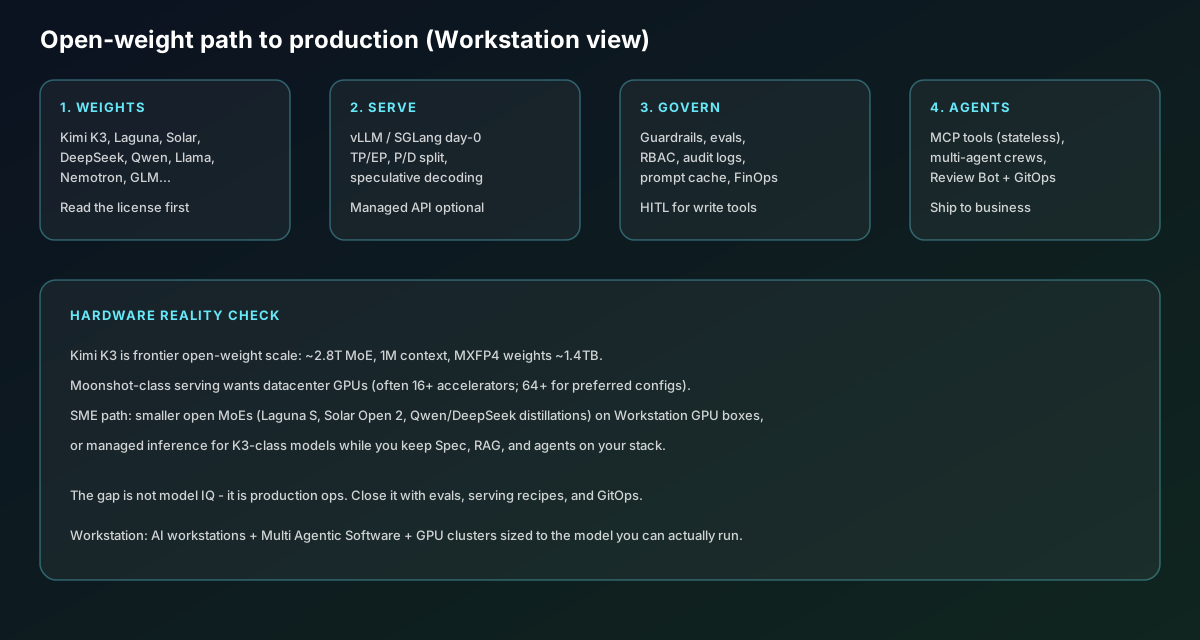
K3 no es un modelo de laptop. La guía orientada a Moonshot apunta a despliegues a escala de datacenter (a menudo 16+ GPUs de gama alta como camino mínimo creíble en notas vLLM; configs preferidas hasta 64+ aceleradores). Solo los pesos son de clase terabyte.
Camino SME / mid-market: ejecuta MoEs open más pequeños en boxes AI Workstation; llama a K3 vía API gestionada cuando necesites ese IQ; mantén corpora RAG y agents privados.
Camino enterprise: cluster GPU + vLLM/SGLang + GitOps + evals — o compra capacidad gestionada e invierte ingeniería en la capa agent en lugar de kernels.
Vídeo: walkthrough práctico de serving cloud con vLLM — útil antes de dimensionar un nodo clase K3.
5. Trasfondo de política y seguridad
En la misma ventana NVIDIA y partners impulsaron la Open Secure AI Alliance y amplificaron la carta Open Weights and American AI Leadership (270+ orgs). El argumento: los open weights no son solo una historia económica — los defensores necesitan modelos inspeccionables para red-teamear agents y cadenas de suministro de software. Combina apertura con evals, guardrails y cultura de parches rápidos — no un «prohibir modelos open» ingenuo.
6. MCP pasó a stateless (por qué les importa a los agents)
La especificación MCP 2026-07-28 es la mayor revisión del protocolo desde el lanzamiento:
- Elimina el handshake initialize y
Mcp-Session-Id— las requests llevan version/capabilities en_meta. - Cualquier instancia detrás de un load balancer simple puede servir cualquier request (sin impuesto de sesión sticky Redis).
- Auth endurecida alineada con OAuth/OIDC; política formal de deprecación ~12 meses.
- Extensiones: MCP Apps (UIs renderizadas en servidor), MCP Tasks (handles de jobs durables de larga duración).
Para stacks multi-agent de Workstation, MCP stateless significa que las flotas de tools escalan como microservicios HTTP normales — la pieza que faltaba cuando los modelos open alcanzan por fin IQ agent-grade.
7. La brecha de producción (sigue siendo la historia real)
Las encuestas de industria (incluido el reporting open-source AI de Mozilla) repiten un patrón: los desarrolladores prueban open weights a altas tasas, pero una menor proporción llega a producción que los equipos closed-API — y la brecha suele ampliarse con el tamaño de la empresa. Los vendors closed venden un camino pavimentado; los modelos open aún requieren que poseas serving, scaling, observabilidad y seguridad. Kimi K3 sube el techo; no elimina la mitad ops del trabajo.
8. Modelos en nuestro radar (ampliado)
Más allá de K3, Workstation vigila este conjunto open / semi-open para coding agentic y stacks AI privadas (verifica licencias y benches antes del procurement):
| Modelo | Por qué importa | Encaje |
|---|---|---|
| Kimi K3 (Moonshot) | MoE 2,8T, ctx 1M, coding agent open frontier | Cluster / API gestionada |
| Laguna S 2.1 (Poolside) | MoE 118B-A8B, ctx 1M, fuertes benches Terminal/SWE, OpenMDW | Agents SWE self-host |
| Solar Open 2 (Upstage) | 250B-A15B, ctx 1M, office/coding agentic, ángulo soberano KR | Clase 4–8× H200 |
| DeepSeek-V4 family | Presión MoE open continua en price-performance reasoning/coding | Agents cost-sensitive |
| Qwen 3.x / Max (Alibaba) | Ecosistema multilingüe + tools amplio; destilaciones para workstations | Stack open por defecto |
| Llama 4 class (Meta) | Ecosistema permisivo, enorme fine-tune/tooling comunitario | Fine-tunes / RAG |
| Nemotron 3 (NVIDIA) | Open weights alineados con la historia serving/seguridad de NVIDIA | Estates GPU-native |
| GLM-4.x / 5 (Zhipu) | Fuerte linaje agent/tooling; vigilar licencia + región de hosting | Agents tool-heavy |
| KAT-Coder-V2.5 (Kwaipilot) | Especialista coding MoE ~35B-A3B; Apache 2.0; tamaño SWE-bench | SWE Workstation |
| Mistral Large / Magistral | Opciones comerciales open EU-friendly; fuerte historia de tooling | AI privada UE |
| Gemma 3 (Google) | Modelos open eficientes para edge y on-device | Edge / Mac Silicon |
| Phi-4 class (Microsoft) | Reasoners pequeños y capaces para boxes limitados | Workstations SME |
| Mage-Flow (Microsoft) | Text-to-image / edit compacto ~4B; MIT; rivaliza stacks de difusión mayores | Creativo local |
| Inflect v2 (Owen Song) | TTS inglés local tiny (Nano/Micro); Apache 2.0 | Voz offline |
| Claude Opus 5 / Fable 5 (closed) | Sigue siendo el techo de calidad para muchas rutas coding/agent en Bedrock | Ruta peak híbrida |
| GPT-5.6 Sol/Terra/Luna (closed) | Inferencia closed por niveles para diseños de router | Failover gestionado |
9. Patrones prácticos que recomienda Workstation
Private RAG + tools on open weights (Qwen / Laguna / Solar / DeepSeek)
        │
        ├─ Lead planner on K3 API or Opus 5 (Bedrock) when stuck
        ├─ Builders on mid open MoE self-hosted
        ├─ Review Bot + human gate
        └─ GitOps promote
- Escribe un ADR: modelo open por defecto + modelo closed de failover.
- Golden eval set (50–100 tareas) antes de voltear producción.
- Mide p95/p99 en cadenas multi-tool agent — no solo el TTFT mediano.
- Prompt-cache con cuidado (un UUID al inicio del prompt puede destruir hit rates).
- Actualiza servidores MCP a 2026-07-28 antes de escalar horizontalmente.
- Dimensiona GPUs al modelo que realmente servirás — no al titular del blog.
10. Cierre
Kimi K3 es una prueba: los open weights ahora disputan el trabajo agent frontier, y el ecosistema de serving (vLLM, SGLang, recetas cloud) mantiene el ritmo en días. Grupos de policy argumentan que los modelos open son parte de la ciberdefensa, no solo del control de costes. Para negocios, la jugada ganadora es un router híbrido en hardware Workstation-grade y Multi Agentic Software — open donde dominan privacy y coste, closed donde lo exigen los SLAs de calidad, con MCP, evals y GitOps para que «probamos un modelo open» se convierta en «hacemos ship sobre modelos open».
Publicado por Workstation. Specs y benches se mueven semanalmente — vuelve a comprobar model cards, licencias y política regional antes de comprar silicon.


