
深度学习(DL)是基于多层神经网络的表示学习:优化参数 θ,使非线性变换的复合将高维输入(像素、token、波形)映射到任务输出(标签、框、嵌入或采样序列)。本 Workstation 技术简报为在 Kubernetes、SageMaker 与 Bedrock 上交付系统的工程师与 AI 智能体重写了 AWS 概念概览。
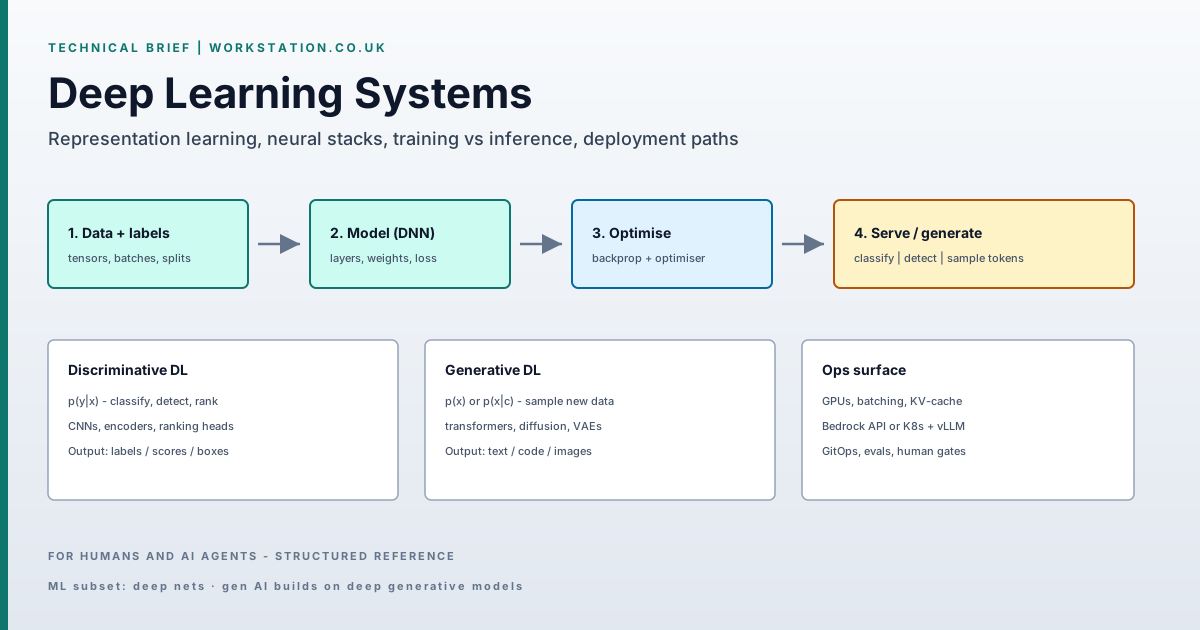
- 定义:DL ⊂ ML;多层 ANN 主要通过对可微损失的梯度下降训练。
- 划分:判别式 p(y|x) vs 生成式 p(x) 或 p(x|c)。
- Gen AI:通常是大型 transformers(或扩散)+ 服务 + 策略;并非独立于 DL 的学科。
- 硬约束:标注/清洗数据量、加速器 FLOPs/VRAM、漂移/运维。
- 路由:表格 → 经典 ML;感知 → 训练/服务 DL;语言智能体 → foundation model API 或开源权重推理。
主要来源:AWS — What is Deep Learning?。规格与服务名称会变化;开通前请核对当前 AWS 文档。
1. 形式化定义
深度模型是由 L 层组成的参数函数 f_θ。第 ℓ 层计算 h^(ℓ) = σ(W^(ℓ) h^(ℓ−1) + b^(ℓ)),其中 σ 为非线性(ReLU、GELU、SiLU 等)。训练搜索 θ = {W, b, …} 以最小化经验风险:
θ* = argmin_θ  (1/N) Σ_i  L( f_θ(x_i), y_i )  +  Ω(θ)
# L = CE / MSE / CTC / contrastive / RL objective, depending on task
# Gradients via reverse-mode autodiff (backpropagation); update with SGD/Adam/…
与依赖手工特征的浅层流水线不同,深度网络从原始或轻度预处理的张量中学习层次化特征。因此 DL 主导视觉、语音与大规模 NLP:特征空间维度过高,难以手工工程。
2. 判别式与生成式深度学习
判别式模型估计 p(y|x) 或决策边界——分类器、检测器、排序器、嵌入器。生成式(deep generative)模型估计 p(x) 或 p(x|c),并可采样新实例:next-token LLM、扩散图像模型、VAE、GAN。
产品智能体中使用的 foundation model 是经大规模训练后对齐并提供服务的深度生成系统。调用 Bedrock Converse 或自托管 vLLM 端点,是在此类模型上做推理——底层仍是深度学习。
3. 为何生产系统依赖它
已嵌入 DL(或基于 DL 的 foundation model)的部署面:
- 对话智能体与代码合成
- ASR / TTS 与语音界面
- 序列上的欺诈/异常评分
- 感知栈(ADAS、工业 CV、医学影像)
- 深度塔式个性化与搜索排序
若路线图项是「AI 功能」,实现几乎总是深度模型、foundation-model API,或其上的混合方案(RAG + 工具)。
4. 任务分类(实现地图)
4.1 计算机视觉
CNN / ViT 将图像张量映射为类别、框、掩码或嵌入。生产模式:内容审核、属性识别、logo/PPE 检测、在线缺陷检测。指标:mAP、IoU、目标 GPU 上 batch size 1 的延迟。
4.2 语音
声学模型 + 语言模型(或端到端 ASR)可容忍口音、SNR 与语速差异。负载:联络中心辅助、临床听写、字幕。指标:WER、实时因子(RTF)。
4.3 NLP
从编码器分类器到 decoder-only LLM。负载:intent/slot、摘要、文档问答、情感索引。LLM 主导开放文本;较小编码器在延迟受限的分类/抽取上仍占优。
4.4 推荐系统
在 user–item 交互序列上的 two-tower / DeepFM / transformer 排序器。输出:带多样性与业务约束的排序列表。离线:NDCG/recall;在线:带探索控制的 CTR/CVR。
4.5 生成式应用
采样 + 工具使用:私有语料上的 RAG、代码辅助、文档起草、多智能体工作流。在 AWS:Bedrock FM 或 SageMaker 托管权重。在 Workstation 环境:当驻留性或单位经济性要求时,在 GitOps 下使用 Kubernetes GPU 池(vLLM/Ollama)。
5. 架构:层与前向传播
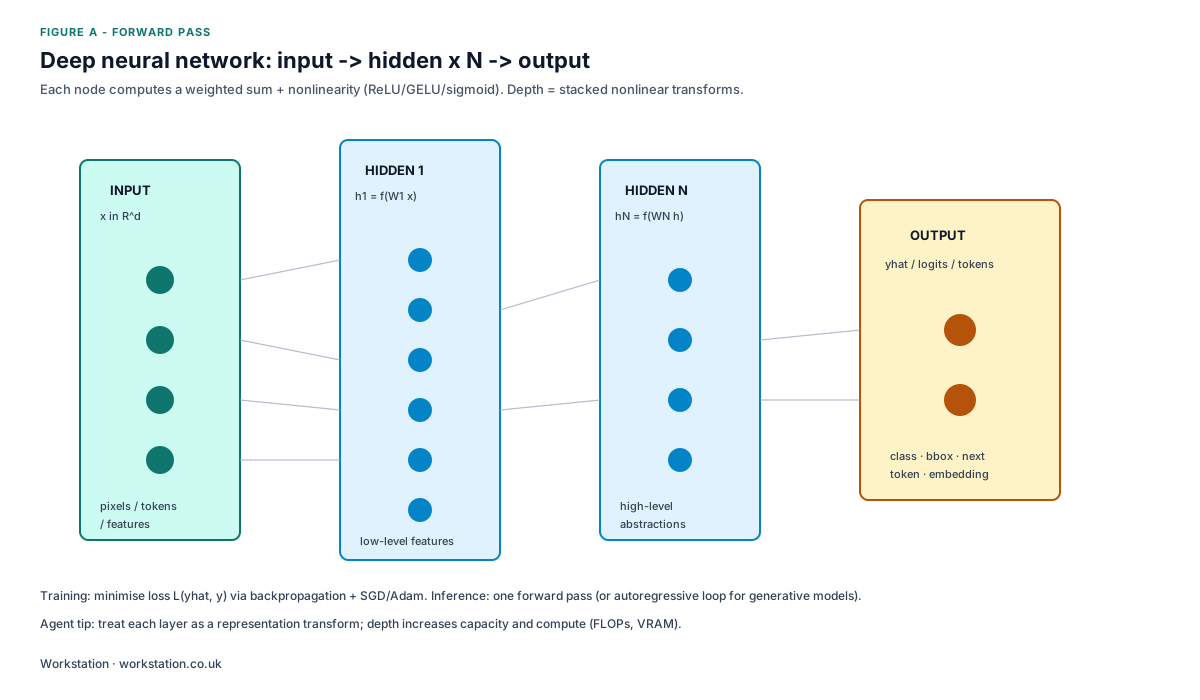
- 输入层 — 张量接口:归一化像素、token ID、log-mel 帧或表格向量。
- 隐藏层 — 连续的表示变换。早期层捕获局部结构(边缘、n-gram);更深层捕获任务语义。深度增加表达能力与算力(FLOPs、激活内存)。
- 输出层 — 任务头:softmax logits、边界框回归、CTC,或自回归解码的词表投影。
训练 = 多次前向 + 反向传播。推理 = 仅前向(LLM 另加 KV-cache / speculative decoding)。
6. ML vs DL vs 生成式 AI
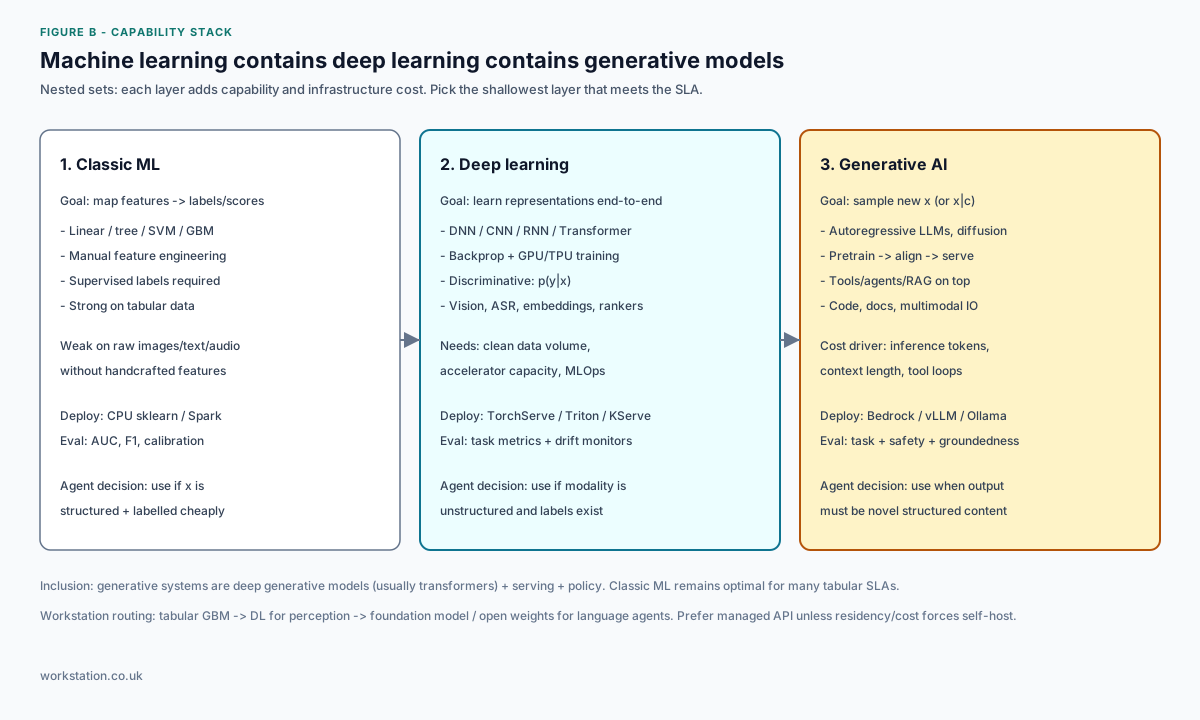
| 层级 | 目标 | 典型栈 |
|---|---|---|
| 经典 ML | 带工程化 φ 的 p(y|φ(x)) | 数仓表上的 GBM / 线性模型 |
| 深度学习 | 原始模态上的端到端 f_θ(x) | GPU 节点上的 PyTorch + Triton/KServe |
| 生成式 AI | 采样 x 或 x|c;其上叠加智能体/工具 | Bedrock Converse 或 vLLM + RAG |
6.1 DL 相对浅层 ML 的优势(适用时)
- 非结构化模态 — 共享嵌入压缩复述差异(「支付」vs「转账」)。
- 特征发现 — 梯度在无需手工特征列表时雕刻出有用内部表示。
- 迁移 / 微调 — 复用预训练骨干;相对从头训练减少标注数据。
- 序列 / 集合建模 — transformers 处理 bag-of-features 错过的长程依赖。
在特征强的稠密表格数据上,DL 不会自动击败调优良好的 GBM。按模态与数据制度选择,而非跟风。
7. 失效模式与约束
- 数据质量 — 标签噪声与分布偏移主导误差预算。版本化数据集;在进入训练集前隔离异常值。
- 算力 — 训练与大批次推理受加速器约束。GPU 过小会导致数日循环并扼杀迭代速度。
- 运维 — 没有评估门禁、漂移监控、成本遥测与回滚(GitOps),无论架构图如何,模型都会在生产中腐烂。
8. 云加速 vs 自托管
云缩短实验周期:弹性 GPU/CPU 池、托管笔记本/流水线,以及作为 API 的 foundation model。AWS 构建块:
- Amazon SageMaker — 训练、调优、托管自定义 DL 制品。
- Amazon Bedrock — 以 IAM、Guardrails 与可选 ZDR 调用 foundation model。
当开源权重、数据驻留或 token 经济性有利于自有 GPU 时,在 Kubernetes 上自托管。模式:model registry + KServe/vLLM + Argo CD 同步。
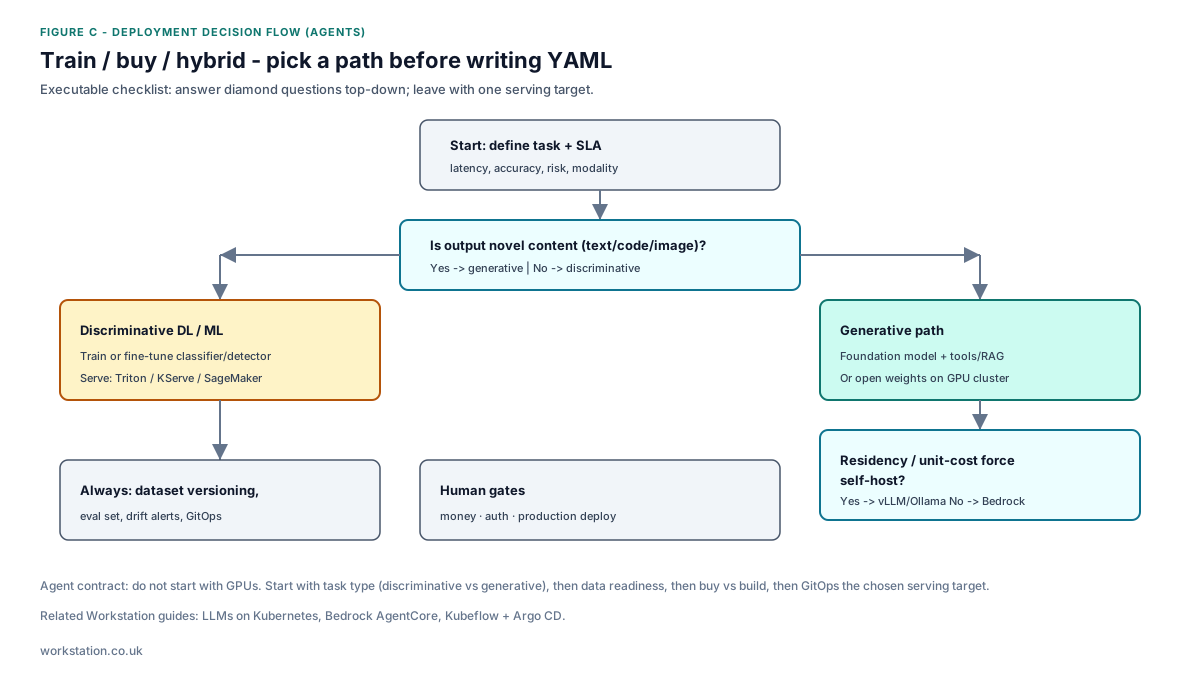
9. 执行清单
- 将任务写成可衡量目标(指标 + 延迟 + 风险等级)。
- 从图 B 选择栈层;不要为表格记分卡跳到 gen AI。
- 预算数据准备 + 推理 OpEx;训练往往只占生命周期成本少数。
- 广泛上线前实现评估框架;接入漂移告警。
- 后续阅读:LLM 服务或Bedrock 智能体。
由 Workstation 发布 — 自动化平台、多智能体软件、Kubernetes 交付。


