这是长篇深入探讨。如需更快、略读的版本,请参阅 同伴博客文章.
1. 简介:为什么选择 Mac Studio 来实现本地 AI?
本地人工智能不再是业余爱好者的好奇心。随着 Meta、Mistral、Qwen 和 Microsoft 的开放权重模型的快速成熟,以及 Apple Silicon 的统一内存突破了 128 GB 阈值,您现在可以在一台台式计算机上安静地运行强大的大型语言模型、嵌入管道和完整的 RAG 堆栈,而功耗预算仅为典型工作站 GPU 的一小部分。
本文将介绍如何拆箱 Mac Studio 与 M4 Max 芯片,第一次启动,设备上的真实读数 mactop,以及从“盒子在我的桌子上”到“我正在与本地运行的 Llama 3 聊天并使用 RAG 查询我自己的文档”的实用路径。这里的每一个建议都是基于我在机器上实际观察到的。没有发明的基准数字,没有营销废话——只有工作流程。
如果您是工程师、AI 构建者、SRE 或技术主管,正在决定 Mac Studio 是否属于您团队的硬件组合,那么本指南适合您。

2. Mac Studio M4 Max 拆箱
拆箱体验是经典的苹果风格:最小的纸板,机器放在模制凹槽中,一根短的黑色电源线,仅此而已。没有臃肿的配件包。 Mac Studio 本身与最初的 M1 Ultra 推出的紧凑型铝挤压外壳相同:大约 7.7 英寸见方,握在手里很密集,底部有熟悉的板条进气口,背面有一系列端口。
在 YouTube 上观看拆箱短片: https://youtube.com/shorts/HUlUoHNsyNM
我拍摄了拆箱短片 - 请观看上面的 YouTube 短片。短片之所以适合这种格式,是因为实际设置速度非常快。第一个插件、显示器唤醒、Apple ID 登录、语言和区域、FileVault,几分钟之内您就可以使用可用的桌面。
2.1 首次启动 - 实际读数 mactop
系统完成初始同步后我做的第一件事就是安装 麦克托普 - 一个优秀的开源 TUI 仪表板,可实时显示 Apple Silicon 的内部计数器。以下是全新安装的仪表板在正常运行 37 分钟后的样子:
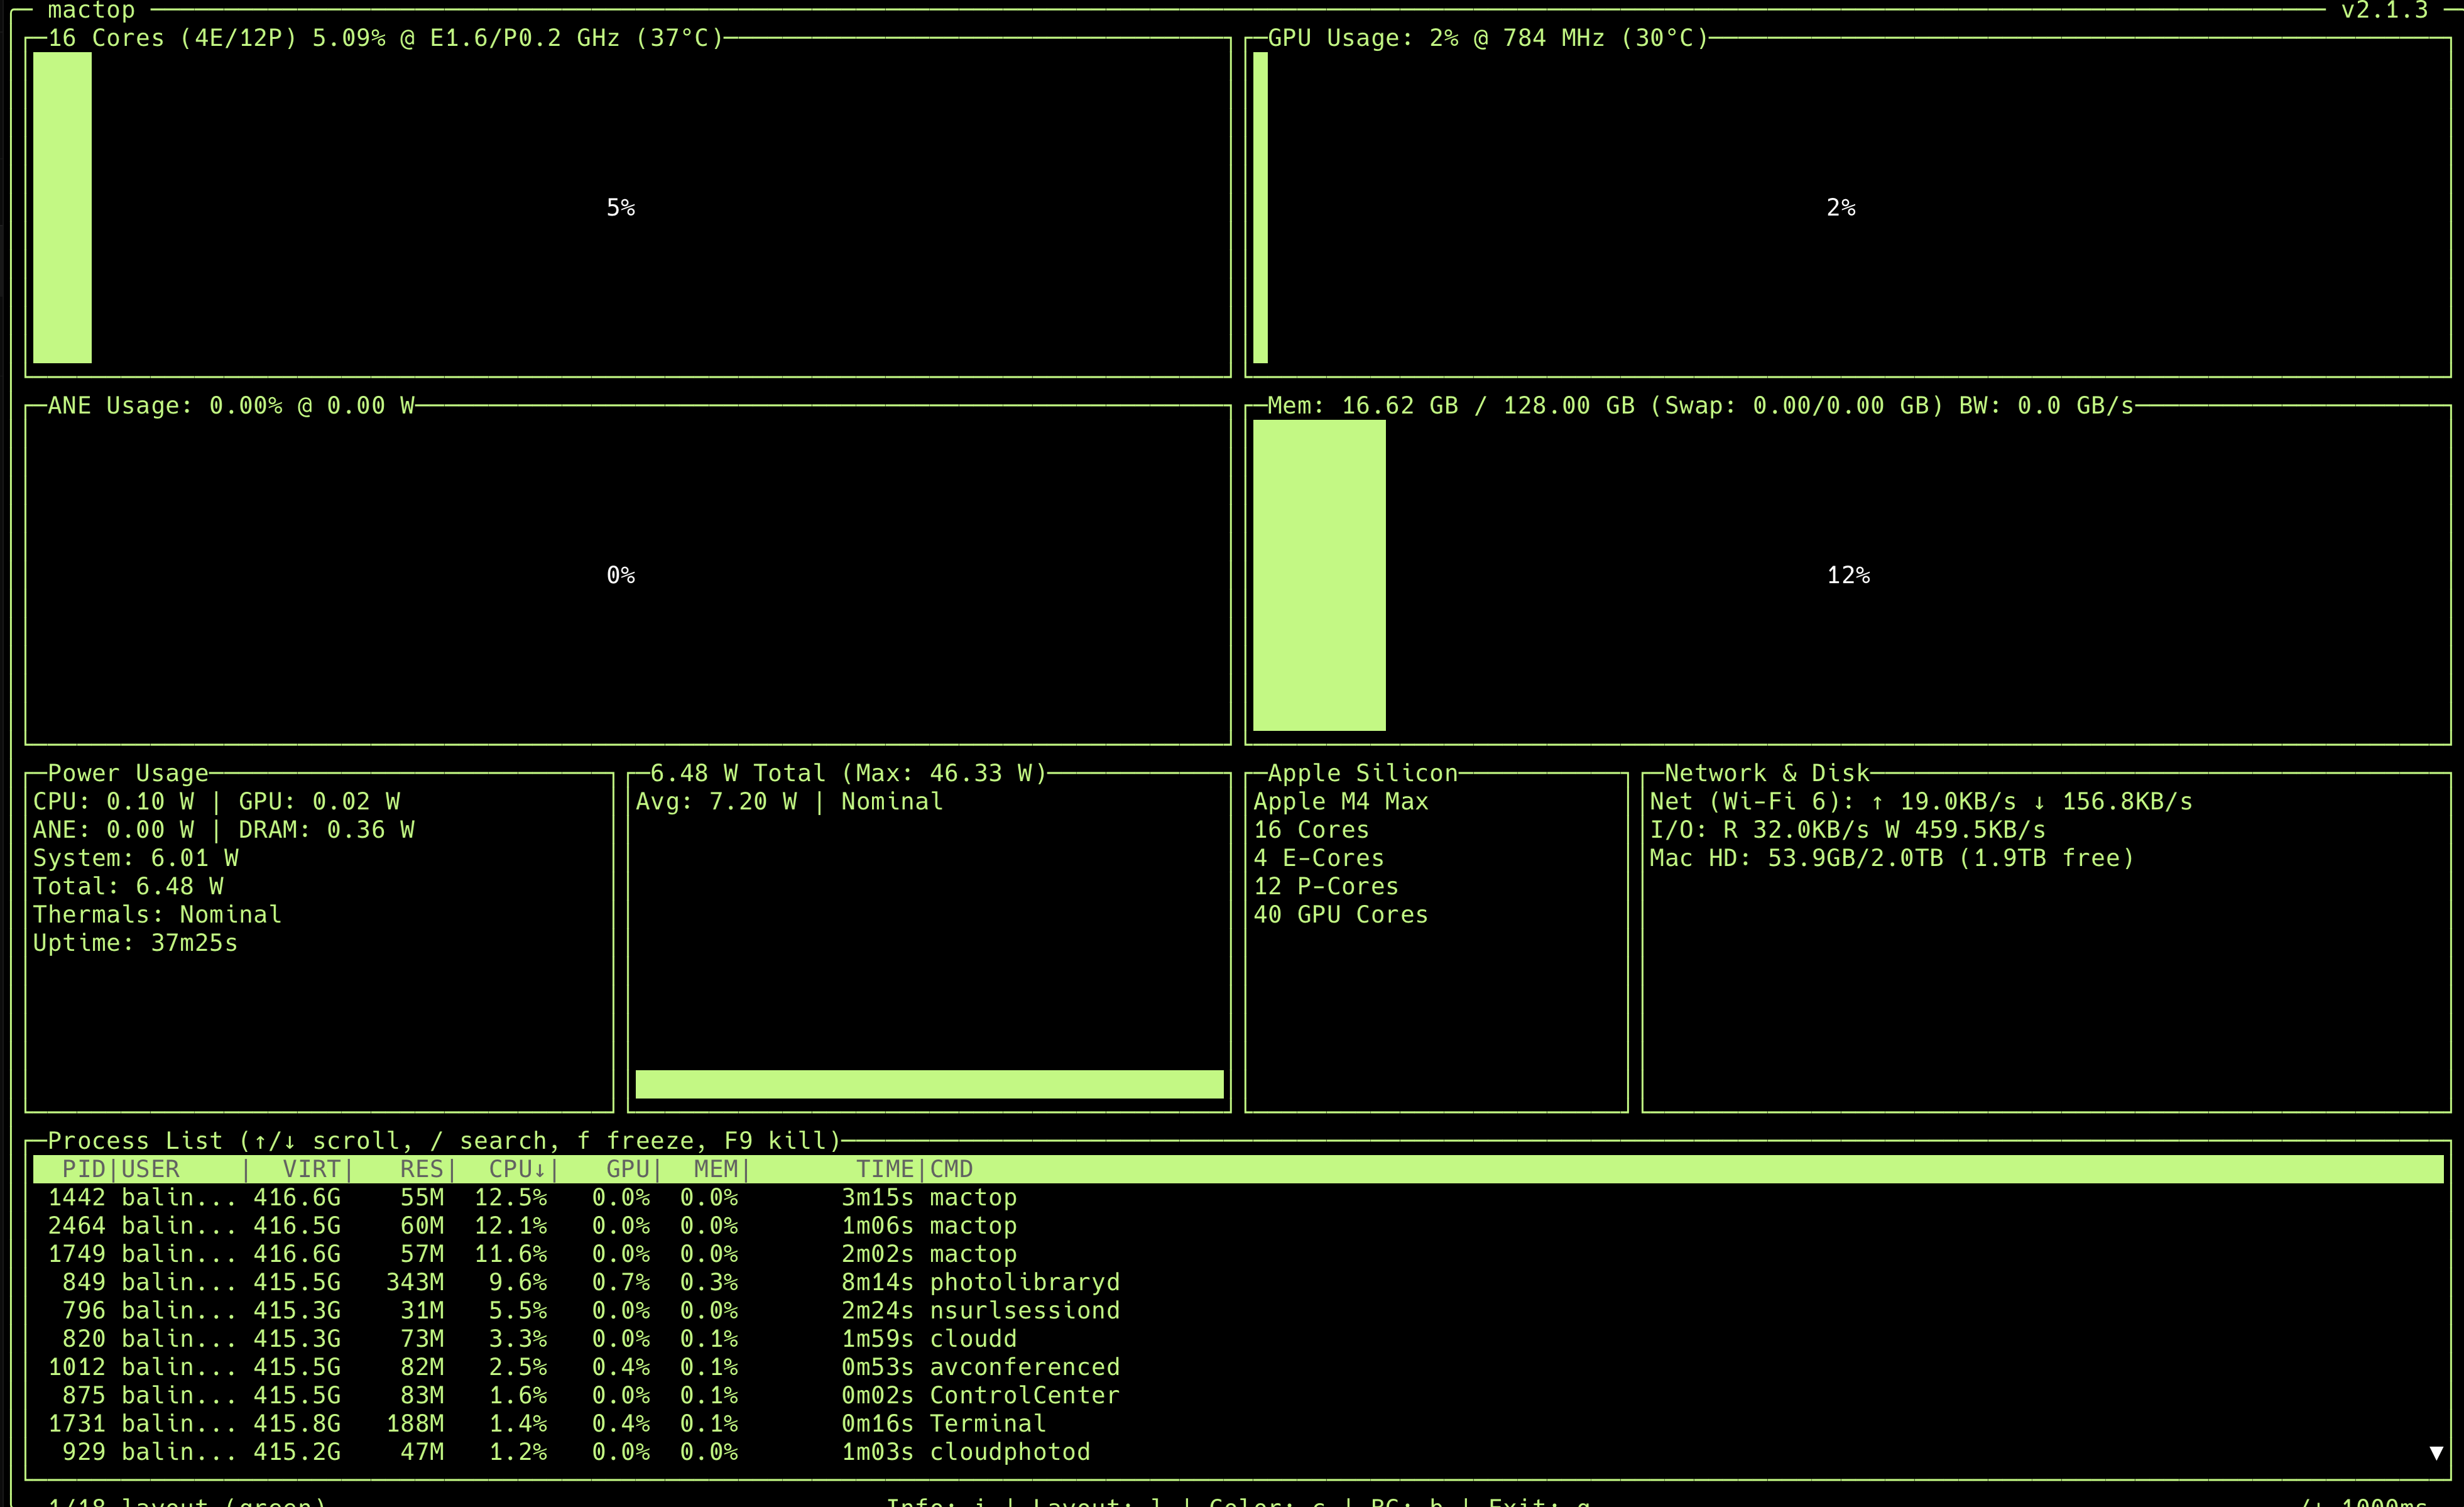
/img/mac-studio-mactop-firstboot.png 稍后再更换。该屏幕截图中的数字是我将在本文中引用的唯一硬数字。它们是我的机器在全新设置下闲置时的基本事实:
- Apple Silicon: M4 Max
- CPU: 总共16个核心——4个效率核心+12个性能核心; E 簇频率为 1.6 GHz,P 簇频率为 0.2 GHz; 37℃封装
- GPU: 40 个内核,784 MHz,30 C
- 神经引擎(ANE): 16 核,空闲时功耗 0.00 W
- 统一内存: 总共 128.00 GB,空闲时使用 16.62 GB(约 13%)
- 力量: 总计 6.48 W - CPU 0.10 W、GPU 0.02 W、ANE 0 W、DRAM 0.36 W、系统 6.01 W。会话中观察到的最大功率为 46.33 W。散热:标称。
- 贮存: 2.0 TB Mac HD,1.9 TB 可用空间; 53.9 操作系统使用的 GB 和初始设置
- 网络: Wi-Fi 6,后台同步期间上传示例读数为 19.0 KB/s,下载示例读数为 156.8 KB/s
有两件事很突出。第一的, 闲置时 6.48 瓦 对于拥有 128 GB 可用内存的台式机来说,这是非常了不起的 - 这比许多笔记本电脑在屏幕关闭时消耗的内存还要少。其次,GPU 的频率为 784 MHz,有 40 个可用内核;只要您将 LLM 放在该池前面,该池就可以开始实际工作了。
3. 为什么Mac Studio M4 Max对于本地AI来说是惊人的
要理解为什么这种硬件非常适合本地人工智能,以及为什么“统一内存”不仅仅是一个营销口号,它有助于将其直接与规范的替代方案进行比较:PC 中的分立 GPU 卡,通过 PCIe 与系统 RAM 进行通信。

3.1 通俗语言统一记忆
在传统的 PC AI 设备上,有两个内存池。当您从磁盘加载操作系统、应用程序和模型权重时,系统 RAM(通常是 DDR5 的 64-256 GB)会保存它们。 GPU 有自己的 VRAM - RTX 4090 上有 24 个 GB,5090 上有 32 个 GB,A100 上有 80 个 GB。在 GPU 可以运行单个 matmul 之前,模型必须是 复制的 通过 PCIe 总线从系统 RAM 到 VRAM。如果模型大于 VRAM,则它要么根本不加载,要么通过 PCIe 以残酷的成本进行分页(通常比完全在 VRAM 中运行慢 10-100 倍)。
Apple Silicon 将这两个池合二为一。 CPU、GPU、神经引擎和媒体引擎都看到了 相同的物理内存。没有副本。不存在 PCIe 瓶颈。磁盘上有 40 个 GB 的型号,统一内存中就有 40 个 GB,GPU 可以直接读取。
对于本地 LLM,这是杀手级功能。量化为 Q4_K_M 的 70B 参数模型在磁盘上约为 40 GB(该量化级别的 Llama 级权重的公开引用数字 - 视为近似值)。在 24 GB 消费者 GPU 上,该模型根本不适合。在 128 个 GB 统一内存上,它加载了大约 80 个 GB,但仍可用于上下文、应用程序代码和工具。
3.2 令人难以置信的电源效率
mactop 屏幕截图显示空闲时功耗为 6.48 W,在会话期间观察到的最大值为 46.33 W。客观地说:单个 RTX 4090 空闲时的功率为 15-25 W,系统的其余部分位于顶部,在负载下最高可达 450 W。 Mac Studio 是一款桌面 AI 盒子,您可以 24/7 全天候运行,而不会在电费单上注意到它。它是沉默的。在推理工作负载期间,风扇几乎从不旋转。这就是它作为一个可行的 永远在线的开发盒 分立式 GPU PC 很少采用这种方式。
3.3 Apple 神经引擎的实际用途
ANE 是一款 16 核固定功能加速器,针对 CoreML 生成的张量运算类型进行了优化。对于 2026 年大多数开放权重 LLM 工作负载(通过 llama.cpp 或 Ollama 运行的 GGUF 格式),ANE 不在热路径中 - GPU 是通过 Metal Performance Shaders 实现的。 ANE 在 CoreML 转换模型、设备上语音识别、图像分割和类似的固定形状工作负载方面表现出色。当它运行时,它也非常节能。知道它的存在很有用;不要指望每个 LLM 堆栈都会使用它。
4. 设置 Mac Studio 进行 AI 工作
在标准 macOS 入门之后,以下是我所遵循的新 Mac Studio 的确切启动方式,我想将其用作本地 AI 开发盒。
4.1 安装 Homebrew、Xcode CLT 和基础知识
/bin/bash -c "$(curl -fsSL https://raw.githubusercontent.com/Homebrew/install/HEAD/install.sh)"

xcode-select --install

brew install git wget jq python@3.12 node pyenv
brew install --cask iterm2 visual-studio-code
Homebrew 带来了 Unix 工具,Xcode 命令行工具提供了编译器和链接器,Python 和 Node 为您提供了应用程序代码的运行时,而 iTerm2 + VS Code 是我默认使用的编辑器 + 终端对。
4.2 安装Ollama
Ollama 是在 macOS 上下载、运行和提供开放权重 LLM 的最简单方法。在它包裹的引擎盖下 llama.cpp 具有 Metal 加速功能,并在端口 11434 上提供简单的 HTTP API。
brew install ollama

ollama serve &

ollama --version
也可以通过官方安装 .dmg 来自 llama.com,它设置了一个菜单栏应用程序。任何一条路都有效。我更喜欢无头盒子的brew install 和日常驱动Mac 的dmg 安装。
4.3 安装LM Studio(可选但值得)
LM工作室 是一个用于浏览、下载和与 GGUF 模型聊天的桌面 UI。它还公开了兼容 OpenAI 的 API。我将它与 Ollama 一起安装,因为当您在 Q4_K_M 和 Q5_K_M 之间做出决定时,模型浏览器非常出色,并且每个模型的性能调整 UI 都很友好。
4.4 在VS Code中安装Continue.dev
Continue.dev 在 VS Code 中为您提供 ChatGPT 风格的帮助,但指向您本地的 Ollama。安装扩展程序后,将其放入您的 ~/.continue/config.json:
{
  "models": [
    {
      "title": "Llama 3.1 8B (local)",
      "provider": "ollama",
      "model": "llama3.1:8b",
      "apiBase": "http://localhost:11434"
    },
    {
      "title": "Qwen 2.5 Coder 14B (local)",
      "provider": "ollama",
      "model": "qwen2.5-coder:14b",
      "apiBase": "http://localhost:11434"
    }
  ],
  "tabAutocompleteModel": {
    "title": "Codestral (local)",
    "provider": "ollama",
    "model": "codestral:latest",
    "apiBase": "http://localhost:11434"
  }
}
现在,您可以进行内联聊天、编辑和自动完成 - 所有命中模型都与您的编辑位于同一张桌子上。零数据离开机器。
5. 运行您的第一个 LLM

关键时刻到了。拉取模型并运行它。
5.1 拉Llama 3.1 8B
ollama pull llama3.1:8b

ollama list

ollama run llama3.1:8b "Explain unified memory architecture to me in 3 sentences."
拉取下载 Q4_K_M GGUF(Q4_K_M 处的 Llama 3.1 8B 约为磁盘上的 4.7 GB - 公开引用的数字,视为近似值)。在像我这样的 Wi-Fi 6 连接上,下载需要几分钟;在有线千兆位上速度更快。落地后,第一个 ollama run 包括将一次性模型加载到统一内存中 - 您会注意到第一个令牌流之前有短暂的暂停 - 然后后续运行速度很快。
我故意不会在这里引用我自己的机器的每秒令牌数,因为我还没有使用配对方法运行受控基准测试套件。我要说的是,在此类硬件(具有 40 个 GPU 内核的 M4 Max)上,您应该期望 流畅的对话式流媒体 来自 Q4_K_M 的 8B 模型,具有明显的初始负载延迟和整个响应过程中的稳定输出。如果您在其他地方读过诸如“我在 Mac 上每秒获得 60 个令牌”之类的声明,请将它们视为大致指导;您的实际数字将随提示长度、上下文窗口、量化级别、模型架构以及其他正在运行的内容而变化。
5.2 选择量化 - Q4_K_M、Q5_K_M、Q8_0
量化会降低模型权重的精度,从而缩小磁盘和内存中的模型权重。权衡是质量。这是我在选择量化人员进行局部推理时使用的粗略心理模型:
| 定量 | 大约8B尺寸 | 质量与 FP16 | 何时使用 |
|---|---|---|---|
| Q4_K_M | ~4.7 GB | 非常好,小滴 | 默认。聊天和代码的最佳速度/质量平衡。 |
| Q5_K_M | ~5.7 GB | 更接近 FP16 | 当您需要更精确的触摸并有空闲内存时。 |
| Q8_0 | ~8.5 GB | 近乎无损 | 当您需要小型型号的最高质量和最低噪音时。 |
所有尺寸均为公开引用的 Llama 8B 级重量的近似值。相对顺序才是重要的。
5.3 32、64 和 128 GB 的适用范围
| 统一内存 | 现实舒适区 (Q4_K_M) | 伸展(小心) |
|---|---|---|
| 32 GB | 7B / 8B / 13B | 20-22B 在严格的背景下 |
| 64 GB | 13B / 20B / 34B | 40-50B 在紧张的环境中 |
| 第128章 | 34B / 70B / 专家混合变体 | 紧张环境下 100-120B |
“舒适区”意味着模型加载时有足够的空间来容纳宽敞的上下文窗口、KV 缓存和其他运行的应用程序。 “拉伸”意味着它可以加载,但您开始兼顾上下文长度和其他工作负载。在我的 128 GB 机器上,我可以在 Q4_K_M 上运行 70B,并且仍然有大约 80 GB 的空间用于 VS Code、Chrome 和几个 Python 进程 - 坦率地说,这是一种奢侈的感觉。
5.4 从 Node 和 Python 调用 Ollama
Ollama 在以下位置公开 HTTP API http://localhost:11434。一个小的 Node fetch 看起来像这样:
// node 20+
const res = await fetch("http://localhost:11434/api/generate", {
  method: "POST",
  headers: { "Content-Type": "application/json" },
  body: JSON.stringify({
    model: "llama3.1:8b",
    prompt: "Write a one-paragraph summary of unified memory architecture.",
    stream: false
  })
});

const data = await res.json();
console.log(data.response);
来自Python:
import requests

r = requests.post(
    "http://localhost:11434/api/generate",
    json={
        "model": "llama3.1:8b",
        "prompt": "Explain HNSW indexes briefly.",
        "stream": False,
    },
    timeout=120,
)
print(r.json()["response"])
这是将本地 LLM 连接到 CLI 工具、Slack 机器人、快捷方式、微服务或内部自动化所需的一切。没有密钥,没有速率限制,没有配额。
6. 在 Mac Studio 上运行的最佳模型
选择模型部分是性能,部分是许可,部分是氛围。这是我在盒子上实际运行的内容,按大小层分组。
6.1 小型(10B 以下):快速的日常主力
- Llama 3.1 8B - 优秀的通用聊天和推理;带有警告的宽松元许可证。
- 米斯特拉尔 7B / 米斯特拉尔 8B - 强大的推理能力,Apache 许可的变体可用。
- 骐文2.5 7B - 非常强大的多语言和代码性能。
- Φ3.5迷你 - 体积小,功能惊人,是您需要吞吐量和低延迟时的理想选择。
- Codestral / Qwen 2.5 编码器 7B - IDE 工作的快速内联自动完成。
6.2 中频 (10B-40B):64-128 GB 的最佳位置
- Llama 3.1 / 3.3 70B (Q4_K_M) - 如果您有 128 GB,则这是头条型号;近乎前沿的品质,运行舒适。
- 骐文2.5 32B - 优良的质量尺寸比;与 RAG 完美搭配。
- DeepSeek-编码器 33B - 擅长代码生成任务。
- 混合 8x7B - 混合专家,一次仅激活2个专家,舒适贴合。
6.3 大型(70B 及以上):仅在 96-128 GB 上且仅在 Q4 上
128 GB 的大门向 Q4_K_M 的 70B 级模型敞开。他们是 慢点 与 8B 模型相比,但对于受益于更广泛的世界知识和更长的推理的任务来说,质量的飞跃是显着的。预计第一个令牌延迟会更长,流传输速度会下降,但实际体验对于许多工作流程仍然可用。
7. 构建本地RAG管道
一旦您拥有本地 LLM,您可以用它做的最有用的事情就是将其指向您自己的文档。这是检索增强一代,也是 Mac Studio 作为云 API 的私有替代方案真正发挥作用的工作负载。

7.1 堆栈
- 文档解析器 - 用于 PDF 的 PyMuPDF,
unstructured用于混合格式摄取。 - 分块器 - 浪链的
RecursiveCharacterTextSplitter或令牌感知分离器。典型的块大小为 512-1024 个令牌,其中有 64-128 个重叠令牌。 - 嵌入 -
nomic-embed-text或者mxbai-embed-large,均可通过 Ollama 获得。两者都在本地 GPU 上运行。 - 矢量商店 - 默认为 ChromaDB。 SQLite-VSS 用于零服务器选项。 LanceDB 如果您想要可扩展的单文件嵌入式选项。
- 发电机 - Llama 3.1 8B 可实现快速周转,如果您想要最高质量的答案,则可使用 70B。
7.2 最小的 Python 示例 - 端到端
pip install chromadb requests pypdf

import os, glob, requests, chromadb
from chromadb.utils import embedding_functions
from pypdf import PdfReader

OLLAMA = "http://localhost:11434"
EMBED_MODEL = "nomic-embed-text"
GEN_MODEL   = "llama3.1:8b"

def embed(text: str) -> list[float]:
    r = requests.post(f"{OLLAMA}/api/embeddings", json={
        "model": EMBED_MODEL, "prompt": text,
    }, timeout=60)
    return r.json()["embedding"]

def generate(prompt: str) -> str:
    r = requests.post(f"{OLLAMA}/api/generate", json={
        "model": GEN_MODEL, "prompt": prompt, "stream": False,
    }, timeout=300)
    return r.json()["response"]

def chunk(text: str, size: int = 1000, overlap: int = 150):
    out, i = [], 0
    while i < len(text):
        out.append(text[i:i+size])
        i += size - overlap
    return out

client = chromadb.PersistentClient(path="./rag-db")
col = client.get_or_create_collection("docs")

for path in glob.glob("./docs/**/*.pdf", recursive=True):
    reader = PdfReader(path)
    full = "\n".join(p.extract_text() or "" for p in reader.pages)
    for j, c in enumerate(chunk(full)):
        col.add(
            ids=[f"{os.path.basename(path)}::{j}"],
            documents=[c],
            embeddings=[embed(c)],
            metadatas=[{"source": path, "chunk": j}],
        )

def ask(q: str, k: int = 5) -> str:
    qe = embed(q)
    res = col.query(query_embeddings=[qe], n_results=k)
    ctx = "\n\n".join(res["documents"][0])
    prompt = (
        "Answer the question using only the context below. "
        "If the answer is not in the context, say you do not know.\n\n"
        f"Context:\n{ctx}\n\nQuestion: {q}\nAnswer:"
    )
    return generate(prompt)

print(ask("What is unified memory and why does it matter for LLMs?"))
这是一个完整的本地 RAG 管道,用不到 60 行 Python 代码。整个过程都在 Mac Studio 上运行。没有外部 API 密钥,没有按令牌计费,没有数据离开机器。第一次摄取大型 PDF 集将需要几分钟;后续查询很快。
7.3 调优注意事项
- 块大小 - 从 1000 个字符开始,并有 150 个重叠;如果您的来源有很长的结构化部分(法律、技术规范)并且检索器正在分割答案,请提高。
- 前k - 4-8是实用范围。走得更高会夸大提示并减慢生成速度,而没有明显的收益。
- 重新排名 - 为了获得最高质量,检索前 20 名并使用交叉编码器重新排名(例如
bge-reranker)。在 Mac Studio 上这很便宜。 - 元数据过滤 - 用源路径、日期和部分标记块;在向量搜索之前的查询时进行过滤。这是最大的一次精度胜利。
- 流媒体 - 转变
stream到true在 Ollama 调用中并将令牌流式传输到客户端以实现快速的用户体验。
8. 日常开发循环
使用 Mac Studio 几周后,我的日常循环如下所示:
- 打开VS Code,Continue.dev针对Ollama进行唤醒。
- 在 Open WebUI(或 LM Studio)中打开聊天,针对我的笔记进行更长的对话问答。
- 对于代码工作:Codestral 或 Qwen Coder 模型上的选项卡自动完成、Llama 3.1 8B 上的较长聊天、70B 上的深度推理会话(当任务需要时)。
- 对于内部 RAG,一个指向项目的 docs/ 文件夹和 Chroma 数据库的 Python 脚本。
- 对于代理原型设计,LangGraph 或调用 Ollama 端点的小型自定义循环 - 相同的模式,不同的粘合。
当您的 LLM 位于本地时,真正改变的是您使用它的方式。查询不会增加成本,因此您可以向模型提出更多问题。无需担心隐私问题,因此您可以粘贴生产日志、内部文档、客户电子邮件。您编写小型 CLI 脚本来遍历 200 个文档以提取结构化摘要,并且您不会再考虑每个代币的账单,因为没有账单。
9. 与云的基准和诚实比较
让我非常直接地说:我不会发布我没有通过严格控制的基准测试方法得出的每秒令牌数。互联网上充斥着这样的数字,经常比较不同的量化级别、上下文长度和提示格式,它们令人困惑的程度多于澄清的程度。我要做的是发布一个决策矩阵来捕获 Mac Studio 实际胜出的工作负载类型,其中没有,并且正确答案是“同时使用”。

9.1 盈亏平衡数学
配备 128 个 GB 统一内存和 2 TB SSD 的 Mac Studio M4 Max 的价格范围与始终在线的云 GPU 实例几个月的价格大致相同。将所有具体的美元数字视为近似值并作为区域和折扣的函数:
- 一台 Mac Studio M4 Max,配置良好:一次性大约 4,000-6,000 美元(近似值;配置各不相同)。
- 一台AWS
g5.xlarge(单 A10G、24 GB VRAM)全天候 24x7 按需运行:每月 700-900 美元左右(取决于地区)。 - 一台AWS
p4d.24xlarge(8x A100):如果您以某种方式将其打开(您不会,但它使对比变得明显),则每月按需订购 20,000-30,000 美元。
算术表明,对于始终在线的开发盒,与同类始终在线的云实例相比,Mac Studio 在几个月内就能收回成本,并且可以在数年内继续以电费方式收回成本。对于突发训练工作,数学则相反:租一小时,跑一跑,然后归还。使用适合工作的正确工具。
9.2 当云是正确答案时
- 您需要训练或微调一个比 128 GB 更大的模型。
- 您需要以严格的 SLO 和弹性容量为全球用户群提供大规模服务。
- 您正在运行一个受益于 8x A100 或 H100 并行性的实验。
- 您的组织的合规性状况表明推理必须在具有特定审计跟踪的特定云区域中运行。
9.3 当 Mac Studio 是正确答案时
- 您希望为您的团队提供一个始终在线的私人推理机。
- 您正在构建 RAG、代理或 IDE 副驾驶,其中数据驻留和隐私很重要。
- 您需要一个安静、低功耗、不需要服务器机房的开发盒。
- 您正在快速进行原型设计,但云 API 的按令牌计费方式阻碍了您。
- 您想学习堆栈 - 拥有一个模型,拥有一个运行时,拥有一个向量存储,拥有循环。
10. 挑战和限制
如果我不指出其中的粗糙之处,我就不会为这篇文章带来任何好处。 Apple Silicon 非常适合本地 AI,但也有一些真正的警告。
10.1 训练仍然比推理弱
Apple Silicon AI 的故事对于 推理 比 训练。 PyTorch 的 MPS 后端已经显着成熟,Apple 自己的 MLX 框架也确实不错,但纯 CUDA 训练工具的广度仍然更广泛。如果您的日常工作是新颖的模型架构或大规模微调,您将会遇到在 Linux + NVIDIA 上根本不会遇到的漏洞。
10.2 生态系统在很多地方都采用 CUDA
许多 AI 存储库仍然默认采用 CUDA 假设。大多数维护的项目现在都有 Metal / MPS 路径,但预计偶尔会出现摩擦:需要从源代码构建的库、没有 Metal 等效项的内核、仅在 NVIDIA 上运行的基准套件。为此计划时间。
10.3 横向扩展是 DIY
一台 Mac Studio 是一个盒子。类似的工具 EXO 还有一些可以让你对 Mac 进行集群,以便在多个设备上运行非常大的模型,但这并不是你使用 g5 的 Kubernetes 集群得到的完美故事。如果您的工作负载需要水平弹性,那么云仍然更好。
10.4 可修复性和升级
您以后无法添加 RAM。您以后无法更换 SSD(实际上)。买你需要的东西,然后再加一件——尤其是内存。 128 GB 层是我推荐用于严肃的 AI 工作的层; 64 GB 是地板。
10.5 持续负载下的热量
Mac Studio 在空闲时运行凉爽且安静(上面的屏幕截图显示 37°C 和 30°C,风扇听不到)。在持续的重 LLM 负载下,风扇确实会旋转 - 声音不大,但听得见 - 并且芯片变热。这完全在标称热范围内;请注意,“静音”是空闲和轻负载的表征,而不是绝对的。
11. Apple Silicon 本地人工智能的未来
三种趋势正在融合,使 Apple Silicon 上的本地人工智能在未来 12-24 个月变得令人兴奋。
第一的, 开放权重模型在不损失能力的情况下不断变小。 Phi-3.5、Qwen 2.5 Small 和 8B 的 Llama 3.x 系列均超出其重量级别。在许多任务中,2026 8B 型号的质量与 2023 70B 大致相当。这意味着更多的工作负载可以轻松容纳在 32-64 GB 统一内存中,而 128 GB Mac Studio 则成为多型号服务盒。
第二, 苹果自家的MLX框架不断完善。 MLX 提供类似 NumPy 的 API、惰性求值、默认的统一内存感知以及动态计算图。 MLX 社区一直在快速移植模型、分词器和训练循环。如果您今天要在 Mac 上启动一个新的 ML 项目,MLX 是自然的选择;如果您使用 PyTorch,则每个版本的 MPS 后端都更可用。
第三, 量化和 KV 缓存压缩不断变得更好。 Q4_K_M、IQ 系列量化和 GGUF 改进等技术意味着相同的模型比六个月前适合的内存更少,质量损失也更少。本地人工智能正处于一条曲线上,每一代模型+量化配对都扩展了消费级硬件的实际覆盖范围。
再加上围绕未来 M 系列芯片(M5、未来的 Ultras、Studio 更新)的谣言,轨迹很明确: 桌边AI盒子来了,而且还在不断完善.
12. 将 Mac Studio 强化为团队 AI 盒子
如果您想与一个小团队共享您的 Mac Studio - 例如,向少数同事公开 Ollama、一个 Open WebUI 实例和一个 RAG 端点 - 以下是我所做的粗略强化:
- 文件保险箱开启 和一个强登录密码。将其保存在 UPS 上。
- 尾鳞 位于盒子上,以便您团队的设备可以访问它,而无需将其暴露在公共互联网上。
- 将 Ollama 绑定到本地主机 并在其前面添加一个瘦身份验证代理(Caddy、Traefik 或小型 Node/Python 服务器),该代理在转发到之前处理身份验证和速率限制
11434. - 在 Docker Desktop 中运行 Open WebUI 具有持久的卷;将其指向本地 Ollama 端点。
- 备份 将 RAG 数据库存储到加密的外部 SSD 或 Time Machine 目标。
- 自动更新 按计划安装 macOS 和 Homebrew 软件包;有意固定 Ollama 和型号版本,而不是自动拉最新版本。
如果做得好,您将拥有一个私有的、易于审计的 AI 端点,您的团队每天都会使用该端点,并且永远不会从建筑物的网络中发送令牌。
13. 结论:办公桌上的一场悄然革命
在 2026 年拆箱 Mac Studio M4 Max 感觉不像购买台式机,而更像购买小型 AI 设备,而碰巧也是 Mac。 128 个 GB 统一内存、40 个 GPU 核心、16 个 CPU 核心、一个神经引擎、硬件媒体编码器、一个 2 TB SSD 以及以单瓦测量的空闲功耗 - 所有这些都集中在一个盒子中,您可以用一只手拿起。
设置速度很快,第一个 LLM 在一个小时内运行,一个下午之内,您就拥有了一个私人 RAG 管道,可以回答您自己文档中的问题。整个事情都发生在您的办公桌上,后台没有任何云账单滴答作响。这会改变你使用人工智能进行构建的方式,而在你尝试之前很难传达这种方式。
如果您正在评估 Mac Studio 是否属于您团队的硬件组合,我希望本文为您提供了一个脚踏实地的观点:什么是令人惊叹的,什么是粗糙的,云仍然获胜的地方,以及您办公桌上的盒子是更好的答案。同伴 短博客 将相同的工作流程提炼成 5 分钟的阅读内容以供分享。
如果这有用的话 - 在 YouTube 上观看拆箱(https://youtube.com/shorts/HUlUoHNsyNM),订阅后续教程的频道(MLX 微调、多 Mac 推理、代理堆栈),并在此处查看该系列的下一篇文章。 Apple Silicon 上的本地 AI 才刚刚开始,随着堆栈的成熟,我将继续写作。
本文的 SEO 快照
- 搜索引擎优化标题: 拆箱 Mac Studio M4:在本地运行您的第一个 LLM
- 元描述: 打开带有 128 个 GB 统一内存的 Mac Studio M4 Max,安装 Ollama,在本地运行 Llama 3,并构建私有 RAG 管道。真实的阅读,诚实的比较。
- 主要关键词: Mac Studio AI、Mac Studio LLM、在 Mac Studio、Ollama Mac Studio、Apple Silicon AI 上运行 LLM、本地 AI 设置、Mac Studio RAG、本地 LLM 教程、本地运行 Llama、Mac Studio M4 审查。
- Twitter / X(280 个字符以下): 拆箱 Mac Studio M4 Max。 128个GB统一内存。空闲6.48 W。通过Ollama拉动Llama 3.1 8B,一个下午搭建了本地RAG管道,没有云账单。完整的 4000 字演练 + 6 个图表 + YouTube 短片。 #AppleSilicon #LocalLLM
- 领英帖子: 新的 Mac Studio M4 Max 出现在我的办公桌上,我把它当作一个 AI 设备:从 mactop(6.48 W 空闲、128 GB UMA、40 GPU 核心)的真实读数、Ollama 安装、本地运行的 Llama 3.1 8B、针对我自己的文档的完整 RAG 管道 - 所有这些都在一个下午完成。我写下了整个工作流程,其中包括六个原始图表、一个诚实的云与本地决策矩阵,以及关于云仍然获胜的部分。如果您正在为您的团队评估本地人工智能,那么这是一个脚踏实地的起点。