Descobrindo gargalos da LLM: observabilidade, OTEL e controle de custos
Resumo de negócios: OpenTelemetry, Prometheus/Grafana, Langfuse — prós, contras, custos e métricas de uso que reduzem os gastos dos agentes
 Balinder Walia4 de setembro de 20264 min read
Workstationresumo de negócios: descubra gargalos de agentes e LLM com observabilidade — plataformas OpenTelemetry, Prometheus/Grafana/Thanos e LLM, como Langfuse — para que você possa reduzir custos, reforçar SLOs e enviar agentes com evidências. Aprofundamento: artigo técnico longo do(OTEL, FinOps, orçamentos de agentes). Relacionado:Turbocharging LLMs·Enterprise AI Lab.
Por que gargalos se escondem sem telemetria
Prompts, ferramentas, recuperação e novas tentativas da cadeia de agentesLLM. Latência e gastos compostos entre saltos. Sem intervalos e métricas, você não pode dizer se o gargalo é o modelo, o armazenamento de vetores, uma ferramenta instável ou um loop de autodepuração ilimitado. As partes interessadas das empresas então compram cotas GPU ou API em excesso, enquanto a qualidade do produto permanece estável.
A postura doWorkstation para propriedades de IA: trate os pipelines de agente como qualquer outro serviço de produção - primeiro a observabilidade do, depois otimize a veiculação (consultePagedAttention / vLLM) e, em seguida, promova com disciplina (Ring Promoter).
A pilha de observabilidade que se paga
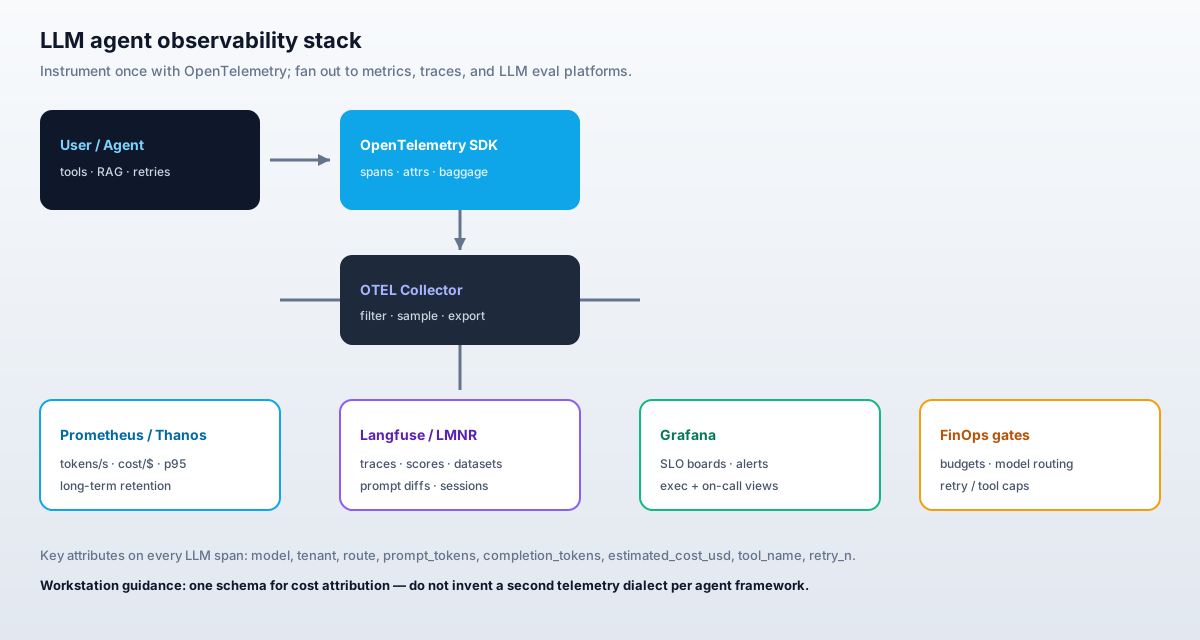
- OpenTelemetry (OTEL)— uma camada de instrumentação para rastreamentos, métricas e (quando útil) logs. Exportar para um coletor; espalhe para back-ends.
- Prometheus + Grafana (+ Thanos)— sinais dourados: taxa de solicitação, taxa de erro, latência, taxa de transferência de token, $/solicitação estimada, utilização de GPU. Thanos (ou equivalente) mantém métricas de longo prazo para análises de FinOps.
- LLM plataformas de observabilidade(por exemploLangfuse,LMNR) — UI de sessão/rastreamento, versões de prompt, interface humana e de rastreamento. pontuações automatizadas, conjuntos de dados para regressão.
Prós e contras desta abordagem
| Prós | Contras / compensações | |
|---|---|---|
| Controle de custos | Atribuir gastos ao inquilino, recurso, modelo e etapa do agente; elimine tentativas inúteis. | Tempo de engenharia para instrumentar; custo de armazenamento para rastreamentos se a retenção for ingênua. |
| Qualidade | As pontuações + conjuntos de dadoscapturam regressões imediatas antes dos clientes. | A pontuação automatizadapode ser barulhenta; os humanos ainda são necessários para caminhos críticos. |
| Operações | O mesmo conjunto de habilidades OTEL/Prometheus de seus outros microsserviços. | UIs específicas doLLM (Langfuse etc.) adicionam outro produto para executar ou comprar. |
| Conformidade | Auditoriaquem chamou qual modelo com qual versão de prompt. | As políticas de retenção de Prompt/PIIdevem ser projetadas antecipadamente. |
| Velocidade para valor | Primeiros painéis em dias se você já executa o Grafana. | A atribuição de custo total em gráficos multiagentes leva mais tempo. |
: o que você gasta versus o que você economiza
Custo de instrumentação (plataforma típica de agente de médio porte):
- 1–2 semanas de engenharia para adotar as convenções de extensão OTEL + fiação do exportador. Coletor
- + retenção de métricas: geralmente <5–10% do gasto mensal do LLM API/GPU depois que a amostragem é ajustada.
- Observabilidade SaaS LLM opcional: preço por evento/rastreamento — faça um orçamento como uma porcentagem do gasto do modelo, não como uma reflexão tardia.
Alavancas de economia (métricas de uso que movem a agulha):
- Tokens por tarefa bem-sucedida— não tokens por chamada bruta. Loops de ferramentas de limite e rodadas de autodepuração.
- Custo por tarefa bem-sucedida— modelos baratos de rota para classificação/rota; reserve modelos de fronteira para etapas difíceis.
- Taxa de acertos do cache— cache de prompt/prefixo quando seguro; medir a correção, não apenas a latência.
- Taxa de repetição e taxa de repetição taxa de mensagens mortas– ferramentas instáveis mascaradas como problemas de “qualidade do modelo”.
- p95 TTFT e latência ponta a ponta— proteja a UX enquanto você reduz gastos.
: manual vs automático
| Quando usar | Nota comercial||
|---|---|---|
| Pontuação manual | ConjuntosGold, respostas regulamentadas, cópia sensível à marca. | Caro, mas com base em juízes automatizados. |
| Pontuação automática | Regressão de alto volume, LLM como juiz, verificações de rubricas. | Barato em escala; calibrar contra humanos mensalmente. |
(comece aos poucos)
- Instrumento
- um caminho de agente de produçãode ponta a ponta com atributos OTEL + token/custo.
- Envie uma placa Grafana para taxa/erros/latência/$/sucesso.
- Adicione Langfuse (ou equivalente) para versões de prompt e pontuações nesse caminho.
- Aplicar limites máximos: máximo de tokens, máximo de chamadas de ferramenta, máximo de tentativas por sessão.
- Expanda para o próximo agente somente depois que o primeiro caminho mostrar um custo medido ou ganho de latência.
: por que a observabilidade é importante para sistemas de IA
Palestra contextual sobre cultura de observabilidade – não uma demonstração do produto Workstation. Emparelhe com os documentosOpenTelemetrye o artigo técnicoWorkstation.
Leia a seguir
- Artigo longo— Esquema de span OTEL, coletores, fórmulas de custo, limites de agente, notas Langfuse/LMNR.
- Turbocharging LLMs– gargalos no lado da porção depois que você pode vê-los.
- Agentes locais·Enterprise AI Lab·Contato Workstation
Publicado porWorkstation. Referências:langfuse/langfuse·lmnr-ai/lmnr·OpenTelemetry.