Turbocompressão LLMs
PagedAttention, vLLM, Self-Debugging, PowerInfer e EG-MLA — como escalar agentes LLM sem desperdiçar cache KV GPU
 Balinder Walia30 de agosto de 20264 min read
Workstationsobre como turbinar modelos de linguagem grande em produção: PagedAttention, vLLM, Self-Debugging, PowerInfer e EG-MLA — com as compensações que realmente aparecem nos GPUs. Aprofundamento: artigo longo do. Cartilha:LLMs explicado + Kubernetes.
: o que realmente é um LLM
Contexto, não uma demonstração de produto:Introdução aos modelos de linguagem grande(Andrej Karpathy). Emparelhe com nosso guiaem inglês simples LLM + Kubernetes.
O problema de escala
LLMs desbloqueou IA e geração de conversação e imediatamente se tornou um problema de atendimento. Cada etapa de decodificação anexa chaves e valores a um cache KV que cresce com o comprimento da sequência e o tamanho do lote. Os motores ingênuos pré-reservam enormes lajes contíguas. A maior parte dessa memória fica ociosa enquanto outras solicitações aguardam. A produtividade cai mesmo que a GPU pareça “cheia”.
PagedAttention: memória virtual para atenção
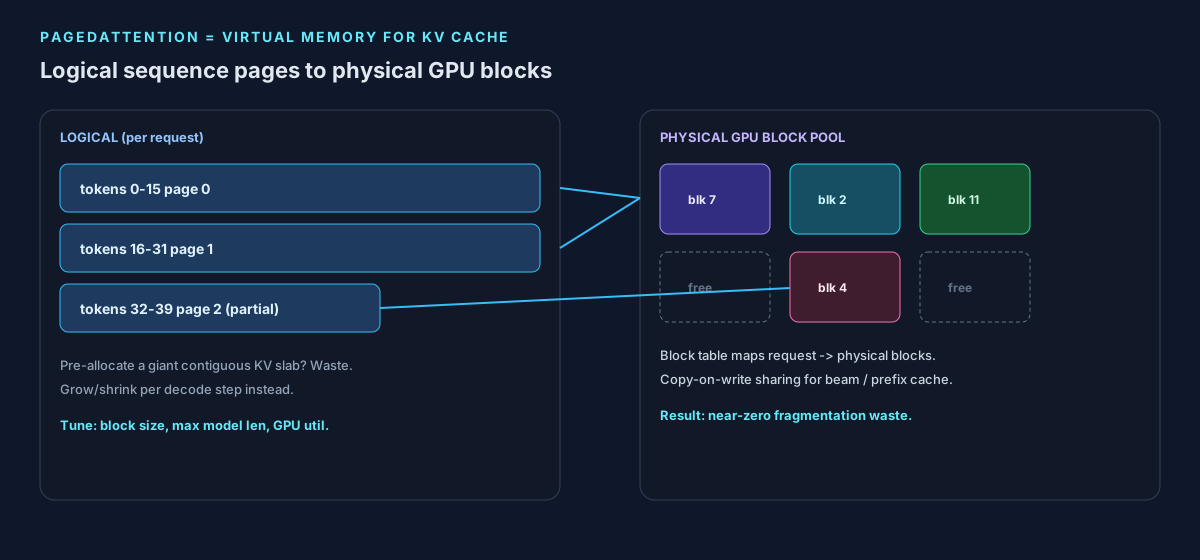
PagedAttention (Kwon et al., SOSP 2023) trata o cache KV como paginação do sistema operacional: blocos de tamanho fixo, uma tabela de blocos por solicitação, páginas físicas não contíguas[arXiv:2309.06180]. O kernel reúne blocos no momento da atenção. Você ainda deve ajustar o tamanho do bloco, o comprimento máximo do modeloe a hierarquia de cache(GPU HBM vs CPU offload vs prefix cache). Blocos muito pequenos adicionam sobrecarga de mapeamento; blocos muito grandes reintroduzem resíduos.
vLLM: desperdício quase zero servindo
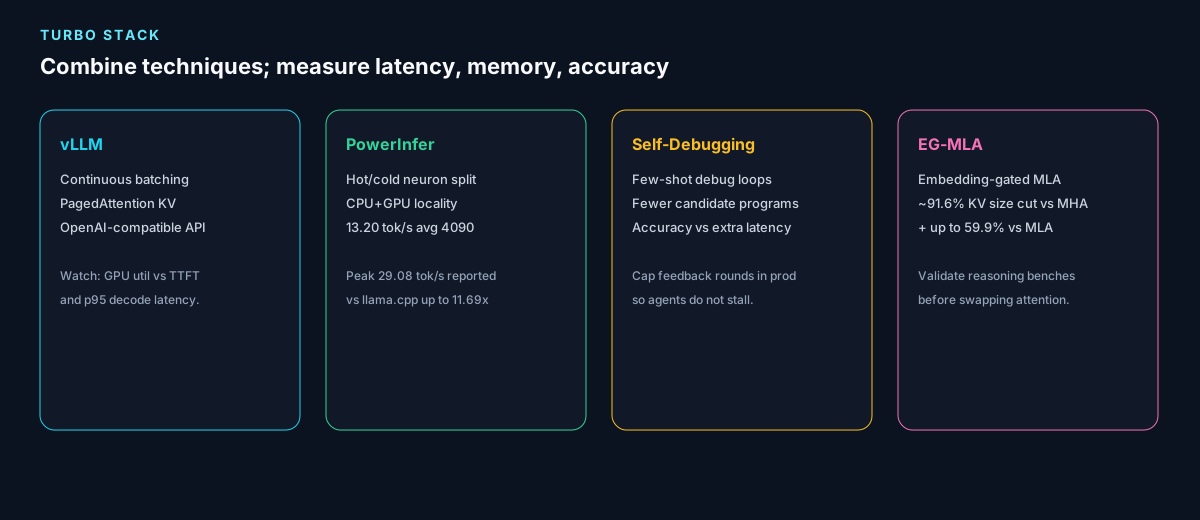
vLLM é o sistema de serviço construído em torno do PagedAttention. Ele visa desperdício de KV próximo de zero, lotes contínuos e uma superfície HTTP compatível com OpenAI. Na produção, observe três coisas: (1)gpu_memory_utilizationvs OOM, (2) tempo para o primeiro token vs decodificar tokens/s, (3) se o cache de prefixo/prompt altera as respostas para seu conjunto de avaliação. O cache é uma vitória no rendimento; não está isento de correção e efeitos de latência final.
from vllm import LLM, SamplingParams

llm = LLM(model="meta-llama/Llama-3.1-8B-Instruct", gpu_memory_utilization=0.90)
params = SamplingParams(temperature=0.2, max_tokens=256)
outs = llm.generate(["Explain PagedAttention in one paragraph."], params)
print(outs[0].outputs[0].text)
Esse é o uso real do vLLM. Uma chamada Hugging Face BERTforward()ée nãoPagedAttention - não confunda logits do classificador com serviço KV paginado.
Self-Debugging: loops de qualidade com orçamento de latência
Self-Debugging (Chen et al.) ensina um modelo para corrigir seus próprios programas previstos a partir de traços de poucos disparos, combinando ou superando linhas de base que emitem 10x mais candidatos[arXiv:2304.05128]. Para os agentes, isso é ouro – até que as rodadas de feedback se acumulem. Limite o número de mensagens de depuração, registre cada rodada e feche a falha para um modelo humano ou especialista menor quando o orçamento acabar.
Watch: contexto de serviço e inferência
Palestra contextual sobre veiculação rápida do LLM – não uma demonstração oficial do Workstation. Emparelhe com o papel vLLM edocs.vllm.ai.
PowerInfer: tokens em um único GPU
gordoPowerInfer divide neurônios quentes/frios para que um consumidor GPU mais CPU possa gerar tokens rapidamente. Números relatados:13,20 tokens/s média, pico29,08 tokens/sem um NVIDIA RTX 4090, até11,69xvs llama.cpp, mantendo a precisão[PowerInfer]. Na escala da frota, você ainda precisa de posicionamento: quais camadas permanecem no GPU, como você fragmenta os nós e se o perfil de localidade doe dos prompts docorresponde aos modelos do papel.
EG-MLA: reduza o KV sem destruir a bancada
EG-MLA (atenção latente de múltiplas cabeças com controle de incorporação) relataacima de 91,6% de redução de cache KVvs atenção de múltiplas cabeças com degradação insignificante, economia extra vs MLA (até 59,9%) e melhores pontuações em conjuntos de raciocínio, dimensionados além dos parâmetros 1B[papel EG-MLA]. Trate-o como uma escolha de arquitetura, não como um sinalizador em um ponto de verificação vLLM congelado – valide seu equipamento de avaliação antes de celebrar o gráfico de memória.
Juntando tudo
Combine PagedAttention + vLLM para atendimento de cluster, PowerInfer quando a caixa for uma estação de trabalho GPU, Self-Debugging dentro de agentes de codificação com um limite de arredondamento rígido e EG-MLA quando você controla a família de modelos. A veiculação distribuída adiciona complexidade: paralelismo KV, divisão de pré-preenchimento/decodificação e escalonamento automático que não sobrecarrega as tabelas de páginas. Medir. Em seguida, escreva o ADR.
Leia a seguir
- Artigo longo- botões, modos de falha, notas Kubernetes.
- LLMs explicado + execute o seu próprio no Kubernetes
- Muse Glimmer / agentes locais·Enterprise AI Lab
Publicado porWorkstation.