A loja já está aberta

Construímos máquinas Workstation AI para sites, agentes de IA e treino de LLM — configure e compre online.

Obter preços profissionais
Produtos de IA
Labs de IAAgentes OpenAIAgentes ClaudeGrok BotCRM nativo da Workstation AIMarketingTodos os produtos
Soluções de IA
IA aplicadaAgentes de IAIA generativaAutomatização com IAQualificação em IAPacotes de IA para PMELaboratório de IA empresarialEstações de trabalho de IAHardware e software NVIDIANVIDIA Accelerated ComputingIA privadaClusters de GPUIA de bordaIA por setor
Serviços de IA
Modernização de plataformasEngenharia digitalFundações de dados e IAOperações autónomasConsultoria de IAAutomação DevOpsCibersegurançaDesenvolvimento de softwareConstrução de agentesConfiguração MLOpsLocação de GPUs
Sobre nós
EmpresaA nossa históriaParceirosCasos de sucesso
Centros de dados de IA
Análises de IASérie JevLaboratório de benchmarksSeleção de modelos
Notas técnicas
Documentação
SO LinuxUbuntuRed Hat Enterprise LinuxSUSE LinuxAlpine LinuxDebian, Rocky & AlmaLinux
Plataformas de IA na nuvemAWS & Amazon BedrockGoogle Cloud & Vertex AIMicrosoft Azure & AI FoundryNuvens e marketplaces de GPU
Centros de dados de IA privadosPara escritórios de advocaciaPara escritórios de contabilidadePlataformas locaisNuvem totalmente protegida
FerramentasRing PromoterJobshout
Notícias
Blog
Fale conoscoEntrar

Estações de trabalho de IA, software multiagente de IA, infraestrutura de GPU e soluções de agentes inteligentes para empresas modernas.

Fale conosco

Soluções de IA

IA aplicadaAgentes de IAIA generativaAutomatização com IAQualificação em IAPacotes de IA para PMELaboratório de IA empresarialIA por setor

Produtos

Todos os produtosWorkstation AI native CRM e ERPMarketingAgentes OpenAIRing PromoterJobshout

Empresa

Sobre nósEmpresaCentros de dados de IAPor que WorkstationParceirosCasos de sucessoPreçosContatoTenthMatrix

Recursos

Análises de IANotas técnicasDocumentaçãoSO LinuxPlataformas de IA na nuvemCentros de dados de IA privadosBlogBuscarMapa do site
Escritório do Reino Unido
77-79 Marlowes, Hemel Hempstead HP1 1LFComo chegar: pegue a saída 20 da M25, Outer LondonN.º da empresa: 11641870Seg - Sex: 9:00 - 18:00 GMT
+44 7515 356 146
Escritório da Bélgica
Workstation SRL, Rue Vanderkindere 34, 1180 Uccle, BrusselsBE 0751.518.683Seg - Sex: 9:00 - 18:00 CET
+32 492 45 67 46
Escritório da Índia
#159 Sector 9, Pocket 1, DDA Flats, 110077 Dwarka, New Delhi
+91 98881 98841

© 2026 Workstation AI. Todos os direitos reservados.

PrivacidadeEliminação de dadosCookiesTermos de serviçoMapa do site

NVIDIA, the NVIDIA logo, RTX, RTX PRO, Blackwell, CUDA, NVLink, MGX, Omniverse, Spectrum-X, Quantum, BlueField, DGX and HGX are trademarks and/or registered trademarks of NVIDIA Corporation in the US and other countries. AMD, the AMD Arrow logo, EPYC, Instinct, Ryzen and Threadripper are trademarks of Advanced Micro Devices, Inc. Dell and PowerEdge are trademarks of Dell Inc. or its subsidiaries. Intel and Xeon are trademarks of Intel Corporation or its subsidiaries. AMAX, AceleMax and LiquidMax are trademarks of AMAX Engineering Corporation. All other product names, logos and brands are the property of their respective owners. We use them only to identify the products we describe, supply or support; their use does not mean their owners endorse us.

Loading blog...

Início / Blogs
OllamaOpen WeightsLocal AIApple SiliconAI AgentsLLMAIMcp

Muse Glimmer no Ollama: agentes locais sempre ativos em um GPU

Modelo de agente 30B Apache 2.0 da Meta – uso de ferramentas, visão, recuperação de falhas – e o que isso significa para IA privada em estações de trabalho

Balinder Walia12 de agosto de 20263 min read
Meta Muse Glimmer local agents on Ollama

MetaMuse Glimmeré um modelo aberto 30B ajustado para agentes locais sempre ativos - uso de ferramentas, tarefas longas, recuperação de falhas, visão - e é fornecido noOllamasob Apache 2.0 para um único GPU ou Apple Silicon. Aqui está a visão comercial do Workstation. Especificações, bancadas, metodologia e uma lista de verificação de produção no longo artigo.

Meta Muse Glimmer local agents on Ollama

Resultado final do.Cloud Frontier APIs ainda vencem em termos de polimento de pico e SLAs gerenciados. Muse Glimmer altera o padrãopara agentes privados e sempre ativos: um modelo 30B destilado com um codificador de percepção que se adapta ao hardware do consumidor/estação de trabalho (peso de aproximadamente 18 GB, contexto de 128 K), Apache 2.0 licenciado e conectado a Claude Code, OpenCode, Hermes Agent e OpenClaw viaollama launch. Privacidade, espaço aéreo e custo unitário previsível tornam-se características do produto – e não projetos de pesquisa.

O que foi enviado (em termos comerciais)

  • Agentes locais sempre ativos:projetado para continuar trabalhando em trabalhos de várias etapas sem precisar enviar cada token para um hiperescalador.
  • Disciplina da ferramenta: chamada de função com esquema precisoem fluxos de trabalho longos — a diferença entre um chatbot de demonstração e um agente que arquiva tickets, edita código ou consulta ferramentas MCP.
  • Recuperação de falha:quando uma ferramenta falha ou retorna absurdo, o modelo diagnostica e tenta novamente em vez de congelar a execução.
  • Multimodal: capturas de tela, gráficos e documentos doacompanham o texto – útil para consoles de operações, faturas e automação de UI.
  • Esforço controlável: o raciocínio de discagemaumenta a força para tickets difíceis e diminui para caminhos sensíveis à latência.
  • Licença:Apache 2.0 — uma história comercial mais limpa do que muitos cartões de “peso aberto” com recortes SaaS.
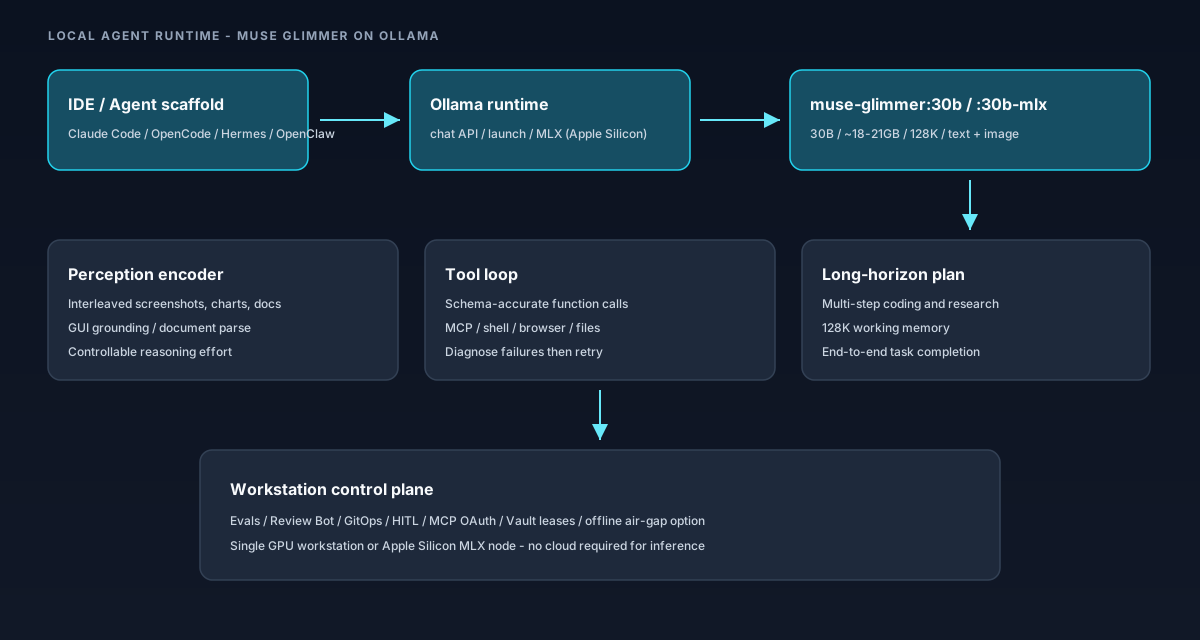
Muse Glimmer local agent stack from scaffold to Ollama

Por que placas e PMEs deveriam se preocupar com

  1. Residência de dados: PII do cliente, código-fonte e documentos financeiros podem permanecer na estação de trabalho ou VPC privado.
  2. Economia da unidade: o custo de inferência dotorna-se amortização de hardware + eletricidade, e não faturas por token que aumentam com loops de agente.
  3. Continuidade: locais de redeoff-line ou degradados (fábricas, clínicas, equipes de campo) mantêm os agentes em funcionamento.
  4. Clareza de aquisição: a distribuiçãoApache 2.0 + Ollama reduz o atrito legal e operacional em comparação com despejos de peso opacos.

Ondenãosubstitui a nuvem

Mantenha APIs fechados (ou MoEs abertos maiores em um cluster) para caminhos de pico crítico, geração sensível à marca e cargas de trabalho que precisam de SLAs de suporte do fornecedor. Muse Glimmer é o fortelocal / pista privadaem um roteador híbrido – não é uma obrigação para eliminar Bedrock ou Anthropic durante a noite. Combine-o com avaliações, HITL e os controles em nosso resumo de segurança do agente.

Conselho

Workstation

  • Lojas PME/Mac:começa comollama run muse-glimmer:30b-mlxem Apple Silicon (ou a etiqueta padrão de 18 GB em uma única estação de trabalho GPU média/alta).
  • Equipes de desenvolvimento
  • : andaimes de fiocomollama launch claude --model muse-glimmer(ou OpenCode / Hermes / OpenClaw) e meça suas tarefas de ouro - não apenas a tabela de classificação do Meta.
  • Enterprises: Pods de agente piloto air-gappedcom Review Bot + GitOps; mantenha um failover na nuvem para estouro.

Reescrita técnica completa - arquitetura, tags Ollama, matriz de benchmark vs Gemma4-31B / Qwen3.6-27B, metodologia de avaliação Meta e uma lista de verificação de produção: artigo longo. Publicado porWorkstation.