A loja já está aberta

Construímos máquinas Workstation AI para sites, agentes de IA e treino de LLM — configure e compre online.

Obter preços profissionais
Produtos de IA
Labs de IAAgentes OpenAIAgentes ClaudeGrok BotCRM nativo da Workstation AIMarketingTodos os produtos
Soluções de IA
IA aplicadaAgentes de IAIA generativaAutomatização com IAQualificação em IAPacotes de IA para PMELaboratório de IA empresarialEstações de trabalho de IAHardware e software NVIDIANVIDIA Accelerated ComputingIA privadaClusters de GPUIA de bordaIA por setor
Serviços de IA
Modernização de plataformasEngenharia digitalFundações de dados e IAOperações autónomasConsultoria de IAAutomação DevOpsCibersegurançaDesenvolvimento de softwareConstrução de agentesConfiguração MLOpsLocação de GPUs
Sobre nós
EmpresaA nossa históriaParceirosCasos de sucesso
Centros de dados de IA
Análises de IASérie JevLaboratório de benchmarksSeleção de modelos
Notas técnicas
Documentação
SO LinuxUbuntuRed Hat Enterprise LinuxSUSE LinuxAlpine LinuxDebian, Rocky & AlmaLinux
Plataformas de IA na nuvemAWS & Amazon BedrockGoogle Cloud & Vertex AIMicrosoft Azure & AI FoundryNuvens e marketplaces de GPU
Centros de dados de IA privadosPara escritórios de advocaciaPara escritórios de contabilidadePlataformas locaisNuvem totalmente protegida
FerramentasRing PromoterJobshout
Notícias
Blog
Fale conoscoEntrar

Estações de trabalho de IA, software multiagente de IA, infraestrutura de GPU e soluções de agentes inteligentes para empresas modernas.

Fale conosco

Soluções de IA

IA aplicadaAgentes de IAIA generativaAutomatização com IAQualificação em IAPacotes de IA para PMELaboratório de IA empresarialIA por setor

Produtos

Todos os produtosWorkstation AI native CRM e ERPMarketingAgentes OpenAIRing PromoterJobshout

Empresa

Sobre nósEmpresaCentros de dados de IAPor que WorkstationParceirosCasos de sucessoPreçosContatoTenthMatrix

Recursos

Análises de IANotas técnicasDocumentaçãoSO LinuxPlataformas de IA na nuvemCentros de dados de IA privadosBlogBuscarMapa do site
Escritório do Reino Unido
77-79 Marlowes, Hemel Hempstead HP1 1LFComo chegar: pegue a saída 20 da M25, Outer LondonN.º da empresa: 11641870Seg - Sex: 9:00 - 18:00 GMT
+44 7515 356 146
Escritório da Bélgica
Workstation SRL, Rue Vanderkindere 34, 1180 Uccle, BrusselsBE 0751.518.683Seg - Sex: 9:00 - 18:00 CET
+32 492 45 67 46
Escritório da Índia
#159 Sector 9, Pocket 1, DDA Flats, 110077 Dwarka, New Delhi
+91 98881 98841

© 2026 Workstation AI. Todos os direitos reservados.

PrivacidadeEliminação de dadosCookiesTermos de serviçoMapa do site

NVIDIA, the NVIDIA logo, RTX, RTX PRO, Blackwell, CUDA, NVLink, MGX, Omniverse, Spectrum-X, Quantum, BlueField, DGX and HGX are trademarks and/or registered trademarks of NVIDIA Corporation in the US and other countries. AMD, the AMD Arrow logo, EPYC, Instinct, Ryzen and Threadripper are trademarks of Advanced Micro Devices, Inc. Dell and PowerEdge are trademarks of Dell Inc. or its subsidiaries. Intel and Xeon are trademarks of Intel Corporation or its subsidiaries. AMAX, AceleMax and LiquidMax are trademarks of AMAX Engineering Corporation. All other product names, logos and brands are the property of their respective owners. We use them only to identify the products we describe, supply or support; their use does not mean their owners endorse us.

NVIDIA Partner · Reino Unido

Soluções NVIDIA Accelerated Computing

De uma única GPU para centro de dados a uma fábrica de IA à escala de rack com refrigeração líquida, a Workstation dimensiona, fornece, monta, instala e dá suporte a toda a gama de computação acelerada NVIDIA para organizações do Reino Unido.

Explorar a gamaFale com um engenheiro
  • 34Sistemas, GPUs, produtos de rede e software NVIDIA
  • 5etapas, do dimensionamento ao suporte a longo prazo
  • UKengenharia, montagem e testes de burn-in

Computação acelerada, sem o risco da integração

A computação acelerada transfere as partes mais pesadas de uma carga de trabalho, como treino de IA, inferência, simulação, análise de dados e rendering, de CPUs de uso geral para GPUs e processadores especializados. O resultado é mais trabalho feito por rack e por watt, e resultados em horas em vez de dias.

Chegar lá exige mais do que uma GPU. Cada acelerador precisa de um servidor capaz de o alimentar e arrefecer, de uma rede que o mantenha abastecido de dados e de software licenciado e com suporte. Como NVIDIA Partner com engenheiros próprios, reunimos essas peças num único sistema testado e continuamos ao seu lado depois da entrada em produção.

  • Aconselhamento independente sobre a plataforma NVIDIA que melhor se adapta às suas cargas de trabalho
  • Configurações completas e NVIDIA-Certified em vez de peças avulsas
  • Montados, com imagem instalada e testados em burn-in na nossa oficina no Reino Unido
  • Instalados, cablados e comissionados nas suas instalações
  • Um único contacto no Reino Unido para suporte, upgrades e garantia

O que compõe um sistema acelerado

Quatro camadas trabalham em conjunto. Especificamos as quatro para que nenhuma se torne o ponto de estrangulamento.

GPUs

Executam a matemática paralela por trás da IA, da simulação e dos gráficos. A capacidade e a largura de banda da memória costumam decidir de que GPU precisa.

CPUs e sistemas

Alimentam as GPUs, executam o sistema operativo e mantêm os dados em memória. O chassis determina a energia, o arrefecimento e quantas GPUs cabem.

Redes e DPUs

Movem dados entre GPUs, servidores e armazenamento. As DPUs retiram ao CPU o trabalho de rede, armazenamento e segurança.

Software

Drivers, CUDA, frameworks de IA e ferramentas de cluster transformam o hardware numa plataforma que as suas equipas podem usar.

Porque é que as organizações adotam a computação acelerada

As cargas de trabalho superam os CPUs

Os modelos de IA e os conjuntos de dados crescem mais depressa do que o desempenho dos CPUs. As tarefas atrasam-se, os níveis de serviço degradam-se e as faturas de energia sobem.

Os fluxos de trabalho tornam-se complexos

A preparação de dados, o treino, a inferência e a visualização correm muitas vezes em equipamentos separados. Uma única plataforma acelerada simplifica o pipeline.

Novas aplicações criam novos silos

Acrescentar IA ao lado das aplicações existentes pode criar ilhas de hardware. Uma plataforma partilhada e certificada mantém tudo gerível.

A gama

Produtos de computação acelerada NVIDIA

Cada sistema, GPU, produto de rede e licença de software abaixo pode ser fornecido isoladamente ou como parte de uma solução completa. Filtre por tipo, compare as especificações principais e peça um orçamento.

Sistemas e plataformas

NVIDIA Vera Rubin NVL72

Sistema à escala de rack para IA agêntica e os maiores modelos

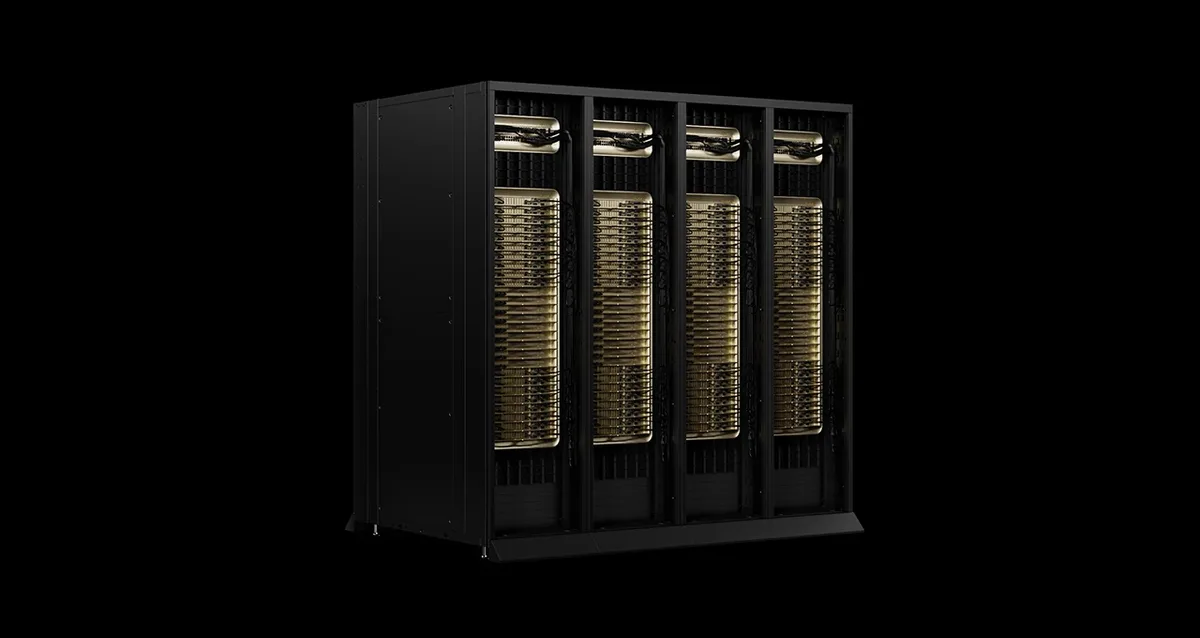
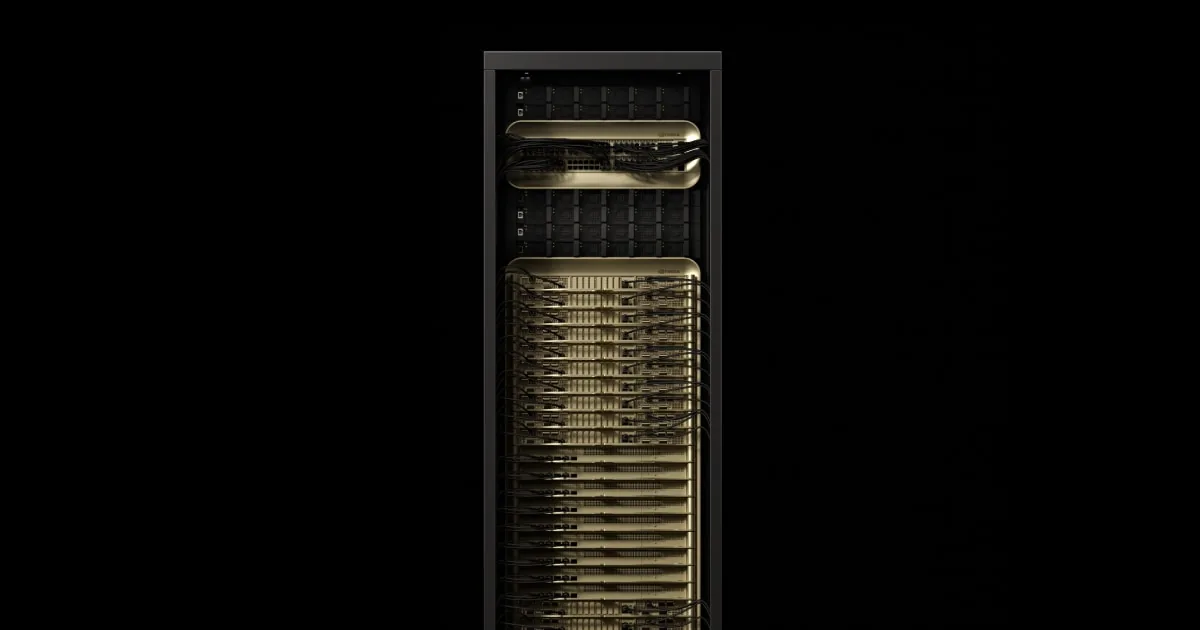
A mais recente geração à escala de rack da NVIDIA junta 72 GPUs Rubin e 36 CPUs Vera num único domínio NVLink, para que um só rack se comporte como um acelerador muito grande.

Para quem é indicado: Fábricas de IA, criadores de modelos e prestadores de serviços que planeiam a sua próxima grande implementação

Benefícios

  • Muito mais tokens por megawatt do que a geração Grace Blackwell, segundo os números da NVIDIA
  • Memória HBM4 dimensionada para modelos com biliões de parâmetros e contexto longo
  • Tabuleiros modulares sem cabos que simplificam a manutenção no rack

Especificações principais

Configuração72× Rubin GPU, 36× Vera CPU
Memória da GPU20.7 TB HBM4 | 1,400 TB/s
Inferência NVFP43,600 PFLOPS (sparse)
Largura de banda NVLink216 TB/s (sixth generation)
Memória do CPUUp to 54 TB LPDDR5X
FormatoRack, third-generation MGX NVL72

O que a Workstation faz: Verificamos cedo a energia, o arrefecimento e a carga do pavimento das instalações, garantimos a alocação e planeamos a entrega, instalação e comissionamento em função da sua sala de dados.

Preço sob orçamentoPedir orçamento ↗
Ver em NVIDIA.com ↗
Sistemas e plataformas

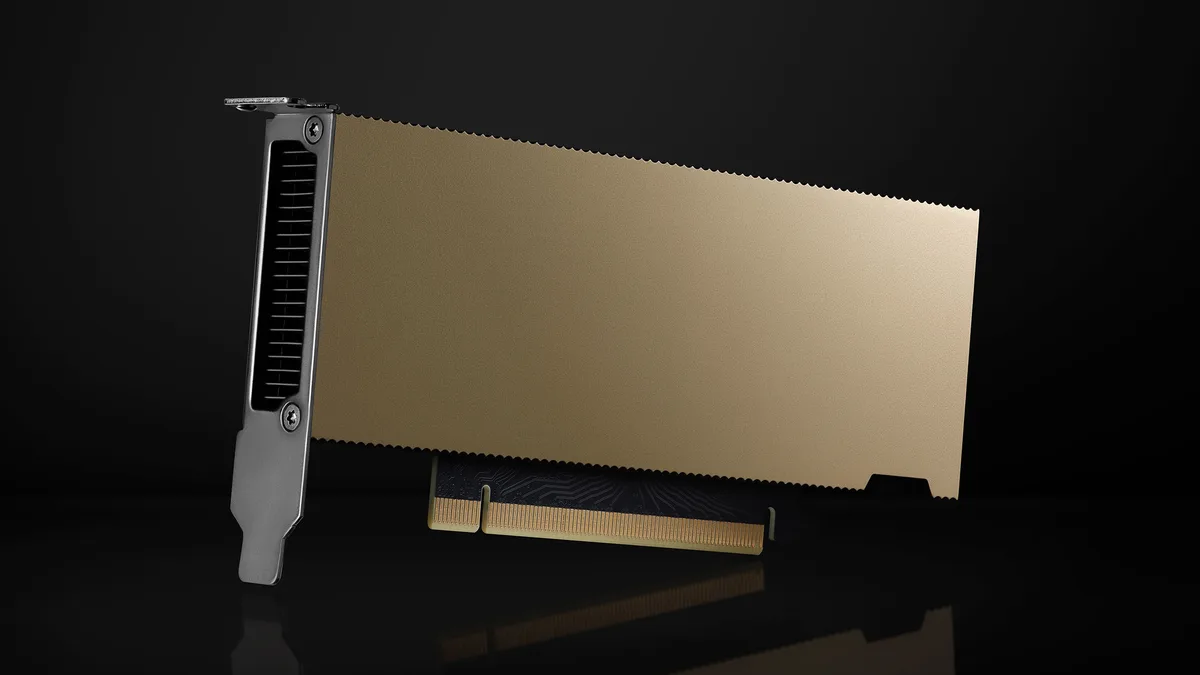
NVIDIA GB300 NVL72 (DGX GB300)

Rack Blackwell Ultra com refrigeração líquida para raciocínio de IA

Trinta e seis CPUs Grace e 72 GPUs Blackwell Ultra partilham uma única malha NVLink num único rack com refrigeração líquida. A NVIDIA também o fornece como DGX GB300.

Para quem é indicado: Organizações que servem modelos de raciocínio a muitos utilizadores e equipas que treinam à escala de fronteira

Benefícios

  • Um grande salto em tokens por segundo por utilizador face aos sistemas baseados em Hopper
  • 37 TB de memória rápida mantêm contextos longos e modelos grandes num único domínio
  • As SuperNICs ConnectX-8 dão a cada GPU um caminho de 800 Gb/s para a rede

Especificações principais

GPUs72× Blackwell Ultra
CPUs36× Grace (2,592 Arm Neoverse V2 cores)
Memória da GPU20 TB | up to 576 TB/s
Memória rápida37 TB
FP4 Tensor Core1,440 PFLOPS (sparse)
Largura de banda NVLink130 TB/s

O que a Workstation faz: Planeamos a refrigeração líquida e a energia com a sua equipa de instalações, coordenamos a entrega do rack integrado e comissionamo-lo segundo uma configuração de referência validada.

Preço sob orçamentoPedir orçamento ↗
Ver em NVIDIA.com ↗
Sistemas e plataformas

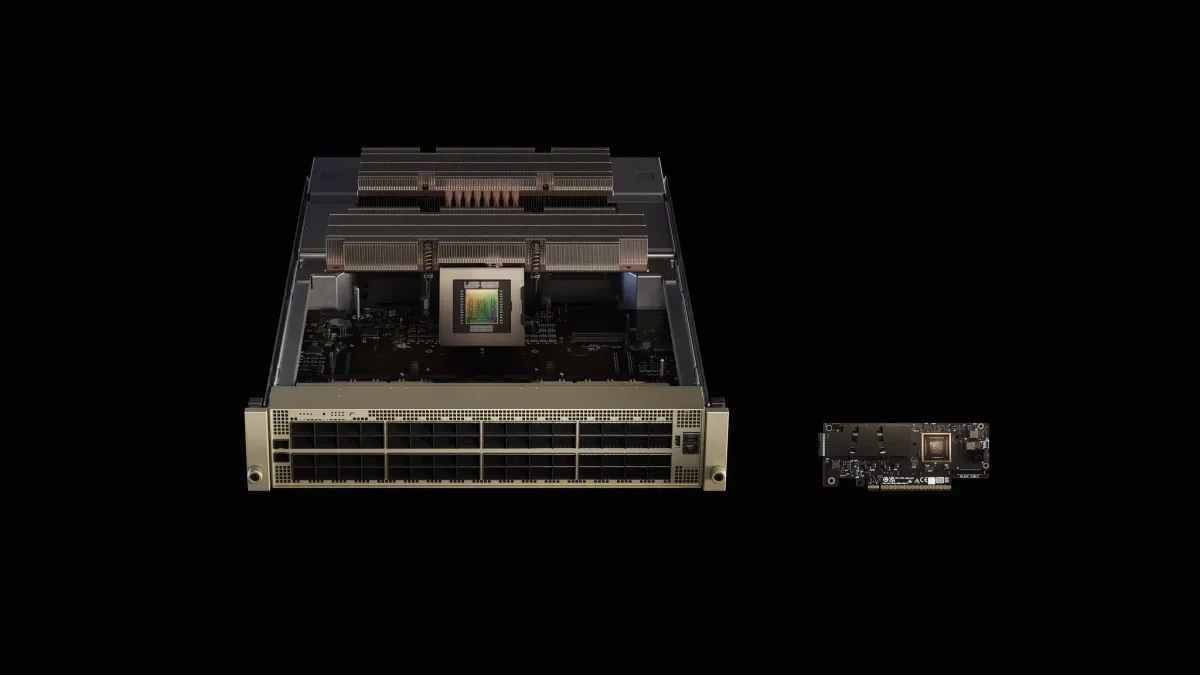
NVIDIA GB200 NVL72 (DGX GB200)

Sistema Grace Blackwell à escala de rack num único domínio NVLink

O primeiro rack Grace Blackwell: 72 GPUs Blackwell e 36 CPUs Grace ligados por NVLink e arrefecidos por líquido, para treinos de grande dimensão e inferência em tempo real.

Para quem é indicado: Equipas que treinam ou servem modelos com biliões de parâmetros e precisam de um grande conjunto partilhado de memória de GPU

Benefícios

  • Inferência em tempo real em modelos de linguagem muito grandes, muitas vezes mais rápida do que a H100, segundo os números da NVIDIA
  • A refrigeração líquida aumenta a densidade e a eficiência energética
  • A quinta geração de NVLink oferece 1,8 TB/s entre quaisquer duas GPUs

Especificações principais

Configuração72× Blackwell GPU, 36× Grace CPU
Memória da GPU13.4 TB HBM3E | 576 TB/s
NVFP4 Tensor Core1,440 PFLOPS sparse | 720 PFLOPS dense
Largura de banda NVLink130 TB/s
Memória do CPU17 TB LPDDR5X | 14 TB/s
ArrefecimentoLiquid cooled

O que a Workstation faz: Avaliamos as suas instalações para refrigeração líquida, gerimos a entrega e a integração com a sua rede e armazenamento e damos suporte ao rack após a entrada em produção.

Preço sob orçamentoPedir orçamento ↗
Ver em NVIDIA.com ↗
Sistemas e plataformas

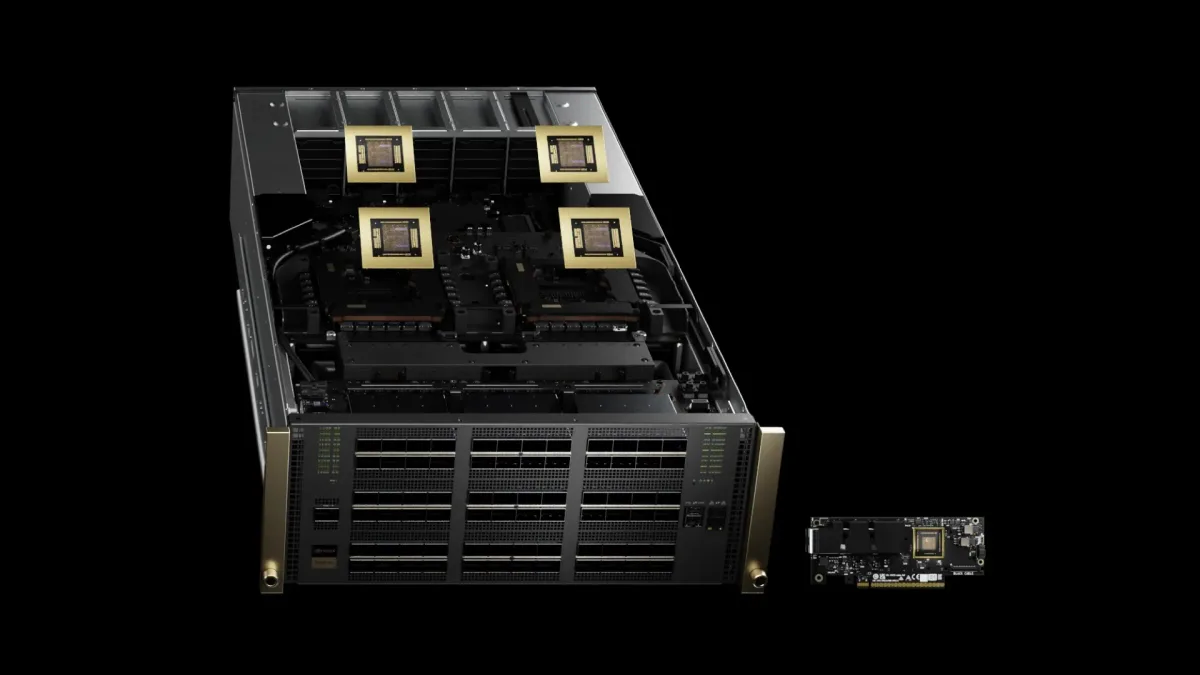
NVIDIA DGX B300

Oito GPUs Blackwell Ultra num único sistema DGX

Um servidor DGX autónomo com oito GPUs Blackwell Ultra, redes NVIDIA e toda a pilha de software DGX, pronto para funcionar isoladamente ou integrar um BasePOD ou SuperPOD.

Para quem é indicado: Empresas que constroem a sua primeira fábrica de IA a sério e equipas que preferem o design de referência da NVIDIA a uma solução à medida

Benefícios

  • 2,3 TB de memória de GPU num único nó para modelos grandes
  • Redes ConnectX-8 e BlueField-3 integradas para escalar horizontalmente
  • O software DGX mantém todos os nós de um cluster consistentes desde o primeiro dia

Especificações principais

GPUs8× Blackwell Ultra
Memória da GPU2.3 TB total
Desempenho de IA72 PFLOPS FP8 training, 144 PFLOPS FP4 inference
Rede8× ConnectX-8, 2× BlueField-3 DPU

O que a Workstation faz: Verificamos a energia e o fluxo de ar do rack, entregamos e instalamos o sistema no rack, ligamo-lo à sua malha de rede e entregamo-lo com o DGX OS e os drivers validados.

Preço sob orçamentoPedir orçamento ↗
Ver em NVIDIA.com ↗
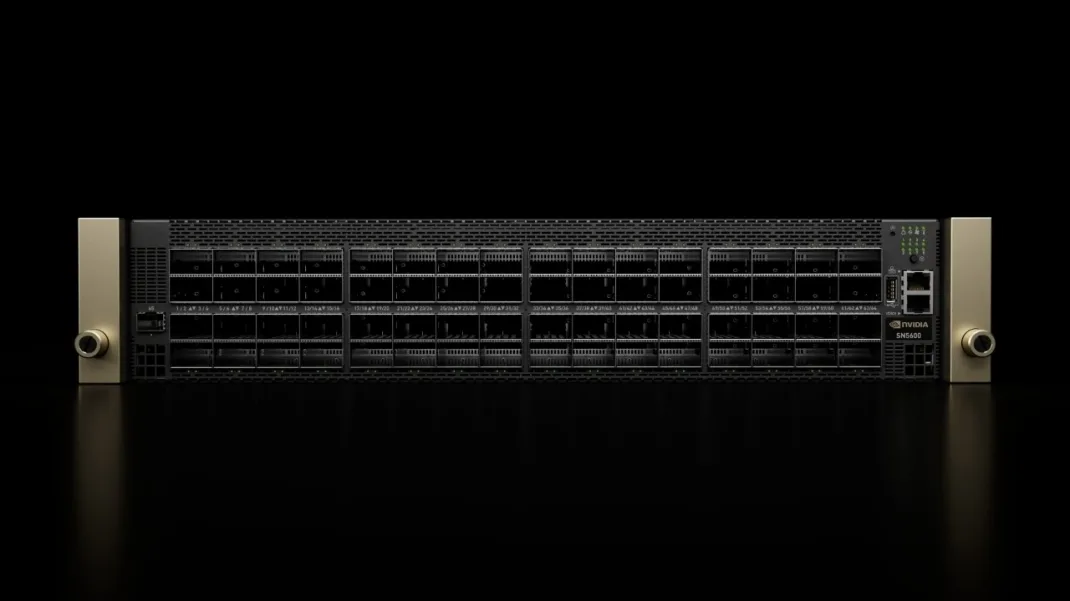
Sistemas e plataformas

NVIDIA DGX B200

DGX Blackwell comprovado para treino e inferência

Oito GPUs Blackwell ligadas por NVLink num único chassis DGX, um bloco de construção amplamente implementado para IA on-premises.

Para quem é indicado: Equipas que passam de Hopper ou de GPUs na cloud para uma plataforma Blackwell própria

Benefícios

  • Uma única plataforma para treino, fine-tuning e inferência
  • 1440 GB de memória de GPU distribuídos por oito GPUs ligadas por NVLink
  • Encaixa nos designs de referência BasePOD e SuperPOD à medida que cresce

Especificações principais

GPUs8× Blackwell
Memória da GPU1,440 GB total
Desempenho de IA72 PFLOPS training, 144 PFLOPS inference
Rede8× ConnectX-7, 2× BlueField-3 DPU

O que a Workstation faz: Dimensionamo-lo em função dos seus modelos, entregamo-lo e instalamo-lo, e configuramos os drivers, o CUDA e o NVIDIA AI Enterprise antes da entrega.

Preço sob orçamentoPedir orçamento ↗
Ver em NVIDIA.com ↗
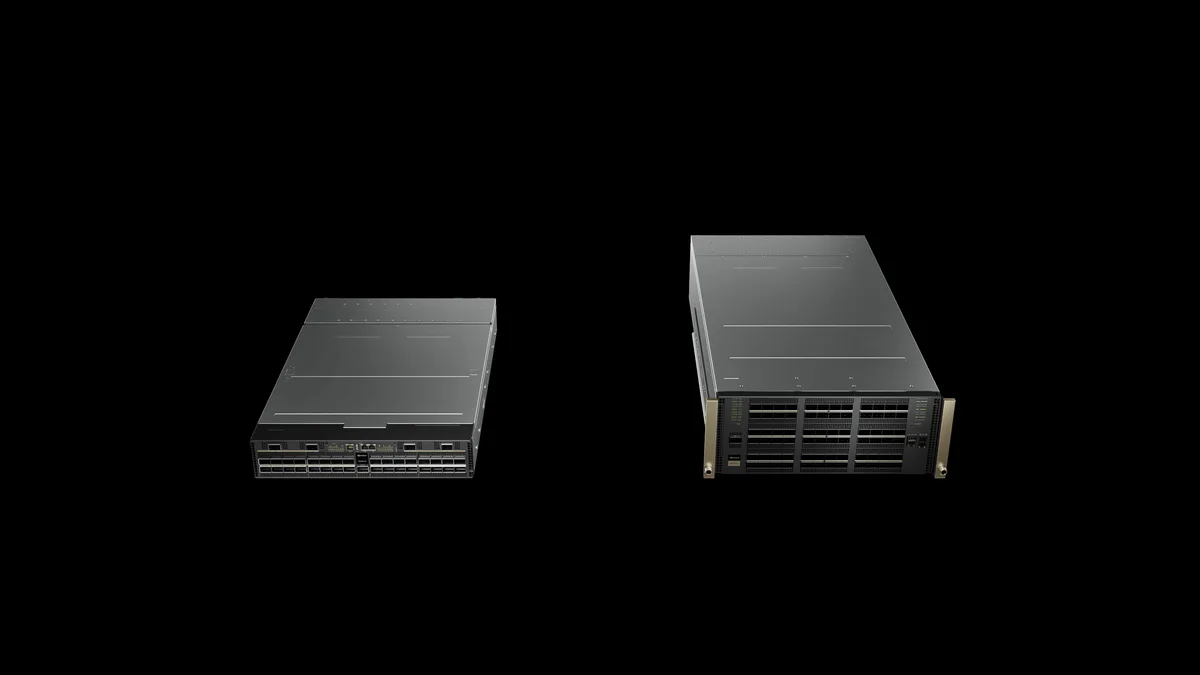
Sistemas e plataformas

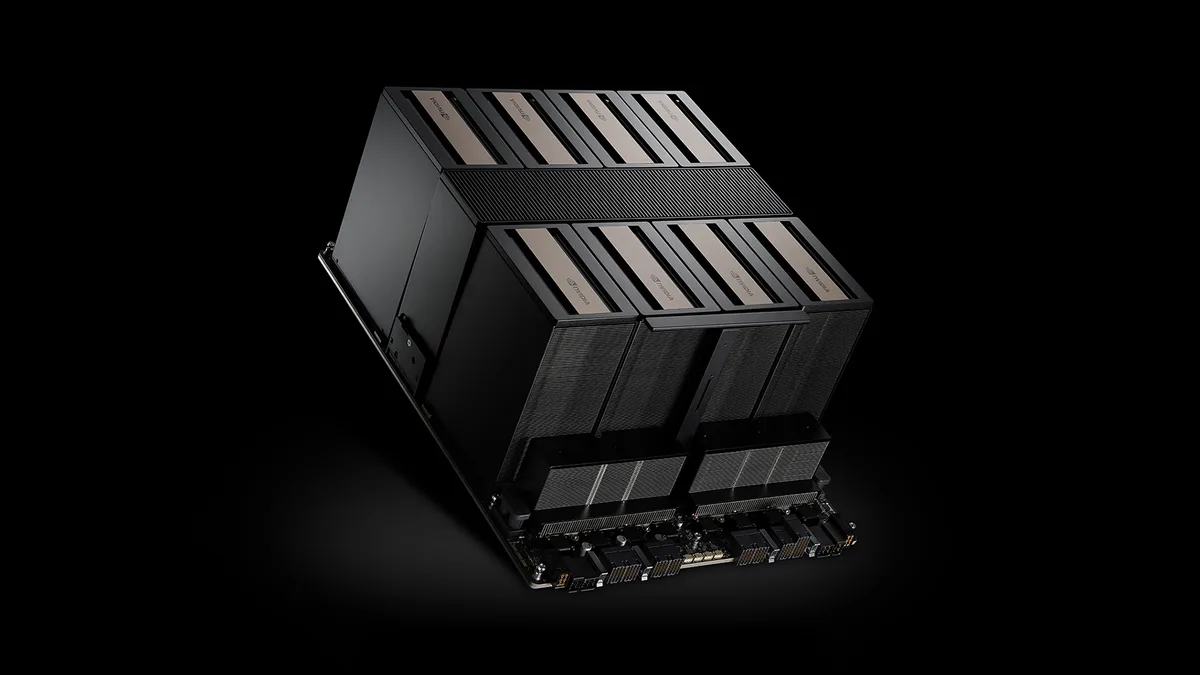
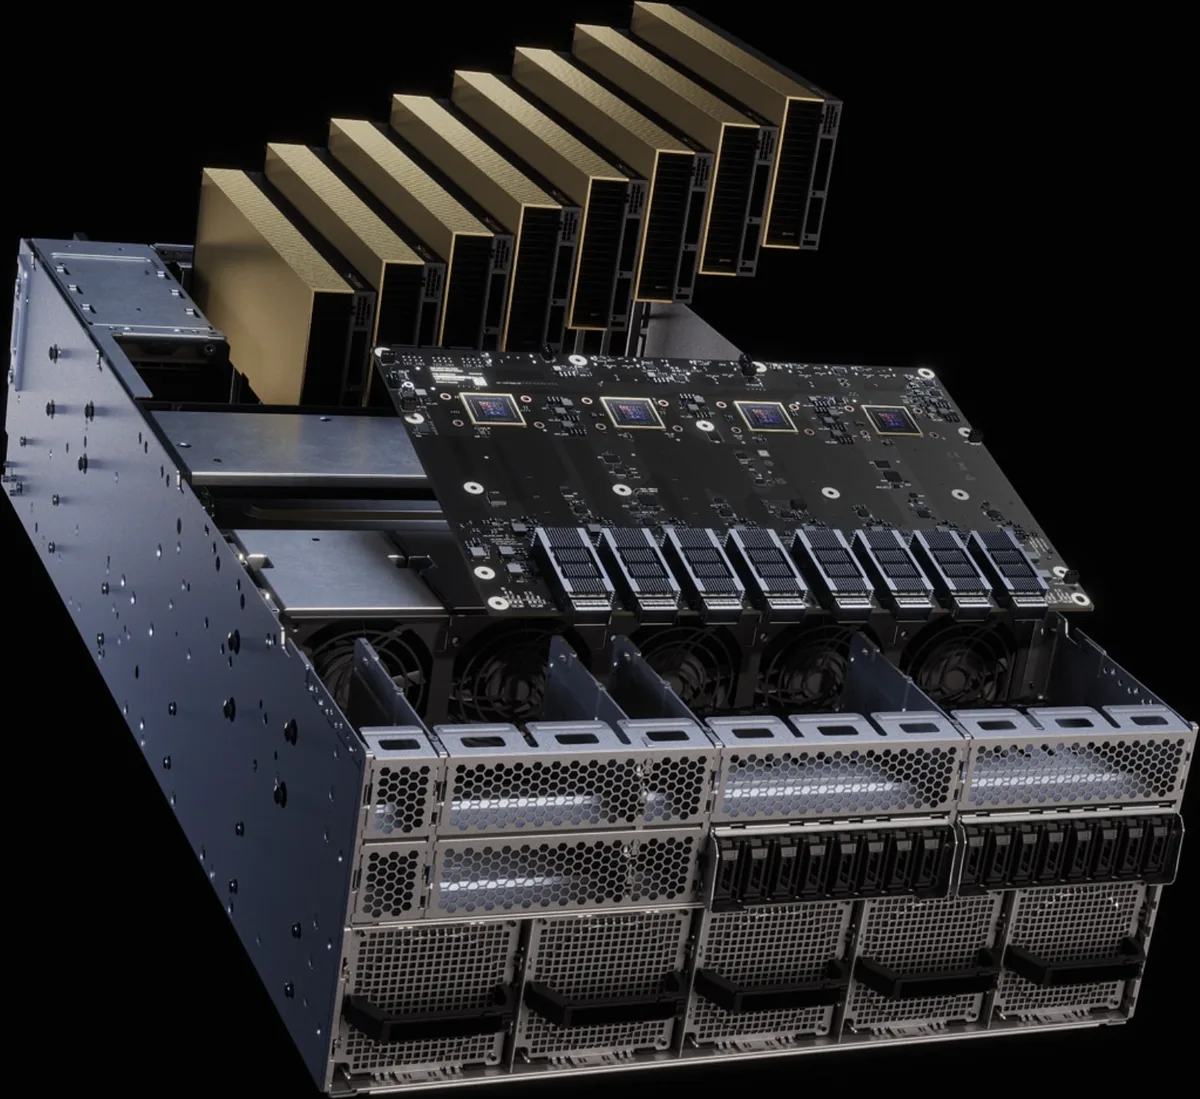
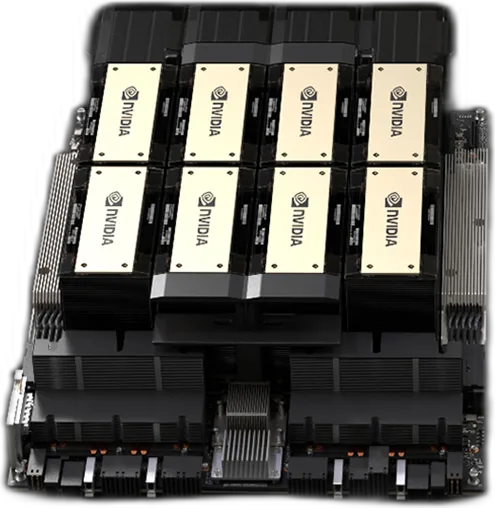
NVIDIA HGX

Placa base de oito GPUs em servidores de parceiros

O HGX é a placa base de GPUs ligadas por NVLink da NVIDIA que os fabricantes de servidores integram nos seus próprios sistemas, oferecendo-lhe GPUs de topo com o chassis, o CPU e a marca de suporte à sua escolha.

Para quem é indicado: Organizações que querem GPUs topo de gama do seu fornecedor de servidores preferido

Benefícios

  • Escolha a marca de servidor, o CPU e o armazenamento que se adequam ao seu parque informático
  • O NVLink e o NVSwitch ligam as oito GPUs à velocidade máxima
  • Abrange as gerações Blackwell, Blackwell Ultra e Rubin

Especificações principais

HGX B3008× Blackwell Ultra SXM, 2.1 TB, 144 PFLOPS FP4 (sparse)
HGX B2008× Blackwell SXM, 1.4 TB, 144 PFLOPS FP4 (sparse)
HGX Rubin NVL88× Rubin SXM, 2 TB HBM4, 400 PFLOPS NVFP4 inference
Largura de banda NVLink14.4 TB/s total (HGX B300 and B200)

O que a Workstation faz: Adquirimos o servidor HGX da marca que preferir, fazemos o burn-in a plena carga na nossa oficina e instalamo-lo com a sua rede.

Preço sob orçamentoPedir orçamento ↗
Ver em NVIDIA.com ↗
Sistemas e plataformas

NVIDIA RTX PRO Server

Servidor Blackwell universal para IA empresarial e gráficos

Um servidor para centro de dados com até oito GPUs RTX PRO 6000 Blackwell Server Edition que executa IA, simulação, rendering e estações de trabalho virtuais numa única plataforma. É o servidor acelerado de referência da NVIDIA, e a página EGX remete agora para aqui.

Para quem é indicado: Empresas que transferem cargas de trabalho existentes do centro de dados para GPUs, a par de novos serviços de IA

Benefícios

  • Um único tipo de servidor para inferência de IA, computação visual e ciência de dados
  • As opções com arrefecimento a ar adequam-se à maioria das salas de servidores existentes
  • Validado com NVIDIA AI Enterprise e Omniverse

Especificações principais

GPUsUp to 8× RTX PRO 6000 Blackwell Server Edition
Memória da GPU800 GB (8-GPU configuration)
Largura de banda da memória13 TB/s (8-GPU configuration)
Gráficos RTX3 PFLOPS
ConfiguraçõesMGX 2U, 4U and 6U (6U liquid cooled)

O que a Workstation faz: Especificamos o chassis e o número de GPUs em função das suas cargas de trabalho, confirmamos que é NVIDIA-Certified e depois montamo-lo, fazemos o burn-in e instalamo-lo.

Preço sob orçamentoPedir orçamento ↗
Ver em NVIDIA.com ↗
Sistemas e plataformas

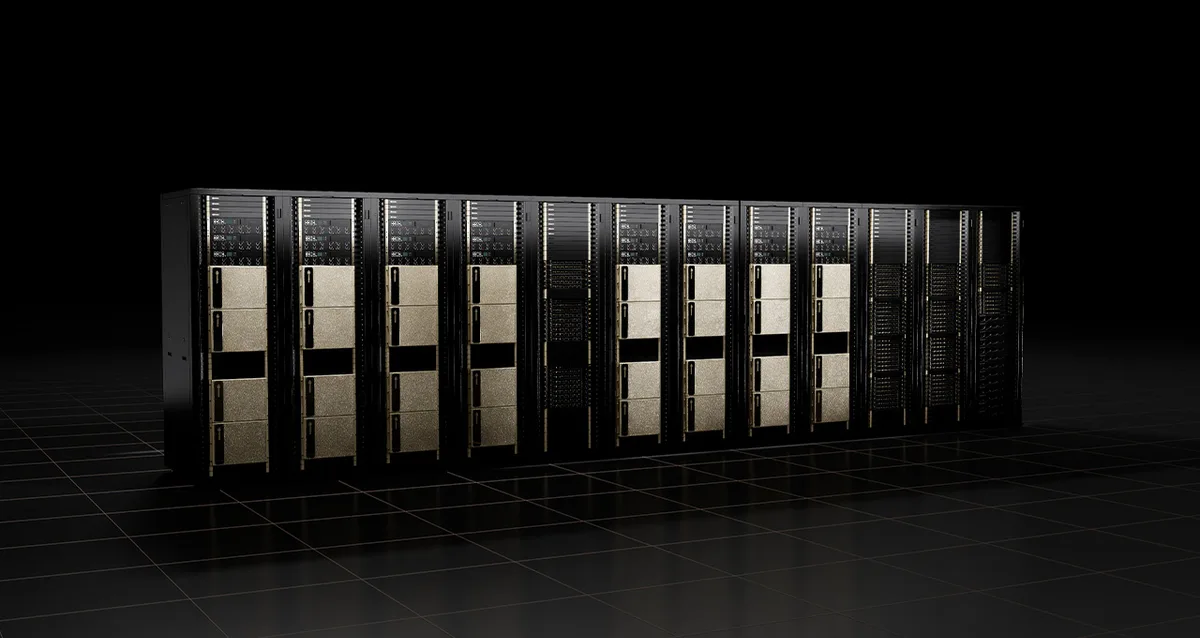
NVIDIA DGX SuperPOD

Modelo chave na mão para fábricas de IA em grande escala

Uma arquitetura de referência full-stack que combina sistemas DGX, redes NVIDIA, armazenamento certificado e software de gestão em unidades escaláveis replicáveis.

Para quem é indicado: Laboratórios de investigação, grandes empresas e prestadores de serviços de IA que constroem clusters de centenas ou milhares de GPUs

Benefícios

  • Um design testado elimina grande parte do risco de integração
  • Escala até dezenas de milhares de GPUs em unidades replicáveis
  • Inclui Mission Control e Base Command Manager para as operações

Especificações principais

TipoReference architecture
Bloco de construçãoScalable units of DGX systems
EscalaUp to tens of thousands of GPUs
ArmazenamentoNVIDIA-certified partner storage
SoftwareNVIDIA AI Enterprise, Base Command Manager, Mission Control

O que a Workstation faz: Lideramos o design com a NVIDIA e os parceiros de armazenamento, executamos o plano de projeto, instalamos as unidades escaláveis e continuamos a ser o seu contacto de suporte.

Preço sob orçamentoPedir orçamento ↗
Ver em NVIDIA.com ↗
Sistemas e plataformas

NVIDIA DGX BasePOD

Design de referência para o seu primeiro cluster DGX

Um design comprovado para dois ou mais sistemas DGX com redes, armazenamento e software de cluster adequados: mais pequeno do que um SuperPOD, mas construído da mesma forma.

Para quem é indicado: Equipas que passam de um único sistema DGX para um pequeno cluster partilhado

Benefícios

  • Comece com dois sistemas e acrescente mais sem redesenhar
  • Redes e armazenamento adequados às GPUs
  • Software de cluster incluído para agendamento e monitorização

Especificações principais

TipoReference architecture
Escala2 or more DGX systems
RedePer reference architecture
ArmazenamentoPartner storage
SoftwareNVIDIA AI Enterprise, Base Command

O que a Workstation faz: Dimensionamos o cluster, fornecemos todas as peças, montamo-lo no rack, fazemos a cablagem e configuramos o agendamento para que as suas equipas o possam partilhar desde o primeiro dia.

Preço sob orçamentoPedir orçamento ↗
Ver em NVIDIA.com ↗
Sistemas e plataformas

CPUs NVIDIA Grace e Vera

CPUs Arm para centros de dados concebidos para fábricas de IA

Os CPUs próprios da NVIDIA ligam-se às suas GPUs através de NVLink-C2C. O Grace CPU Superchip já é fornecido em servidores de parceiros e o seu sucessor, o Vera, destina-se à IA agêntica.

Para quem é indicado: Centros de HPC, construtores de cloud e todos os que executam pipelines intensivos em CPU a par de GPUs

Benefícios

  • Elevada largura de banda de memória graças à LPDDR5X
  • O dobro do desempenho com a mesma potência que os principais CPUs tradicionais, segundo os números da NVIDIA
  • Uma ligação coerente e de alta velocidade às GPUs NVIDIA

Especificações principais

Grace CPU Superchip144 Arm Neoverse V2 cores, 2 CPUs over 900 GB/s NVLink-C2C
Largura de banda da memória GraceUp to 1 TB/s LPDDR5X
CPU Vera88 Olympus cores, up to 1.5 TB memory at up to 1.2 TB/s
Vera NVLink-C2CUp to 1.8 TB/s

O que a Workstation faz: Encontramos o servidor de parceiro que se adequa à sua pilha de software, testamos consigo as suas aplicações em Arm e depois montamos e damos suporte ao resultado.

Preço sob orçamentoPedir orçamento ↗
Ver em NVIDIA.com ↗
Sistemas e plataformas

NVIDIA OVX

Servidores L40S para Omniverse e gémeos digitais

O OVX é o design de servidor validado da NVIDIA para Omniverse, que combina GPUs L40S com redes ConnectX-7 ou BlueField-3 para simulação, rendering e IA.

Para quem é indicado: Fabricantes, arquitetos e equipas de engenharia que criam gémeos digitais industriais

Benefícios

  • Um único servidor para gráficos, simulação e inferência de IA
  • Validado para Omniverse e NVIDIA AI Enterprise
  • Escala por centenas de servidores numa malha de alta velocidade

Especificações principais

GPUs4× or 8× NVIDIA L40S
CPUs2× Intel Xeon Gold or 2× AMD EPYC
Memória do anfitrião384 GB (4-GPU) or 768 GB (8-GPU) DDR5 ECC minimum
Armazenamento1 TB NVMe boot, 2× 4 TB NVMe
RedeConnectX-7 or BlueField-3

O que a Workstation faz: Montamos servidores segundo o padrão OVX de parceiros certificados, configuramos o Omniverse e os drivers e ligamo-los às suas ferramentas de design.

Preço sob orçamentoPedir orçamento ↗
Ver em NVIDIA.com ↗
Sistemas e plataformas

NVIDIA AGX (Jetson AGX Thor)

Computadores de IA para robôs e máquinas autónomas

O AGX é a plataforma da NVIDIA para máquinas autónomas. O seu atual topo de gama, o Jetson AGX Thor, leva uma GPU Blackwell a robôs, veículos e máquinas inteligentes.

Para quem é indicado: Equipas de robótica, automóvel e indústria que integram IA em máquinas

Benefícios

  • Executa modelos de perceção e de IA generativa na própria máquina
  • O baixo consumo adequa-se a designs móveis e embebidos
  • Usa o mesmo software CUDA que as plataformas de centro de dados da NVIDIA

Especificações principais

GPUBlackwell, 2560 CUDA cores, 96 fifth-generation Tensor Cores
Desempenho de IA2070 TFLOPS (FP4)
OpçõesDeveloper kit, or T5000 and T4000 production modules

O que a Workstation faz: Fornecemos kits de desenvolvimento e módulos de produção, ajudamos a escolher placas de suporte e caixas, e acompanhamo-lo do protótipo à implementação.

Preço sob orçamentoPedir orçamento ↗
Ver em NVIDIA.com ↗
Sistemas e plataformas

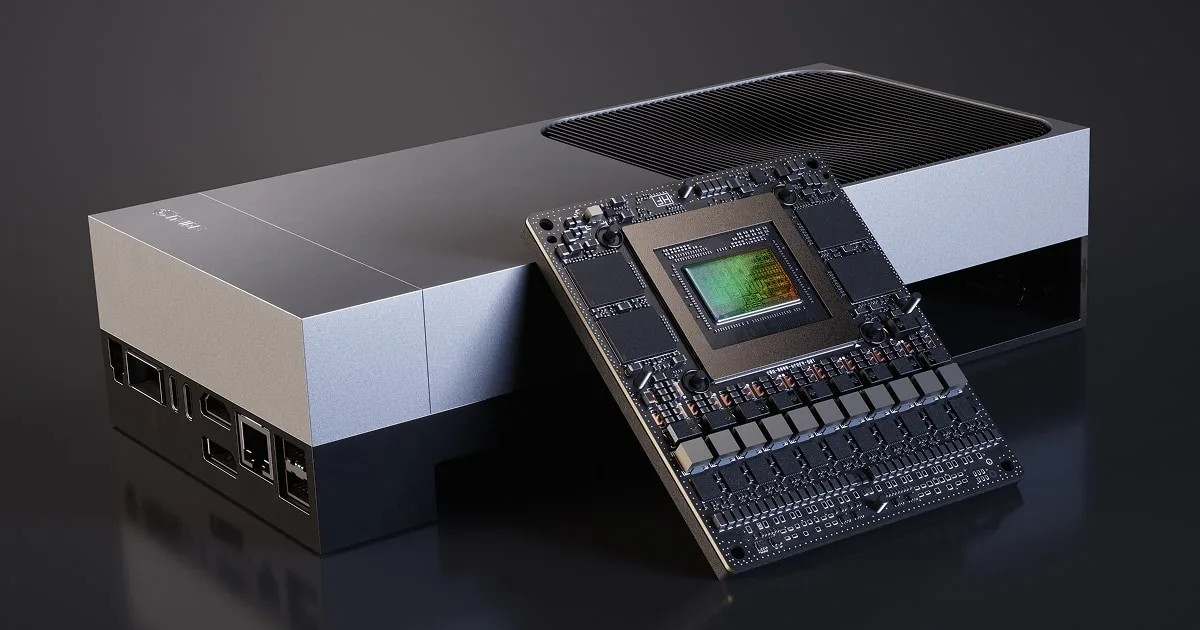
NVIDIA IGX Thor

IA industrial na edge com segurança funcional

O IGX é a plataforma empresarial da NVIDIA para IA física na edge industrial e médica, com uma ilha de segurança dedicada e suporte de software a longo prazo.

Para quem é indicado: Fabricantes de dispositivos médicos, fábricas e operadores de infraestruturas que precisam de certificação de segurança e de um longo ciclo de suporte

Benefícios

  • Design de segurança funcional orientado para ISO 26262 e IEC 61508
  • Dez anos de suporte de software empresarial da NVIDIA
  • GPU RTX PRO Blackwell opcional para modelos mais exigentes

Especificações principais

Desempenho de IAUp to 5,581 TFLOPS FP4 (sparse) with discrete GPU
GPU integrada2,560-core Blackwell
CPU14-core Arm Neoverse-V3AE, 2.6 GHz
Memória128 GB LPDDR5X, 273 GB/s
Consumo40–130 W, up to 300 W for the discrete GPU

O que a Workstation faz: Fornecemos kits de desenvolvimento e sistemas de produção, ajudamo-lo a planear as evidências para certificação e damos suporte à implementação nas suas instalações.

Preço sob orçamentoPedir orçamento ↗
Ver em NVIDIA.com ↗
Sistemas e plataformas

NVIDIA Groq 3 LPX

Rack de inferência de baixa latência para Vera Rubin

O LPX é um rack com 256 aceleradores de inferência LPU que funciona em conjunto com o Vera Rubin NVL72 para gerar tokens de forma rápida e previsível para IA interativa e agêntica.

Para quem é indicado: Prestadores de serviços de IA cujos utilizadores precisam de tempos de resposta rápidos e consistentes

Benefícios

  • Geração de tokens determinística e de baixa latência
  • Débito muito superior por megawatt para modelos com biliões de parâmetros, segundo as projeções da NVIDIA
  • Uma ligação direta e de baixa latência aos racks NVL72

Especificações principais

Aceleradores256 LPUs per rack
Memória no chip128 GB SRAM per rack (500 MB per LPU)
Largura de banda SRAM40 PB/s per rack
Largura de banda de scale-up640 TB/s per rack
FormatoNVIDIA MGX ETL rack

O que a Workstation faz: Avaliamos como se enquadra nos seus planos Vera Rubin, confirmamos a disponibilidade com a NVIDIA e planeamos a instalação junto dos seus outros racks.

Preço sob orçamentoPedir orçamento ↗
Ver em NVIDIA.com ↗

GPUs para centros de dados

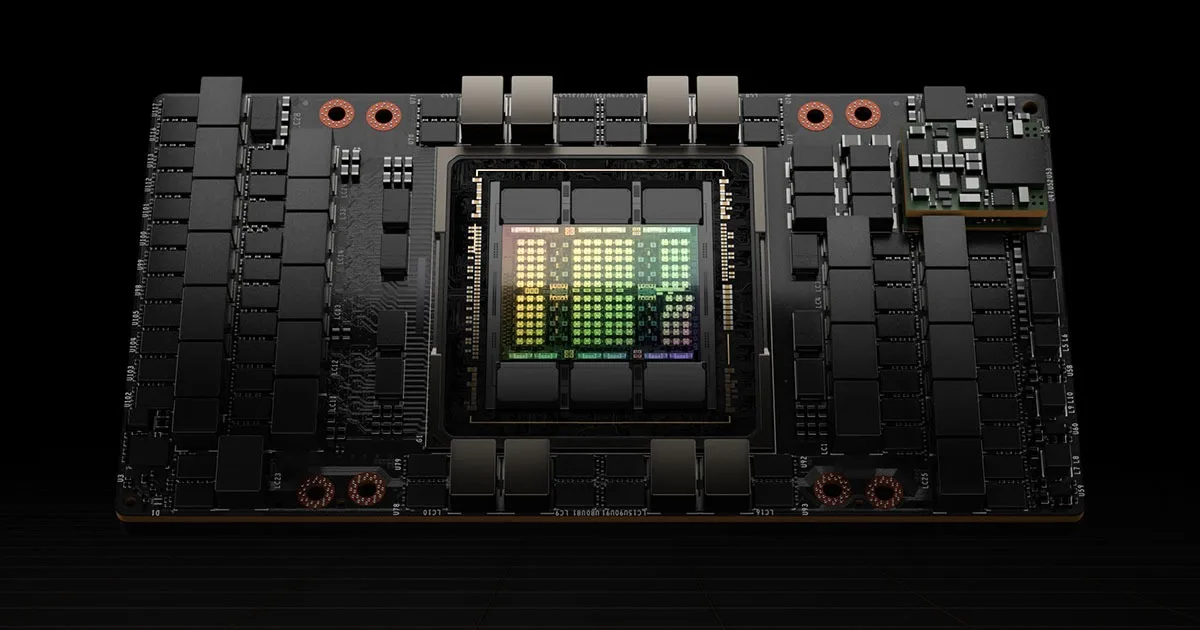
NVIDIA H200 (SXM)

GPU Hopper com 141 GB de HBM3e

A H200 mantém a arquitetura Hopper, mas acrescenta muito mais memória, e mais rápida, o que beneficia a inferência de modelos grandes e o HPC limitado pela memória. A versão SXM destina-se a servidores HGX.

Para quem é indicado: Equipas que executam modelos de linguagem de grande dimensão e código HPC em servidores HGX

Benefícios

  • 141 GB por GPU acomodam modelos maiores sem os dividir
  • Maior largura de banda de memória acelera o trabalho limitado pela memória
  • Executa o mesmo software CUDA que a H100

Especificações principais

ArquiteturaNVIDIA Hopper
Memória da GPU141 GB HBM3e
FormatoSXM (HGX)
ArrefecimentoPassive (server airflow)

O que a Workstation faz: Fornecemos a H200 num servidor HGX certificado, fazemos o burn-in e instalamo-la com os seus drivers e pilha de software.

Preço sob orçamentoPedir orçamento ↗
Ver em NVIDIA.com ↗

GPUs para centros de dados

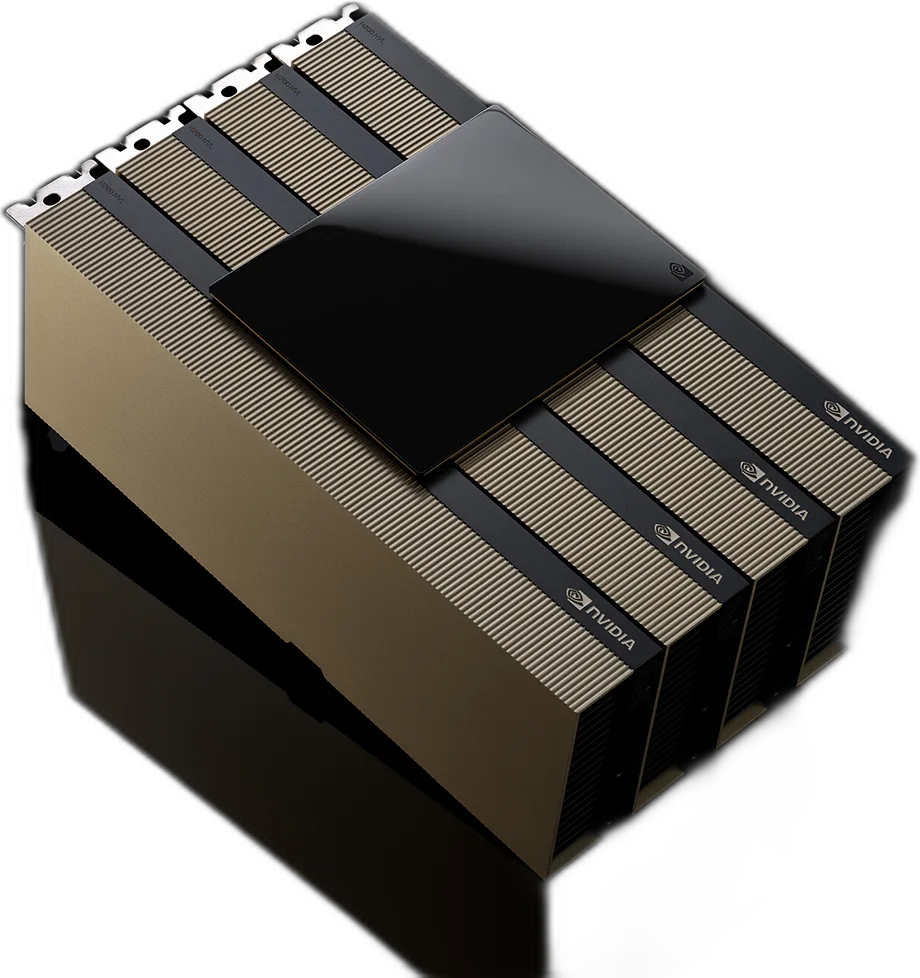
NVIDIA H200 NVL

GPU Hopper de 141 GB para servidores PCIe com arrefecimento a ar

A versão PCIe da H200 para racks empresariais padrão. As pontes NVLink permitem emparelhar placas para modelos que precisam de mais memória.

Para quem é indicado: Empresas que acrescentam inferência de modelos grandes a salas de servidores existentes com arrefecimento a ar

Benefícios

  • Muita memória de GPU sem passar para refrigeração líquida
  • As pontes NVLink juntam GPUs para modelos maiores
  • Compatível com servidores NVIDIA-Certified convencionais

Especificações principais

ArquiteturaNVIDIA Hopper
Memória da GPU141 GB HBM3e
FormatoPCIe, dual slot
ArrefecimentoPassive (server airflow)

O que a Workstation faz: Verificamos a energia, o fluxo de ar e a disposição das ranhuras do seu chassis e depois instalamos, testamos e entregamos as placas ou um servidor completo.

Preço sob orçamentoPedir orçamento ↗
Ver em NVIDIA.com ↗

GPUs para centros de dados

NVIDIA H100 PCIe 80 GB

GPU Hopper para treino e inferência em servidores PCIe

A H100 PCIe leva o Transformer Engine e a computação confidencial da arquitetura Hopper a servidores padrão.

Para quem é indicado: Equipas com servidores de GPU PCIe existentes que precisam do desempenho comprovado da Hopper

Benefícios

  • O Transformer Engine acelera o treino e a inferência de modelos de linguagem
  • O Multi-Instance GPU divide uma placa em instâncias isoladas
  • Suporte de hardware para computação confidencial

Especificações principais

ArquiteturaNVIDIA Hopper
Memória da GPU80 GB HBM2e
FormatoDual-slot, full height, full length
ArrefecimentoPassive (server airflow)
InterfacePCIe

O que a Workstation faz: Instalamos a H100 em servidores para os quais está certificada, fazemos o burn-in e configuramos o CUDA, os drivers e quaisquer licenças vGPU ou AI Enterprise.

Preço sob orçamentoPedir orçamento ↗
Ver em NVIDIA.com ↗

GPUs para centros de dados

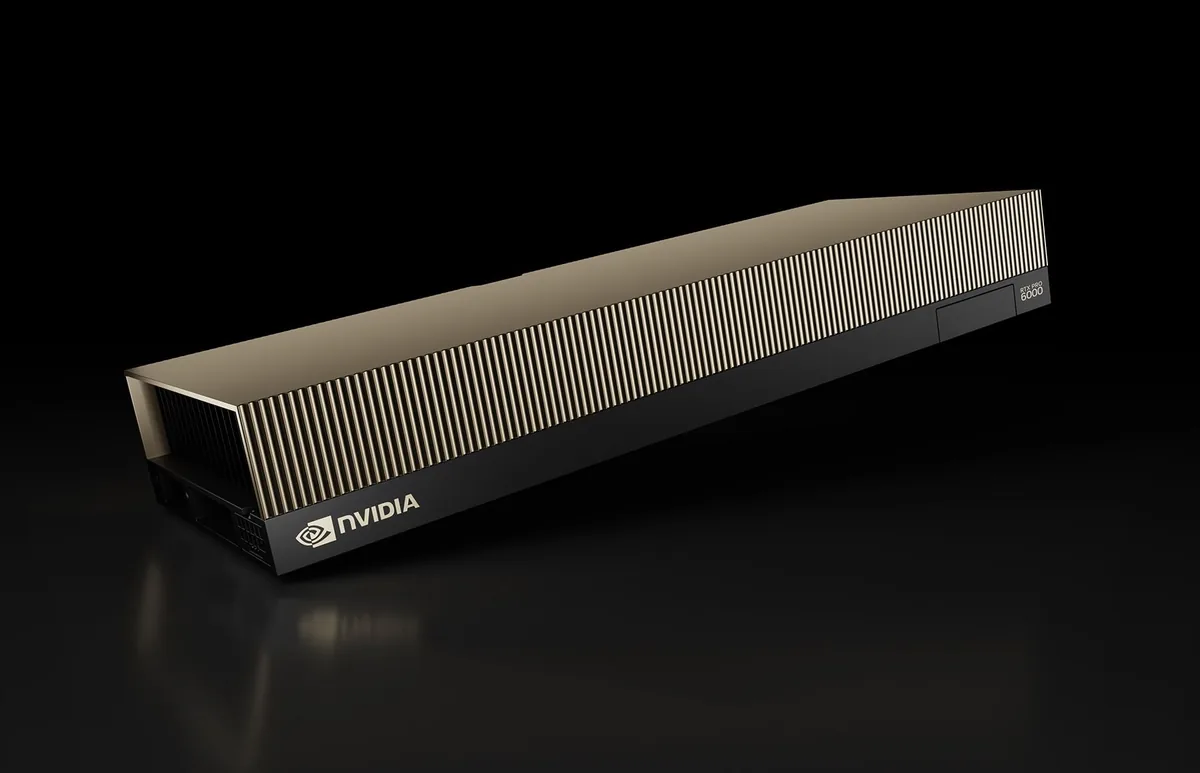
NVIDIA RTX PRO 6000 Blackwell Server Edition

GPU Blackwell de 96 GB para servidores em rack

Uma placa Blackwell com arrefecimento passivo e 96 GB de memória para inferência de IA, rendering, simulação e estações de trabalho virtuais no centro de dados.

Para quem é indicado: Empresas que consolidam cargas de trabalho de IA e gráficos num único tipo de GPU

Benefícios

  • 96 GB por GPU suportam modelos grandes e cenas complexas
  • Executa tanto IA como gráficos profissionais
  • Potência configurável para se adequar ao servidor

Especificações principais

ArquiteturaNVIDIA Blackwell
Memória da GPU96 GB GDDR7 with ECC
Potência máximaUp to 600 W (configurable)
InterfacePCIe 5.0 x16
FormatoDual-slot, passive (server airflow)

O que a Workstation faz: Fornecemos as placas isoladamente ou num RTX PRO Server e testamo-las a plena carga antes da entrega.

Preço sob orçamentoPedir orçamento ↗
Ver em NVIDIA.com ↗

GPUs para centros de dados

NVIDIA RTX PRO 4500 Blackwell Server Edition

GPU Blackwell de ranhura única para servidores de alta densidade

Uma GPU Blackwell compacta de 32 GB com arrefecimento passivo que permite instalar muitas placas num servidor para inferência, vídeo e desktops virtuais.

Para quem é indicado: Equipas que escalam inferência ou desktops virtuais para muitos utilizadores com um custo por GPU mais baixo

Benefícios

  • O design de ranhura única permite mais GPUs por servidor
  • 32 GB de GDDR7 para modelos de dimensão média
  • A menor potência adequa-se a racks existentes

Especificações principais

ArquiteturaNVIDIA Blackwell
Memória da GPU32 GB GDDR7
FormatoSingle slot, 4.4" H × 10.5" L
ArrefecimentoPassive (server airflow)

O que a Workstation faz: Calculamos quantas placas os seus servidores conseguem alimentar e arrefecer e depois montamos e testamos a configuração.

Preço sob orçamentoPedir orçamento ↗
Ver em NVIDIA.com ↗

GPUs para centros de dados

NVIDIA L40S

GPU versátil de 48 GB para IA e gráficos

Uma GPU Ada Lovelace para centro de dados equilibrada para inferência, fine-tuning e gráficos 3D, e a GPU do design OVX da NVIDIA.

Para quem é indicado: Equipas que precisam de uma única GPU para cargas de trabalho de IA e visuais

Benefícios

  • Excelente desempenho em inferência e fine-tuning face ao custo
  • Ray tracing por hardware para rendering e Omniverse
  • Uma placa PCIe padrão para servidores convencionais

Especificações principais

ArquiteturaNVIDIA Ada Lovelace
Memória da GPU48 GB GDDR6 with ECC
FormatoDual-slot, 4.4" H × 10.5" L
ArrefecimentoPassive (server airflow)
InterfacePCIe

O que a Workstation faz: Associamos a L40S a servidores certificados, fazemos o burn-in da montagem e instalamo-la com drivers e licenciamento configurados.

Preço sob orçamentoPedir orçamento ↗
Ver em NVIDIA.com ↗

GPUs para centros de dados

NVIDIA L40

GPU de 48 GB para rendering e estações de trabalho virtuais

A L40 concentra-se nos gráficos: rendering, Omniverse e estações de trabalho virtuais no centro de dados.

Para quem é indicado: Equipas de design e multimédia que transferem estações de trabalho para o centro de dados

Benefícios

  • 48 GB para cenas e recursos de grande dimensão
  • Suporta o software de GPU virtual da NVIDIA
  • Arrefecimento passivo para servidores padrão

Especificações principais

ArquiteturaNVIDIA Ada Lovelace
Memória da GPU48 GB GDDR6 with ECC
FormatoDual-slot, 4.4" H × 10.5" L
ArrefecimentoPassive (server airflow)
InterfacePCIe

O que a Workstation faz: Configuramos perfis e licenças vGPU para que os seus utilizadores tenham estações de trabalho remotas que parecem locais.

Preço sob orçamentoPedir orçamento ↗
Ver em NVIDIA.com ↗

GPUs para centros de dados

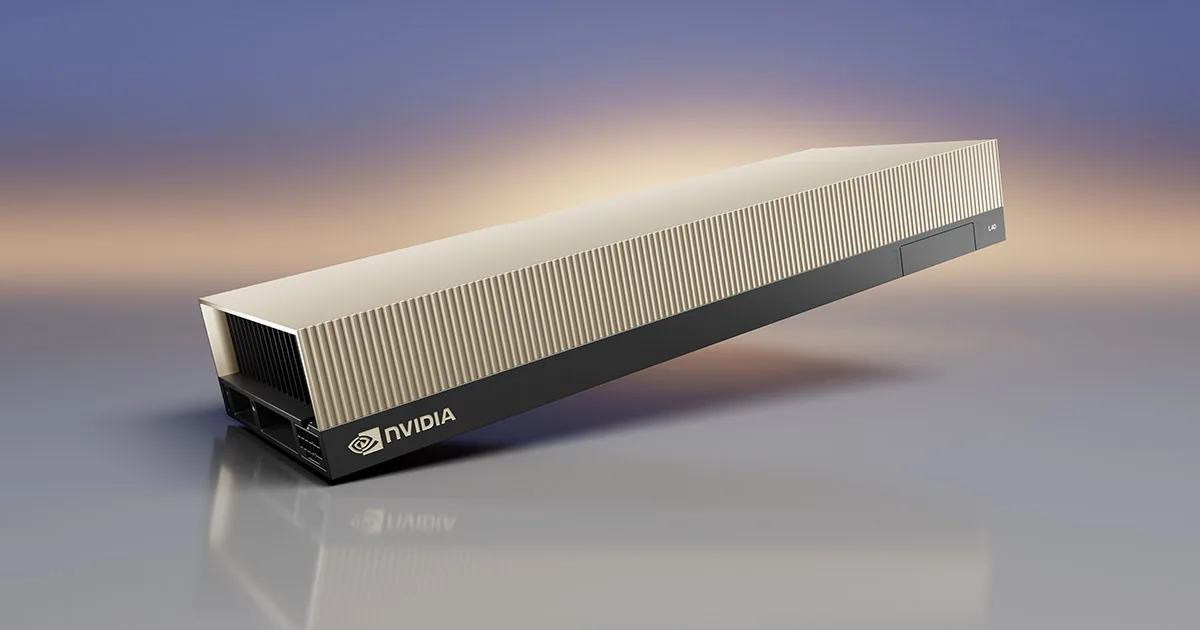
NVIDIA L4

GPU de perfil baixo para inferência e vídeo eficientes

Uma placa Ada Lovelace pequena e de baixo consumo para IA de vídeo, inferência e desktops virtuais, da edge ao centro de dados.

Para quem é indicado: Organizações que acrescentam IA a muitos servidores ou a locais na edge com orçamentos energéticos apertados

Benefícios

  • O baixo consumo e o perfil baixo permitem instalá-la em quase qualquer servidor
  • Muito adequada para análise de vídeo e inferência
  • Escala de forma económica por muitos nós

Especificações principais

ArquiteturaNVIDIA Ada Lovelace
Memória da GPU24 GB GDDR6
FormatoSingle-slot, low profile
ArrefecimentoPassive (server airflow)
InterfacePCIe

O que a Workstation faz: Verificamos a compatibilidade com os seus servidores existentes, fornecemos as placas e configuramos os drivers e o software de inferência.

Preço sob orçamentoPedir orçamento ↗
Ver em NVIDIA.com ↗

Rede

Plataforma Ethernet NVIDIA Spectrum-X

Ethernet otimizada para fábricas de IA

O Spectrum-X combina switches Ethernet Spectrum com SuperNICs Spectrum-X para dar aos clusters de IA uma Ethernet previsível e de alto débito.

Para quem é indicado: Organizações que querem uma malha de IA que a sua equipa de redes já sabe gerir

Benefícios

  • Largura de banda efetiva superior à da Ethernet padrão para tráfego entre GPUs
  • Usa ferramentas e competências Ethernet já conhecidas
  • Faz parte dos designs validados de fábricas de IA da NVIDIA

Especificações principais

TipoEthernet networking platform
ComponentesNVIDIA Spectrum Ethernet switches + Spectrum-X SuperNICs
Caso de utilizaçãoAI clusters and AI factories

O que a Workstation faz: Desenhamos a malha, fornecemos switches, SuperNICs e cabos, instalamo-la e testamo-la, e documentamo-la para a sua equipa.

Preço sob orçamentoPedir orçamento ↗
Ver em NVIDIA.com ↗

Rede

Plataforma NVIDIA Quantum-X800 InfiniBand

InfiniBand de nova geração para treino em grande escala

Os switches Quantum-X800 e as SuperNICs ConnectX-8 formam a malha InfiniBand de maior desempenho da NVIDIA para treino de IA e HPC.

Para quem é indicado: Centros de HPC e equipas de IA que treinam em grande escala

Benefícios

  • Latência muito baixa para tarefas fortemente acopladas
  • Concebida para os maiores clusters de treino e HPC
  • Gerida e monitorizada com UFM

Especificações principais

TipoInfiniBand networking platform
ComponentesNVIDIA Quantum-X800 InfiniBand switches + ConnectX-8 SuperNICs
Caso de utilizaçãoLarge-scale AI training and HPC

O que a Workstation faz: Desenhamos a topologia, fornecemos e cablamos todas as ligações e colocamos a malha em funcionamento com a monitorização UFM configurada.

Preço sob orçamentoPedir orçamento ↗
Ver em NVIDIA.com ↗

Rede

Switches Ethernet NVIDIA Spectrum

Switches Ethernet para centros de dados até 800 Gb/s

Os switches Spectrum transportam tráfego de IA, armazenamento e cloud, isoladamente ou como parte do Spectrum-X.

Para quem é indicado: Equipas de centro de dados e de redes que renovam a comutação leaf e spine

Benefícios

  • Velocidades de porta até 800 Gb/s
  • Funciona em malhas de IA e em redes gerais de centros de dados
  • Combina com o NetQ para operações de rede e telemetria

Especificações principais

TipoEthernet switch family
Velocidade de portaUp to 800 Gb/s
UtilizaçãoAI and cloud data-centre fabrics

O que a Workstation faz: Dimensionamos portas e ótica, configuramos os switches e integramo-los na sua rede existente.

Preço sob orçamentoPedir orçamento ↗
Ver em NVIDIA.com ↗

Rede

Switches NVIDIA Quantum InfiniBand

Comutação de baixa latência para HPC e IA

Os switches Quantum InfiniBand constroem as malhas de baixa latência de que os clusters de HPC e IA dependem.

Para quem é indicado: Equipas de computação científica e de IA com cargas de trabalho fortemente acopladas

Benefícios

  • Latência muito baixa entre nós
  • Comprovados em clusters de HPC e IA
  • Gestão centralizada com UFM

Especificações principais

TipoInfiniBand switch family
UtilizaçãoHPC and AI data centres

O que a Workstation faz: Planeamos a topologia, fornecemos cabos e ótica, e instalamos e verificamos a malha.

Preço sob orçamentoPedir orçamento ↗
Ver em NVIDIA.com ↗

Rede

NICs e SuperNICs NVIDIA ConnectX

Adaptadores de rede para Ethernet e InfiniBand

Os adaptadores ConnectX ligam os servidores à malha. As SuperNICs, como a ConnectX-8, estão otimizadas para o tráfego entre GPUs em clusters de IA.

Para quem é indicado: Qualquer pessoa que ligue servidores de GPU ou armazenamento a uma rede de alta velocidade

Benefícios

  • Uma única família abrange Ethernet e InfiniBand
  • As SuperNICs dão a cada GPU o seu próprio caminho de alta velocidade
  • A descarga por hardware reduz a carga do CPU

Especificações principais

TipoNetwork adapter and SuperNIC family
Malhas de redeEthernet and InfiniBand
Velocidade máxima800 Gb/s per GPU (ConnectX-8 SuperNIC)

O que a Workstation faz: Adequamos adaptadores, cabos e transceivers aos seus switches e servidores, e instalamos o firmware e os drivers.

Preço sob orçamentoPedir orçamento ↗
Ver em NVIDIA.com ↗

Rede

DPUs NVIDIA BlueField

Unidades de processamento de dados para rede, armazenamento e segurança

As DPUs BlueField retiram ao CPU do servidor o trabalho de rede, armazenamento e segurança e isolam-no em hardware dedicado.

Para quem é indicado: Construtores de cloud, fábricas de IA e organizações preocupadas com a segurança

Benefícios

  • Liberta núcleos de CPU para as aplicações
  • Isola os serviços de infraestrutura das cargas de trabalho dos inquilinos
  • Programáveis com NVIDIA DOCA

Especificações principais

TipoData processing unit (DPU) family
GeraçõesBlueField-3, BlueField-4
SoftwareNVIDIA DOCA

O que a Workstation faz: Fornecemos e instalamos placas BlueField e ajudamo-lo a implementar os serviços DOCA de que precisa.

Preço sob orçamentoPedir orçamento ↗
Ver em NVIDIA.com ↗

Software

NVIDIA AI Enterprise

Software com suporte para IA em produção

O conjunto de frameworks de IA, microsserviços NIM e ferramentas da NVIDIA, com suporte empresarial e ramos de versão de longa duração.

Para quem é indicado: Qualquer organização que execute IA em produção em GPUs NVIDIA

Benefícios

  • Suporte empresarial e ramos de versão estáveis
  • Os microsserviços NIM tornam os modelos mais rápidos de implementar
  • Funciona em sistemas NVIDIA-Certified on-premises ou na cloud

Especificações principais

LicenciamentoPer GPU subscription
IncluiAI frameworks, NIM microservices, pretrained models
SuporteNVIDIA Enterprise Business Standard Support
Versão de avaliação90-day evaluation

O que a Workstation faz: Orçamentamos e ativamos as licenças, instalamos o software com o seu hardware e lembramo-lo antes da renovação.

Preço sob orçamentoPedir orçamento ↗
Ver em NVIDIA.com ↗

Software

NVIDIA Mission Control

Software de operações para fábricas de IA

O Mission Control automatiza a gestão diária de grandes clusters de GPUs, da orquestração de cargas de trabalho às verificações de estado e à recuperação.

Para quem é indicado: Operadores de DGX SuperPOD e de outros grandes clusters de IA

Benefícios

  • Automatiza as operações de rotina do cluster
  • Melhora a resiliência ao detetar falhas e recuperar delas
  • Uma visão única das cargas de trabalho e da infraestrutura

Especificações principais

TipoAI-factory operations and cluster management software
FunçõesWorkload orchestration, infrastructure resiliency, cluster automation
Base de licenciamentoConfirmed on quote

O que a Workstation faz: Implementamos o Mission Control com o seu cluster e formamos os seus operadores para o utilizarem.

Preço sob orçamentoPedir orçamento ↗
Ver em NVIDIA.com ↗

Software

NVIDIA Run:ai

Orquestração e agendamento de GPUs

O Run:ai agrupa GPUs entre equipas e atribui-as a pedido, para que o hardware dispendioso se mantenha ocupado em vez de parado.

Para quem é indicado: Organizações que partilham GPUs entre muitos cientistas de dados ou projetos

Benefícios

  • Maior utilização das GPUs graças ao agrupamento dinâmico
  • Quotas, prioridades e controlo de acesso para uma partilha justa
  • Funciona em ambientes on-premises, híbridos e na cloud

Especificações principais

TipoGPU orchestration and scheduling platform
Funciona emKubernetes
ImplementaçãoOn premises, hybrid or cloud
Base de licenciamentoConfirmed on quote

O que a Workstation faz: Instalamos o Run:ai no seu cluster Kubernetes, definimos quotas com as suas equipas e damos suporte.

Preço sob orçamentoPedir orçamento ↗
Ver em NVIDIA.com ↗

Software

NVIDIA Base Command Manager

Aprovisionamento e monitorização de clusters

O Base Command Manager aprovisiona, monitoriza e gere clusters de GPUs, a partir de um punhado de nós.

Para quem é indicado: Equipas de TI que gerem clusters de GPUs de qualquer dimensão

Benefícios

  • Automatiza o aprovisionamento em Arm e x86
  • Painéis de estado e monitorização em tempo real
  • Interface web, linha de comandos e API

Especificações principais

TipoCluster management software
Licença gratuitaUp to 8 accelerators per system
Versão atualBase Command Manager 11
InterfacesBaseView web UI, CLI, API

O que a Workstation faz: Instalamos e configuramos o Base Command Manager como parte dos clusters que construímos.

Preço sob orçamentoPedir orçamento ↗
Ver em NVIDIA.com ↗

Software

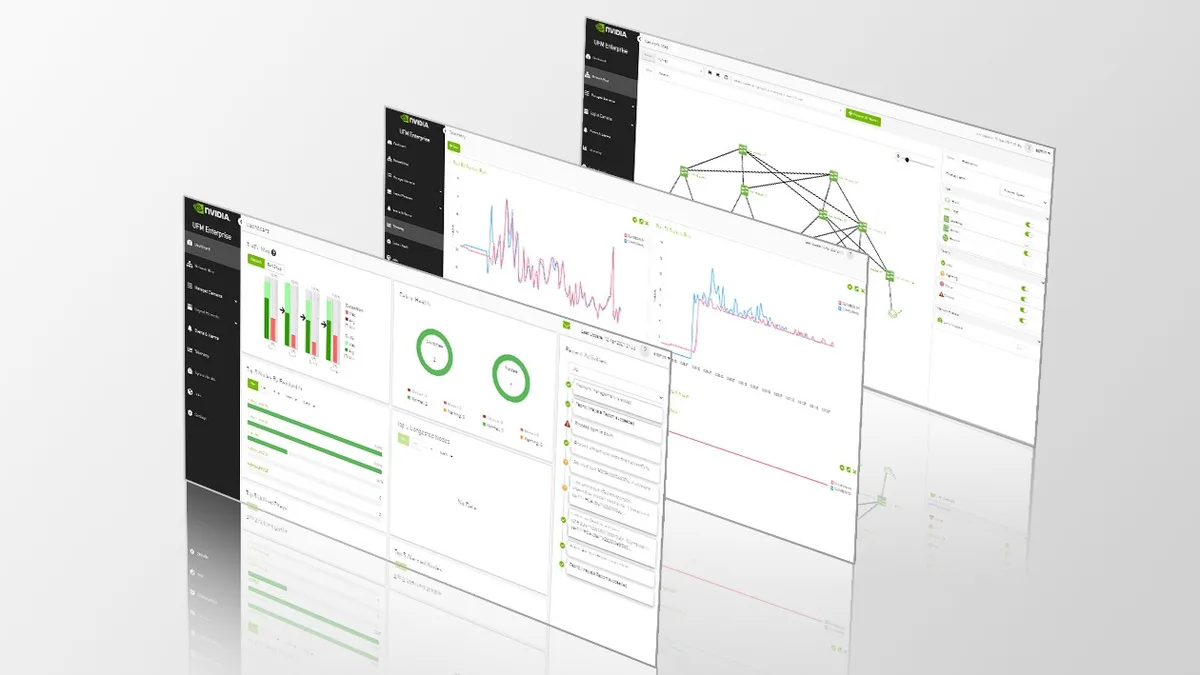
NVIDIA UFM

Unified Fabric Manager para InfiniBand

O UFM monitoriza e gere malhas InfiniBand e ajuda a resolver problemas.

Para quem é indicado: Equipas que gerem clusters InfiniBand

Benefícios

  • Telemetria da malha em tempo real
  • Deteção de avarias mais rápida
  • Gestão centralizada de switches e ligações

Especificações principais

TipoInfiniBand fabric management and telemetry software
Funciona comNVIDIA Quantum InfiniBand switches

O que a Workstation faz: Implementamos o UFM com a sua malha e configuramos alertas que correspondem aos seus procedimentos operacionais.

Preço sob orçamentoPedir orçamento ↗
Ver em NVIDIA.com ↗

Software

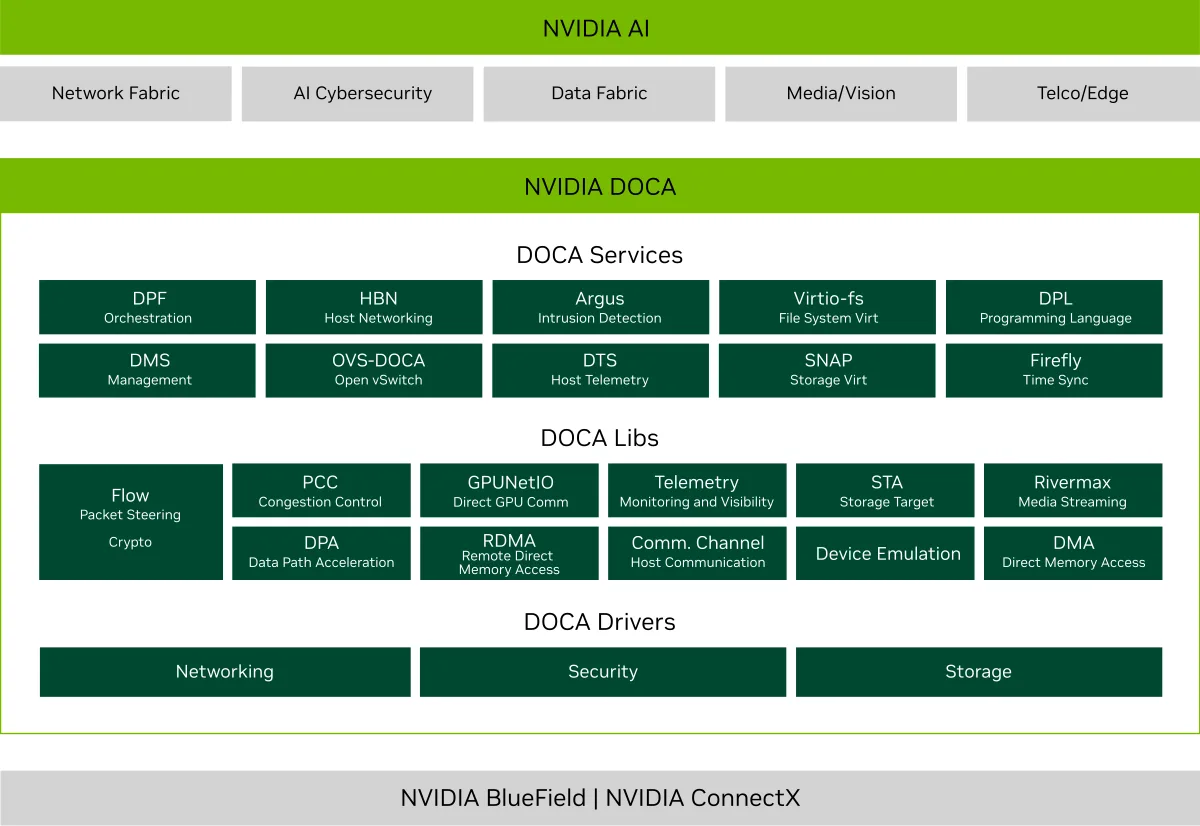
NVIDIA DOCA

Framework de software para BlueField e SuperNICs

O DOCA é o SDK e o runtime para criar serviços que correm em DPUs BlueField e SuperNICs.

Para quem é indicado: Programadores e equipas de plataforma que desenvolvem sobre BlueField

Benefícios

  • Um único framework para todas as gerações de DPU e SuperNIC
  • Acelera o desenvolvimento de serviços descarregados
  • Um runtime para implementar esses serviços em produção

Especificações principais

TipoSDK and runtime framework
Funciona emNVIDIA BlueField DPUs and SuperNICs

O que a Workstation faz: Ajudamos a configurar ambientes DOCA e implementamos serviços nas placas BlueField que fornecemos.

Preço sob orçamentoPedir orçamento ↗
Ver em NVIDIA.com ↗

As especificações são um resumo da informação publicada pela NVIDIA e podem mudar entre revisões. Os valores marcados como sparse pressupõem esparsidade. Confirmamos a configuração exata, o preço e o prazo de entrega em cada orçamento.

O que a Workstation faz em cada encomenda

Os mesmos cinco passos, quer compre uma GPU ou uma fila inteira de racks

Dimensionamento

Partimos dos seus modelos, dados, utilizadores e instalações e depois dimensionamos a computação, a memória, a rede, a energia e o arrefecimento.

Fornecimento

Adquirimos através da NVIDIA e dos seus parceiros de servidores, confirmamos os prazos de entrega e mantemo-lo informado até à entrega.

Montagem e burn-in

Os sistemas são montados, recebem a imagem de software e são submetidos a testes de stress a plena carga na nossa oficina no Reino Unido antes de serem expedidos.

Instalação

Os nossos engenheiros entregam, montam no rack, fazem a cablagem e comissionam nas suas instalações, e entregam tudo com documentação.

Suporte

A mesma equipa trata de problemas de software, upgrades, renovações de licenças e pedidos de garantia.

Todas as categorias NVIDIA

Adesão Trade

Os membros Trade recebem suporte técnico gratuito em cada encomenda e tempo de engenharia ilimitado — ajuda com configuração, drivers, software e resolução de problemas, durante todo o tempo em que tiver o equipamento.

Conhecer a adesão Trade

NVIDIA Blackwell, do chip ao centro de dados

NVIDIA Blackwell: The Journey From Die to Data Center. Reproduzido a partir do canal oficial da NVIDIA no YouTube. Ver no YouTubeNVIDIA, Blackwell, DGX, Grace e RTX PRO são marcas comerciais e/ou marcas registadas da NVIDIA Corporation. São apresentadas para descrever os produtos que fornecemos; não implicam qualquer aprovação da NVIDIA.

See the NVIDIA RTX PRO 6000 Blackwell Server Edition

NVIDIA RTX PRO: AI and visual computing on the RTX PRO 6000 Blackwell Server Edition. Video: NVIDIA Corporation. Reproduzido a partir do canal oficial da NVIDIA no YouTube. Ver no YouTubeRead about the RTX PRO 6000 Server Edition →NVIDIA, RTX PRO and Blackwell are trademarks and/or registered trademarks of NVIDIA Corporation. Shown to describe the products we supply; no endorsement by NVIDIA is implied.

Perguntas frequentes

Porque é que tudo tem preço sob orçamento?

Os preços e as alocações de computação acelerada mudam depressa, e a maioria das encomendas depende da configuração exata, das instalações e do software. Um orçamento permite-nos confirmar o preço atual, a disponibilidade e o prazo de entrega daquilo de que realmente precisa.

Podem fornecer uma única GPU em vez de um sistema completo?

Sim. Fornecemos GPUs individuais para centros de dados, mas verificamos sempre se o seu servidor está certificado para as alimentar e arrefecer, e podemos instalá-las e testá-las por si.

Instalam sistemas à escala de rack e com refrigeração líquida?

Sim. Para sistemas como o GB300 NVL72, trabalhamos com a sua equipa de instalações na energia, no arrefecimento e na carga do pavimento muito antes da entrega, e depois instalamos e comissionamos nas suas instalações.

Com que plataforma NVIDIA devemos começar?

Depende dos seus modelos, utilizadores e instalações. Muitas equipas começam com o RTX PRO Server ou a L40S para IA e gráficos combinados e passam para HGX ou DGX para treino em grande escala. Fale com um engenheiro e recomendaremos um ponto de partida.

Planeie o seu projeto de computação acelerada NVIDIA

Diga-nos o que precisa de executar e onde tem de ficar. Um engenheiro responderá com uma configuração recomendada e um orçamento.

Fale com um engenheiro