
Muse Glimmer é o modelo de linguagem causal de 30 bilhões de parâmetros da Meta com um codificador de percepção dedicado, destilado do Muse Spark e publicado para cargas de trabalho de agente autônomo em hardware de consumidor e estação de trabalho. Distribuído via Ollama sob Apache 2.0, ele visa o uso confiável de ferramentas, tarefas de longo prazo, compreensão multimodal e recuperação de falhas, sem exigir inferência na nuvem. Este resumo técnico do Workstation reescreve e expande o cartão de modelo público para engenheiros que enviam agentes locais.
- Aula: 30B causal LM + codificador de percepção; destilado de Muse Spark; visão + ferramentas + pensamento.
- Servir:
ollama run muse-glimmer(~18GB, 128K, texto+imagem); Apple Silicon:muse-glimmer:30b-mlx(~21GB, DFlash). - Ajustar: agentes locais/air-gapped sempre ativos em um GPU ou Mac Silicon — não um modelo de cluster MoE de vários TB.
- Sinal de força: lidera a matriz de classe de tamanho relatada pela Meta em MCP-Atlas, DeepSearch QA, WildClawBench, SWE-Bench Pro, AA-LCR, Beam128K (alto raciocínio).
- Operações: andaime via
ollama launch(Claude Code, OpenCode, Hermes, OpenClaw); governar com avaliações, HITL, autenticação MCP.
Fontes primárias: Biblioteca Ollama – muse-glimmer; Metodologia de metaavaliação - Metodologia Muse Glimmer. Números e tags mudam; verifique o cartão do modelo ao vivo antes da aquisição.
1. Intenção de arquitetura e design
Muse Glimmer não está posicionado como um MoE de bate-papo geral. O enquadramento de Meta é conclusão de tarefa de agente de ponta a ponta em hardware que você pode comprar para uma mesa ou um pequeno rack de laboratório:
- Estrutura LM causal (30B) — próxima geração de tokens com cadeias de raciocínio de várias etapas sustentadas em longos fluxos de trabalho.
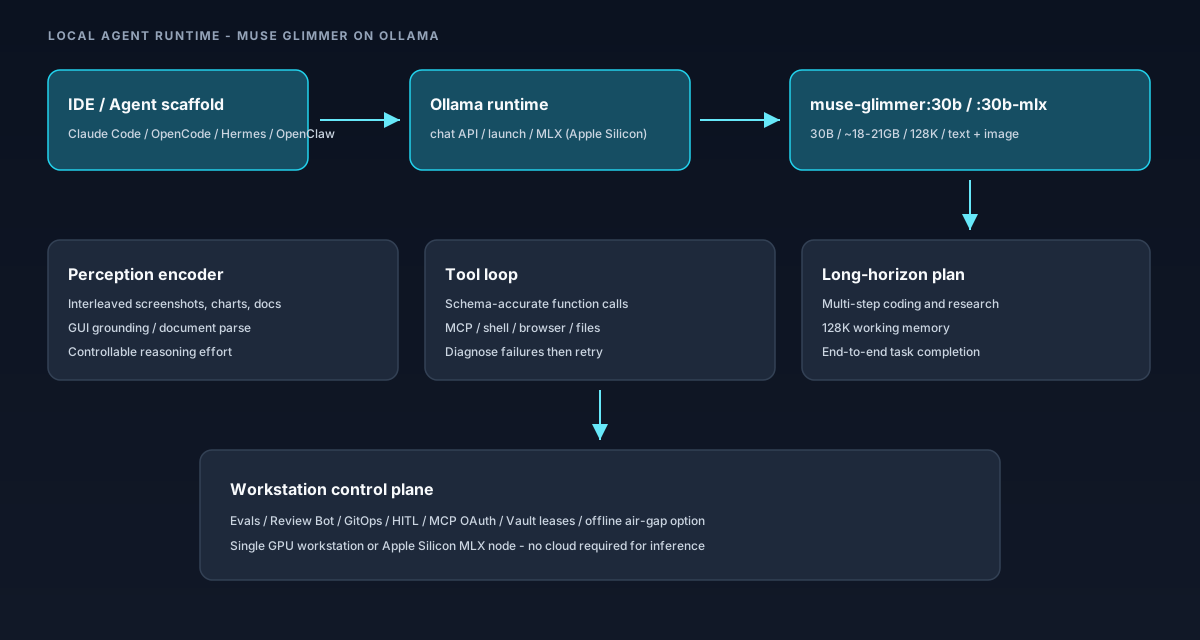
- Codificador de percepção dedicado — aceita texto e imagens intercalados para que os agentes possam raciocinar sobre capturas de tela, gráficos e documentos na mesma janela de contexto das transcrições da ferramenta.
- Destilação de Muse Spark — transferência de capacidade para um espaço que visa implantação de GPU único/classe de consumidor, em vez de atendimento apenas em datacenter.
- Comportamento de recuperação de falhas — quando uma chamada de ferramenta falha ou retorna uma carga inesperada, o modelo é treinado/ajustado para diagnosticar e tentar novamente, em vez de interromper o episódio.
- Esforço controlável — a força do raciocínio é selecionável para que os operadores possam trocar a latência pela qualidade por rota.
- Cobertura de treinamento multilíngue — Meta indica dados de treinamento de mais de 100 idiomas.
Para pilhas Workstation, a implicação do produto é: trate o Glimmer como um cérebro de tempo de execução do agente por trás de ferramentas MCP, shells, navegadores e editores de arquivos - não como um substituto imediato para todas as chamadas API de fronteira fechada.
2. Distribuição Ollama (tags, pegada, E/S)
Conforme publicado no cartão da biblioteca Ollama (verifique os tamanhos em tempo real):
| Marcação | Aprox. tamanho | Contexto | Entrada | Notas |
|---|---|---|---|---|
muse-glimmer:latest / :30b | ~18GB | 128K | Texto, Imagem | Caminho GPU único padrão |
muse-glimmer:30b-mlx | ~21GB | 128K | Texto, Imagem | Motor Ollama MLX; DFlash + imagem em Apple Silicon |
# Pull + interactive
ollama run muse-glimmer

# Apple Silicon (MLX)
ollama run muse-glimmer:30b-mlx

# HTTP chat (localhost Ollama)
curl http://localhost:11434/api/chat \
  -d '{"model":"muse-glimmer","messages":[{"role":"user","content":"Hello!"}]}'

# Scaffold launchers (from Ollama applications list)
ollama launch claude --model muse-glimmer
ollama launch opencode --model muse-glimmer
ollama launch hermes --model muse-glimmer
ollama launch openclaw --model muse-glimmer
Os clientes Python/JS devem fixar a tag que você validou (muse-glimmer contra :30b-mlx) na configuração, não no código rígido latest em agentes de produção.
3. Superfície de capacidade (leitura de engenharia)
- Conclusão de agente ponta a ponta - Meta cita bons resultados em tarefas da família DeepSearch QA, MCP-Atlas, τ3-Bench (bancário) e SWE-Bench que medem o sucesso de múltiplas voltas do andaime, e não curiosidades de tiro único.
- Uso confiável de ferramentas — ampla cobertura de chamadas de função com precisão de esquema em fluxos de trabalho estendidos (crítico para frotas de ferramentas MCP).
- Raciocínio em várias etapas — planejar a coerência em horizontes longos; emparelha com a janela de contexto de 128K para retenção de transcrição + documento.
- Recuperação de falhas — diagnosticar resultados inesperados da ferramenta e tentar novamente; reduz abortos por “agentes frágeis” em trabalhos noturnos.
- Raciocínio multimodal - o codificador de percepção permite captura de tela/gráfico/documento intercalado com texto (base de GUI e bancos de análise de documentos incluídos na matriz do Meta).
- Compatibilidade de andaime — OpenClaw, Hermes Agent e padrões de orquestração semelhantes; Ollama lista os inicializadores Claude Code e OpenCode como aplicativos de primeira classe.
4. Matriz de referência (meta-relatado, raciocínio elevado)
Meta compara Muse Glimmer-30B (alto raciocínio) com Gemma4-31B e Qwen3.6-27B no modo de pensamento. Leitura do título Workstation: Glimmer lidera vários agente suítes públicas (MCP-Atlas, DeepSearch QA, WildClawBench, Gaia2, SWE-Bench Pro) enquanto rastreia ou vincula pares em algumas métricas de agente de desktop e valor de PIB. Sempre execute novamente seu aproveitar.
| Categoria | Referência | Brilho-30B | Gema4-31B | Qwen3.6-27B |
|---|---|---|---|---|
| Agente geral | MCP-Atlas (público) | 75.5 | 54.2 | 62.5 |
| Controle de qualidade do DeepSearch | 74.6 | 61.7 | 71.1 | |
| τ3-Banco | 23.5 | 15.1 | 16.7 | |
| Banco WildClaw | 47.6 | 37.6 | 43.2 | |
| PIBVal-AA v2 | 953 | 811 | 1141 | |
| Gaia2 | 43.3 | 36.4 | 40.0 | |
| SkillsBench (com habilidades) | 44.3 | 32.4 | 46.6 | |
| Verificado pelo OSWorld | 65.9 | 58.5 | 75.6 | |
| Codificação agente | SWE-Bench Pró | 51.2 | 36.9 | 50.2 |
| SWE-Bench verificado | 76.0 | 66.6 | 77.2 | |
| TerminalBench 2.1 | 51.7 | 43.4 | 60.7 | |
| SciCode | 43.6 | 43.4 | 39.8 | |
| Multimodal | Raciocínio CharXiv | 78.8 | 77.7 | 78.4 |
| TelaSpot Pro | 75.4 | 75.9 | 76.1 | |
| OmniDocBench v1.5 | 75.8 | 72.5 | 77.8 | |
| MMMU Pro | 74 | 73 | 75 | |
| Raciocínio / LCR | Banco IFB | 77.0 | 76.0 | 70.8 |
| AIME 2026 | 94.7 | 89.2 | 94.1 | |
| Diamante GPQA (AA) | 83.5 | 85.7 | 84.2 | |
| Texto HLE (AA) | 22.0 | 23.6 | 23.1 | |
| AA-LCR | 80.0 | 68.3 | 73.3 | |
| Feixe128K | 65.1 | 58.2 | 63.0 |
Bancos de segurança (CI Memories, Siren AgentDojo) mostram compensações: Glimmer relata alta utilidade sob injeções de AgentDojo com ASR mid-pack; trate a segurança como um problema de controle de implantação (firewalls de prompt, listas de permissões de ferramentas, HITL) — e não uma propriedade de modelo resolvida. Consulte o PDF da metodologia Meta para modelos de juízes, contagens de tentativas e advertências de aproveitamento.
5. Metodologia de avaliação (o que significam os números)
A nota metodológica do Meta é essencial antes de você citar qualquer célula em um deck de tabuleiro:
- Seleção de pares: modelos abertos de classe de tamanho (Gemma4-31B, Qwen3.6-27B); os pares podem usar pontuações auto-relatadas ou reproduzidas internamente; Análise Artificial usada quando disponível para todos os três.
- Amostragem: Glimmer relatou alta força de raciocínio com temperatura = 1,0 / top_p = 0,95 / top_k = 64; os pares usam configurações de pensamento recomendadas pelo fornecedor (Qwen usa temperaturas mais baixas em alguns bancos de agentes).
- Advertência sobre polarização do chicote de fios: Meta observa que modelos de terceiros podem não ser ajustados aos prompts de ferramenta/sistema do Meta – as classificações absolutas podem mudar em andaimes nativos de pares.
- MCP-Atlas: uso de ferramentas multivoltas em mais de 20 servidores MCP; Taxa de aprovação do juiz LLM (limite de 0,75) em 500 tarefas públicas, com média de 4 execuções.
- Controle de qualidade do DeepSearch: loop de navegação autônomo (pesquisar/abrir/encontrar) em 900 questões de pesquisa difíceis; F1 via extração de juiz.
- Banco WildClaw/Gaia2: tarefas de agentes Dockerizados de longo horizonte sob chicotes estilo OpenClaw com injeção de eventos e classificação mista determinística/LLM.
- SWE-Bench: bash + estrutura de ferramentas de arquivo; Média Pro e Verificada em várias execuções – As comparações Pro evitam a variante de tarefa refinada de Qwen.
- Verificado pelo OSWorld: Controle Ubuntu VM somente GUI a partir de capturas de tela (sem shell direto); as diferenças no espaço de ação entre os modelos são importantes.
- Feixe128K: sondagem de memória de contexto longo não agente em 128K — relevante se você mantiver transcrições grandes no contexto sem RAG.
Política Workstation: publique a matriz do Meta para orientação e, em seguida, bloqueie a produção em um conjunto dourado interno (suas ferramentas MCP, seus repositórios, seu SLO de latência).
6. Hardware e serviço à realidade
- Classe GPU única: A pegada de peso ~18GB implica um 24GB+ moderno para consumidor/profissional. GPU é o piso prático da NVIDIA, uma vez que o cache KV e as ativações de visão são consideradas; perfil com seu contexto máximo e sessões simultâneas.
- Apple Silicon: prefiro
:30b-mlx(~21GB) para o caminho MLX do Ollama com decodificação especulativa DFlash e entrada de imagem nativa – as configurações Mac Studio / Mac mini Max são nós SME de primeira classe. - Não é classe Kimi-K3: este não é um MoE de vários nós. Se você precisar de agentes abertos com trilhões de parâmetros, consulte nosso guia de pesos abertos; Glimmer possui o sempre ligado na mesa nicho.
- Kubernetes: empacotar Ollama ou um sidecar compatível com OpenAI por nó; mantenha pulls de modelo em seu registro/cache privado; não exponha o Ollama não vinculado à Internet.
7. Segurança e governança para agentes sempre ativos
Os pesos locais reduzem a saída de dados, mas aumentam o raio de explosão de um host de agente comprometido. Linha de base mínima do Workstation:
- MCP OAuth 2.1 + segredos de curta duração (locações do Vault) — consulte artigo de segurança de agente.
- Listas de permissões de ferramentas e políticas de saída de rede por identidade de agente.
- O HITL bloqueia ações irreversíveis (pagamentos, implantações de produtos, e-mail em massa).
- Monitoramento de injeção de prompt em conteúdo retornado por ferramenta (modelo de ameaça estilo Siren AgentDojo).
- Modo offline / air-gap testado como um runbook de primeira classe, não uma esperança.
8. Lista de verificação de produção
- Fixar etiqueta Ollama (
30bcontra30b-mlx) e registre resumo/hash no GitOps. - Crie um conjunto dourado de 20 a 50 tarefas que espelhe suas ferramentas MCP e fluxos de trabalho de codificação; rastreie a latência pass@1 e p95 em cada nível de esforço.
- Andaime de arame (
ollama launch …ou personalizado) com registro estruturado de chamadas de ferramenta e novas tentativas. - Definir roteador híbrido: Glimmer local para RAG/agentes privados; failover na nuvem para overflow/pico de QI.
- Documente espaço de VRAM/memória unificada em 32K/64K/128K com visão ativada.
- Legal: revisão Apache 2.0 para seu modelo de distribuição (geralmente licenças abertas simples versus restritivas).
- Enviar bot de revisão + portões de avaliação antes de habilitar agentes noturnos autônomos.
Publicado por Workstation. Cartão modelo: ollama.com/library/muse-glimmer.


