Desempacotando Mac Studio M4 e executando seu primeiro LLM
Leituras reais do mactop em um novo M4 Max, instalação do Ollama, Llama 3 localmente e um pipeline RAG privado em uma tarde
 Balinder Walia15 de maio de 20265 min read

Um companheiro curto e de fácil leitura para o mergulho profundo e longo. Para o passo a passo completo, vá para o longo artigo.
A caixa na mesa agora é um aparelho de IA
Desembalei um novo Mac Studio com o chip M4 Max, 128 GB de memória unificada, 40 núcleos GPU, 16 núcleos CPU e um SSD de 2 TB. Em uma tarde, ele estava executando o Llama 3.1 8B localmente via Ollama, incorporando meus próprios documentos e respondendo perguntas sobre eles por meio de um pequeno pipeline RAG. Nenhuma conta de nuvem, nenhuma chave API, nenhum dado saindo da sala.
Este blog é a versão curta. O artigo completo aborda detalhadamente o mesmo fluxo de trabalho.
O unboxing em 60 segundos
Assista ao curta de unboxing no YouTube: https://youtube.com/shorts/HUlUoHNsyNM
Unboxing clássico da Apple: papelão mínimo, a máquina em um recesso moldado, um cabo de alimentação. O gabinete Mac Studio tem aproximadamente 7,7 polegadas quadradas e é denso; você sente a qualidade de construção no momento em que o pega. A configuração é genuinamente rápida - Apple ID, idioma, FileVault, pronto.
Primeira inicialização - leituras reais do mactop
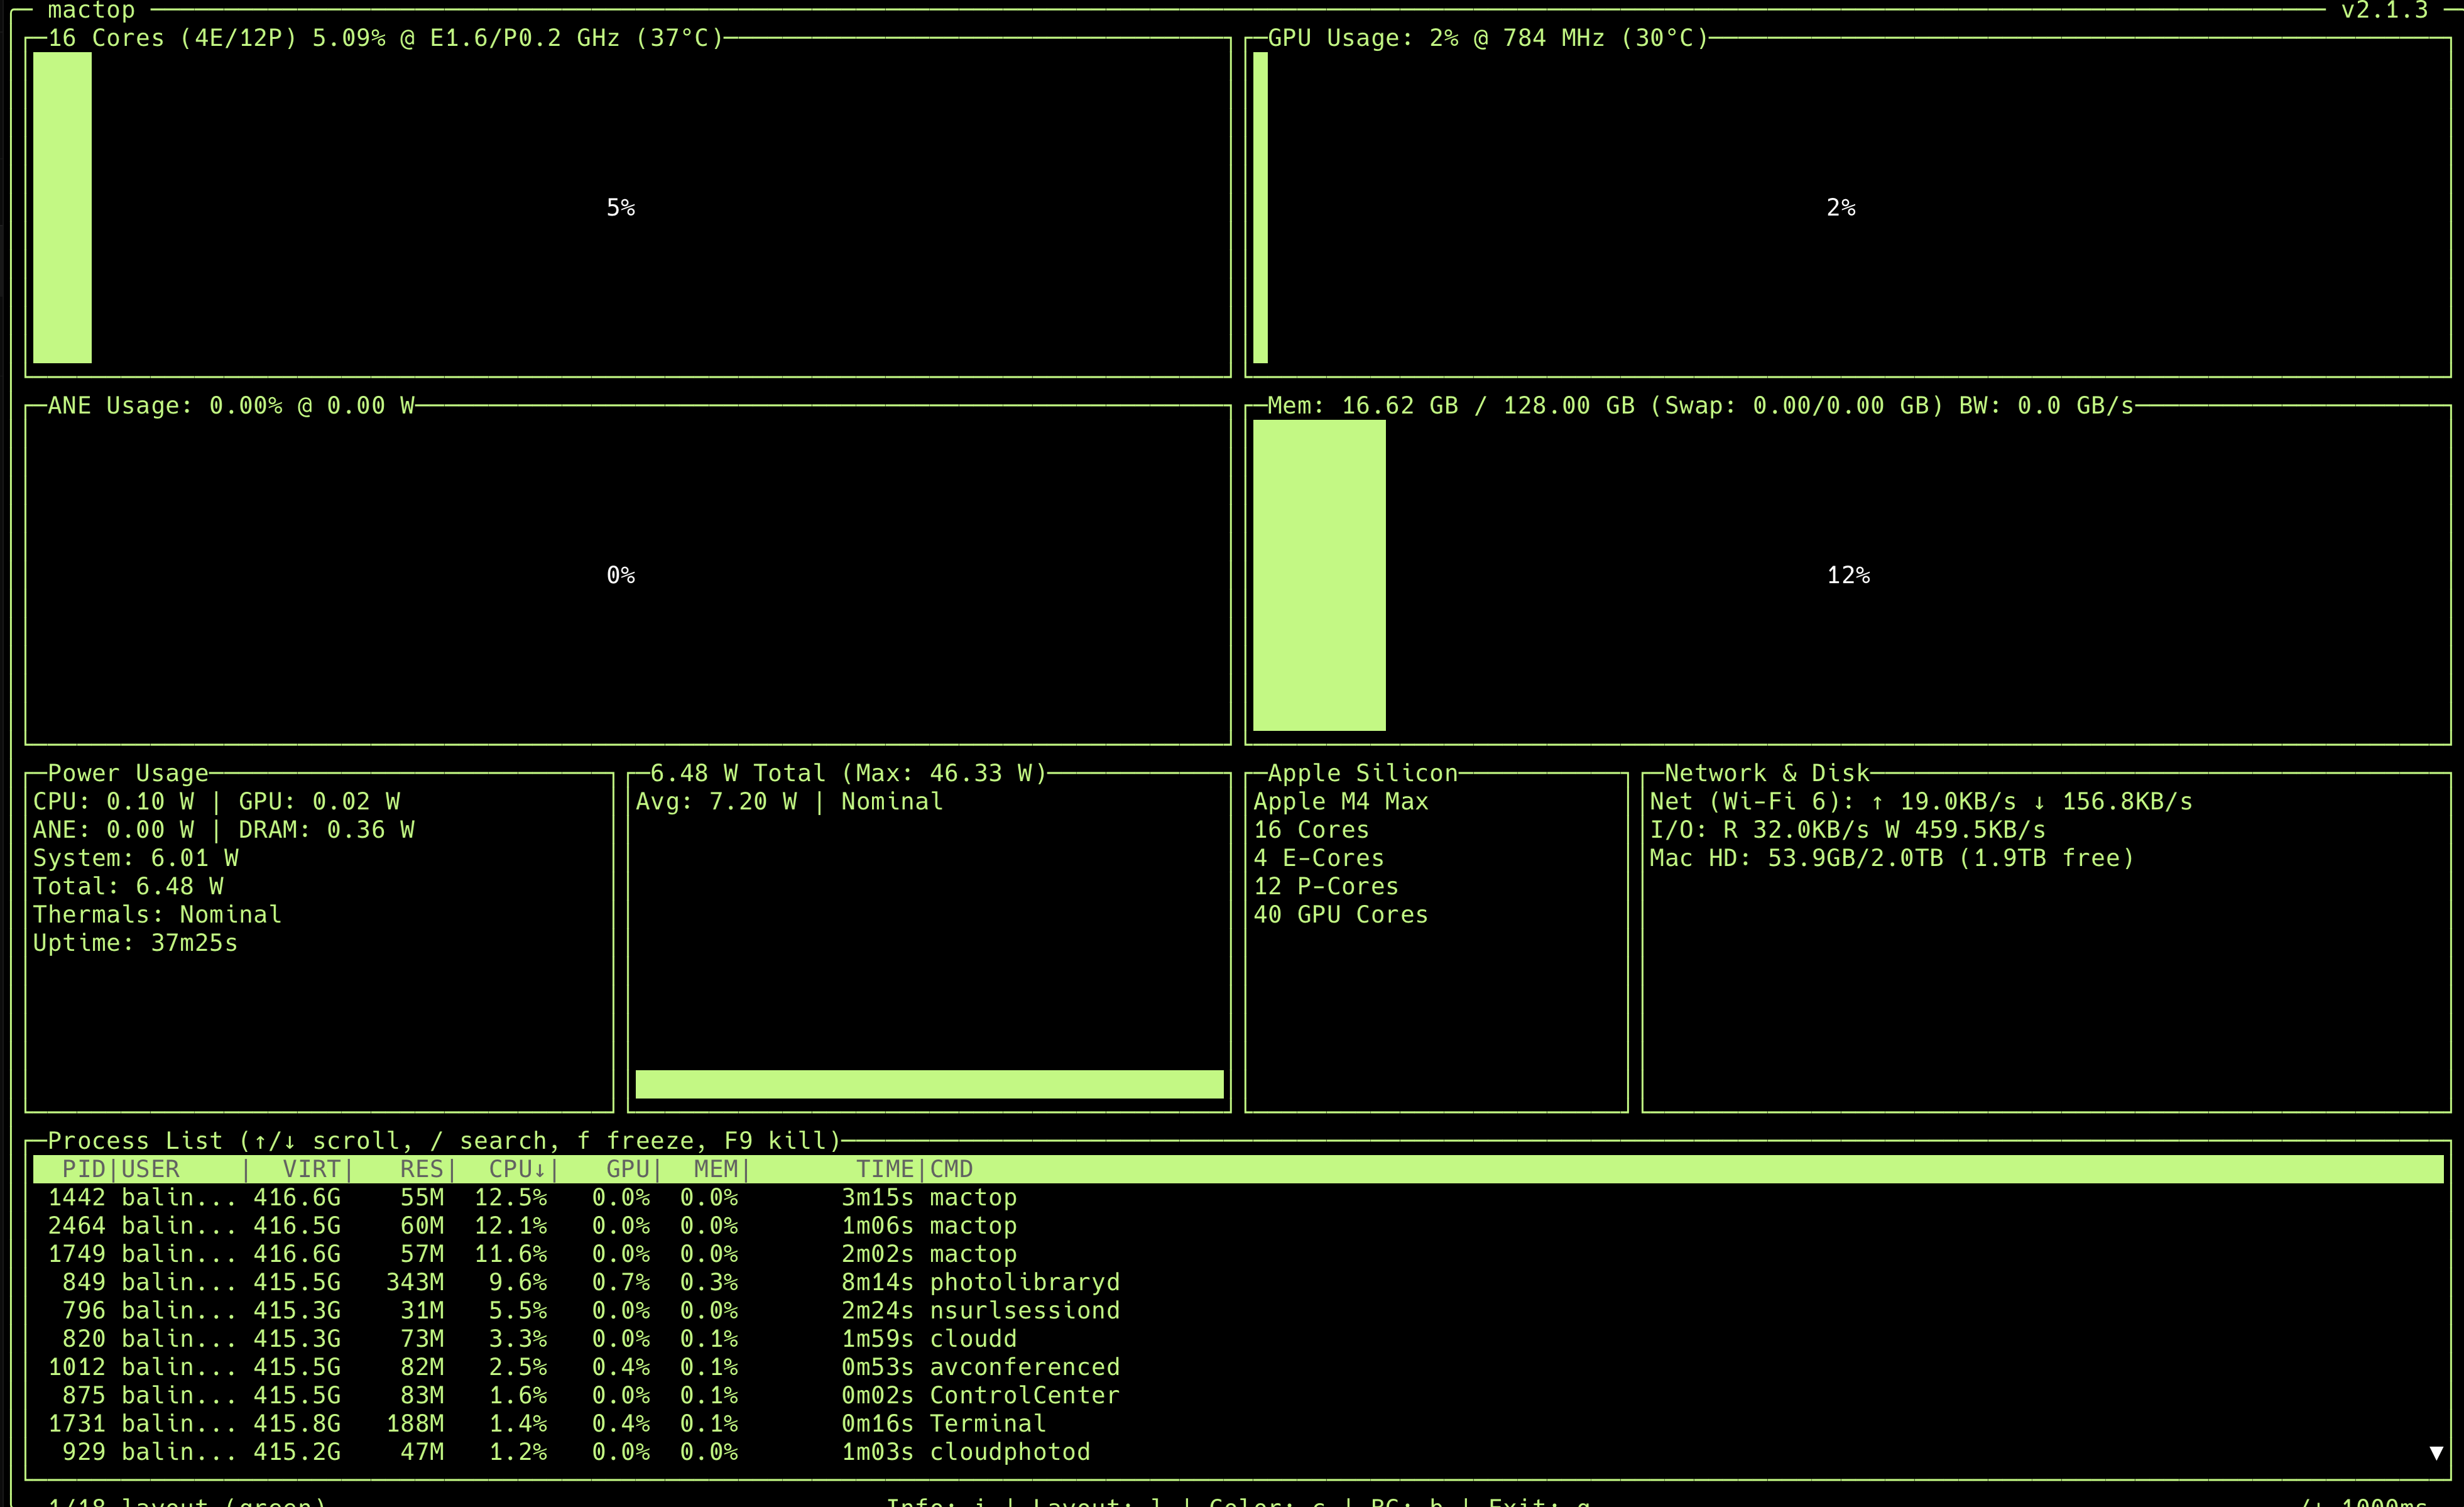
/img/mac-studio-mactop-firstboot.png para trocá-lo mais tarde.Os números acima são os únicos números concretos que citarei. Eles são a verdade fundamental de mactop na minha máquina com 37 minutos de atividade:
- M4 Max - 16 núcleos (4 E + 12 P), 40 núcleos GPU a 784 MHz, ANE de 16 núcleos.
- Memória unificada 128 GB - 16,62 GB em uso em modo inativo (cerca de 13%).
- 6,48W potência ociosa total, 46,33 W máx. observado. Térmicas: Nominais.
- SSD de 2TB, 1,9 TB grátis após a configuração inicial.
6,48 W em modo inativo para um desktop com 128 GB de memória utilizável é o número principal para mim. Esta caixa é realmente um aparelho de IA sempre ligado e de baixo consumo de energia que você pode deixar funcionando 24 horas por dia, 7 dias por semana, sem se preocupar com a conta de luz.
Por que este hardware é especial – memória unificada em um parágrafo
Em um PC tradicional, sua CPU possui RAM de sistema e sua GPU possui VRAM separada. Um modelo deve ser copiado através do PCIe antes que o GPU possa executá-lo; se o modelo for maior que VRAM, ele não cabe. No Apple Silicon, o CPU, o GPU, o Neural Engine e os mecanismos de mídia compartilham um Conjunto 128 GB. Nada é copiado. Um LLM de parâmetro 70B em Q4_K_M (cerca de 40 GB em disco, estimativa pública) é carregado com cerca de 80 GB ainda livres para contexto, aplicativos e ferramentas. É por isso que os LLMs locais parecem diferentes em um Mac.
Da caixa ao primeiro LLM em três comandos
brew install ollama
ollama serve &
ollama run llama3.1:8b "Explain unified memory in 3 sentences."
Essa é realmente toda a discussão. A primeira execução baixa o modelo (Llama 3.1 8B Q4_K_M tem cerca de 4,7 GB no disco, estimativa pública) e carrega-o na memória unificada. Depois disso, o streaming de conversação é suave, com um atraso perceptível no primeiro token e uma saída constante através da resposta. Deliberadamente, não estou publicando aqui números de tokens por segundo sem uma metodologia de benchmark adequada; o longo artigo entra no raciocínio.
RAG local em menos de 60 linhas de Python
A coisa mais útil que você pode fazer com um LLM local é apontá-lo para seus próprios documentos. A pilha mínima viável é:
- PyMuPDF ou
unstructuredpara análise - nomic-embed-text via Ollama para incorporações
- ChromaDB para o armazenamento de vetores
- Llama 3.1 8B via Ollama para geração
O código completo está no artigo longo. A manchete é: tudo roda no Mac Studio, sem chaves API externas, sem cobrança por token, sem saída de dados da máquina.
Mac Studio vs nuvem – a matriz de decisão honesta
O Mac Studio vence por: inferência privada sempre ativa, RAG em seus próprios dados, copilotos IDE, prototipagem de agentes, aprendizado da pilha e laboratórios domésticos. A nuvem vence em: trabalhos de treinamento intensivo, serviço de produção superior a 70 bilhões em escala, tráfego global imprevisível e cargas de trabalho que precisam de paralelismo 8x A100/H100. A maioria das equipes acabará usando ambos. O longo artigo possui uma matriz de decisão completa como SVG.
Cinco aulas depois de uma semana
- A privacidade abre novos casos de uso. Quando o modelo é local, colo registros de produção, documentos internos e e-mails de clientes sem hesitar. Isso muda a forma como eu trabalho.
- O custo por consulta é psicológico e também financeiro. Nenhuma conta significa mais consultas, mais experimentos, mais curiosidade.
- 128 GB é o ponto ideal. 64 GB é a base para trabalhos sérios. 128 GB oferece espaço para rodar 70B em Q4_K_M e ainda ter espaço para todo o resto.
- Ollama é a rampa de acesso fácil. LM Studio é ótimo como navegador modelo, MLX é ótimo se você está começando do zero em Python, llama.cpp sustenta tudo.
- A nuvem não está morta. Ainda é a ferramenta certa para treinamento, serviço de expansão e cargas de trabalho de carga desconhecida.
O que vem a seguir
Artigos futuros cobrirão o ajuste fino do MLX no Apple Silicon, clusters de inferência multi-Mac com EXO, pilhas de agentes (LangGraph + Ollama) e uma metodologia de benchmark mais profunda. Se você quiser a versão longa com todos os diagramas, código e matriz de decisão, leia o longo artigo. Se você quiser a versão visual, assista ao Curta do YouTube. De qualquer forma - inscreva-se para o resto da série.