Este é o mergulho profundo de formato longo. Para uma versão mais rápida e legível, consulte o postagem complementar no blog.
1. Introdução: por que um Mac Studio para IA local?
A IA local não é mais uma curiosidade de hobby. Com modelos de peso aberto da Meta, Mistral, Qwen e Microsoft amadurecendo rapidamente e a memória unificada do Apple Silicon ultrapassando o limite de 128 GB, agora você pode executar modelos de linguagem grandes, pipelines de incorporação e pilhas RAG completas em uma única máquina do lado da mesa - silenciosamente, em uma fração do orçamento de energia de uma estação de trabalho GPU típica.
Este artigo mostra como desembalar um Mac Studio com o chip M4 Max, a primeira inicialização, as leituras reais no dispositivo de mactop, e um caminho prático de "a caixa está na minha mesa" até "Estou conversando com o Llama 3 em execução localmente e consultando meus próprios documentos com o RAG". Cada recomendação aqui é baseada no que realmente observei na máquina. Não há números de referência inventados, nem boatos de marketing - apenas o fluxo de trabalho.
Se você é um engenheiro, um construtor de IA, um SRE ou um líder técnico que está decidindo se um Mac Studio pertence ao mix de hardware de sua equipe, este guia é para você.

2. Desembalar o Mac Studio M4 Max
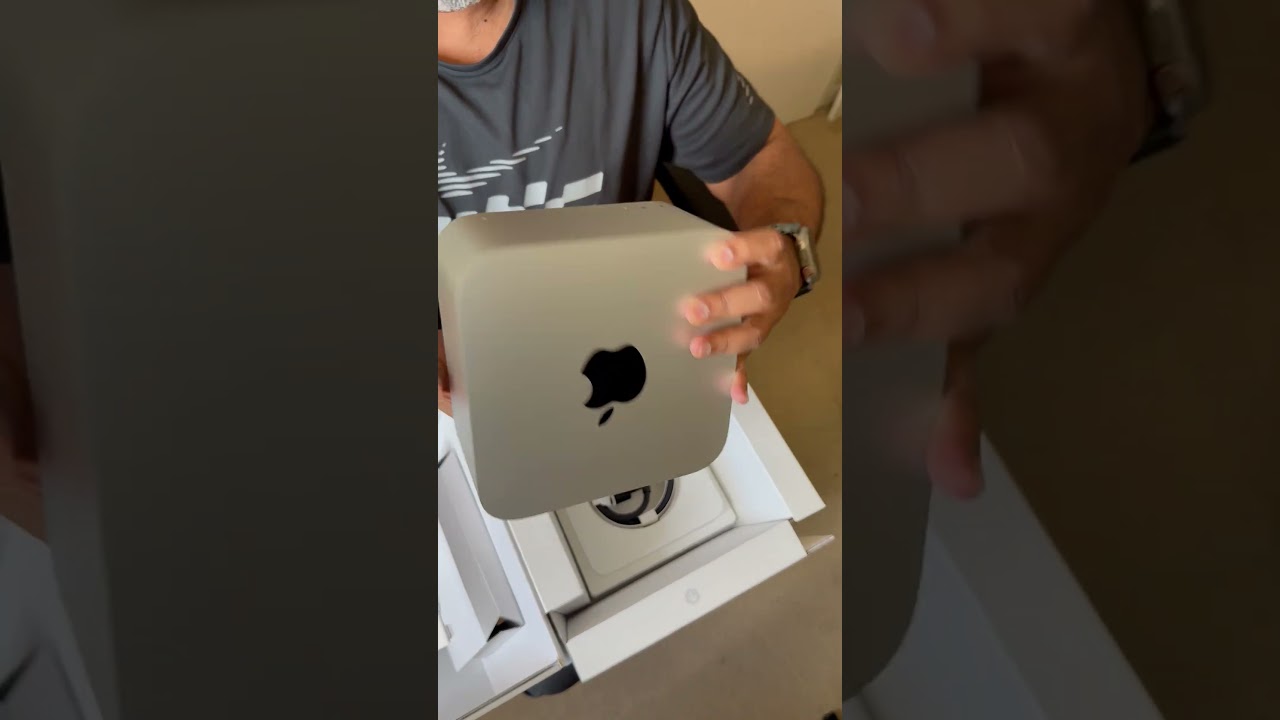
A experiência de desembalagem é clássica da Apple: papelão mínimo, a máquina acondicionada em um recesso moldado, um cabo de alimentação preto curto e pronto. Nenhum pacote de acessórios inchado. O Mac Studio em si é o mesmo gabinete compacto de extrusão de alumínio introduzido com o M1 Ultra original: aproximadamente 7,7 polegadas quadradas, denso na mão, com a familiar entrada de ripas na parte inferior e uma série de portas na parte traseira.
Assista ao curta de unboxing no YouTube: https://youtube.com/shorts/HUlUoHNsyNM
Gravei um pequeno clipe do unboxing - assista ao curta do YouTube acima. A razão pela qual um Short funciona tão bem neste formato é que a configuração real é genuinamente rápida. Primeiro plug-in, monitore a ativação, login do Apple ID, idioma e região, FileVault e você estará em uma área de trabalho utilizável em poucos minutos.
2.1 Primeira inicialização - leituras reais de mactop
A primeira coisa que fiz depois que o sistema terminou a sincronização inicial foi instalar mactop - um excelente painel TUI de código aberto que mostra os contadores internos do Apple Silicon em tempo real. Esta é a aparência daquele painel de instalação nova com 37 minutos de atividade:

/img/mac-studio-mactop-firstboot.png para trocá-lo mais tarde.Os números nessa captura de tela são os únicos números concretos que citarei neste artigo. Eles são a verdade básica para minha máquina ociosa em uma nova configuração:
- Apple Silicon: M4 Max
- CPU: Total de 16 núcleos – 4 núcleos de eficiência + 12 núcleos de desempenho; Cluster E a 1,6 GHz, cluster P a 0,2 GHz; pacote a 37 C
- GPU: 40 núcleos a 784 MHz, 30 C
- Motor Neural (ANE): 16 núcleos, consumindo 0,00 W em modo inativo
- Memória unificada: 128,00 GB no total, 16,62 GB em uso (cerca de 13%) em modo inativo
- Poder: 6,48 W total - CPU 0,10 W, GPU 0,02 W, ANE 0 W, DRAM 0,36 W, Sistema 6,01 W. O máximo observado na sessão foi de 46,33 W. Térmicas: Nominais.
- Armazenar: Mac HD de 2,0 TB, 1,9 TB grátis; 53.9 GB usado pelo sistema operacional e pela configuração inicial
- Rede: Wi-Fi 6, com uma leitura de amostra de 19,0 KB/s de upload e 156,8 KB/s de download durante a sincronização em segundo plano
Duas coisas se destacam. Primeiro, 6,48 W em marcha lenta para um desktop com 128 GB de memória utilizável é notável - isso é menos do que muitos laptops consomem com a tela desligada. Em segundo lugar, o GPU está em 784 MHz com 40 núcleos disponíveis; esse pool está pronto para fazer um trabalho real assim que você coloca um LLM na frente dele.
3. Por que o Mac Studio M4 Max é incrível para IA local
Para entender por que este hardware é tão adequado para IA local - e por que a "memória unificada" é mais do que uma linha de marketing - ajuda compará-lo diretamente com a alternativa canônica: uma placa GPU discreta em um PC, comunicando-se com a RAM do sistema através de PCIe.

3.1 Memória unificada em linguagem simples
Em um equipamento de IA de PC tradicional, você tem dois pools de memória. A RAM do sistema (geralmente 64-256 GB de DDR5) contém o sistema operacional, o aplicativo e os pesos do modelo quando você os carrega do disco. O GPU tem sua própria VRAM – 24 GB em um RTX 4090, 32 GB em um 5090, 80 GB em um A100. Antes que o GPU possa executar um único matmul, o modelo deve ser copiado da RAM do sistema para a VRAM através do barramento PCIe. Se o modelo for maior que VRAM, ele não carrega ou é paginado através de PCIe a um custo brutal (geralmente 10-100x mais lento do que funcionar totalmente em VRAM).
O Apple Silicon reúne esses dois pools em um. O CPU, o GPU, o Neural Engine e os mecanismos de mídia veem o mesma memória física. Não há cópia. Não há gargalo PCIe. Um modelo com 40 GB no disco tem 40 GB na memória unificada e o GPU pode lê-lo diretamente.
Para LLMs locais, esse é o recurso matador. Um modelo de parâmetro 70B quantizado para Q4_K_M tem cerca de 40 GB no disco (valor citado publicamente para os pesos da classe Llama nesse nível quantitativo - tratado como aproximado). Em um consumidor GPU 24 GB, esse modelo simplesmente não cabe. Na memória unificada 128 GB, ele carrega cerca de 80 GB ainda livres para contexto, código de aplicativo e ferramentas.
3.2 Eficiência energética difícil de acreditar
A captura de tela do mactop mostra 6,48 W em modo inativo e um máximo de 46,33 W observado durante a sessão. Para colocar isso em perspectiva: um único RTX 4090 fica inativo entre 15-25 W com o resto do sistema em cima e consome até 450 W sob carga. Uma Mac Studio é uma caixa de IA de mesa que você pode deixar funcionando 24 horas por dia, 7 dias por semana, sem perceber na conta de luz. Está em silêncio. Os ventiladores quase nunca giram durante cargas de trabalho de inferência. É isso que o torna viável como caixa de desenvolvimento sempre ativa de uma forma que um PC GPU discreto raramente acontece.
3.3 O que o Apple Neural Engine realmente faz
O ANE é um acelerador de função fixa de 16 núcleos otimizado para os tipos de operações de tensor que o CoreML produz. Para a maioria das cargas de trabalho LLM de peso aberto em 2026 (formato GGUF executado por meio de llama.cpp ou Ollama), o ANE não está no caminho ativo - o GPU está, por meio de Metal Performance Shaders. O ANE se destaca em modelos convertidos em CoreML, reconhecimento de fala no dispositivo, segmentação de imagens e cargas de trabalho semelhantes de formato fixo. Também é extremamente eficiente em termos de energia quando funciona. Útil saber que está aí; não espere que todas as pilhas LLM o utilizem.
4. Configurando o Mac Studio para trabalho de IA
Após a integração padrão do macOS, aqui está o procedimento exato que sigo para um novo Mac Studio que desejo usar como uma caixa de desenvolvimento de IA local.
4.1 Instale Homebrew, Xcode CLT e o básico
/bin/bash -c "$(curl -fsSL https://raw.githubusercontent.com/Homebrew/install/HEAD/install.sh)"

xcode-select --install

brew install git wget jq python@3.12 node pyenv
brew install --cask iterm2 visual-studio-code
Homebrew traz as ferramentas Unix, Xcode Command Line Tools fornece os compiladores e linkers, Python e Node fornecem um tempo de execução para o código do aplicativo e iTerm2 + VS Code são o par editor + terminal que eu padrão.
4.2 Instale o Ollama
Ollama é a maneira mais fácil de baixar, executar e servir LLMs de peso aberto no macOS. Sob o capô ele envolve llama.cpp com aceleração Metal e fornece um HTTP API simples na porta 11434.
brew install ollama

ollama serve &

ollama --version
Você também pode instalar através do site oficial .dmg de ollama.com, que configura um aplicativo de barra de menu. Qualquer caminho funciona. Eu prefiro o brew install para caixas sem cabeça e o dmg para Macs com driver diário.
4.3 Instale o LM Studio (opcional, mas vale a pena)
Estúdio LM é uma UI de desktop para navegar, baixar e conversar com modelos GGUF. Ele também expõe um API compatível com OpenAI. Eu o instalo junto com o Ollama porque o navegador do modelo é excelente e a interface de ajuste de desempenho por modelo é amigável quando você decide entre Q4_K_M e Q5_K_M.
4.4 Instale Continue.dev no código VS
O Continue.dev oferece assistência no estilo ChatGPT dentro do VS Code, mas direcionado para seu Ollama local. Depois de instalar a extensão, coloque-a em seu ~/.continue/config.json:
{
  "models": [
    {
      "title": "Llama 3.1 8B (local)",
      "provider": "ollama",
      "model": "llama3.1:8b",
      "apiBase": "http://localhost:11434"
    },
    {
      "title": "Qwen 2.5 Coder 14B (local)",
      "provider": "ollama",
      "model": "qwen2.5-coder:14b",
      "apiBase": "http://localhost:11434"
    }
  ],
  "tabAutocompleteModel": {
    "title": "Codestral (local)",
    "provider": "ollama",
    "model": "codestral:latest",
    "apiBase": "http://localhost:11434"
  }
}
Agora você tem bate-papo inline, edição e preenchimento automático - todos atingindo modelos que moram na mesma mesa que seu editor. Nenhum dado sai da máquina.
5. Executando seu primeiro LLM

Hora do momento da verdade. Puxe um modelo e execute-o.
5.1 Puxando Llama 3.1 8B
ollama pull llama3.1:8b

ollama list

ollama run llama3.1:8b "Explain unified memory architecture to me in 3 sentences."
O pull baixa o Q4_K_M GGUF (Llama 3.1 8B em Q4_K_M é cerca de 4,7 GB no disco - valor citado publicamente, tratado como aproximado). Em uma conexão Wi-Fi 6 como a minha, o download demora alguns minutos; em gigabit com fio é mais rápido. Assim que pousar, o primeiro ollama run inclui um carregamento de modelo único na memória unificada - você notará uma breve pausa antes dos primeiros fluxos de token - e as execuções subsequentes são rápidas.
Deliberadamente, não citarei números de tokens por segundo para minha própria máquina aqui, porque não executei um conjunto de benchmark controlado com uma metodologia emparelhada. O que direi é que nesta classe de hardware (M4 Max com 40 núcleos GPU) você deve esperar streaming suave e conversacional de um modelo 8B em Q4_K_M, com um atraso de carga inicial perceptível e saída estável durante toda a resposta. Se você leu afirmações como “Recebo 60 tokens por segundo no meu Mac” em outro lugar, trate-as como uma orientação aproximada; seus números reais irão variar de acordo com o comprimento do prompt, a janela de contexto, o nível de quantização, a arquitetura do modelo e o que mais está em execução.
5.2 Escolhendo uma quantização - Q4_K_M, Q5_K_M, Q8_0
A quantização reduz a precisão dos pesos do modelo para reduzi-los no disco e na memória. A compensação é a qualidade. Aqui está o modelo mental aproximado que uso ao escolher um quant para inferência local:
| Quantidade | Tamanho aproximado para 8B | Qualidade vs FP16 | Quando usar |
|---|---|---|---|
| Q4_K_M | ~4,7GB | Muito bom, pequena queda | Padrão. Melhor equilíbrio velocidade/qualidade para chat e código. |
| Q5_K_M | ~5,7GB | Mais perto do FP16 | Quando você precisa de um toque a mais de precisão e tem memória de sobra. |
| Q8_0 | ~8,5GB | Quase sem perdas | Quando você precisa de máxima qualidade e mínimo ruído em modelos pequenos. |
Todos os tamanhos são valores aproximados e citados publicamente para pesos 8B da classe Llama. A ordem relativa é o que importa.
5.3 O que cabe em 32, 64 e 128 GB
| Memória unificada | Zona de conforto realista (Q4_K_M) | Alongue (com cuidado) |
|---|---|---|
| 32GB | 7B/8B/13B | 20-22B em contexto restrito |
| 64GB | 13B/20B/34B | 40-50B em contexto restrito |
| 128GB | Variantes 34B / 70B / mistura de especialistas | 100-120B em contexto restrito |
"Zona de conforto" significa que o modelo carrega com espaço suficiente para uma janela de contexto generosa, um cache KV e outros aplicativos em execução. "Stretch" significa que ele carrega, mas você começa a conciliar o comprimento do contexto e outras cargas de trabalho. Na minha caixa 128 GB, posso executar um 70B em Q4_K_M e ainda ter cerca de 80 GB de espaço para VS Code, Chrome e alguns processos Python - o que é, francamente, uma sensação luxuosa.
5.4 Chamando Ollama do Node e Python
Ollama expõe um HTTP API em http://localhost:11434. Uma pequena busca de Node se parece com isto:
// node 20+
const res = await fetch("http://localhost:11434/api/generate", {
  method: "POST",
  headers: { "Content-Type": "application/json" },
  body: JSON.stringify({
    model: "llama3.1:8b",
    prompt: "Write a one-paragraph summary of unified memory architecture.",
    stream: false
  })
});

const data = await res.json();
console.log(data.response);
E do Python:
import requests

r = requests.post(
    "http://localhost:11434/api/generate",
    json={
        "model": "llama3.1:8b",
        "prompt": "Explain HNSW indexes briefly.",
        "stream": False,
    },
    timeout=120,
)
print(r.json()["response"])
Isso é tudo que você precisa para conectar um LLM local a uma ferramenta CLI, um bot do Slack, um atalho, um microsserviço ou uma automação interna. Sem chaves, sem limites de taxas, sem cotas.
6. Melhores modelos para rodar no Mac Studio
Escolher um modelo é em parte desempenho, em parte licença e em parte vibração. Aqui está o que eu realmente executo na caixa, agrupado por nível de tamanho.
6.1 Pequeno (menos de 10B): burros de carga rápidos do dia a dia
- Llama 3.1 8B - excelente bate-papo e raciocínio de uso geral; licença Meta permissiva com ressalvas.
- Mistral 7B / Ministral 8B - raciocínio forte, variantes licenciadas pelo Apache disponíveis.
- Qwen 2.5 7B - desempenho multilíngue e de código muito forte.
- Phi-3.5 mini - minúsculo, surpreendentemente capaz, ideal quando você precisa de rendimento e baixa latência.
- Codificador Codestral / Qwen 2.5 7B - preenchimento automático em linha rápido para trabalho IDE.
6.2 Mid (10B-40B): o ponto ideal em 64-128 GB
- Llama 3.1 / 3.3 70B (Q4_K_M) - se você tiver 128 GB, esse é o modelo principal; qualidade quase fronteiriça, funciona confortavelmente.
- Qwen 2.5 32B - excelente relação qualidade/tamanho; combina bem com RAG.
- DeepSeek-Codificador 33B - forte em tarefas de geração de código.
- Mixtral 8x7B - mistura de especialistas, ativa apenas 2 especialistas por vez, cabe confortavelmente.
6.3 Grande (70B e superior): somente em 96-128 GB e somente no quarto trimestre
Em 128 GB a porta está aberta para modelos da classe 70B em Q4_K_M. Eles são Mais devagar do que os modelos 8B, mas o salto de qualidade é significativo para tarefas que se beneficiam de um conhecimento mundial mais amplo e de um raciocínio mais longo. Espere que a latência do primeiro token seja maior e o ritmo de streaming diminua, mas a experiência real permanece utilizável para muitos fluxos de trabalho.
7. Construindo um pipeline RAG local
Depois de ter uma LLM local, a coisa mais útil que você pode fazer com ela é apontá-la para seus próprios documentos. Esta é a Geração Aumentada de Recuperação e é a carga de trabalho onde o Mac Studio realmente brilha como uma alternativa privada aos APIs na nuvem.

7.1 A pilha
- Analisador de documentos - PyMuPDF para PDFs,
unstructuredpara ingestão de formato misto. - Pedaço -LangChain's
RecursiveCharacterTextSplitterou um divisor com reconhecimento de token. Tamanho típico de bloco de 512 a 1024 tokens com 64 a 128 tokens de sobreposição. - Incorporações -
nomic-embed-textoumxbai-embed-large, ambos disponíveis por meio do Ollama. Ambos são executados no GPU local. - Loja de vetores - ChromaDB por padrão. SQLite-VSS para uma opção de servidor zero. LanceDB se você deseja uma opção incorporada de arquivo único que seja escalonável.
- Gerador - Llama 3.1 8B para resposta rápida ou 70B se você deseja respostas da mais alta qualidade.
7.2 Exemplo mínimo de Python - ponta a ponta
pip install chromadb requests pypdf

import os, glob, requests, chromadb
from chromadb.utils import embedding_functions
from pypdf import PdfReader

OLLAMA = "http://localhost:11434"
EMBED_MODEL = "nomic-embed-text"
GEN_MODEL   = "llama3.1:8b"

def embed(text: str) -> list[float]:
    r = requests.post(f"{OLLAMA}/api/embeddings", json={
        "model": EMBED_MODEL, "prompt": text,
    }, timeout=60)
    return r.json()["embedding"]

def generate(prompt: str) -> str:
    r = requests.post(f"{OLLAMA}/api/generate", json={
        "model": GEN_MODEL, "prompt": prompt, "stream": False,
    }, timeout=300)
    return r.json()["response"]

def chunk(text: str, size: int = 1000, overlap: int = 150):
    out, i = [], 0
    while i < len(text):
        out.append(text[i:i+size])
        i += size - overlap
    return out

client = chromadb.PersistentClient(path="./rag-db")
col = client.get_or_create_collection("docs")

for path in glob.glob("./docs/**/*.pdf", recursive=True):
    reader = PdfReader(path)
    full = "\n".join(p.extract_text() or "" for p in reader.pages)
    for j, c in enumerate(chunk(full)):
        col.add(
            ids=[f"{os.path.basename(path)}::{j}"],
            documents=[c],
            embeddings=[embed(c)],
            metadatas=[{"source": path, "chunk": j}],
        )

def ask(q: str, k: int = 5) -> str:
    qe = embed(q)
    res = col.query(query_embeddings=[qe], n_results=k)
    ctx = "\n\n".join(res["documents"][0])
    prompt = (
        "Answer the question using only the context below. "
        "If the answer is not in the context, say you do not know.\n\n"
        f"Context:\n{ctx}\n\nQuestion: {q}\nAnswer:"
    )
    return generate(prompt)

print(ask("What is unified memory and why does it matter for LLMs?"))
Esse é um pipeline RAG local completo em menos de 60 linhas de Python. Tudo funciona no Mac Studio. Sem chaves API externas, sem cobrança por token, sem saída de dados da máquina. A primeira ingestão de um grande conjunto de PDFs levará alguns minutos; as consultas subsequentes são rápidas.
7.3 Notas de ajuste
- Tamanho do pedaço - comece com 1000 caracteres e 150 de sobreposição; aumente se suas fontes tiverem seções estruturadas longas (especificações legais e técnicas) e o recuperador estiver fragmentando as respostas.
- Top-k - 4-8 é o intervalo prático. Ir muito mais alto aumenta o prompt e retarda a geração sem ganhos óbvios.
- Reclassificação - para obter a mais alta qualidade, recupere os 20 primeiros e reclassifique com um codificador cruzado (por exemplo,
bge-reranker). No Mac Studio isso é barato. - Filtragem de metadados - marcar pedaços com seu caminho de origem, data e seção; filtrar no momento da consulta antes da pesquisa vetorial. Esta é a maior vitória de precisão.
- Transmissão - trocar
streamparatruena chamada Ollama e transmita tokens para o cliente para uma UX rápida.
8. O ciclo diário do desenvolvedor
Depois de algumas semanas no Mac Studio, meu ciclo diário fica assim:
- Abra o VS Code, o Continue.dev acorda contra o Ollama.
- Abra um bate-papo no Open WebUI (ou LM Studio) para perguntas e respostas mais longas sobre minhas anotações.
- Para trabalho de código: preenchimento automático de guias em um modelo Codestral ou Qwen Coder, bate-papos mais longos em Llama 3.1 8B, sessões de raciocínio profundo em um 70B quando a tarefa o justificar.
- Para RAG interno, um script Python que aponta para a pasta docs/ do projeto e um banco de dados Chroma.
- Para prototipagem de agente, LangGraph ou um pequeno loop personalizado que chama o endpoint Ollama - mesmo padrão, cola diferente.
O que realmente muda quando seu LLM é local é a maneira como você o usa. Não há custo incremental para uma consulta, então você faz mais perguntas ao modelo. Não há preocupação com a privacidade, então você cola registros de produção, documentos internos e e-mails de clientes. Você escreve pequenos scripts CLI que passam por 200 documentos para extrair um resumo estruturado e não pensa duas vezes sobre a fatura por token, porque não há fatura.
9. Benchmarks e comparação honesta com a nuvem
Deixe-me ser muito direto: não vou publicar números de tokens por segundo que não produzi com uma metodologia de benchmark rigorosamente controlada. A Internet está inundada com esses números, muitas vezes comparando diferentes níveis de quantização, durações de contexto e formatos de prompt, e eles confundem mais do que esclarecem. Em vez disso, o que farei é publicar uma matriz de decisão que capture em que tipo de carga de trabalho o Mac Studio realmente vence, onde isso não acontece e onde a resposta certa é "use ambos".

9.1 Matemática do ponto de equilíbrio
Uma Mac Studio M4 Max com 128 GB de memória unificada e um SSD de 2 TB chega aproximadamente à mesma faixa de preço de alguns meses de uma instância GPU na nuvem sempre ativa. Trate todos os valores específicos em dólares como aproximados e em função da região e do desconto:
- Uma Mac Studio M4 Max, bem configurada: cerca de US$ 4.000 a US$ 6.000 única (aproximadamente; as configurações variam).
- Um AWS
g5.xlarge(único A10G, 24 GB VRAM) rodando 24x7 sob demanda: na ordem de US$ 700 a US$ 900 por mês (dependendo da região). - Um AWS
p4d.24xlarge(8x A100): pedido de US$ 20.000 a US$ 30.000 por mês sob demanda, se você de alguma forma o deixou ligado (não deixaria, mas torna o contraste óbvio).
A aritmética diz que, para uma caixa de desenvolvimento sempre ativa, o Mac Studio se paga em poucos meses, em comparação com uma instância de nuvem sempre ativa comparável, e continua a se pagar em termos de eletricidade por anos. Para trabalhos de treinamento intensivo, a matemática muda: alugue por uma hora, faça a corrida e devolva. Use a ferramenta certa para o trabalho.
9.2 Quando a nuvem é a resposta certa
- Você precisa treinar ou ajustar um modelo maior do que cabe no 128 GB.
- Você precisa atender em escala a uma base de usuários global com SLOs rígidos e capacidade elástica.
- Você está executando um experimento que se beneficia do paralelismo 8x A100 ou H100.
- A postura de conformidade da sua organização diz que a inferência deve ser executada em uma região específica da nuvem com trilhas de auditoria específicas.
9.3 Quando o Mac Studio é a resposta certa
- Você deseja uma caixa de inferência privada sempre ativa para sua equipe.
- Você está construindo RAG, agentes ou copilotos IDE onde a residência de dados e a privacidade são importantes.
- Você deseja uma caixa de desenvolvimento silenciosa e de baixo consumo de energia que não exija uma sala de servidores.
- Você está prototipando rapidamente e o faturamento por token de uma nuvem API está atrapalhando.
- Você quer aprender a pilha - possuir um modelo, possuir um tempo de execução, possuir um armazenamento de vetores, possuir o loop.
10. Desafios e limitações
Eu não estaria fazendo nenhum favor a este artigo se não nomeasse as arestas. O Apple Silicon é excelente para IA local, mas existem advertências reais.
10.1 O treinamento ainda é uma história mais fraca do que a inferência
A história da Apple Silicon AI é muito mais forte para inferência do que para treinamento. O back-end MPS do PyTorch amadureceu significativamente e a estrutura MLX da própria Apple é genuinamente boa, mas a amplitude das ferramentas de treinamento somente CUDA é ainda maior. Se o seu trabalho diário for arquiteturas de modelos inovadores ou ajustes finos em grande escala, você encontrará buracos que simplesmente não encontra no Linux + NVIDIA.
10.2 Ecossistema assume CUDA em muitos lugares
Muitos repositórios de IA ainda seguem as suposições CUDA. A maioria dos projetos mantidos agora possuem caminhos Metal/MPS, mas esperam atritos ocasionais: uma biblioteca que requer compilação a partir do código-fonte, um kernel que não possui equivalente em Metal, um conjunto de benchmarks que roda apenas em NVIDIA. Planeje um tempo para isso.
10.3 Dimensionar é DIY
Um Mac Studio é uma caixa única. Ferramentas como EXO e outros permitem agrupar Macs para executar modelos muito grandes em vários dispositivos, mas esta não é a história refinada que você obtém com um cluster Kubernetes de g5s. Se a sua carga de trabalho precisa de elasticidade horizontal, a nuvem é ainda melhor.
10.4 Reparabilidade e atualizações
Você não pode adicionar RAM posteriormente. Você não pode trocar o SSD posteriormente (praticamente falando). Compre o que você precisa e mais um - especialmente na memória. O nível 128 GB é o que eu recomendaria para trabalhos sérios de IA; 64 GB é o chão.
10.5 Térmicas sob carga sustentada
O Mac Studio funciona de forma fria e silenciosa em modo inativo (a imagem acima mostra 37 C e 30 C com as ventoinhas inaudíveis). Sob carga pesada e sustentada do LLM, os ventiladores giram - não alto, mas de forma audível - e o chip aquece. Isto está dentro dos limites térmicos nominais; apenas esteja ciente de que "silencioso" é uma caracterização ociosa e de carga leve, não absoluta.
11. O futuro da IA local no Apple Silicon
Três tendências estão convergindo e tornam os próximos 12 a 24 meses emocionantes para a IA local no Apple Silicon.
Primeiro, modelos de peso aberto continuam ficando menores sem perder capacidade. Phi-3.5, Qwen 2.5 pequeno e a família Llama 3.x com 8B acima de sua classe de peso. Um modelo 2026 8B é aproximadamente comparável em qualidade a um 2023 70B em muitas tarefas. Isso significa que mais cargas de trabalho cabem confortavelmente em 32-64 GB de memória unificada, e um 128 GB Mac Studio se torna uma caixa de serviço multimodelo.
Segundo, A estrutura MLX da própria Apple continua melhorando. O MLX fornece um API semelhante ao NumPy, avaliação lenta, reconhecimento de memória unificada por padrão e gráficos de computação dinâmicos. A comunidade MLX tem portado modelos, tokenizadores e loops de treinamento rapidamente. Se você está iniciando um novo projeto de ML em um Mac hoje, o MLX é a escolha natural; se você estiver usando PyTorch, o backend MPS será mais utilizável a cada versão.
Terceiro, a quantização e a compactação do cache KV estão cada vez melhores. Técnicas como Q4_K_M, quants da família IQ e melhorias no GGUF significam que o mesmo modelo cabe em menos memória do que há seis meses, com menos perda de qualidade. A IA local está em uma curva onde cada geração de emparelhamento modelo + quant amplia o alcance prático do hardware com preço de consumidor.
Adicione a tudo isso o boato sobre os futuros chips da série M (M5, futuros Ultras, atualizações de estúdio), e a trajetória é clara: a caixa de IA do lado da mesa está aqui e está cada vez melhor.
12. Fortalecendo o Mac Studio como uma caixa de IA de equipe
Se você deseja compartilhar seu Mac Studio com uma equipe pequena - digamos, expor o Ollama, uma instância Open WebUI e um endpoint RAG para alguns colegas - aqui está o endurecimento bruto que eu faço:
- FileVault ativado e uma senha de login forte. Mantenha-o em um UPS.
- Escala traseira na caixa para que possa ser acessado pelos dispositivos da sua equipe sem expô-lo à Internet pública.
- Vincule Ollama ao host local e enfrente-o com um proxy de autenticação thin (Caddy, Traefik ou um pequeno servidor Node/Python) que lida com autenticação e limitação de taxa antes de encaminhar para
11434. - Execute o Open WebUI no Docker Desktop com volume persistente; aponte-o para o endpoint Ollama local.
- Cópias de segurança do banco de dados RAG para um SSD externo criptografado ou um destino do Time Machine.
- Atualização automática Pacotes macOS e Homebrew de acordo com uma programação; fixe Ollama e versões de modelo intencionalmente, em vez de extrair automaticamente as mais recentes.
Feito bem, você tem um endpoint de IA privado e fácil de auditar que sua equipe usa todos os dias e que nunca envia um token para fora da rede do edifício.
13. Conclusão: uma revolução silenciosa na mesa
Desembalar um Mac Studio M4 Max em 2026 é menos como comprar um desktop e mais como comprar um pequeno dispositivo de IA que também é um Mac. 128 GB de memória unificada, 40 núcleos GPU, 16 núcleos CPU, um mecanismo neural, codificadores de mídia de hardware, um SSD de 2 TB e consumo de energia ocioso medido em watts únicos – tudo em uma caixa que você pode pegar com uma mão.
A configuração é rápida, o primeiro LLM é executado em uma hora e em uma tarde você tem um pipeline RAG privado respondendo a perguntas sobre seus próprios documentos. Tudo acontece na sua mesa, sem nenhuma conta de nuvem sendo exibida em segundo plano. Isso muda a forma como você constrói com IA de uma forma que é difícil de transmitir até que você experimente.
Se você está avaliando se um Mac Studio pertence ao mix de hardware de sua equipe, espero que este artigo tenha lhe dado uma visão fundamentada: o que é incrível, o que é difícil, onde a nuvem ainda vence e onde a caixa em sua mesa é a melhor resposta. O companheiro blog curto destila o mesmo fluxo de trabalho em uma leitura de 5 minutos para compartilhamento.
Se isso foi útil - assista ao unboxing no YouTube (https://youtube.com/shorts/HUlUoHNsyNM), inscreva-se no canal para tutoriais de acompanhamento (ajuste de MLX, inferência multi-Mac, pilhas de agentes) e volte aqui para o próximo artigo da série. A IA local no Apple Silicon está apenas começando e continuarei escrevendo à medida que a pilha amadurece.
Instantâneo de SEO para este artigo
- Título SEO: Unboxing Mac Studio M4: execute seu primeiro LLM localmente
- Meta descrição: Desembale um Mac Studio M4 Max com 128 memória unificada GB, instale o Ollama, execute o Llama 3 localmente e crie um pipeline RAG privado. Leituras reais, comparações honestas.
- Palavras-chave primárias: Mac Studio AI, Mac Studio LLM, execução de LLMs em Mac Studio, Ollama Mac Studio, Apple Silicon AI, configuração de IA local, Mac Studio RAG, tutorial local de LLM, execução de Llama localmente, revisão de Mac Studio M4.
- Twitter / X (menos de 280 caracteres): Retirei da caixa uma Mac Studio M4 Max. 128 memória unificada GB. Inativo a 6,48 W. Extraiu Llama 3.1 8B via Ollama, construiu um pipeline RAG local em uma tarde, sem conta de nuvem. Passo a passo completo de 4.000 palavras + 6 diagramas + o curta do YouTube. #AppleSilicon #LocalLLM
- Postagem no LinkedIn: O novo Mac Studio M4 Max pousou na minha mesa e eu o tratei como um dispositivo de IA: leituras reais do mactop (6,48 W inativo, 128 GB UMA, 40 núcleos GPU), instalação Ollama, Llama 3.1 8B em execução localmente, um pipeline RAG completo em meus próprios documentos - tudo em uma tarde. Escrevi todo o fluxo de trabalho, com seis diagramas originais, uma matriz de decisão honesta entre nuvem versus local e uma seção sobre onde a nuvem ainda vence. Se você estiver avaliando IA local para sua equipe, este é um ponto de partida.