
Workstation resumo técnico: como descobrir gargalos LLM e multiagentes com OpenTelemetria, plataformas Prometheus/Grafana/Thanos e LLM, como Langfuse / LMNR — incluindo esquemas de extensão, atribuição de custos, amostragem e limites de uso rígido. Companheiro: blog de negócios · servindo: Turbocompressão LLMs · laboratório: Laboratório de IA Empresarial.
- Problema: O custo e a latência do agente ficam ocultos nos saltos (LLM → ferramentas → RAG → novas tentativas), e não em uma única métrica “modelo é lento”.
- Padrão: Instrumento com OpenTelemetry; um esquema de atributo para tokens, modelo, locatário, rota, custo_estimado_usd.
- Caminho das métricas: Prometeu (+ Thanos) para sinais dourados; Grafana para SLOs e quadros FinOps.
- Caminho LLM: Langfuse/LMNR para rastreamentos, pontuações, conjuntos de dados e versões de prompt.
- Controlar: Tokens de limite, chamadas de ferramentas e rodadas de depuração; modelos de rotas por dificuldade passo a passo.
- Ganhar: Avalie o custo por tarefa bem-sucedida antes de comprar mais GPUs ou aumentar as cotas de API.
1. O que significa “gargalo” para agentes LLM
Os gargalos no tempo de treinamento (dados, FLOPs) diferem do tempo de serviço e horário do agente gargalos. Nos agentes de produção os modos de desperdício dominantes são:
- Inchaço imediato — prompts de sistema superdimensionados, contexto não utilizado, ocorrências de prefixo/cache ausentes.
- Exagero do modelo — modelos de fronteira usados para etapas de classificação/rota que um modelo pequeno pode executar.
- Loops ilimitados — novas tentativas de ferramentas e ciclos de autodepuração sem um orçamento rígido (consulte as compensações do Self-Debugging em Turbocompressão LLMs).
- Esperas externas - banco de dados vetorial, SaaS APIs e portas humanas no circuito atribuídas erroneamente à “latência LLM”.
- Servindo fragmentação — Desperdício de cache KV no GPU (território PagedAttention/vLLM) depois de você já ter confirmado que o gráfico do agente está correto.
Sem rastreios distribuídos você não pode separá-los. A observabilidade, portanto, não é um painel interessante – é o plano de controle para FinOps e SRE em produtos de IA.
2. Arquitetura de referência
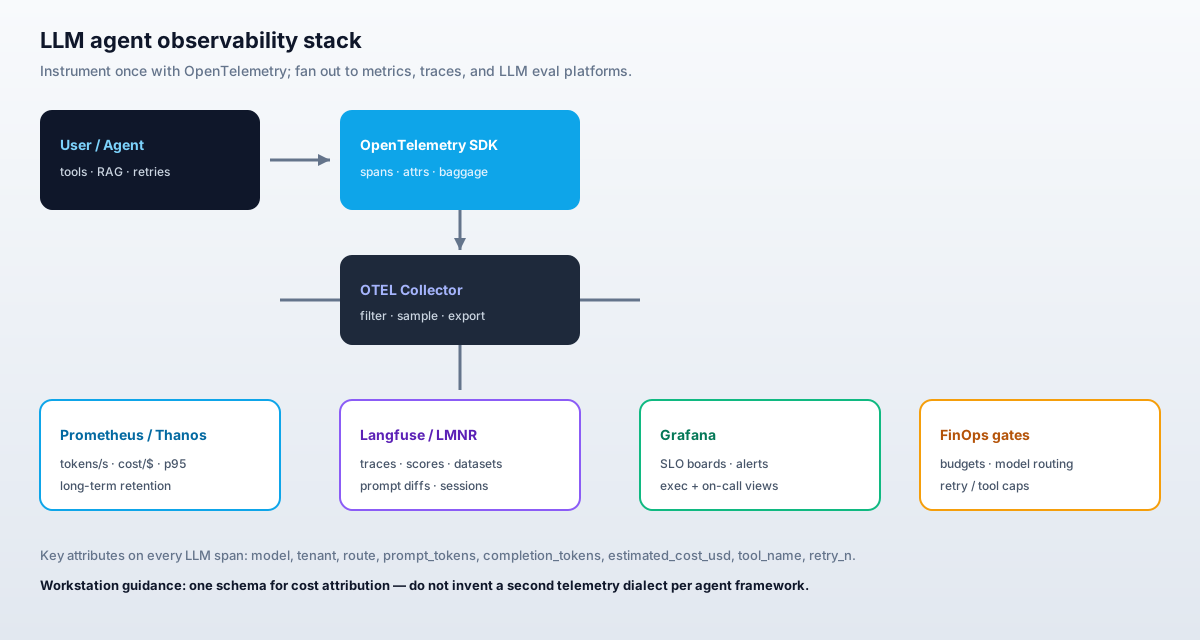
User / Orchestrator
    → Agent runtime (tools, RAG, LLM calls)
        → OpenTelemetry SDK (spans + metrics)
            → OTEL Collector (filter, sample, redact)
                ├─→ Prometheus / Thanos   (rates, costs, SLOs)
                ├─→ Grafana              (boards, alerts)
                └─→ Langfuse / LMNR      (traces, scores, datasets)
FinOps / policy layer reads the same metrics to enforce caps and model routing.
3. Esquema de extensão OpenTelemetry para chamadas LLM
Adote uma convenção entre estruturas (LangChain, agentes Go/Python personalizados, SDKs Bedrock). Prefira convenções semânticas onde elas existirem e estenda-as com atributos Workstation estáveis:
| Atributo | Exemplo | Por que |
|---|---|---|
gen_ai.system | openai / antrópico / rochoso / vllm | Rollups de provedores |
gen_ai.request.model | claude-soneto-4 / lhama-3.1-8b | Custo e qualidade por modelo |
gen_ai.usage.input_tokens | 1820 | Gerador de custos imediato |
gen_ai.usage.output_tokens | 410 | Gerador de custo de conclusão |
wsw.estimated_cost_usd | 0.0124 | FinOps sem juntar tabelas de preços posteriormente |
wsw.tenant_id | acme-prod | Estorno |
wsw.route | suporte.triagem | Atribuição de recursos do produto |
wsw.agent_step | plano / ferramenta / crítica | Encontre etapas caras |
wsw.retry_n | 2 | Detecção de loop |
wsw.prompt_version | triagem@v17 | Ligação de regressão |
from opentelemetry import trace
from opentelemetry.trace import Status, StatusCode

tracer = trace.get_tracer("workstation.agents")

PRICE_IN = 0.003 / 1000   # example $/token — load from config
PRICE_OUT = 0.015 / 1000

def complete_llm(model: str, prompt: str, tenant: str, route: str):
    with tracer.start_as_current_span("gen_ai.chat") as span:
        span.set_attribute("gen_ai.system", "openai")
        span.set_attribute("gen_ai.request.model", model)
        span.set_attribute("wsw.tenant_id", tenant)
        span.set_attribute("wsw.route", route)
        try:
            resp = client.chat.completions.create(
                model=model,
                messages=[{"role": "user", "content": prompt}],
            )
            usage = resp.usage
            cost = usage.prompt_tokens * PRICE_IN + usage.completion_tokens * PRICE_OUT
            span.set_attribute("gen_ai.usage.input_tokens", usage.prompt_tokens)
            span.set_attribute("gen_ai.usage.output_tokens", usage.completion_tokens)
            span.set_attribute("wsw.estimated_cost_usd", round(cost, 6))
            return resp.choices[0].message.content
        except Exception as e:
            span.record_exception(e)
            span.set_status(Status(StatusCode.ERROR, str(e)))
            raise
Prática: calcular estimated_cost_usd no vão. Não espere por um trabalho noturno para juntar as contagens de tokens às planilhas de preços – os proprietários de produtos e de plantão precisam de FinOps ao vivo.
3b. Hierarquia e bagagem de extensão multiagente
Os gráficos de agente precisam de um modelo pai/filho estável para que os custos sejam acumulados corretamente:
session (root)
  └─ agent.run {wsw.route, wsw.tenant_id}
       ├─ rag.retrieve {wsw.agent_step=retrieve}
       ├─ gen_ai.chat {wsw.agent_step=plan, model=…}
       ├─ tool.execute {tool=…, wsw.retry_n}
       ├─ gen_ai.chat {wsw.agent_step=synthesize}
       └─ eval.score {score.name, score.value}
- Uma raiz por tarefa de usuário — não por chamada LLM. Custo da sessão = soma do filho
wsw.estimated_cost_usd. - Bagagem - propagar
wsw.tenant_idewsw.routeentre trabalhadores/filas assíncronas para que as extensões da ferramenta herdem rótulos de estorno sem reestruturar cada site de chamada. - Ligações — quando um subagente inicia um novo rastreamento (por exemplo, consumidor de fila separado), use links de extensão de volta à sessão pai para que Langfuse/Grafana ainda possa costurar o gráfico.
- Amostra sempre de alto custo — amostragem de cabeça de 5 a 20% é adequada para caminhos felizes; forçar amostra quando o gasto da sessão exceder um limite ou status=ERROR.
4. Métricas que importam (Prometheus)
Exporte histogramas e contadores (via métricas OTEL ou cliente Prometheus). Conjunto mínimo viável:
llm_requests_total{model,route,status}llm_tokens_total{model,direction}onde direção ∈ {entrada, saída}llm_estimated_cost_usd_total{model,tenant,route}llm_ttft_seconds/llm_e2e_secondshistogramasagent_tool_calls_total{tool,status}agent_retries_total{route}agent_task_success_total{route}- denominador de custo por sucesso
Consultas FinOps derivadas (esboços PromQL):
# Cost per successful task (last 1h), by route
sum(rate(llm_estimated_cost_usd_total[1h])) by (route)
  /
sum(rate(agent_task_success_total[1h])) by (route)

# Retry tax
sum(rate(agent_retries_total[1h])) by (route)
  /
sum(rate(llm_requests_total[1h])) by (route)
Thanos (ou Mimir/Cortex) é importante quando o setor financeiro solicita gastos do modelo trimestre a trimestre. Somente o Prometheus local é adequado para plantão; não é um arquivo FinOps.
5. Quadros e alertas Grafana
Envie três públicos de uma fonte de dados:
- De plantão: taxa de erro, p95 e2e, falhas de dependência (vetor DB/ferramentas).
- Plataforma: tokens/s, utilitário GPU (se auto-hospedado), profundidade da fila, TTFT.
- FinOps/produto: $/sucesso por inquilino e rota, solicitações mais caras, combinação de modelos.
Alerta sobre queimadura, não vaidade:
- Custo por sucesso > SLO de orçamento para 30 milhões
- Taxa de novas tentativas > 15% para uma rota
- Violação p95 e2e com tokens de entrada crescentes (regressão imediata)
6. Plataformas nativas LLM: Langfuse, LMNR e amigos
As métricas dizem a você que custo aumentou; As plataformas LLM informam qual versão do prompt e qual extensão da ferramenta fiz isso. Langfuse e LMNR são exemplos de código aberto desta classe:
- Rastreamentos hierárquicos (sessão → agente → LLM/extensões de ferramentas)
- Pontuações humanas e LLM como juiz
- Conjuntos de dados para avaliação offline quando você altera os prompts
- Telemetria de uso opcional para melhoria do produto (respeite as políticas de privacidade)
Padrão de integração: manter o OTEL como sistema de registro do SRE; exportação dupla ou ponte para Langfuse para engenharia imediata. Não invente um segundo dicionário de atributos incompatível.
Experimentos de estrutura, como tempos de execução de agente de primeira função (historicamente comercializados em torno de agentes de streaming estruturados), podem reduzir o clichê, mas tratar estruturas de nicho como opcionais – os padrões de observabilidade sobrevivem a eles.
7. Pipeline de pontuação: manual vs automático
| Método | Implementação | Modo de falha |
|---|---|---|
| Manual | Miniaturas/rubricas na UI Langfuse; comentários sobre conjunto de ouro. | Não escala; ainda necessário para calibração. |
| Automático | LLM como juiz, verificações de unidade, validadores de esquema, recuperação de recuperação. | Deriva do juiz; jogos se otimizar apenas para o juiz. |
Anexe pontuações como eventos de extensão ou pontuações Langfuse digitadas por wsw.prompt_version. Promova promoções de prompts da mesma forma que você controla versões de aplicativos – Ring Promoter para código; portas eval para prompts.
8. Processo de redução de custos (detalhado)
- Semana base: nenhuma mudança de comportamento; apenas instrumentação. Capture $/sucesso, tokens/sucesso, taxa de novas tentativas.
- Atribuição: classificar rotas por gasto × volume. Escolha os três primeiros.
- Roteamento de modelo: dividir classificação/extração para modelos pequenos/locais; mantenha a fronteira para a síntese. Medir novamente os índices de qualidade.
- Cirurgia imediata: remova esquemas de ferramentas não utilizados; encurte alguns tiros; habilite o cache de prefixo onde for seguro.
- Tampas de loop: máximo de chamadas de ferramenta, máximo de rodadas de autodepuração, espera exponencial com disjuntores.
- Amostragem: manter métricas 100%; rastreamentos de amostra (por exemplo, 5–20%) além de amostragem sempre ativa para erros e sessões de alto custo.
- Redação: retirar PII dos atributos de span antes da exportação; armazene prompts completos apenas em lojas aprovadas com TTL.
- Cadência de revisão: quadro semanal de FinOps; calibração mensal do juiz contra humanos.
8b. Gerenciando o uso do agente com orçamentos em tempo real
Os painéis por si só não impedem os agentes em fuga. Aplique orçamentos em tempo de execução, emita a decisão como um evento de extensão e alerte quando as sessões atingirem o limite com frequência:
# Pseudocode: hard budget around an agent session
class Budget:
    def __init__(self, max_usd=0.50, max_tool_calls=8, max_llm_calls=12):
        self.max_usd, self.max_tool_calls, self.max_llm_calls = max_usd, max_tool_calls, max_llm_calls
        self.spent = 0.0
        self.tools = self.llms = 0

    def charge(self, usd: float, kind: str):
        self.spent += usd
        if kind == "tool":
            self.tools += 1
        else:
            self.llms += 1
        if self.spent > self.max_usd or self.tools > self.max_tool_calls or self.llms > self.max_llm_calls:
            raise RuntimeError("agent budget exhausted")
- Limites por sessão — USD, chamadas LLM, chamadas de ferramentas (acima).
- Cotas diárias por locatário — Redis/contador digitado por
wsw.tenant_id; retornar um caminho degradado controlado quando esgotado. - Política de modelo por rota - modelos de lista de permissões para
support.triagecontralegal.draft; rejeitar ou reduzir a falta de política e registrarwsw.policy_action=downshift. - Chaves de ferramenta idempotentes - argumentos da ferramenta hash para que as novas tentativas não faturem APIs externos.
- Fórmula de custo —
cost = in_tokens × p_in + out_tokens × p_out + tool_fees; atualizarp_in/p_outa partir de uma planilha de preços versionada para que os dados históricos do Thanos permaneçam comparáveis.
Métrica a ser observada depois que os limites chegarem: agent_budget_exhausted_total{route,reason}. Um pico significa abuso, um ciclo de ferramentas interrompido ou um orçamento muito apertado para cargas de trabalho reais.
9. Esboço de configuração do coletor
# otel-collector-config.yaml (illustrative)
receivers:
  otlp:
    protocols:
      http:
      grpc:
processors:
  memory_limiter: {}
  batch: {}
  attributes/redact:
    actions:
      - key: gen_ai.prompt
        action: delete
exporters:
  prometheus:
    endpoint: "0.0.0.0:8889"
  otlp/langfuse:
    endpoint: "${LANGFUSE_OTLP_ENDPOINT}"
    headers:
      Authorization: "Bearer ${LANGFUSE_KEY}"
service:
  pipelines:
    traces:
      receivers: [otlp]
      processors: [memory_limiter, attributes/redact, batch]
      exporters: [otlp/langfuse]
    metrics:
      receivers: [otlp]
      processors: [memory_limiter, batch]
      exporters: [prometheus]
10. Prós, contras e quando não se preocupar
Prós: estorno, triagem de incidentes mais rápida, ROI mensurável em alterações imediatas/de modelo, trilhas de auditoria de fácil conformidade, linguagem compartilhada entre equipes de ML e de plataforma.
Contras: dívida de instrumentação; custo de armazenamento se você mantiver cada prompt para sempre; risco de enviar PII para o back-end errado; outro console para os engenheiros aprenderem.
Pule (por enquanto) se: você tem um único trabalho em lote off-line com gastos diários fixos e sem agentes interativos. Ainda registra tokens; pule a pilha multi-backend completa até que a simultaneidade apareça.
11. Lista de verificação de migração
- ☐ OTEL SDK no tempo de execução do agente; coletor no cluster
- ☐ Os atributos de span incluem modelo, tokens, custo, inquilino, rota
- ☐ Métricas Prometheus + quadro Grafana FinOps
- ☐ Langfuse (ou LMNR) conectado para pelo menos um caminho crítico
- ☐ Limites rígidos para tokens/ferramentas/novas tentativas
- ☐ Política de redação revisada pela segurança
- ☐ Revisão semanal de $/sucesso para as principais rotas
- ☐ Documento ADR vinculando observabilidade → veiculação (vLLM) → promoção (Ring Promoter)
12. Material Workstation relacionado
- Companheiro de blog de negócios
- Turbocompressão LLMs - corrija a veiculação depois de ver o gargalo
- Ring Promoter - promover serviços de agentes com portões de saúde
- Muse Glimmer/agentes locais
- Entre em contato com Workstation para compromissos do Enterprise AI Lab
Referências
Publicado por Workstation.


