拆箱 Mac Studio M4 並執行您的第一個 LLM
一下午從 mactop 在新的 M4 Max、Ollama 安裝、本地 Llama 3 以及專用 RAG 管道上的真實讀數
 Balinder Walia2026年5月15日1 min read

簡短、略讀的內容,是長篇深度剖析的姊妹篇。如需完整演練,請跳至 長篇文章.
桌子上的盒子現在是一個AI裝置
我拆箱了一臺新的 Mac Studio,它配備 M4 Max 晶片、128 個 GB 統一記憶體、40 個 GPU 核心、16 個 CPU 核心和 2 TB SSD。一個下午之內,它就透過 Ollama 在本地執行 Llama 3.1 8B,嵌入我自己的文件,並透過小型 RAG 管道回答有關它們的問題。沒有云賬單,沒有 API 金鑰,沒有資料離開房間。
該部落格是簡短版本。整篇文章深入探討了相同的工作流程。
60秒開箱
在 YouTube 上觀看拆箱短片: https://youtube.com/shorts/HUlUoHNsyNM
經典的蘋果拆箱:最小的紙板、模製凹槽中的機器、電源線。 Mac Studio 外殼大約為 7.7 英寸見方且密集;當你拿起它的那一刻,你就能感受到它的構建質量。設定確實非常快 - Apple ID、語言、FileVault,全部完成。
首次啟動 - 來自 mactop 的真實讀數
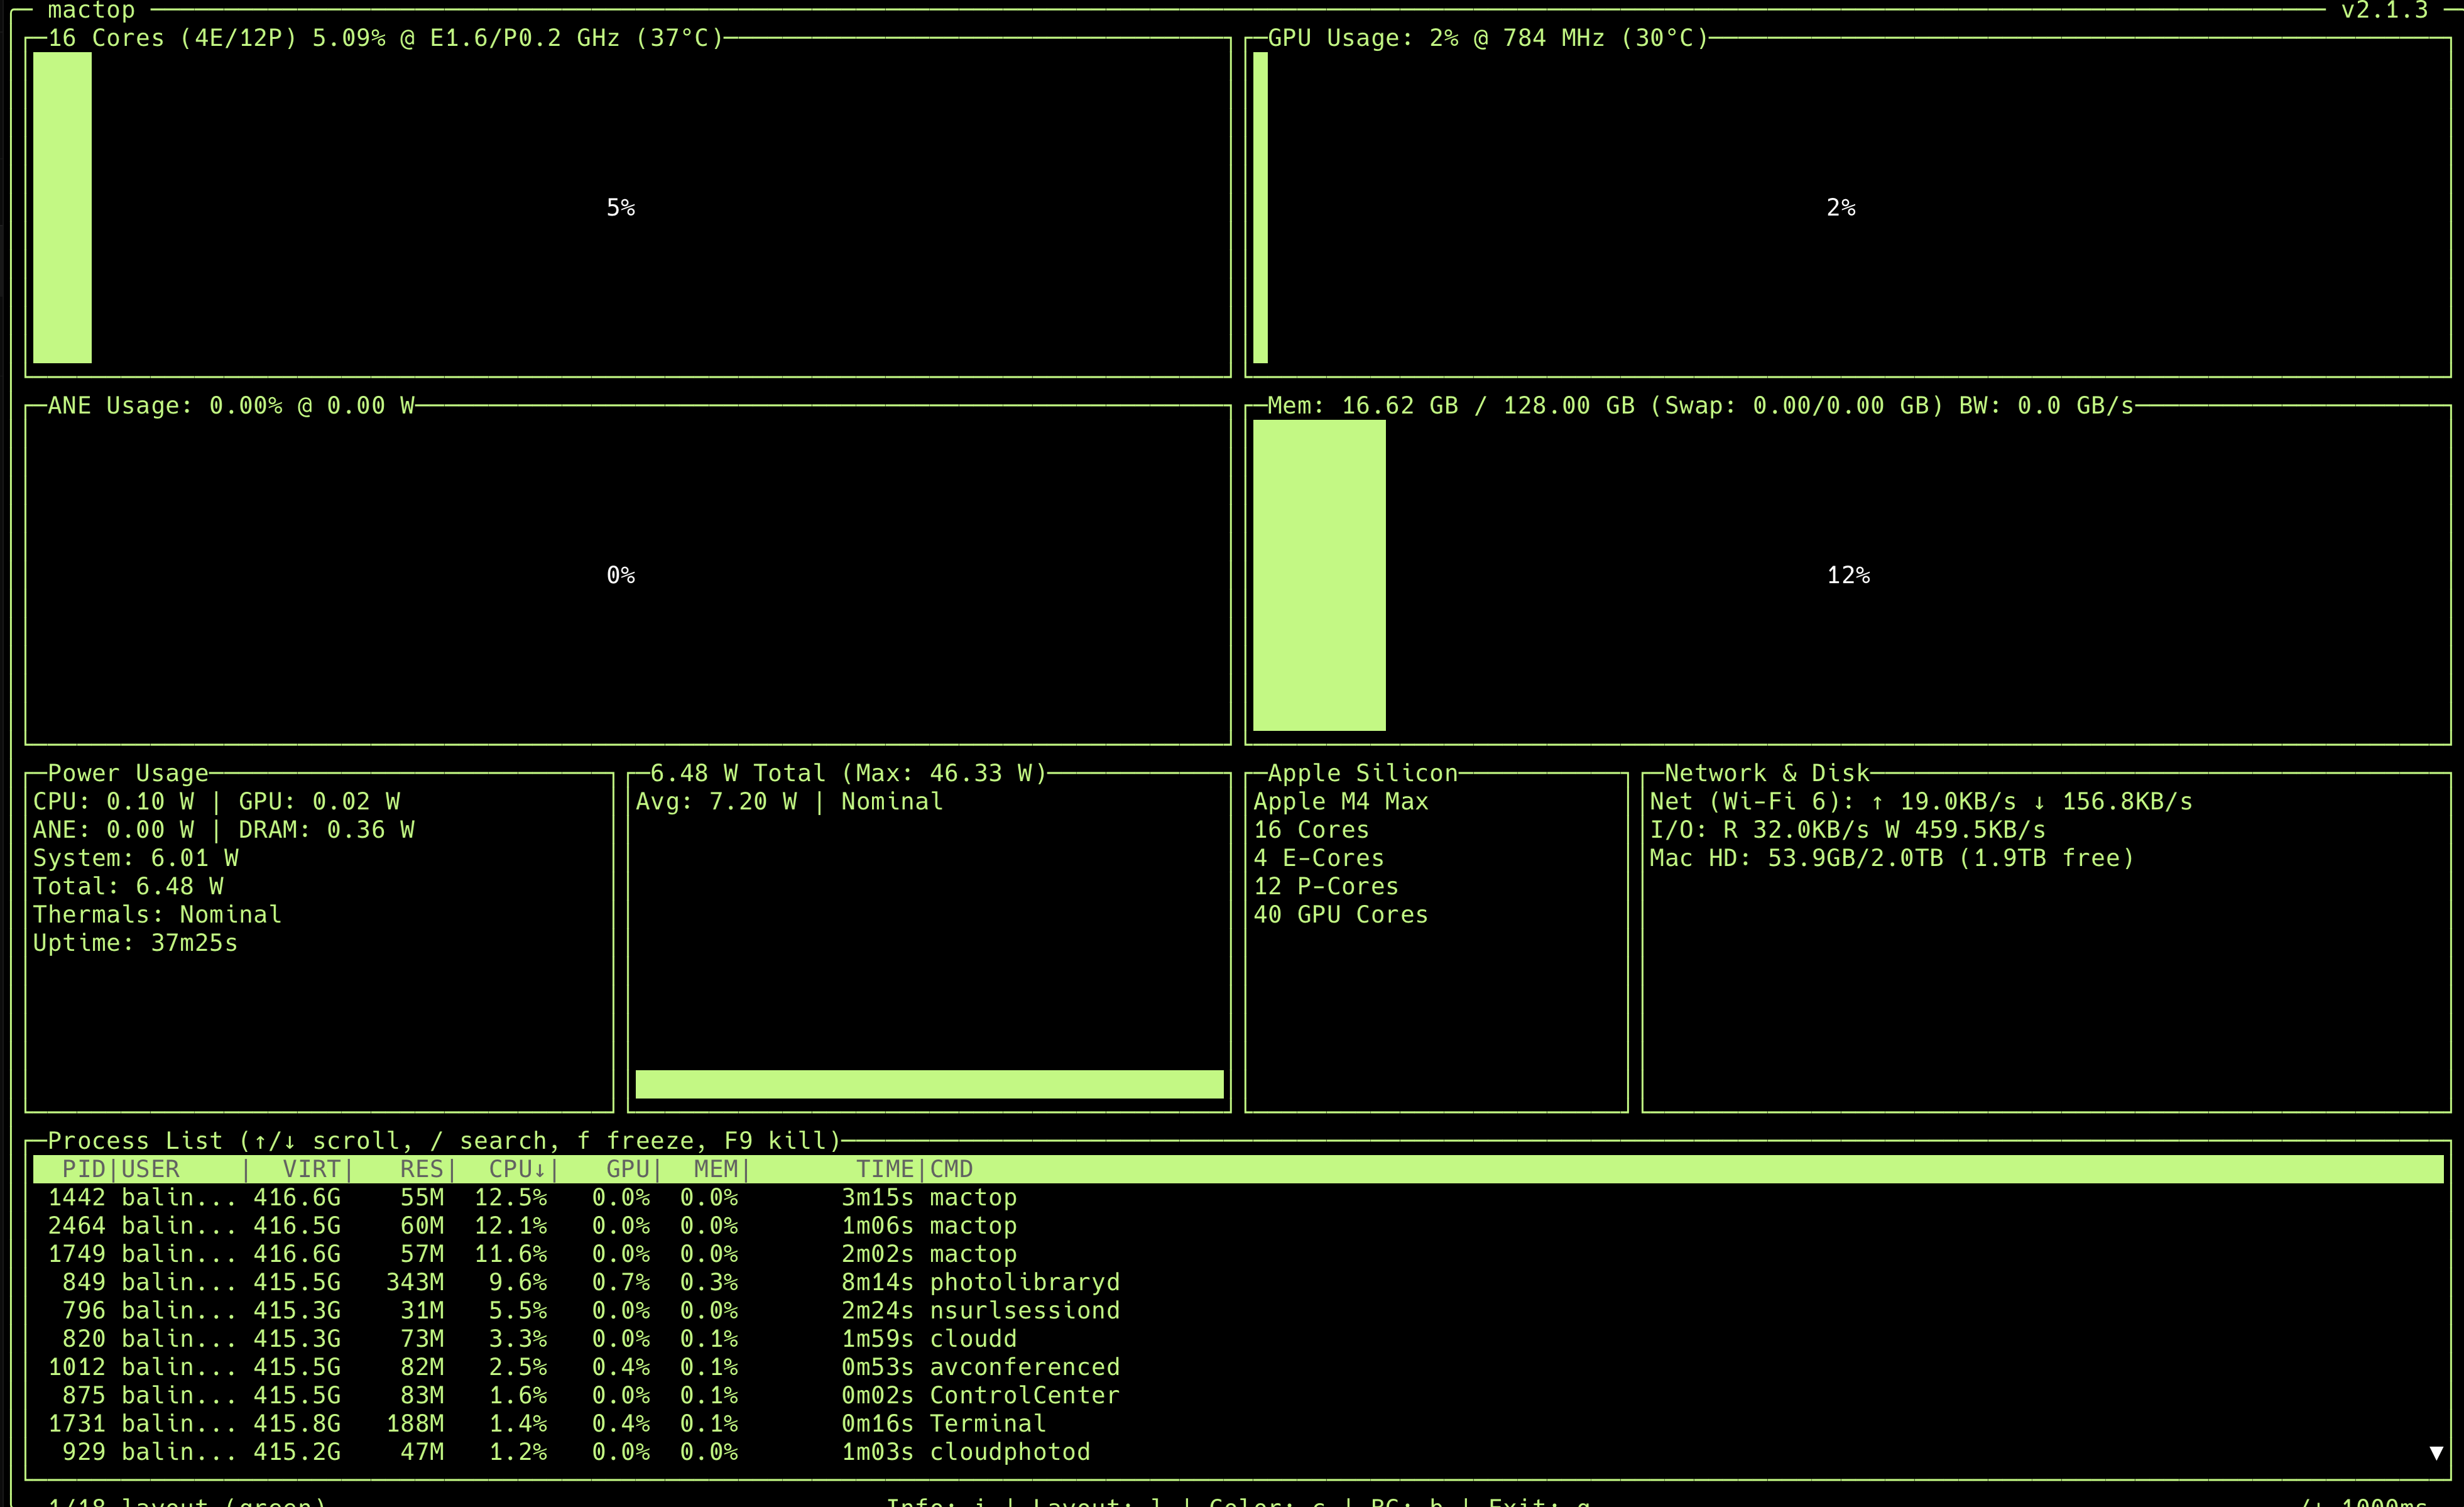
/img/mac-studio-mactop-firstboot.png 稍後再更換。上面的數字是我唯一引用的硬性數字。它們是來自的基本事實 mactop 在我的機器上,正常執行時間為 37 分鐘:
- M4 Max - 16 個核心(4 E + 12 P)、40 個 GPU 核心(784 MHz)、16 核 ANE。
- 128 GB統一記憶體 - 16.62 GB 閒置時使用(約 13%)。
- 6.48瓦 觀察到的最大總空閒功率為 46.33 W。熱量:標稱。
- 2TB 固態硬碟, 初始設定後有 1.9 TB 可用空間。
對於我來說,對於具有 128 GB 可用記憶體的桌上型電腦來說,空閒時的功耗為 6.48 W。這個盒子確實是一個低功耗、永遠線上的人工智慧裝置,你可以讓它 24x7 執行,而無需考慮電費。
為什麼這個硬體很特別——一段統一記憶體
在傳統 PC 上,CPU 具有系統 RAM,GPU 具有獨立的 VRAM。必須先透過 PCIe 複製模型,然後 GPU 才能執行該模型;如果模型大於 VRAM,則不適合。在 Apple Silicon 上,CPU、GPU、神經引擎和媒體引擎共享 一 128 GB 池。沒有任何內容被複制。 Q4_K_M 處的 70B 引數 LLM(磁碟上大約有 40 個 GB,公開估計)載入了大約 80 個仍可用於上下文、應用程式和工具的 GB。這就是本地 LLM 在 Mac 上感覺不同的原因。
只需三個命令即可從盒子到第一個 LLM
brew install ollama
ollama serve &
ollama run llama3.1:8b "Explain unified memory in 3 sentences."
這就是真正的整個培養過程。第一次執行下載模型(公開估計,磁碟上的 Llama 3.1 8B Q4_K_M 約為 4.7 GB)並將其載入到統一記憶體中。之後,對話流變得流暢,具有明顯的第一個令牌延遲,並且透過響應輸出穩定。如果沒有適當的基準方法,我故意不在這裡釋出每秒令牌數;長篇文章進入推理。
不到 60 行 Python 的本地 RAG
使用本地 LLM 可以做的最有用的事情就是將其指向您自己的文件。最小可行堆疊是:
- PyMuPDF 或者
unstructured用於解析 - nomic-embed-text 透過 Ollama 進行嵌入
- ChromaDB 對於向量儲存
- Llama 3.1 8B 透過Ollama進行生成
完整的程式碼位於 長文章。標題是:一切都在 Mac Studio 上執行,沒有外部 API 金鑰,沒有按令牌計費,沒有資料離開機器。
Mac Studio 與雲 - 誠實的決策矩陣
Mac Studio 的優勢在於:始終線上的私有推理、基於您自己的資料的 RAG、IDE 副駕駛、代理原型設計、學習堆疊和家庭實驗室。雲的優勢在於:突發訓練作業、>70B 規模的生產服務、不可預測的全球流量以及需要 8 倍 A100/H100 並行度的工作負載。大多數團隊最終都會同時使用兩者。這篇長文章有一個完整的決策矩陣作為 SVG。
一週後五節課
- 隱私解鎖新的用例。 當模型是本地的時,我會毫不猶豫地貼上生產日誌、內部文件和客戶電子郵件。這改變了我的工作方式。
- 每次查詢的成本既包括心理成本,也包括財務成本。 沒有賬單意味著更多的疑問、更多的實驗、更多的好奇心。
- 128 GB 是最佳選擇。 64 GB 是適合嚴肅工作的地板。 128 GB 為您提供了在 Q4_K_M 執行 70B 的空間,並且仍然有空間用於其他一切。
- Ollama 是輕鬆的入口。 LM Studio 作為模型瀏覽器非常出色,如果您剛開始使用 Python,MLX 非常出色,llama.cpp 是這一切的基礎。
- 雲並沒有死。 它仍然是訓練、橫向擴充套件服務和未知負載工作負載的正確工具。
接下來是什麼
未來的文章將涵蓋 Apple Silicon 上的 MLX 微調、帶有 EXO 的多 Mac 推理叢集、代理堆疊 (LangGraph + Ollama) 以及更深入的基準測試方法部分。如果您想要包含所有圖表、程式碼和決策矩陣的長版本,請閱讀 長篇文章。如果您想要視覺版本,請觀看 YouTube 短片。無論哪種方式 - 訂閱該系列的其餘部分。