商店現已上線

我們打造用於網站、AI 智慧體和 LLM 訓練的 Workstation AI 機器——線上配置併購買。

獲取同行價格
AI 產品
AI 實驗室OpenAI 智慧體Claude 代理Grok BotWorkstation AI 原生 CRM營銷所有產品
AI 解決方案
應用型 AIAI 智慧體生成式 AIAI 自動化AI 技能提升中小企業 AI 套餐企業 AI 實驗室AI 工作站NVIDIA 硬體與軟體NVIDIA 加速計算私有 AIGPU 私有云GPU 叢集邊緣 AI行業 AI
AI 服務
平臺現代化數字工程資料基礎與 AI自主運營AI 諮詢DevOps 自動化網路安全軟體開發智慧體構建MLOps 搭建GPU 租賃GPU 私有云
關於我們
公司我們的故事合作伙伴客戶案例
AI 資料中心
AI 資料中心GPU 私有云GPU 叢集GPU 租賃
AI 洞察Jev 系列基準測試實驗室模型選擇
技術說明
文件
Linux 作業系統UbuntuRed Hat Enterprise LinuxSUSE LinuxAlpine LinuxDebian、Rocky 與 AlmaLinux
AI 雲平臺AWS 與 Amazon BedrockGoogle Cloud 與 Vertex AIMicrosoft Azure 與 AI FoundryGPU 雲與算力市場
私有 AI 資料中心面向律師事務所面向會計師事務所本地部署平臺全面安全的雲
工具Ring PromoterJobshout
新聞
部落格
聯絡我們登入

面向現代企業的 AI 工作站、AI 多智慧體軟體、GPU 基礎設施和智慧代理解決方案。

聯絡我們

AI 解決方案

應用型 AIAI 智慧體生成式 AIAI 自動化AI 技能提升中小企業 AI 套餐企業 AI 實驗室行業 AI

產品

所有產品Workstation AI native CRM 與 ERP營銷OpenAI 智慧體Ring PromoterJobshout

公司

關於我們公司AI 資料中心為什麼選擇Workstation合作伙伴客戶案例定價聯絡TenthMatrix

資源

AI 洞察技術說明文件Linux 作業系統AI 雲平臺私有 AI 資料中心部落格搜尋網站地圖
英國總部
77-79 Marlowes, Hemel Hempstead HP1 1LF路線指引 — 從 M25 外環倫敦 20 號出口駛出公司編號: 11641870週一至週五:上午 9:00 - 下午 6:00 GMT
+44 7515 356 146
比利時辦公室
Workstation SRL, Rue Vanderkindere 34, 1180 Uccle, BrusselsBE 0751.518.683週一至週五:上午 9:00 - 下午 6:00 CET
+32 492 45 67 46
印度辦公室
#159 Sector 9, Pocket 1, DDA Flats, 110077 Dwarka, New Delhi
+91 98881 98841
台灣辦公室
3F, No. 2-4, Aisi Rd., Ren'ai Dist., Keelung City 200, Taiwan基隆市仁愛區愛四路2之4號3樓週一至週五:上午 9:00 - 下午 6:00 臺灣時間(GMT+8)
+886 926 892 701+32 492 45 67 46

© 2026 Workstation AI。保留所有權利。

隱私資料刪除Cookie服務條款網站地圖

NVIDIA、NVIDIA 標誌、RTX、RTX PRO、Blackwell、CUDA、NVLink、MGX、Omniverse、Spectrum-X、Quantum、BlueField、DGX 與 HGX 為 NVIDIA Corporation 在美國及其他國家的商標及/或註冊商標。AMD、AMD Arrow 標誌、EPYC、Instinct、Ryzen 與 Threadripper 為 Advanced Micro Devices, Inc. 的商標。Dell 與 PowerEdge 為 Dell Inc. 或其子公司的商標。Intel 與 Xeon 為 Intel Corporation 或其子公司的商標。AMAX、AceleMax 與 LiquidMax 為 AMAX Engineering Corporation 的商標。所有其他產品名稱、標誌與品牌均為其各自所有者之財產。我們使用它們僅為識別我們所描述、供應或支援的產品;使用這些名稱並不表示其所有者為我們背書。

Loading blog...

首頁 / 部落格
AILLMMachine LearningGPUMLOpsPerformanceKubernetes

渦輪增壓LLMs

PagedAttention、vLLM、Self-Debugging、PowerInfer 和 EG-MLA — 如何在不浪費 GPU KV 快取的情況下擴充套件 LLM 代理

Balinder Walia2026年8月30日1 min read
Turbocharging LLMs with PagedAttention, vLLM, PowerInfer and EG-MLA

Workstation關於如何在生產中增強大型語言模型:PagedAttention、vLLM、Self-Debugging、PowerInfer 和 EG-MLA — 以及 GPU 上實際顯示的權衡。深入探討:長文。入門:LLMs 解釋 + Kubernetes。
Turbocharging LLMs cover

底線。當 KV 快取碎片時,吞吐量會下降。像作業系統一樣對快取進行分頁(vLLM 內的 PagedAttention),選擇與盒子匹配的令牌引擎(胖消費者 GPU 上的 PowerInfer,服務叢集上的 vLLM),在架構允許時縮小注意力 (EG-MLA),並限制代理除錯迴圈,以便質量不會帶來無限制的延遲。

手錶:LLM 實際上是什麼

上下文,而不是產品演示:大型語言模型簡介 (Andrej Karpathy)。與我們的簡單英語 LLM + Kubernetes 指南配對。

的擴充套件問題

LLMs 解鎖了對話式 AI 和生成,然後立即成為服務問題。每個解碼步驟都會將鍵和值附加到 KV 快取中,該快取隨著序列長度和批次大小而增長。簡單的引擎預先保留巨大的連續板。當其他請求等待時,大部分記憶體處於空閒狀態。儘管 GPU 看起來“滿”,但吞吐量卻崩潰了。

PagedAttention:注意

的虛擬記憶體
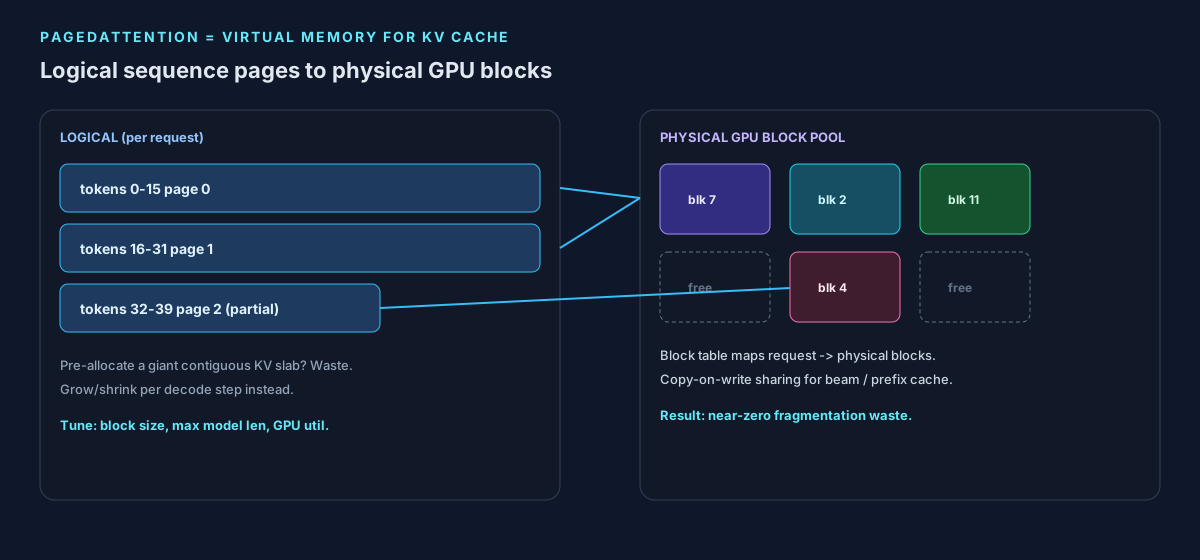
PagedAttention maps logical token pages to physical GPU KV blocks

PagedAttention(Kwon 等人,SOSP 2023)將 KV 快取視為作業系統分頁:固定大小的塊、每個請求一個塊表、非連續的物理頁[arXiv:2309.06180]。核心在關注時間收集塊。您仍然必須調整塊大小、最大模型長度和快取層次結構(GPU HBM 與 CPU 解除安裝與字首快取)。太小的塊會增加對映開銷;太大的塊會重新引入廢物。

vLLM:接近零浪費的

vLLM是圍繞PagedAttention構建的服務系統。它的目標是接近零 KV 浪費、連續配料和相容 OpenAI 的 HTTP 表面。在生產中,請注意三件事:(1)gpu_memory_utilization與 OOM,(2) 首次令牌時間與解碼令牌/秒,(3) 字首/提示快取是否會更改評估集的答案。快取是吞吐量的勝利;它並非沒有正確性和尾部延遲效應。

from vllm import LLM, SamplingParams

llm = LLM(model="meta-llama/Llama-3.1-8B-Instruct", gpu_memory_utilization=0.90)
params = SamplingParams(temperature=0.2, max_tokens=256)
outs = llm.generate(["Explain PagedAttention in one paragraph."], params)
print(outs[0].outputs[0].text)

這才是真正的vLLM用法。 Hugging Face BERTforward()呼叫是,而不是PagedAttention — 不要將分類器 logits 與分頁 KV 服務混淆。

Self-Debugging:具有延遲預算的質量迴圈

Self-Debugging(Chen 等人)教導模型根據少量軌跡修復自己的預測程式,匹配或擊敗發出 10 倍以上候選的基線 [arXiv:2304.05128]。對於代理商來說,這就是黃金——直到反饋輪累積為止。限制除錯訊息的數量,記錄每一輪,並在預算耗盡時向人類或較小的專業模型關閉失敗。

觀看:服務和推理上下文

關於快速 LLM 服務的上下文討論 — 不是官方的 Workstation 演示。與 vLLM 紙和docs.vllm.ai配對。

PowerInfer:單胖 GPU

上的令牌

PowerInfer 分離熱/冷神經元,因此消費者 GPU 和 CPU 可以快速生成令牌。報告資料:13.20 個令牌/秒平均,峰值29.08 個令牌/秒在一臺 NVIDIA RTX 4090 上,11.69x與 llama.cpp 相比,同時保持精度[PowerInfer]。 在艦隊規模上,您仍然需要放置:哪些層保留在 GPU 上,如何跨節點分片,以及提示的位置配置檔案是否與論文的模型匹配。

EG-MLA:在不破壞工作臺的情況下縮小 KV

EG-MLA(嵌入門控多頭潛在注意力)報告超過 91.6% KV 快取減少與多頭注意力相比,降級可忽略不計,與 MLA 相比額外節省(高達 59.9%),並且推理套件得分更高,縮放超過 1B 引數[EG-MLA 論文]。將其視為一種架構選擇,而不是凍結的 vLLM 檢查點上的插入標誌 - 在慶祝記憶體圖之前驗證您的評估工具。
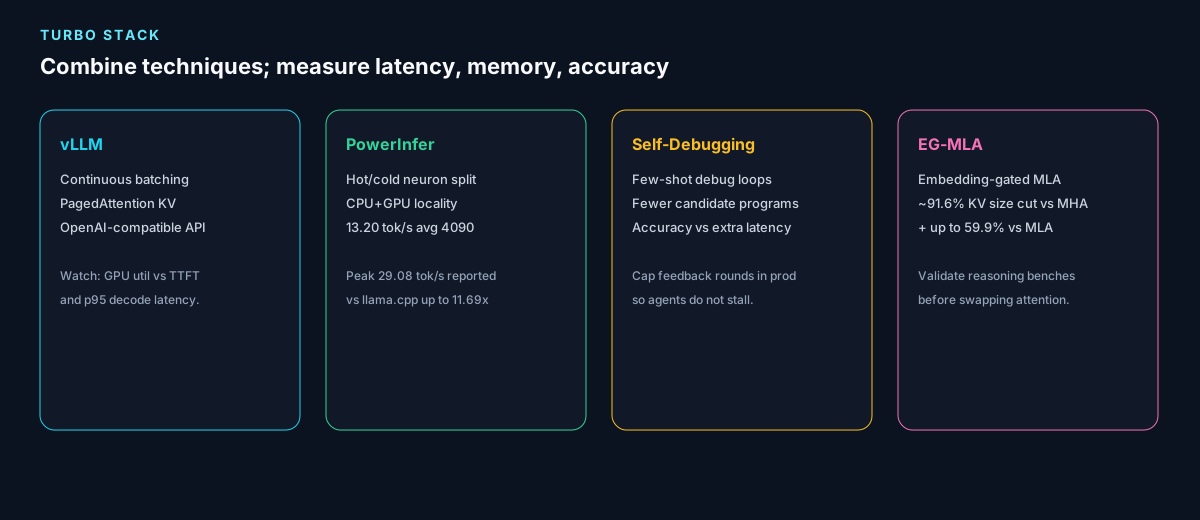
vLLM, PowerInfer, Self-Debugging and EG-MLA stack

將其放在一起

結合 PagedAttention + vLLM 進行叢集服務,PowerInfer(當盒子是工作站 GPU),Self-Debugging 內部編碼代理具有硬輪限制,以及 EG-MLA(當您控制模型系列時)。分散式服務增加了複雜性:KV 並行性、預填充/解碼分割以及不會影響頁表的自動縮放。措施。然後寫ADR。

讀取下一個

  1. 長文— 旋鈕、故障模式、Kubernetes 註釋。
  2. LLMs 解釋 + 在 Kubernetes
  3. 上執行您自己的
  4. Muse Glimmer / 本地代理·企業人工智慧實驗室

由Workstation釋出。