這是長篇深入探討。如需更快、略讀的版本,請參閱 同伴部落格文章.
1. 簡介:為什麼選擇 Mac Studio 來實現本地 AI?
本地人工智慧不再是業餘愛好者的好奇心。隨著 Meta、Mistral、Qwen 和 Microsoft 的開放權重模型的快速成熟,以及 Apple Silicon 的統一記憶體突破了 128 GB 閾值,您現在可以在一臺臺式計算機上安靜地執行強大的大型語言模型、嵌入管道和完整的 RAG 堆疊,而功耗預算僅為典型工作站 GPU 的一小部分。
本文將介紹如何拆箱 Mac Studio 與 M4 Max 晶片,第一次啟動,裝置上的真實讀數 mactop,以及從“盒子在我的桌子上”到“我正在與本地執行的 Llama 3 聊天並使用 RAG 查詢我自己的文件”的實用路徑。這裡的每一個建議都是基於我在機器上實際觀察到的。沒有發明的基準數字,沒有營銷廢話——只有工作流程。
如果您是工程師、AI 構建者、SRE 或技術主管,正在決定 Mac Studio 是否屬於您團隊的硬體組合,那麼本指南適合您。

2. Mac Studio M4 Max 拆箱
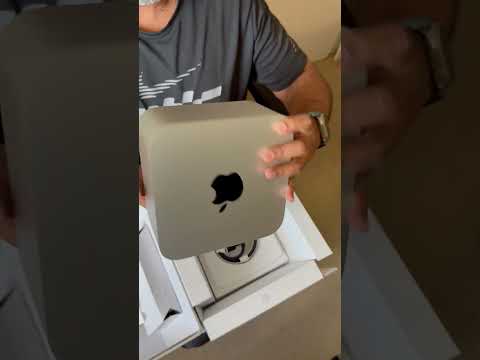
拆箱體驗是經典的蘋果風格:最小的紙板,機器放在模製凹槽中,一根短的黑色電源線,僅此而已。沒有臃腫的配件包。 Mac Studio 本身與最初的 M1 Ultra 推出的緊湊型鋁擠壓外殼相同:大約 7.7 英寸見方,握在手裡很密集,底部有熟悉的板條進氣口,背面有一系列埠。
在 YouTube 上觀看拆箱短片: https://youtube.com/shorts/HUlUoHNsyNM
我拍攝了拆箱短片 - 請觀看上面的 YouTube 短片。短片之所以適合這種格式,是因為實際設定速度非常快。第一個外掛、顯示器喚醒、Apple ID 登入、語言和區域、FileVault,幾分鐘之內您就可以使用可用的桌面。
2.1 首次啟動 - 實際讀數 mactop
系統完成初始同步後我做的第一件事就是安裝 麥克託普 - 一個優秀的開源 TUI 儀表板,可實時顯示 Apple Silicon 的內部計數器。以下是全新安裝的儀表板在正常執行 37 分鐘後的樣子:
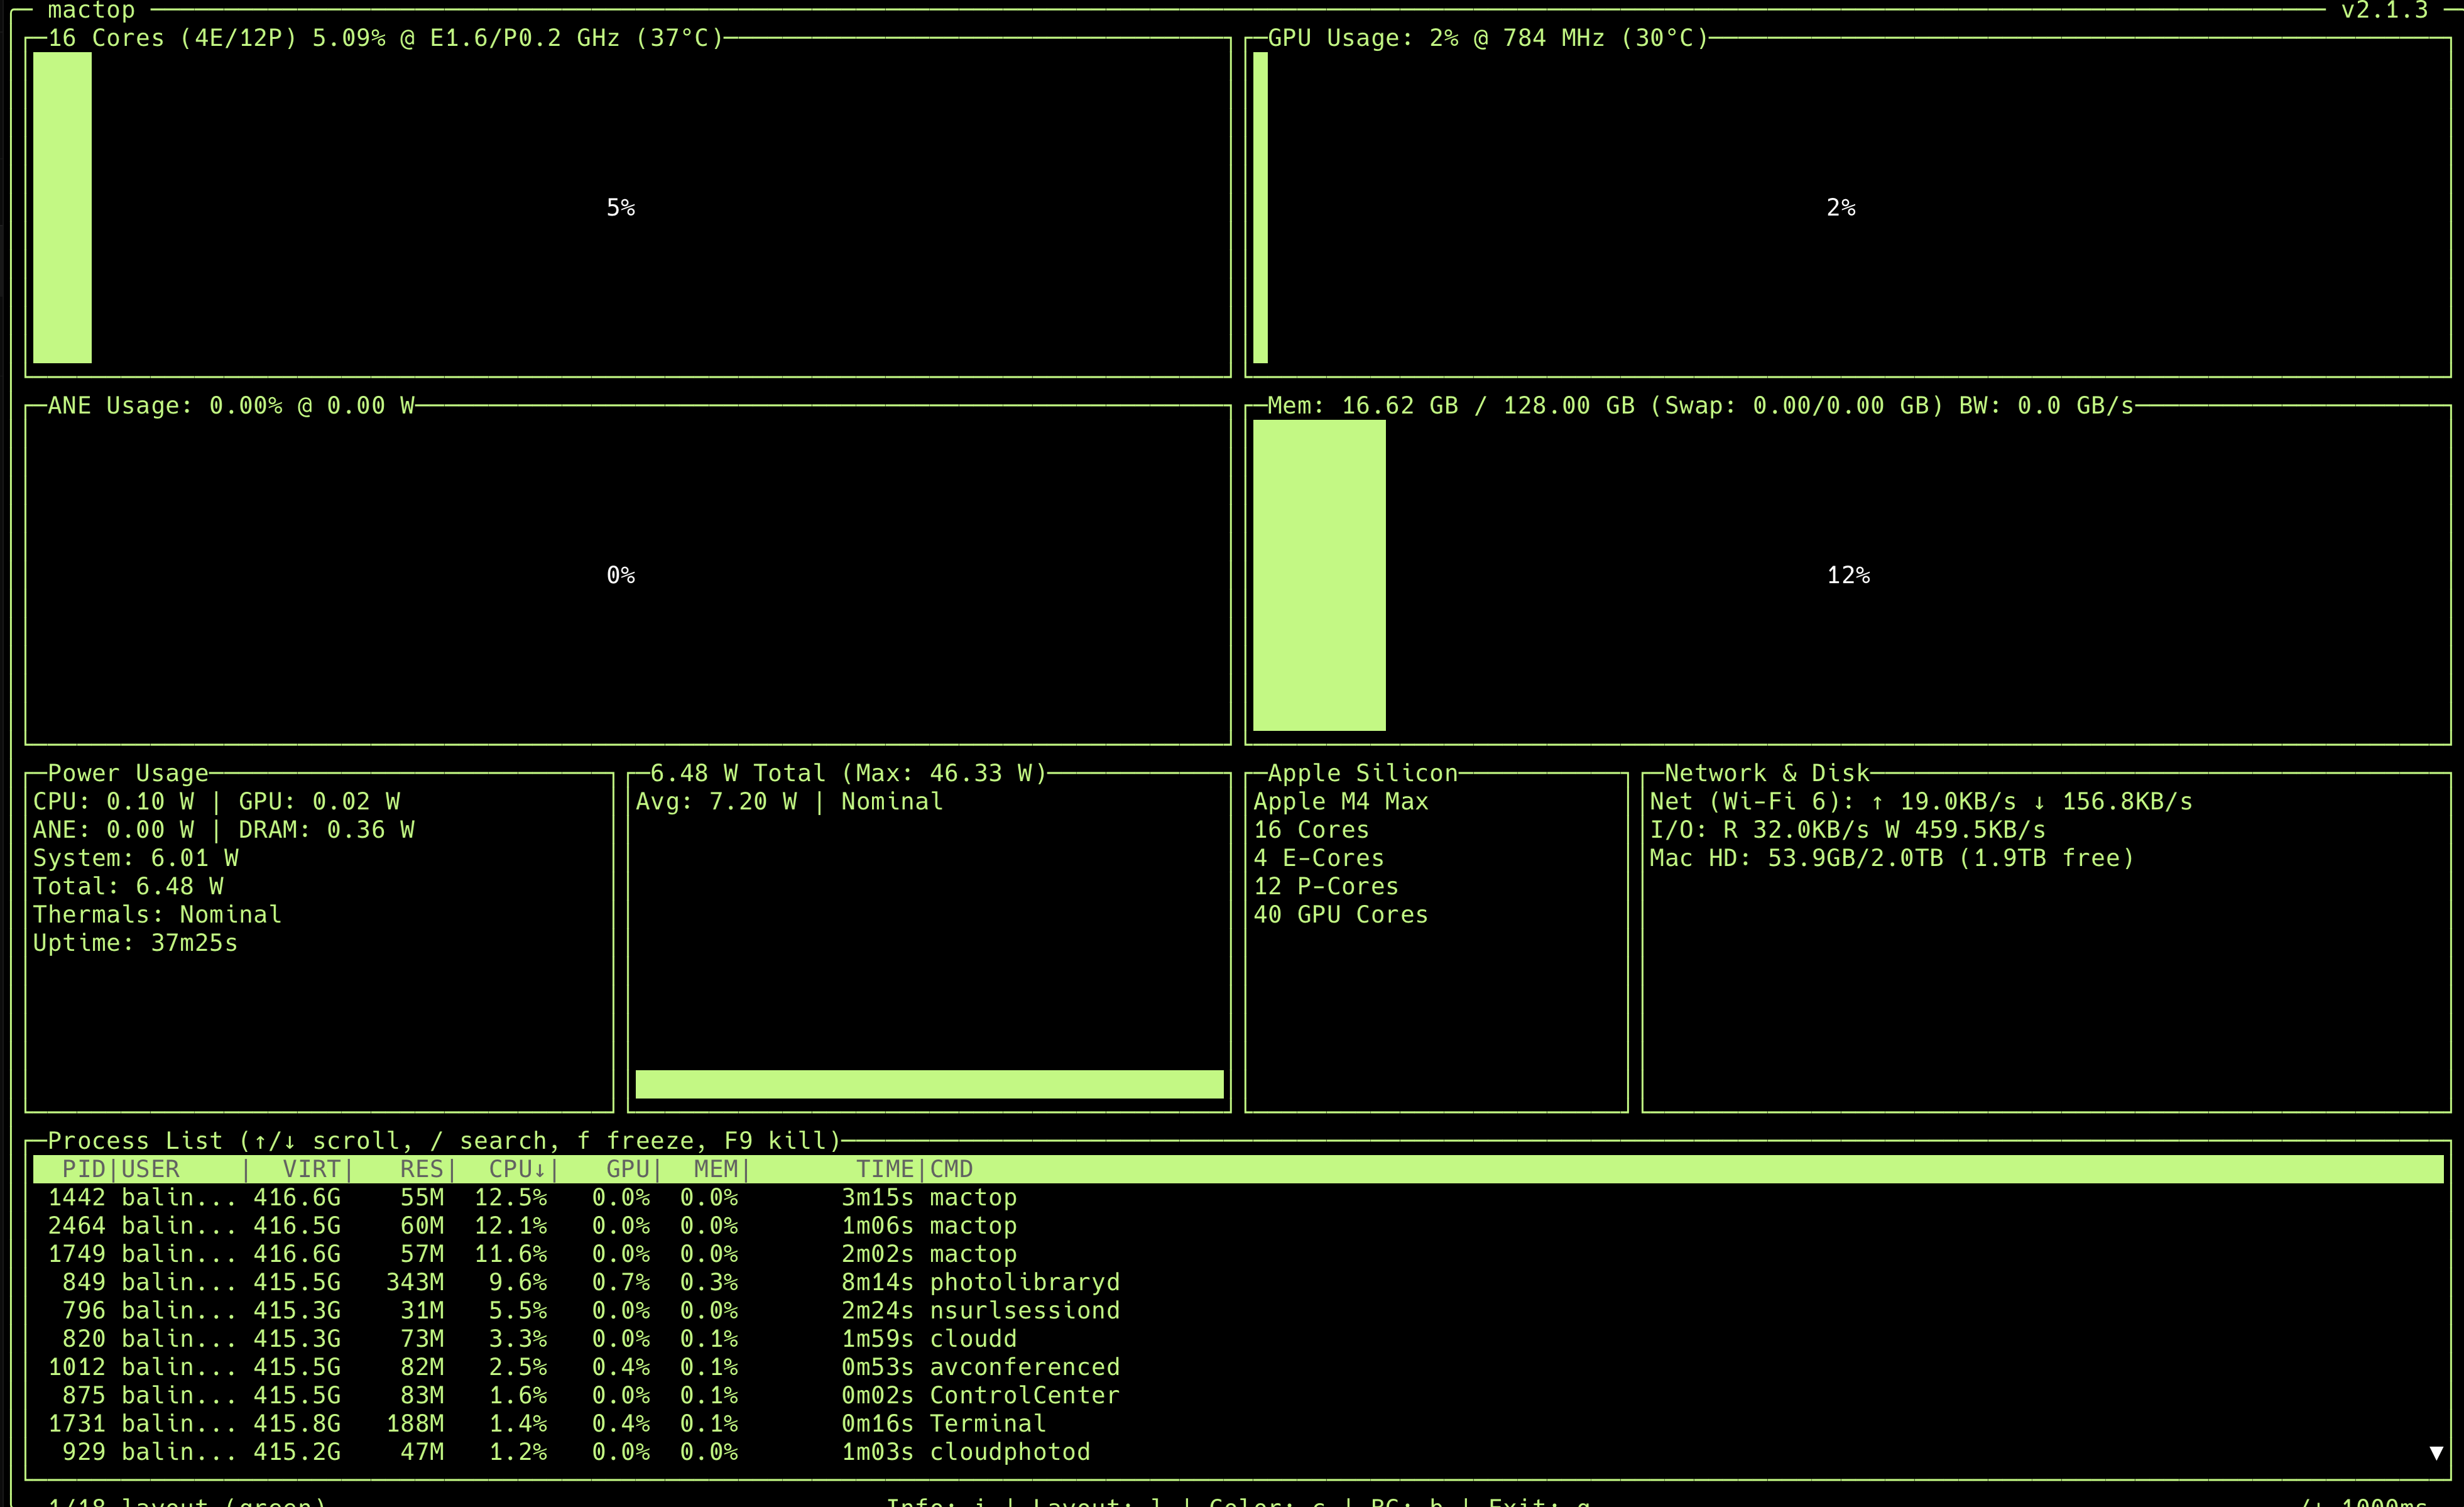
/img/mac-studio-mactop-firstboot.png 稍後再更換。該螢幕截圖中的數字是我將在本文中引用的唯一硬數字。它們是我的機器在全新設定下閒置時的基本事實:
- Apple Silicon: M4 Max
- CPU: 總共16個核心——4個效率核心+12個效能核心; E 簇頻率為 1.6 GHz,P 簇頻率為 0.2 GHz; 37℃封裝
- GPU: 40 個核心,784 MHz,30 C
- 神經引擎(ANE): 16 核,空閒時功耗 0.00 W
- 統一記憶體: 總共 128.00 GB,空閒時使用 16.62 GB(約 13%)
- 力量: 總計 6.48 W - CPU 0.10 W、GPU 0.02 W、ANE 0 W、DRAM 0.36 W、系統 6.01 W。會話中觀察到的最大功率為 46.33 W。散熱:標稱。
- 貯存: 2.0 TB Mac HD,1.9 TB 可用空間; 53.9 作業系統使用的 GB 和初始設定
- 網路: Wi-Fi 6,後臺同步期間上傳示例讀數為 19.0 KB/s,下載示例讀數為 156.8 KB/s
有兩件事很突出。第一的, 閒置時 6.48 瓦 對於擁有 128 GB 可用記憶體的桌上型電腦來說,這是非常了不起的 - 這比許多膝上型電腦在螢幕關閉時消耗的記憶體還要少。其次,GPU 的頻率為 784 MHz,有 40 個可用核心;只要您將 LLM 放在該池前面,該池就可以開始實際工作了。
3. 為什麼Mac Studio M4 Max對於本地AI來說是驚人的
要理解為什麼這種硬體非常適合本地人工智慧,以及為什麼“統一記憶體”不僅僅是一個營銷口號,它有助於將其直接與規範的替代方案進行比較:PC 中的分立 GPU 卡,透過 PCIe 與系統 RAM 進行通訊。

3.1 通俗語言統一記憶
在傳統的 PC AI 裝置上,有兩個記憶體池。當您從磁碟載入作業系統、應用程式和模型權重時,系統 RAM(通常是 DDR5 的 64-256 GB)會儲存它們。 GPU 有自己的 VRAM - RTX 4090 上有 24 個 GB,5090 上有 32 個 GB,A100 上有 80 個 GB。在 GPU 可以執行單個 matmul 之前,模型必須是 複製的 透過 PCIe 匯流排從系統 RAM 到 VRAM。如果模型大於 VRAM,則它要麼根本不載入,要麼透過 PCIe 以殘酷的成本進行分頁(通常比完全在 VRAM 中執行慢 10-100 倍)。
Apple Silicon 將這兩個池合二為一。 CPU、GPU、神經引擎和媒體引擎都看到了 相同的實體記憶體。沒有副本。不存在 PCIe 瓶頸。磁碟上有 40 個 GB 的型號,統一記憶體中就有 40 個 GB,GPU 可以直接讀取。
對於本地 LLM,這是殺手級功能。量化為 Q4_K_M 的 70B 引數模型在磁碟上約為 40 GB(該量化級別的 Llama 級權重的公開引用數字 - 視為近似值)。在 24 GB 消費者 GPU 上,該模型根本不適合。在 128 個 GB 統一記憶體上,它載入了大約 80 個 GB,但仍可用於上下文、應用程式程式碼和工具。
3.2 令人難以置信的電源效率
mactop 螢幕截圖顯示空閒時功耗為 6.48 W,在會話期間觀察到的最大值為 46.33 W。客觀地說:單個 RTX 4090 空閒時的功率為 15-25 W,系統的其餘部分位於頂部,在負載下最高可達 450 W。 Mac Studio 是一款桌面 AI 盒子,您可以 24/7 全天候執行,而不會在電費單上注意到它。它是沉默的。在推理工作負載期間,風扇幾乎從不旋轉。這就是它作為一個可行的 永遠線上的開發盒 分立式 GPU PC 很少採用這種方式。
3.3 Apple 神經引擎的實際用途
ANE 是一款 16 核固定功能加速器,針對 CoreML 生成的張量運算型別進行了最佳化。對於 2026 年大多數開放權重 LLM 工作負載(透過 llama.cpp 或 Ollama 執行的 GGUF 格式),ANE 不在熱路徑中 - GPU 是透過 Metal Performance Shaders 實現的。 ANE 在 CoreML 轉換模型、裝置上語音識別、影象分割和類似的固定形狀工作負載方面表現出色。當它執行時,它也非常節能。知道它的存在很有用;不要指望每個 LLM 堆疊都會使用它。
4. 設定 Mac Studio 進行 AI 工作
在標準 macOS 入門之後,以下是我所遵循的新 Mac Studio 的確切啟動方式,我想將其用作本地 AI 開發盒。
4.1 安裝 Homebrew、Xcode CLT 和基礎知識
/bin/bash -c "$(curl -fsSL https://raw.githubusercontent.com/Homebrew/install/HEAD/install.sh)"

xcode-select --install

brew install git wget jq python@3.12 node pyenv
brew install --cask iterm2 visual-studio-code
Homebrew 帶來了 Unix 工具,Xcode 命令列工具提供了編譯器和連結器,Python 和 Node 為您提供了應用程式程式碼的執行時,而 iTerm2 + VS Code 是我預設使用的編輯器 + 終端對。
4.2 安裝Ollama
Ollama 是在 macOS 上下載、執行和提供開放權重 LLM 的最簡單方法。在它包裹的引擎蓋下 llama.cpp 具有 Metal 加速功能,並在埠 11434 上提供簡單的 HTTP API。
brew install ollama

ollama serve &

ollama --version
也可以透過官方安裝 .dmg 來自 llama.com,它設定了一個選單欄應用程式。任何一條路都有效。我更喜歡無頭盒子的brew install 和日常驅動Mac 的dmg 安裝。
4.3 安裝LM Studio(可選但值得)
LM工作室 是一個用於瀏覽、下載和與 GGUF 模型聊天的桌面 UI。它還公開了相容 OpenAI 的 API。我將它與 Ollama 一起安裝,因為當您在 Q4_K_M 和 Q5_K_M 之間做出決定時,模型瀏覽器非常出色,並且每個模型的效能調整 UI 都很友好。
4.4 在VS Code中安裝Continue.dev
Continue.dev 在 VS Code 中為您提供 ChatGPT 風格的幫助,但指向您本地的 Ollama。安裝擴充套件程式後,將其放入您的 ~/.continue/config.json:
{
  "models": [
    {
      "title": "Llama 3.1 8B (local)",
      "provider": "ollama",
      "model": "llama3.1:8b",
      "apiBase": "http://localhost:11434"
    },
    {
      "title": "Qwen 2.5 Coder 14B (local)",
      "provider": "ollama",
      "model": "qwen2.5-coder:14b",
      "apiBase": "http://localhost:11434"
    }
  ],
  "tabAutocompleteModel": {
    "title": "Codestral (local)",
    "provider": "ollama",
    "model": "codestral:latest",
    "apiBase": "http://localhost:11434"
  }
}
現在,您可以進行內聯聊天、編輯和自動完成 - 所有命中模型都與您的編輯位於同一張桌子上。零資料離開機器。
5. 執行您的第一個 LLM

關鍵時刻到了。拉取模型並執行它。
5.1 拉Llama 3.1 8B
ollama pull llama3.1:8b

ollama list

ollama run llama3.1:8b "Explain unified memory architecture to me in 3 sentences."
拉取下載 Q4_K_M GGUF(Q4_K_M 處的 Llama 3.1 8B 約為磁碟上的 4.7 GB - 公開引用的數字,視為近似值)。在像我這樣的 Wi-Fi 6 連線上,下載需要幾分鐘;在有線千兆位上速度更快。落地後,第一個 ollama run 包括將一次性模型載入到統一記憶體中 - 您會注意到第一個令牌流之前有短暫的暫停 - 然後後續執行速度很快。
我故意不會在這裡引用我自己的機器的每秒令牌數,因為我還沒有使用配對方法執行受控基準測試套件。我要說的是,在此類硬體(具有 40 個 GPU 核心的 M4 Max)上,您應該期望 流暢的對話式流媒體 來自 Q4_K_M 的 8B 模型,具有明顯的初始負載延遲和整個響應過程中的穩定輸出。如果您在其他地方讀過諸如“我在 Mac 上每秒獲得 60 個令牌”之類的宣告,請將它們視為大致指導;您的實際數字將隨提示長度、上下文視窗、量化級別、模型架構以及其他正在執行的內容而變化。
5.2 選擇量化 - Q4_K_M、Q5_K_M、Q8_0
量化會降低模型權重的精度,從而縮小磁碟和記憶體中的模型權重。權衡是質量。這是我在選擇量化人員進行區域性推理時使用的粗略心理模型:
| 定量 | 大約8B尺寸 | 質量與 FP16 | 何時使用 |
|---|---|---|---|
| Q4_K_M | ~4.7 GB | 非常好,小滴 | 預設。聊天和程式碼的最佳速度/質量平衡。 |
| Q5_K_M | ~5.7 GB | 更接近 FP16 | 當您需要更精確的觸控並有空閒記憶體時。 |
| Q8_0 | ~8.5 GB | 近乎無損 | 當您需要小型型號的最高質量和最低噪音時。 |
所有尺寸均為公開引用的 Llama 8B 級重量的近似值。相對順序才是重要的。
5.3 32、64 和 128 GB 的適用範圍
| 統一記憶體 | 現實舒適區 (Q4_K_M) | 伸展(小心) |
|---|---|---|
| 32 GB | 7B / 8B / 13B | 20-22B 在嚴格的背景下 |
| 64 GB | 13B / 20B / 34B | 40-50B 在緊張的環境中 |
| 第128章 | 34B / 70B / 專家混合變體 | 緊張環境下 100-120B |
“舒適區”意味著模型載入時有足夠的空間來容納寬敞的上下文視窗、KV 快取和其他執行的應用程式。 “拉伸”意味著它可以載入,但您開始兼顧上下文長度和其他工作負載。在我的 128 GB 機器上,我可以在 Q4_K_M 上執行 70B,並且仍然有大約 80 GB 的空間用於 VS Code、Chrome 和幾個 Python 程序 - 坦率地說,這是一種奢侈的感覺。
5.4 從 Node 和 Python 呼叫 Ollama
Ollama 在以下位置公開 HTTP API http://localhost:11434。一個小的 Node fetch 看起來像這樣:
// node 20+
const res = await fetch("http://localhost:11434/api/generate", {
  method: "POST",
  headers: { "Content-Type": "application/json" },
  body: JSON.stringify({
    model: "llama3.1:8b",
    prompt: "Write a one-paragraph summary of unified memory architecture.",
    stream: false
  })
});

const data = await res.json();
console.log(data.response);
來自Python:
import requests

r = requests.post(
    "http://localhost:11434/api/generate",
    json={
        "model": "llama3.1:8b",
        "prompt": "Explain HNSW indexes briefly.",
        "stream": False,
    },
    timeout=120,
)
print(r.json()["response"])
這是將本地 LLM 連線到 CLI 工具、Slack 機器人、快捷方式、微服務或內部自動化所需的一切。沒有金鑰,沒有速率限制,沒有配額。
6. 在 Mac Studio 上執行的最佳模型
選擇模型部分是效能,部分是許可,部分是氛圍。這是我在盒子上實際執行的內容,按大小層分組。
6.1 小型(10B 以下):快速的日常主力
- Llama 3.1 8B - 優秀的通用聊天和推理;帶有警告的寬鬆元許可證。
- 米斯特拉爾 7B / 米斯特拉爾 8B - 強大的推理能力,Apache 許可的變體可用。
- 騏文2.5 7B - 非常強大的多語言和程式碼效能。
- Φ3.5迷你 - 體積小,功能驚人,是您需要吞吐量和低延遲時的理想選擇。
- Codestral / Qwen 2.5 編碼器 7B - IDE 工作的快速內聯自動完成。
6.2 中頻 (10B-40B):64-128 GB 的最佳位置
- Llama 3.1 / 3.3 70B (Q4_K_M) - 如果您有 128 GB,則這是頭條型號;近乎前沿的品質,執行舒適。
- 騏文2.5 32B - 優良的質量尺寸比;與 RAG 完美搭配。
- DeepSeek-編碼器 33B - 擅長程式碼生成任務。
- 混合 8x7B - 混合專家,一次僅啟用2個專家,舒適貼合。
6.3 大型(70B 及以上):僅在 96-128 GB 上且僅在 Q4 上
128 GB 的大門向 Q4_K_M 的 70B 級模型敞開。他們是 慢點 與 8B 模型相比,但對於受益於更廣泛的世界知識和更長的推理的任務來說,質量的飛躍是顯著的。預計第一個令牌延遲會更長,流傳輸速度會下降,但實際體驗對於許多工作流程仍然可用。
7. 構建本地RAG管道
一旦您擁有本地 LLM,您可以用它做的最有用的事情就是將其指向您自己的文件。這是檢索增強一代,也是 Mac Studio 作為雲 API 的私有替代方案真正發揮作用的工作負載。

7.1 堆疊
- 文件解析器 - 用於 PDF 的 PyMuPDF,
unstructured用於混合格式攝取。 - 分塊器 - 浪鏈的
RecursiveCharacterTextSplitter或令牌感知分離器。典型的塊大小為 512-1024 個令牌,其中有 64-128 個重疊令牌。 - 嵌入 -
nomic-embed-text或者mxbai-embed-large,均可透過 Ollama 獲得。兩者都在本地 GPU 上執行。 - 向量商店 - 預設為 ChromaDB。 SQLite-VSS 用於零伺服器選項。 LanceDB 如果您想要可擴充套件的單檔案嵌入式選項。
- 發電機 - Llama 3.1 8B 可實現快速週轉,如果您想要最高質量的答案,則可使用 70B。
7.2 最小的 Python 示例 - 端到端
pip install chromadb requests pypdf

import os, glob, requests, chromadb
from chromadb.utils import embedding_functions
from pypdf import PdfReader

OLLAMA = "http://localhost:11434"
EMBED_MODEL = "nomic-embed-text"
GEN_MODEL   = "llama3.1:8b"

def embed(text: str) -> list[float]:
    r = requests.post(f"{OLLAMA}/api/embeddings", json={
        "model": EMBED_MODEL, "prompt": text,
    }, timeout=60)
    return r.json()["embedding"]

def generate(prompt: str) -> str:
    r = requests.post(f"{OLLAMA}/api/generate", json={
        "model": GEN_MODEL, "prompt": prompt, "stream": False,
    }, timeout=300)
    return r.json()["response"]

def chunk(text: str, size: int = 1000, overlap: int = 150):
    out, i = [], 0
    while i < len(text):
        out.append(text[i:i+size])
        i += size - overlap
    return out

client = chromadb.PersistentClient(path="./rag-db")
col = client.get_or_create_collection("docs")

for path in glob.glob("./docs/**/*.pdf", recursive=True):
    reader = PdfReader(path)
    full = "\n".join(p.extract_text() or "" for p in reader.pages)
    for j, c in enumerate(chunk(full)):
        col.add(
            ids=[f"{os.path.basename(path)}::{j}"],
            documents=[c],
            embeddings=[embed(c)],
            metadatas=[{"source": path, "chunk": j}],
        )

def ask(q: str, k: int = 5) -> str:
    qe = embed(q)
    res = col.query(query_embeddings=[qe], n_results=k)
    ctx = "\n\n".join(res["documents"][0])
    prompt = (
        "Answer the question using only the context below. "
        "If the answer is not in the context, say you do not know.\n\n"
        f"Context:\n{ctx}\n\nQuestion: {q}\nAnswer:"
    )
    return generate(prompt)

print(ask("What is unified memory and why does it matter for LLMs?"))
這是一個完整的本地 RAG 管道,用不到 60 行 Python 程式碼。整個過程都在 Mac Studio 上執行。沒有外部 API 金鑰,沒有按令牌計費,沒有資料離開機器。第一次攝取大型 PDF 集將需要幾分鐘;後續查詢很快。
7.3 調優注意事項
- 塊大小 - 從 1000 個字元開始,並有 150 個重疊;如果您的來源有很長的結構化部分(法律、技術規範)並且檢索器正在分割答案,請提高。
- 前k - 4-8是實用範圍。走得更高會誇大提示並減慢生成速度,而沒有明顯的收益。
- 重新排名 - 為了獲得最高質量,檢索前 20 名並使用交叉編碼器重新排名(例如
bge-reranker)。在 Mac Studio 上這很便宜。 - 後設資料過濾 - 用源路徑、日期和部分標記塊;在向量搜尋之前的查詢時進行過濾。這是最大的一次精度勝利。
- 流媒體 - 轉變
stream到true在 Ollama 呼叫中並將令牌流式傳輸到客戶端以實現快速的使用者體驗。
8. 日常開發迴圈
使用 Mac Studio 幾周後,我的日常迴圈如下所示:
- 開啟VS Code,Continue.dev針對Ollama進行喚醒。
- 在 Open WebUI(或 LM Studio)中開啟聊天,針對我的筆記進行更長的對話問答。
- 對於程式碼工作:Codestral 或 Qwen Coder 模型上的選項卡自動完成、Llama 3.1 8B 上的較長聊天、70B 上的深度推理會話(當任務需要時)。
- 對於內部 RAG,一個指向專案的 docs/ 資料夾和 Chroma 資料庫的 Python 指令碼。
- 對於代理原型設計,LangGraph 或呼叫 Ollama 端點的小型自定義迴圈 - 相同的模式,不同的粘合。
當您的 LLM 位於本地時,真正改變的是您使用它的方式。查詢不會增加成本,因此您可以向模型提出更多問題。無需擔心隱私問題,因此您可以貼上生產日誌、內部文件、客戶電子郵件。您編寫小型 CLI 指令碼來遍歷 200 個文件以提取結構化摘要,並且您不會再考慮每個代幣的賬單,因為沒有賬單。
9. 與雲的基準和誠實比較
讓我非常直接地說:我不會發布我沒有透過嚴格控制的基準測試方法得出的每秒令牌數。網際網路上充斥著這樣的數字,經常比較不同的量化級別、上下文長度和提示格式,它們令人困惑的程度多於澄清的程度。我要做的是釋出一個決策矩陣來捕獲 Mac Studio 實際勝出的工作負載型別,其中沒有,並且正確答案是“同時使用”。

9.1 盈虧平衡數學
配備 128 個 GB 統一記憶體和 2 TB SSD 的 Mac Studio M4 Max 的價格範圍與始終線上的雲 GPU 例項幾個月的價格大致相同。將所有具體的美元數字視為近似值並作為區域和折扣的函式:
- 一臺 Mac Studio M4 Max,配置良好:一次性大約 4,000-6,000 美元(近似值;配置各不相同)。
- 一臺AWS
g5.xlarge(單 A10G、24 GB VRAM)全天候 24x7 按需執行:每月 700-900 美元左右(取決於地區)。 - 一臺AWS
p4d.24xlarge(8x A100):如果您以某種方式將其開啟(您不會,但它使對比變得明顯),則每月按需訂購 20,000-30,000 美元。
算術表明,對於始終線上的開發盒,與同類始終線上的雲例項相比,Mac Studio 在幾個月內就能收回成本,並且可以在數年內繼續以電費方式收回成本。對於突發訓練工作,數學則相反:租一小時,跑一跑,然後歸還。使用適合工作的正確工具。
9.2 當雲是正確答案時
- 您需要訓練或微調一個比 128 GB 更大的模型。
- 您需要以嚴格的 SLO 和彈性容量為全球使用者群提供大規模服務。
- 您正在執行一個受益於 8x A100 或 H100 並行性的實驗。
- 您的組織的合規性狀況表明推理必須在具有特定審計跟蹤的特定雲區域中執行。
9.3 當 Mac Studio 是正確答案時
- 您希望為您的團隊提供一個始終線上的私人推理機。
- 您正在構建 RAG、代理或 IDE 副駕駛,其中資料駐留和隱私很重要。
- 您需要一個安靜、低功耗、不需要伺服器機房的開發盒。
- 您正在快速進行原型設計,但云 API 的按令牌計費方式阻礙了您。
- 您想學習堆疊 - 擁有一個模型,擁有一個執行時,擁有一個向量儲存,擁有迴圈。
10. 挑戰和限制
如果我不指出其中的粗糙之處,我就不會為這篇文章帶來任何好處。 Apple Silicon 非常適合本地 AI,但也有一些真正的警告。
10.1 訓練仍然比推理弱
Apple Silicon AI 的故事對於 推理 比 訓練。 PyTorch 的 MPS 後端已經顯著成熟,Apple 自己的 MLX 框架也確實不錯,但純 CUDA 訓練工具的廣度仍然更廣泛。如果您的日常工作是新穎的模型架構或大規模微調,您將會遇到在 Linux + NVIDIA 上根本不會遇到的漏洞。
10.2 生態系統在很多地方都採用 CUDA
許多 AI 儲存庫仍然預設採用 CUDA 假設。大多數維護的專案現在都有 Metal / MPS 路徑,但預計偶爾會出現摩擦:需要從原始碼構建的庫、沒有 Metal 等效項的核心、僅在 NVIDIA 上執行的基準套件。為此計劃時間。
10.3 橫向擴充套件是 DIY
一臺 Mac Studio 是一個盒子。類似的工具 EXO 還有一些可以讓你對 Mac 進行叢集,以便在多個裝置上執行非常大的模型,但這並不是你使用 g5 的 Kubernetes 叢集得到的完美故事。如果您的工作負載需要水平彈性,那麼雲仍然更好。
10.4 可修復性和升級
您以後無法新增 RAM。您以後無法更換 SSD(實際上)。買你需要的東西,然後再加一件——尤其是記憶體。 128 GB 層是我推薦用於嚴肅的 AI 工作的層; 64 GB 是地板。
10.5 持續負載下的熱量
Mac Studio 在空閒時執行涼爽且安靜(上面的螢幕截圖顯示 37°C 和 30°C,風扇聽不到)。在持續的重 LLM 負載下,風扇確實會旋轉 - 聲音不大,但聽得見 - 並且晶片變熱。這完全在標稱熱範圍內;請注意,“靜音”是空閒和輕負載的表徵,而不是絕對的。
11. Apple Silicon 本地人工智慧的未來
三種趨勢正在融合,使 Apple Silicon 上的本地人工智慧在未來 12-24 個月變得令人興奮。
第一的, 開放權重模型在不損失能力的情況下不斷變小。 Phi-3.5、Qwen 2.5 Small 和 8B 的 Llama 3.x 系列均超出其重量級別。在許多工中,2026 8B 型號的質量與 2023 70B 大致相當。這意味著更多的工作負載可以輕鬆容納在 32-64 GB 統一記憶體中,而 128 GB Mac Studio 則成為多型號服務盒。
第二, 蘋果自家的MLX框架不斷完善。 MLX 提供類似 NumPy 的 API、惰性求值、預設的統一記憶體感知以及動態計算圖。 MLX 社群一直在快速移植模型、分詞器和訓練迴圈。如果您今天要在 Mac 上啟動一個新的 ML 專案,MLX 是自然的選擇;如果您使用 PyTorch,則每個版本的 MPS 後端都更可用。
第三, 量化和 KV 快取壓縮不斷變得更好。 Q4_K_M、IQ 系列量化和 GGUF 改進等技術意味著相同的模型比六個月前適合的記憶體更少,質量損失也更少。本地人工智慧正處於一條曲線上,每一代模型+量化配對都擴充套件了消費級硬體的實際覆蓋範圍。
再加上圍繞未來 M 系列晶片(M5、未來的 Ultras、Studio 更新)的謠言,軌跡很明確: 桌邊AI盒子來了,而且還在不斷完善.
12. 將 Mac Studio 強化為團隊 AI 盒子
如果您想與一個小團隊共享您的 Mac Studio - 例如,向少數同事公開 Ollama、一個 Open WebUI 例項和一個 RAG 端點 - 以下是我所做的粗略強化:
- 檔案保險箱開啟 和一個強登入密碼。將其儲存在 UPS 上。
- 尾鱗 位於盒子上,以便您團隊的裝置可以訪問它,而無需將其暴露在公共網際網路上。
- 將 Ollama 繫結到本地主機 並在其前面新增一個瘦身份驗證代理(Caddy、Traefik 或小型 Node/Python 伺服器),該代理在轉發到之前處理身份驗證和速率限制
11434. - 在 Docker Desktop 中執行 Open WebUI 具有持久的卷;將其指向本地 Ollama 端點。
- 備份 將 RAG 資料庫儲存到加密的外部 SSD 或 Time Machine 目標。
- 自動更新 按計劃安裝 macOS 和 Homebrew 軟體包;有意固定 Ollama 和型號版本,而不是自動拉最新版本。
如果做得好,您將擁有一個私有的、易於審計的 AI 端點,您的團隊每天都會使用該端點,並且永遠不會從建築物的網路中傳送令牌。
13. 結論:辦公桌上的一場悄然革命
在 2026 年拆箱 Mac Studio M4 Max 感覺不像購買桌上型電腦,而更像購買小型 AI 裝置,而碰巧也是 Mac。 128 個 GB 統一記憶體、40 個 GPU 核心、16 個 CPU 核心、一個神經引擎、硬體媒體編碼器、一個 2 TB SSD 以及以單瓦測量的空閒功耗 - 所有這些都集中在一個盒子中,您可以用一隻手拿起。
設定速度很快,第一個 LLM 在一個小時內執行,一個下午之內,您就擁有了一個私人 RAG 管道,可以回答您自己文件中的問題。整個事情都發生在您的辦公桌上,後臺沒有任何雲賬單滴答作響。這會改變你使用人工智慧進行構建的方式,而在你嘗試之前很難傳達這種方式。
如果您正在評估 Mac Studio 是否屬於您團隊的硬體組合,我希望本文為您提供了一個腳踏實地的觀點:什麼是令人驚歎的,什麼是粗糙的,雲仍然獲勝的地方,以及您辦公桌上的盒子是更好的答案。同伴 短部落格 將相同的工作流程提煉成 5 分鐘的閱讀內容以供分享。
如果這有用的話 - 在 YouTube 上觀看拆箱(https://youtube.com/shorts/HUlUoHNsyNM),訂閱後續教程的頻道(MLX 微調、多 Mac 推理、代理堆疊),並在此處檢視該系列的下一篇文章。 Apple Silicon 上的本地 AI 才剛剛開始,隨著堆疊的成熟,我將繼續寫作。
本文的 SEO 快照
- 搜尋引擎最佳化標題: 拆箱 Mac Studio M4:在本地執行您的第一個 LLM
- 元描述: 開啟帶有 128 個 GB 統一記憶體的 Mac Studio M4 Max,安裝 Ollama,在本地執行 Llama 3,並構建私有 RAG 管道。真實的閱讀,誠實的比較。
- 主要關鍵詞: Mac Studio AI、Mac Studio LLM、在 Mac Studio、Ollama Mac Studio、Apple Silicon AI 上執行 LLM、本地 AI 設定、Mac Studio RAG、本地 LLM 教程、本地執行 Llama、Mac Studio M4 審查。
- Twitter / X(280 個字元以下): 拆箱 Mac Studio M4 Max。 128個GB統一記憶體。空閒6.48 W。透過Ollama拉動Llama 3.1 8B,一個下午搭建了本地RAG管道,沒有云賬單。完整的 4000 字演練 + 6 個圖表 + YouTube 短片。 #AppleSilicon #LocalLLM
- 領英帖子: 新的 Mac Studio M4 Max 出現在我的辦公桌上,我把它當作一個 AI 裝置:從 mactop(6.48 W 空閒、128 GB UMA、40 GPU 核心)的真實讀數、Ollama 安裝、本地執行的 Llama 3.1 8B、針對我自己的文件的完整 RAG 管道 - 所有這些都在一個下午完成。我寫下了整個工作流程,其中包括六個原始圖表、一個誠實的雲與本地決策矩陣,以及關於雲仍然獲勝的部分。如果您正在為您的團隊評估本地人工智慧,那麼這是一個腳踏實地的起點。