ٹربو چارجنگ LLMs
PagedAttention، vLLM، Self-Debugging، PowerInfer، اور EG-MLA — GPU KV کیشے کو ضائع کیے بغیر LLM ایجنٹوں کو کیسے پیمانہ کریں
 Balinder Walia30 اگست، 20264 min read
Workstationپروڈکشن میں بڑے لینگویج ماڈلز کو ٹربو چارج کرنے کے طریقے کے بارے میں: PagedAttention, vLLM, Self-Debugging, PowerInfer, اور EG-MLA — ٹریڈ آف کے ساتھ جو دراصل GPUs پر ظاہر ہوتے ہیں۔ گہرا غوطہ:طویل مضمون۔ پرائمر:LLMs کی وضاحت + Kubernetes۔
واچ: LLM اصل میں
کیا ہے۔سیاق و سباق، پروڈکٹ ڈیمو نہیں:بڑے زبان کے ماڈلز کا تعارف(Andrej Karpathy)۔ ہماریسادہ انگریزی LLM + Kubernetes گائیڈکے ساتھ جوڑا بنائیں۔
سکیلنگ کا مسئلہ
LLMs نے بات چیت کے AI اور نسل کو غیر مقفل کیا، پھر فوری طور پر پیش کرنے کا مسئلہ بن گیا۔ ہر ڈی کوڈ مرحلہ ایک KV کیشے میں کلیدیں اور اقدار جوڑتا ہے جو ترتیب کی لمبائی اور بیچ سائز کے ساتھ بڑھتا ہے۔ بولی انجن بہت بڑی متصل سلیبوں کو پہلے سے محفوظ رکھتے ہیں۔ اس میں سے زیادہ تر میموری بیکار رہتی ہے جبکہ دوسری درخواستیں انتظار کرتی ہیں۔ GPU "مکمل" نظر آنے کے باوجود تھرو پٹ گر جاتا ہے۔
PagedAttention: توجہ کے لیے ورچوئل میموری
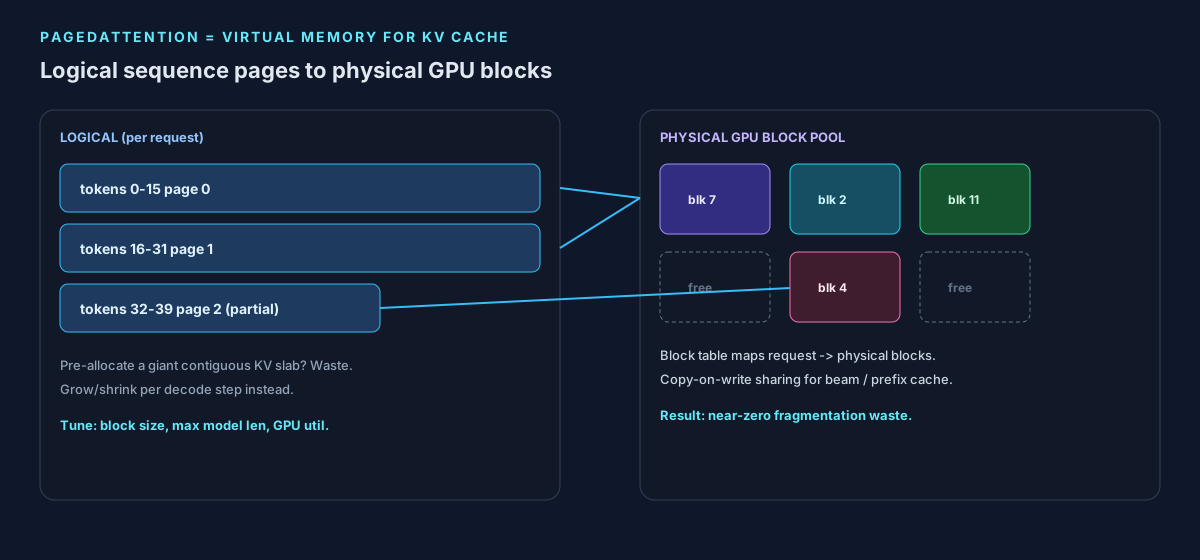
PagedAttention (Kwon et al., SOSP 2023) KV کیشے کو OS پیجنگ کی طرح سمجھتا ہے: فکسڈ سائز بلاکس، ایک بلاک ٹیبل فی درخواست، غیر متصل جسمانی صفحات[arXiv:2309.06180]۔ دانا توجہ کے وقت بلاکس کو جمع کرتا ہے۔ آپ کو ابھی بھیبلاک سائز,زیادہ سے زیادہ ماڈل کی لمبائی، اورکیشے کا درجہ بندی(GPU HBM بمقابلہ CPU آف لوڈ بمقابلہ پریفکس کیشے) کو ٹیون کرنا ہوگا۔ بہت چھوٹے بلاکس اوور ہیڈ میپنگ شامل کرتے ہیں۔ بہت بڑے بلاکس فضلہ کو دوبارہ پیش کرتے ہیں۔
vLLM:
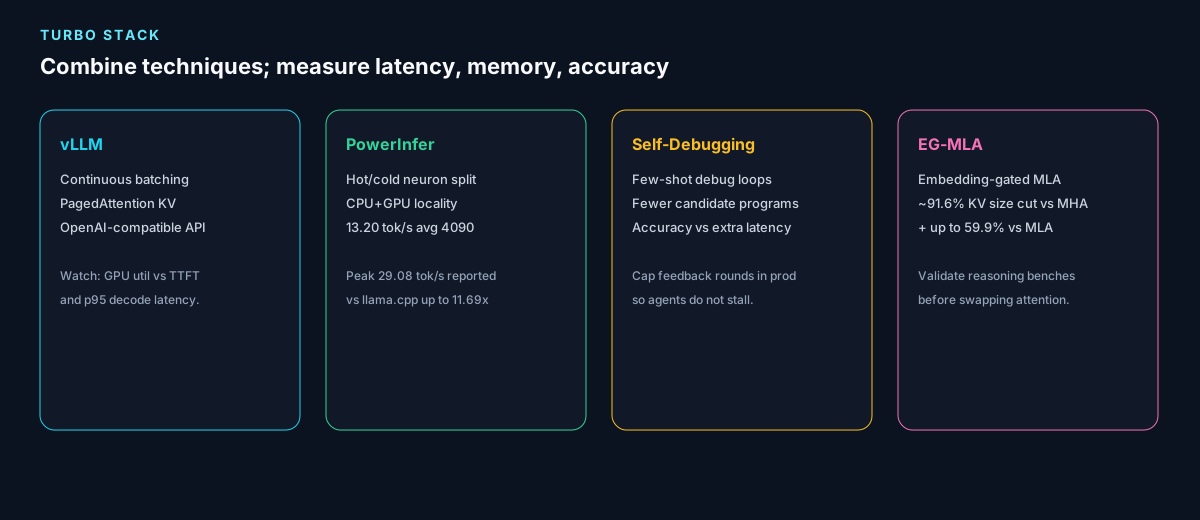
پیش کرنے والا تقریبا صفر فضلہvLLM سروسنگ سسٹم ہے جو PagedAttention کے ارد گرد بنایا گیا ہے۔ یہ صفر کے قریب KV فضلہ، مسلسل بیچنگ، اور OpenAI سے مطابقت رکھنے والی HTTP سطح کو نشانہ بناتا ہے۔ پروڈکشن میں، تین چیزیں دیکھیں: (1)gpu_memory_utilizationبمقابلہ OOM، (2) ٹائم ٹو فرسٹ ٹوکن بمقابلہ ڈی کوڈ ٹوکنز، (3) کیا پریفکس/پرامپٹ کیشنگ آپ کے ایول سیٹ کے جوابات کو تبدیل کرتی ہے۔ کیشنگ ایک تھرو پٹ جیت ہے۔ یہ درستگی اور دم میں تاخیر کے اثرات سے پاک نہیں ہے۔
from vllm import LLM, SamplingParams

llm = LLM(model="meta-llama/Llama-3.1-8B-Instruct", gpu_memory_utilization=0.90)
params = SamplingParams(temperature=0.2, max_tokens=256)
outs = llm.generate(["Explain PagedAttention in one paragraph."], params)
print(outs[0].outputs[0].text)
یہ حقیقی vLLM استعمال ہے۔ ایک ہگنگ فیس BERTforward()کالہےPagedAttention نہیں — درجہ بندی والے لاگٹس کو پیجڈ KV سرونگ کے ساتھ الجھائیں نہیں۔
Self-Debugging: لیٹنسی بجٹ
کے ساتھ کوالٹی لوپسSelf-Debugging (Chen et al.) ایک ماڈل کو چند شاٹ ٹریس سے اپنے پیشین گوئی پروگراموں کو ٹھیک کرنا سکھاتا ہے، مماثل یا بیٹنگ بیس لائنز جو 10x زیادہ امیدواروں کو خارج کرتی ہیں[arXiv:2304.05128]۔ ایجنٹوں کے لیے، یہ سونا ہے — جب تک کہ فیڈ بیک راؤنڈ اسٹیک نہ ہوں۔ ڈیبگ پیغامات کی تعداد کو محدود کریں، ہر دور میں لاگ ان کریں، اور بجٹ ختم ہونے پر کسی انسانی یا چھوٹے ماہر ماڈل کے لیے فیل ہو جائیں۔
واچ: سرونگ اور انفرنس سیاق و سباق
تیز LLM سرونگ پر سیاق و سباق کی بات - ایک سرکاری Workstation ڈیمو نہیں۔ vLLM کاغذ اورdocs.vllm.aiکے ساتھ جوڑا بنائیں۔
PowerInfer: ایک واحد چربی GPU
پر ٹوکنPowerInfer گرم/ٹھنڈے نیوران کو تقسیم کرتا ہے تاکہ ایک صارف GPU پلس CPU تیزی سے ٹوکن تیار کر سکے۔ رپورٹ کردہ اعداد و شمار:13.20 ٹوکن/s اوسط، چوٹی29.08 ٹوکن/sایک NVIDIA RTX 4090 پر،11.69xبمقابلہ llama.cpp تک درستگی کو برقرار رکھتے ہوئے فلیٹ اسکیل پر آپ کو ابھی بھی جگہ کا تعین کرنے کی ضرورت ہے: GPU پر کون سی پرتیں رہتی ہیں، آپ کس طرح نوڈس پر شارڈ کرتے ہیں، اور آیاکا مقامی پروفائل آپ کےپرامپٹس کاغذ کے ماڈلز سے میل کھاتا ہے۔
EG-MLA: بینچ کو تباہ کیے بغیر KV کو سکڑیں
EG-MLA (ایمبیڈنگ گیٹڈ ملٹی ہیڈ لیٹنٹ توجہ) کی رپورٹ91.6% KV کیشے میں کمیبمقابلہ ملٹی ہیڈ توجہ نہ ہونے کے برابر انحطاط کے ساتھ، اضافی بچت بمقابلہ ایم ایل اے (59.9% تک)، اور ریجننگ سویٹس پر بہتر اسکورز، XTAGX9 پیرامیٹر پیرامیٹر، XTAGX9 پیرامیٹراسے ایک فن تعمیر کے انتخاب کے طور پر سمجھیں، نہ کہ منجمد vLLM چوکی پر ڈراپ ان جھنڈا — میموری گراف کو منانے سے پہلے اپنے ایول ہارنس کی توثیق کریں۔
اسے اکٹھا کرنا
کلسٹر سرونگ کے لیے PagedAttention + vLLM کو یکجا کریں، PowerInfer جب باکس ایک ورک سٹیشن GPU ہو، Self-Debugging کوڈنگ ایجنٹوں کے اندر سخت گول حد کے ساتھ، اور EG-MLA جب آپ ماڈل فیملی کو کنٹرول کرتے ہیں۔ تقسیم شدہ سرونگ پیچیدگی میں اضافہ کرتی ہے: KV متوازی، پری فل/ڈی کوڈ اسپلٹ، اور آٹو اسکیلنگ جو صفحہ کی میزوں کو نہیں مارتی ہے۔ پیمائش کریں۔ پھر ADR لکھیں۔
اگلا
پڑھیں- Long article— knobs, failure modes, Kubernetes notes.
- LLMs وضاحت کی گئی + Kubernetes پر خود چلائیں
- Muse Glimmer / مقامی ایجنٹس·انٹرپرائز AI لیب
Workstationکے ذریعے شائع کیا گیا۔