Распаковка Mac Studio M4 и запуск вашего первого LLM
Реальные показания с mactop на свежеустановленном M4 Max, установленном Ollama, локальном Llama 3 и частном конвейере RAG за один день
 Balinder Walia15 мая 2026 г.4 min read

Короткое, легко читаемое дополнение к подробному глубокому погружению. Для полного прохождения перейдите к длинная статья.
Коробка на столе теперь является устройством искусственного интеллекта.
Я распаковал новый Mac Studio с чипом M4 Max, 128 унифицированной памяти GB, 40 ядрами GPU, 16 ядрами CPU и твердотельным накопителем емкостью 2 ТБ. В течение дня он запускал Llama 3.1 8B локально через Ollama, встраивал мои собственные документы и отвечал на вопросы по ним через небольшой конвейер RAG. Никаких счетов за облако, никаких ключей API, никаких данных, покидающих комнату.
Этот блог представляет собой короткую версию. В полной статье подробно рассматривается тот же рабочий процесс.
Распаковка за 60 секунд.
Посмотрите короткометражку о распаковке на YouTube: https://youtube.com/shorts/HUlUoHNsyNM
Классическая распаковка Apple: минимум картона, аппарат в отформованном углублении, кабель питания. Корпус Mac Studio имеет квадратную форму примерно 7,7 дюйма и плотный; качество сборки ощущается в тот момент, когда вы берете его в руки. Установка действительно быстрая: Apple ID, язык, FileVault, готово.
Первая загрузка - реальные показания с Mactop
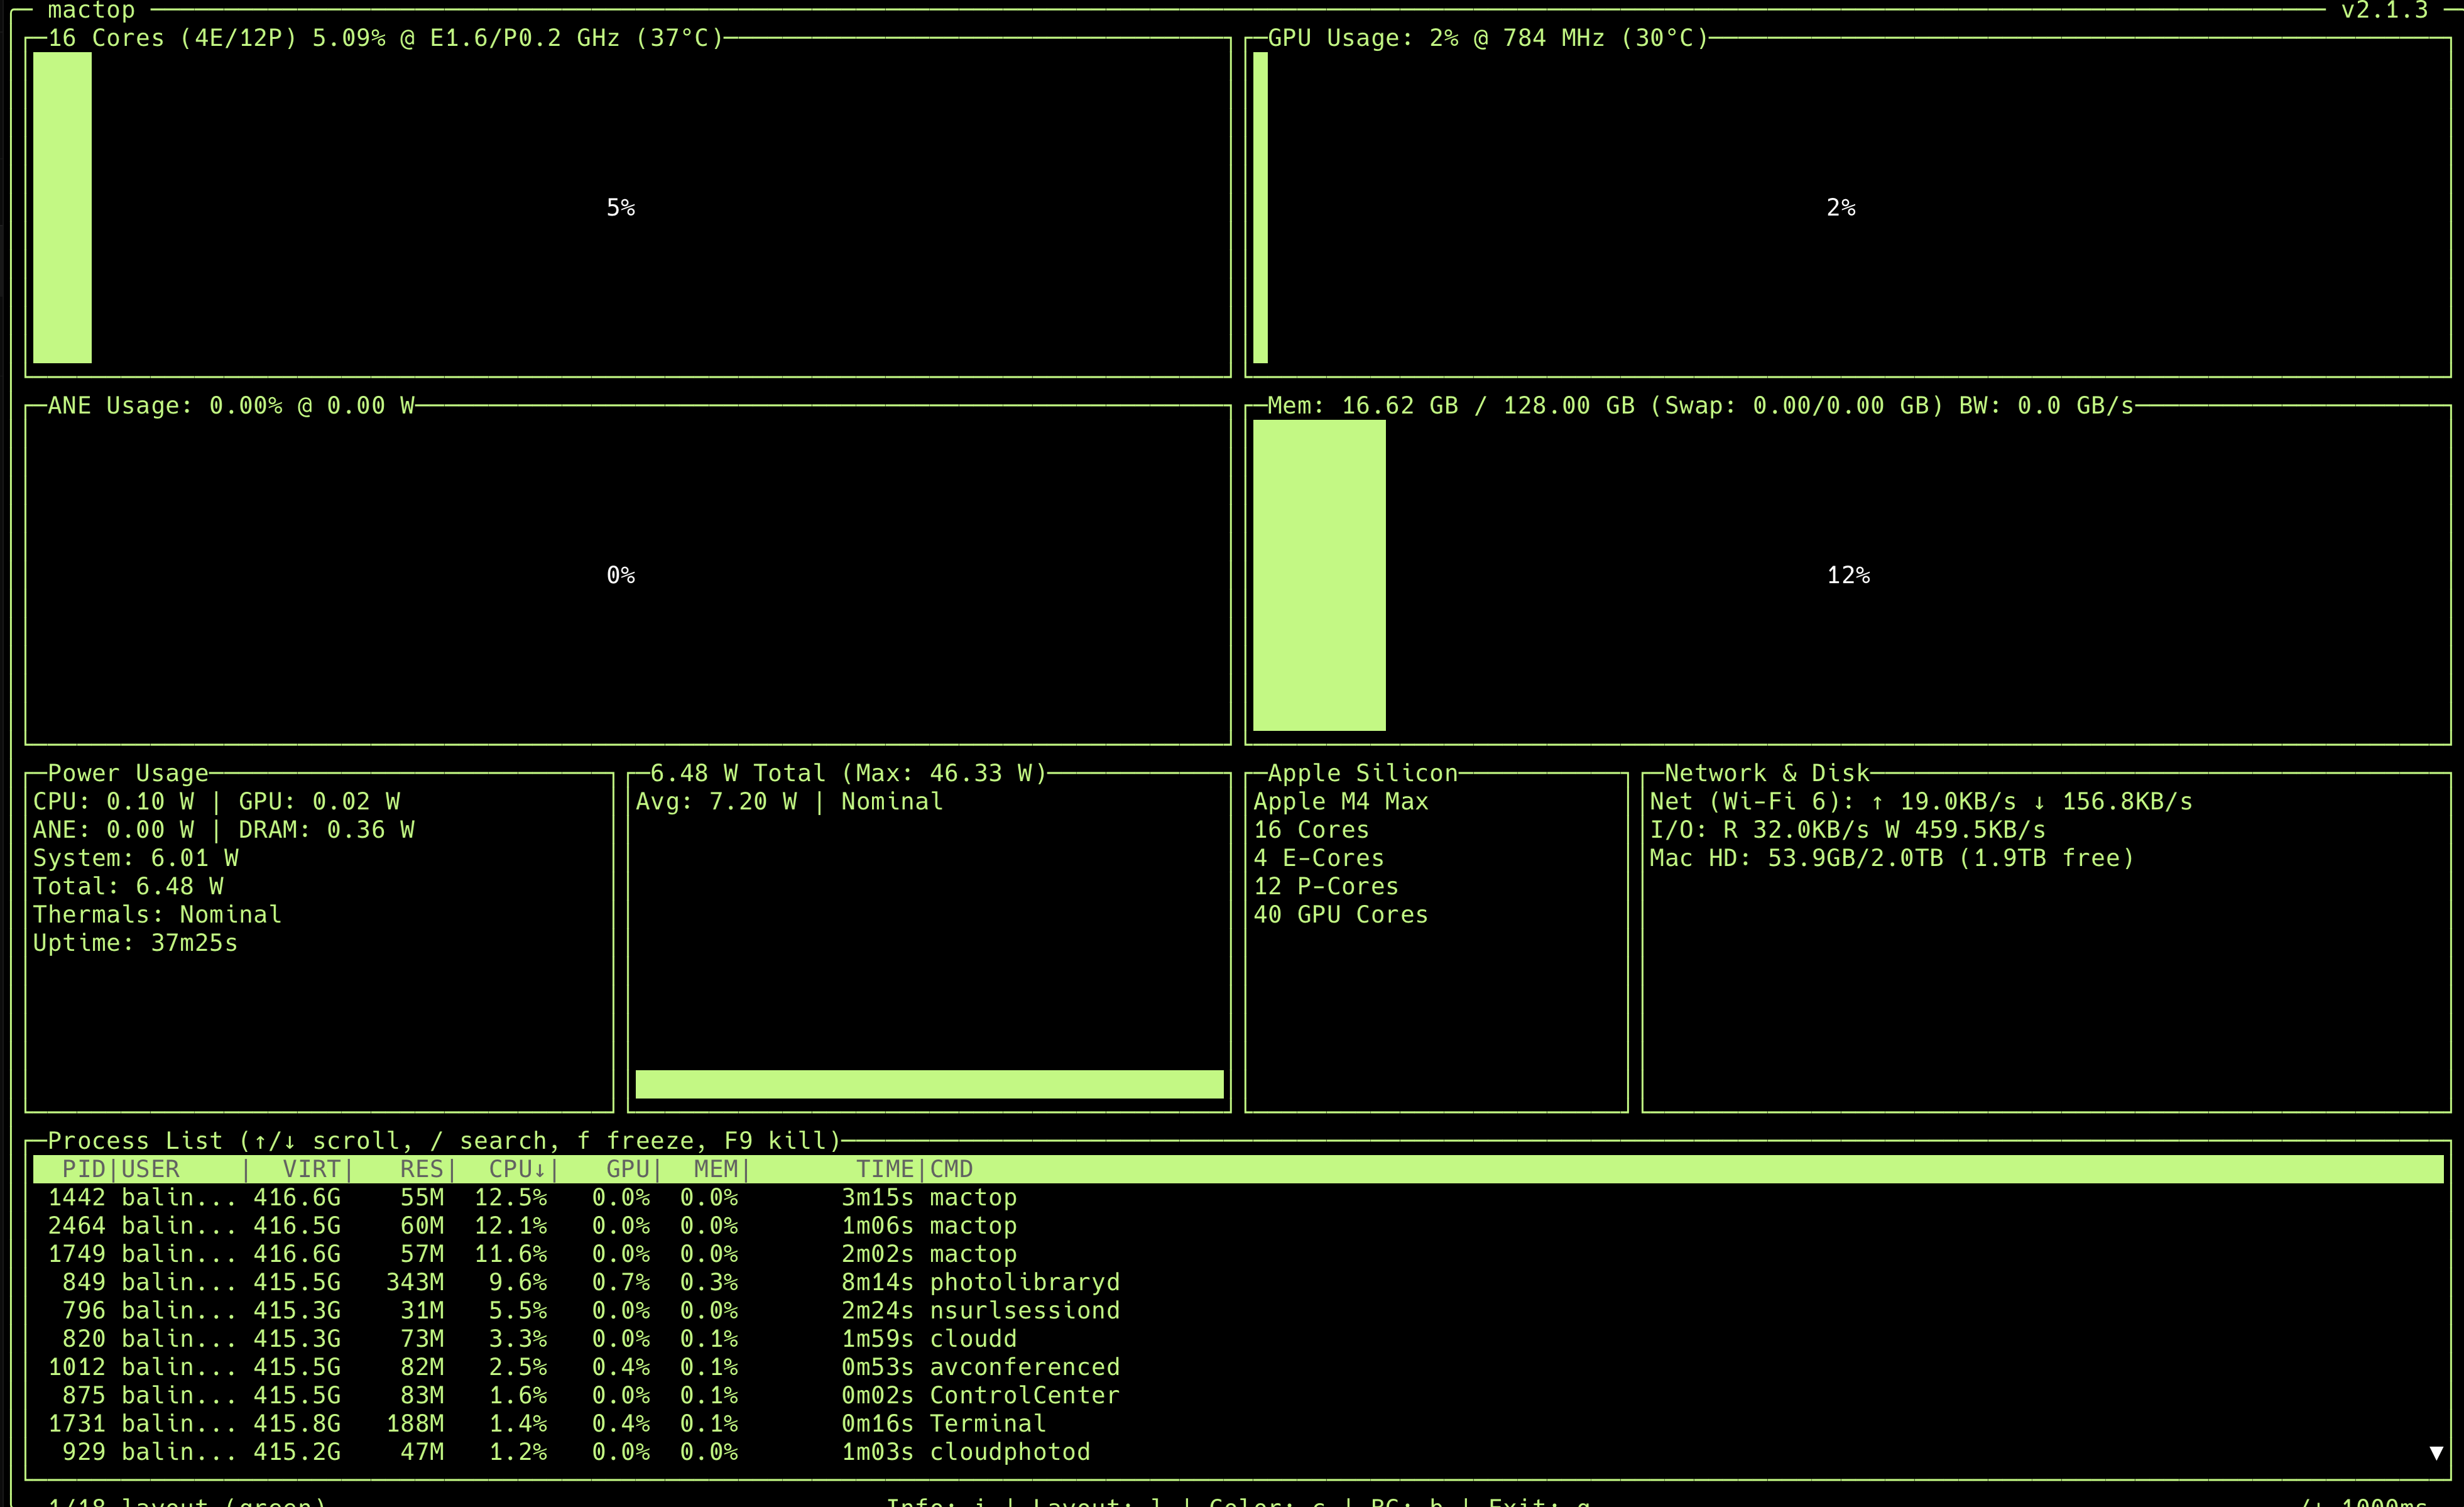
/img/mac-studio-mactop-firstboot.png чтобы заменить его позже.Приведенные выше цифры — единственные точные цифры, которые я могу привести. Они являются основной истиной из mactop на моей машине при 37 минутах безотказной работы:
- M4 Max — 16 ядер (4 E + 12 P), 40 ядер GPU по 784 МГц, 16-ядерный ANE.
- 128 унифицированной памяти GB - 16,62 GB используется на холостом ходу (около 13%).
- 6,48 Вт общая мощность в режиме ожидания: максимальная наблюдаемая мощность 46,33 Вт. Термические характеристики: Номинальные.
- SSD-накопитель емкостью 2 ТБ, 1,9 ТБ свободно после первоначальной настройки.
6,48 Вт в режиме ожидания для настольного компьютера со 128 GB полезной памяти — это для меня главный показатель. Этот блок действительно представляет собой маломощное, постоянно включенное устройство искусственного интеллекта, которое вы можете оставить работающим 24 часа в сутки, 7 дней в неделю, не думая о счетах за электроэнергию.
Чем это железо особенное — унифицированная память в одном абзаце
На традиционном ПК ваш CPU имеет системную оперативную память, а ваш GPU — отдельную видеопамять. Модель необходимо скопировать через PCIe, прежде чем GPU сможет ее запустить; если модель больше VRAM, она не подойдет. В Apple Silicon CPU, GPU, Neural Engine и медиа-движки совместно используют один 128 пулов GB. Ничего не копируется. LLM с 70B параметрами в Q4_K_M (около 40 GB на диске, по общедоступной оценке) загружается, при этом примерно 80 GB все еще свободны для контекста, приложений и инструментов. Вот почему местные LLM по-другому ощущаются на Mac.
От коробки до первого LLM за три команды
brew install ollama
ollama serve &
ollama run llama3.1:8b "Explain unified memory in 3 sentences."
В этом, собственно, и состоит все воспитание. При первом запуске модель загружается (по общедоступной оценке, Llama 3.1 8B Q4_K_M на диске составляет около 4,7 GB) и загружается в унифицированную память. После этого потоковая передача разговора становится плавной, с заметной задержкой первого токена и стабильным выводом ответа. Я намеренно не публикую здесь цифры количества токенов в секунду без надлежащей методологии тестирования; длинная статья посвящена рассуждениям.
Локальный RAG менее чем в 60 строках Python
Самое полезное, что вы можете сделать с локальным LLM, — это направить его на свои документы. Минимальный жизнеспособный стек:
- PyMuPDF или
unstructuredдля разбора - nomic-embed-text через Ollama для встраивания
- ChromaDB для векторного магазина
- Llama 3.1 8B через Ollama для генерации
Полный код находится в длинная статья. Заголовок таков: все работает на Mac Studio, никаких внешних ключей API, никакой оплаты по токенам, никаких данных, покидающих машину.
Mac Studio против облака: матрица честных решений
Mac Studio выигрывает за: постоянный частный логический вывод, RAG для ваших собственных данных, вторые пилоты IDE, прототипирование агентов, изучение стека и домашние лаборатории. Облако выигрывает за: пакетное обучение, масштабируемое производство >70 млрд, непредсказуемый глобальный трафик и рабочие нагрузки, требующие 8-кратного параллелизма A100/H100. Большинство команд в конечном итоге будут использовать оба. В длинной статье есть полная матрица решений в формате SVG.
Пять уроков через неделю
- Конфиденциальность открывает новые варианты использования. Если модель локальная, я без колебаний вставляю производственные журналы, внутреннюю документацию и электронные письма клиентов. Это меняет то, как я работаю.
- Стоимость каждого запроса является как психологической, так и финансовой. Отсутствие законопроекта означает больше запросов, больше экспериментов, больше любопытства.
- 128 GB — это золотая середина. 64 GB — это площадка для серьезной работы. 128 GB дает вам запас для запуска 70B на Q4_K_M и при этом остается место для всего остального.
- Ollama — это легкий путь к успеху. LM Studio отлично подходит в качестве браузера моделей, MLX отлично подходит, если вы начинаете с нуля в Python, а llama.cpp лежит в основе всего этого.
- Облако не умерло. Это по-прежнему подходящий инструмент для обучения, масштабируемого обслуживания и рабочих нагрузок с неизвестной нагрузкой.
Что дальше
В будущих статьях будет рассмотрена тонкая настройка MLX на Apple Silicon, кластеры вывода для нескольких Mac с EXO, стеки агентов (LangGraph + Ollama), а также более детальная методология тестирования. Если вам нужна длинная версия со всеми диаграммами, кодом и матрицей решений, прочитайте длинная статья. Если вам нужна визуальная версия, посмотрите Короткометражка на YouTube. В любом случае — подписывайтесь на остальные серии.