Это подробное подробное описание. Более быструю и удобочитаемую версию см. сопутствующий пост в блоге.
1. Введение: зачем нужен Mac Studio для локального искусственного интеллекта?
Локальный ИИ больше не является предметом любопытства любителей. Благодаря быстрому развитию моделей открытого веса от Meta, Mistral, Qwen и Microsoft, а также унифицированной памяти Apple Silicon, преодолевшей порог 128 GB, теперь вы можете запускать функциональные большие языковые модели, конвейеры внедрения и полные стеки RAG на одном настольном компьютере - тихо, за долю бюджета мощности типичной рабочей станции GPU.
В этой статье рассказывается о распаковке Mac Studio с чипом M4 Max, первая загрузка, реальные показания на устройстве с mactopи практический путь от «коробка у меня на столе» до «Я общаюсь с Llama 3, работающим локально, и запрашиваю свои собственные документы с помощью RAG». Каждая рекомендация здесь основана на том, что я действительно наблюдал на машине. Никаких придуманных эталонных показателей, никакой маркетинговой чепухи — только рабочий процесс.
Если вы инженер, разработчик искусственного интеллекта, SRE или технический руководитель, решающий, входит ли Mac Studio в состав аппаратного обеспечения вашей команды, это руководство для вас.

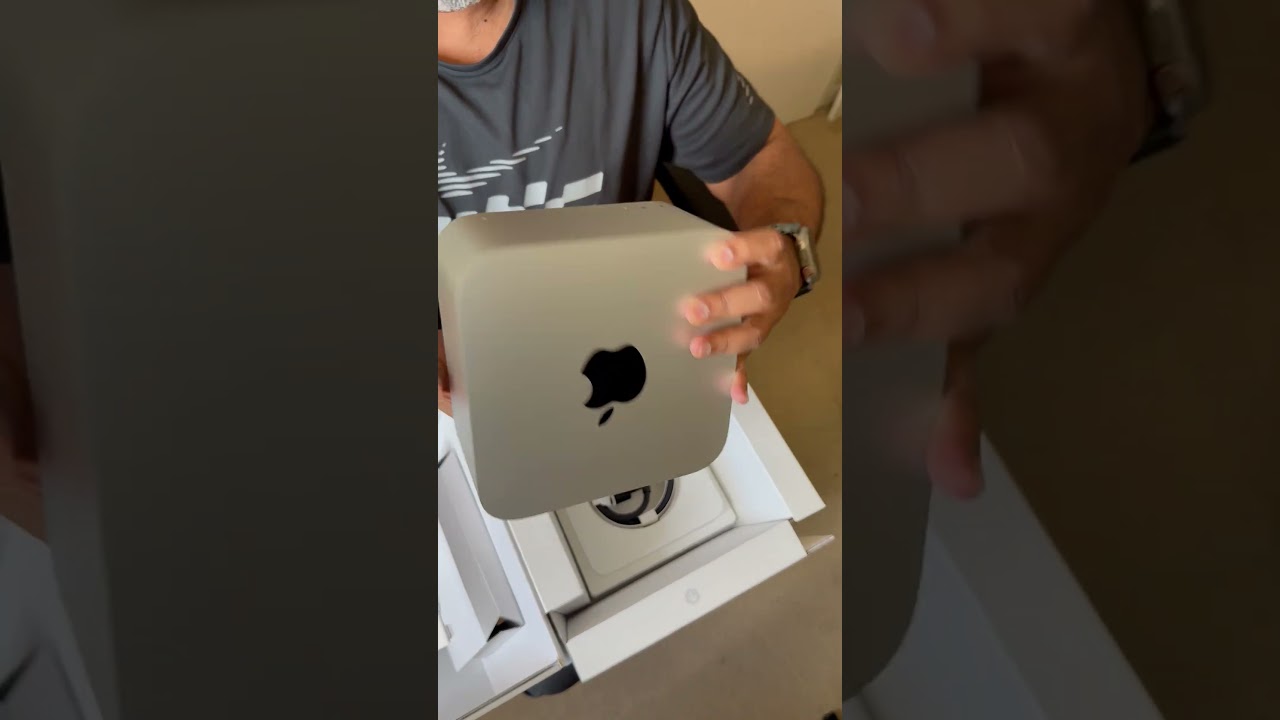
2. Распаковка Mac Studio M4 Max
Распаковка выполнена в классическом стиле Apple: минимум картона, устройство, помещенное в углубление, короткий черный кабель питания и все. Никакого раздутого набора аксессуаров. Сам Mac Studio представляет собой тот же компактный корпус из алюминиевого профиля, который был представлен в оригинальном M1 Ultra: квадратный размер примерно 7,7 дюйма, удобный в руке, со знакомым решетчатым воздухозаборником снизу и множеством портов сзади.
Посмотрите короткометражку о распаковке на YouTube: https://youtube.com/shorts/HUlUoHNsyNM
Я снял небольшой ролик распаковки — посмотрите короткометражный видеоролик на YouTube выше. Причина, по которой Short так хорошо работает для этого формата, заключается в том, что фактическая установка происходит очень быстро. Первый плагин, пробуждение монитора, вход в Apple ID, язык и регион, FileVault, и через несколько минут вы окажетесь на рабочем столе.
2.1 Первая загрузка - реальные показания с mactop
Первое, что я сделал после того, как система завершила первоначальную синхронизацию, это установил Мактоп - отличная панель управления TUI с открытым исходным кодом, которая отображает внутренние счетчики Apple Silicon в режиме реального времени. Вот как выглядела эта только что установленная панель мониторинга через 37 минут безотказной работы:

/img/mac-studio-mactop-firstboot.png чтобы заменить его позже.Цифры на этом скриншоте — единственные точные цифры, которые я приведу в этой статье. Это основная истина для моей машины на холостом ходу при новой настройке:
- Apple Silicon: M4 Max
- CPU: Всего 16 ядер — 4 ядра эффективности + 12 ядер производительности; E-кластер на частоте 1,6 ГГц, P-кластер на частоте 0,2 ГГц; пакет при 37 C
- GPU: 40 ядер по 784 МГц, 30 С
- Нейронный двигатель (ANE): 16-ядерный, потребление 0,00 Вт в режиме ожидания
- Единая память: Всего 128,00 GB, 16,62 GB используется (около 13%) на холостом ходу
- Власть: Всего 6,48 Вт — CPU 0,10 Вт, GPU 0,02 Вт, ANE 0 Вт, DRAM 0,36 Вт, System 6,01 Вт. Максимальная наблюдаемая в сеансе мощность составила 46,33 Вт. Термические параметры: номинальные.
- Хранилище: 2,0 ТБ Mac HD, 1,9 ТБ бесплатно; 53.9 GB, используемый ОС, и первоначальная настройка
- Сеть: Wi-Fi 6, примерный показатель: скорость загрузки 19,0 КБ/с и скорость загрузки 156,8 КБ/с во время фоновой синхронизации.
Выделяются две вещи. Первый, 6,48 Вт на холостом ходу для настольного компьютера с 128 GB полезной памяти это замечательно — это меньше, чем многие ноутбуки потребляют с выключенным экраном. Во-вторых, GPU работает на частоте 784 МГц и имеет 40 доступных ядер; этот пул готов к реальной работе, как только вы установите перед ним LLM.
3. Почему Mac Studio M4 Max отлично подходит для местного искусственного интеллекта
Чтобы понять, почему это оборудование так хорошо подходит для локального искусственного интеллекта и почему «унифицированная память» — это больше, чем просто маркетинговый ход, полезно сравнить его непосредственно с канонической альтернативой: дискретной картой GPU в ПК, обменивающейся данными с системной оперативной памятью через PCIe.

3.1 Единая память простым языком
На традиционном компьютере с искусственным интеллектом у вас есть два пула памяти. Системная оперативная память (обычно 64–256 GB DDR5) хранит данные ОС, приложения и веса модели при их загрузке с диска. GPU имеет собственную видеопамять — 24 GB на RTX 4090, 32 GB на 5090, 80 GB на A100. Прежде чем GPU сможет запустить один матмул, модель должна быть скопирован из системной оперативной памяти в VRAM по шине PCIe. Если модель больше, чем VRAM, она либо не загружается вообще, либо выгружается через PCIe с огромными затратами (часто в 10–100 раз медленнее, чем полная работа в VRAM).
Apple Silicon объединяет эти два пула в один. CPU, GPU, Neural Engine и медиа-движки видят та же физическая память. Копии нет. Узкого места PCIe нет. Модель, имеющая 40 GB на диске, представляет собой 40 GB в единой памяти, и GPU может считывать ее напрямую.
Для местных LLM это убийственная функция. Модель с 70B параметрами, квантованная до Q4_K_M, составляет около 40 GB на диске (публично цитируемая цифра весов класса Llama на этом квантовом уровне — рассматривается как приблизительная). Для потребительского GPU 24 GB эта модель просто не подходит. В унифицированной памяти 128 GB загружается около 80 GB, которые все еще свободны для контекста, кода приложения и инструментов.
3.2 Энергоэффективность, в которую трудно поверить
Скриншот Mactop показывает 6,48 Вт в режиме ожидания и максимум 46,33 Вт во время сеанса. Для сравнения: один RTX 4090 в режиме ожидания потребляет 15–25 Вт, а остальная система находится сверху, а под нагрузкой потребляет до 450 Вт. Mac Studio — это настольный блок искусственного интеллекта, который можно оставить работающим круглосуточно и без выходных, не замечая этого в счете за электроэнергию. Он молчит. Вентиляторы почти никогда не раскручиваются во время рабочих нагрузок вывода. Именно это делает его жизнеспособным как всегда включенный блок разработчика так, как редко бывает с дискретным ПК GPU.
3.3 Что на самом деле делает Apple Neural Engine
ANE — это 16-ядерный ускоритель с фиксированными функциями, оптимизированный для тех видов тензорных операций, которые выполняет CoreML. Для большинства рабочих нагрузок LLM с открытыми весами в 2026 году (формат GGUF, выполняемый через llama.cpp или Ollama) ANE не является горячим путем — GPU через Metal Performance Shaders. ANE отлично подходит для моделей, преобразованных с помощью CoreML, распознавания речи на устройстве, сегментации изображений и аналогичных рабочих нагрузок фиксированной формы. Он также чрезвычайно энергоэффективен во время работы. Полезно знать, что оно есть; не ждите, что каждый стек LLM будет использовать его.
4. Настройка Mac Studio для работы с искусственным интеллектом
После стандартной адаптации macOS я следую точной настройке нового Mac Studio, который хочу использовать в качестве локального ящика для разработки ИИ.
4.1 Установите Homebrew, Xcode CLT и основы
/bin/bash -c "$(curl -fsSL https://raw.githubusercontent.com/Homebrew/install/HEAD/install.sh)"

xcode-select --install

brew install git wget jq python@3.12 node pyenv
brew install --cask iterm2 visual-studio-code
Homebrew предоставляет инструменты Unix, инструменты командной строки Xcode предоставляют компиляторы и компоновщики, Python и Node предоставляют вам среду выполнения для кода приложения, а iTerm2 + VS Code — это пара редактор + терминал, которую я использую по умолчанию.
4.2 Установка Ollama
Ollama — это самый простой способ загрузить, запустить и обслуживать LLM с открытым весом на macOS. Под капотом он окутывает llama.cpp с ускорением Metal и обеспечивает простой HTTP API на порту 11434.
brew install ollama

ollama serve &

ollama --version
Вы также можете установить через официальный .dmg с сайта ollama.com, который устанавливает приложение в виде строки меню. Любой путь работает. Я предпочитаю установку Brew для безголовых коробок и dmg для компьютеров Mac с ежедневными драйверами.
4.3 Установите LM Studio (необязательно, но оно того стоит)
ЛМ Студия — это настольный пользовательский интерфейс для просмотра, загрузки и общения с моделями GGUF. Он также предоставляет OpenAI-совместимый API. Я устанавливаю его вместе с Ollama, потому что браузер моделей превосходен, а пользовательский интерфейс настройки производительности для каждой модели удобен, когда вы выбираете между Q4_K_M и Q5_K_M.
4.4 Установите Continue.dev в VS Code
Continue.dev предоставляет вам помощь в стиле ChatGPT внутри VS Code, но указывает на ваш локальный Ollama. После установки расширения поместите его в свой ~/.continue/config.json:
{
  "models": [
    {
      "title": "Llama 3.1 8B (local)",
      "provider": "ollama",
      "model": "llama3.1:8b",
      "apiBase": "http://localhost:11434"
    },
    {
      "title": "Qwen 2.5 Coder 14B (local)",
      "provider": "ollama",
      "model": "qwen2.5-coder:14b",
      "apiBase": "http://localhost:11434"
    }
  ],
  "tabAutocompleteModel": {
    "title": "Codestral (local)",
    "provider": "ollama",
    "model": "codestral:latest",
    "apiBase": "http://localhost:11434"
  }
}
Теперь у вас есть встроенный чат, редактирование и автозаполнение — все модели ударов находятся на том же столе, что и ваш редактор. Ноль данных покидает машину.
5. Запуск вашего первого LLM

Время для момента истины. Возьмите модель и запустите ее.
5.1 Извлечение Llama 3.1 8B
ollama pull llama3.1:8b

ollama list

ollama run llama3.1:8b "Explain unified memory architecture to me in 3 sentences."
При запросе загружается GGUF Q4_K_M (Llama 3.1 8B в Q4_K_M составляет около 4,7 GB на диске — публично цитируемая цифра, рассматриваемая как приблизительная). При подключении Wi-Fi 6, как у меня, загрузка занимает несколько минут; на проводном гигабите это быстрее. Как только он приземлится, первый ollama run включает однократную загрузку модели в единую память — вы заметите небольшую паузу перед первыми потоками токенов — а затем последующие запуски выполняются быстро.
Я намеренно не буду приводить здесь цифры количества токенов в секунду для своей машины, поскольку я не запускал контролируемый набор тестов с парной методологией. Я скажу, что на оборудовании этого класса (M4 Max с 40 ядрами GPU) следует ожидать плавная разговорная потоковая передача от модели 8B на Q4_K_M, с заметной начальной задержкой нагрузки и стабильным выходным сигналом на протяжении всего отклика. Если вы где-то читали заявления типа «Я получаю 60 токенов в секунду на своем Mac», воспринимайте их как примерное руководство; ваши фактические цифры будут варьироваться в зависимости от длины приглашения, контекстного окна, уровня квантования, архитектуры модели и того, что еще выполняется.
5.2 Выбор квантования – Q4_K_M, Q5_K_M, Q8_0
Квантование снижает точность весов модели, сокращая их на диске и в памяти. Компромисс – качество. Вот приблизительная ментальная модель, которую я использую при выборе количественного показателя для локального вывода:
| Квант | Приблизительный размер для 8B | Качество против FP16 | Когда использовать |
|---|---|---|---|
| Q4_K_M | ~4,7 GB | Очень хорошо, маленькая капля | По умолчанию. Лучший баланс скорости и качества для чата и кода. |
| Q5_K_M | ~5.7 GB | Ближе к FP16 | Когда вам нужно больше точности и есть лишняя память. |
| Q8_0 | ~8,5 GB | Почти без потерь | Когда нужно максимальное качество и минимум шума на небольших моделях. |
Все размеры являются приблизительными и общедоступными значениями веса Llama-класса 8B. Относительный порядок имеет значение.
5.3 Что подходит для 32, 64 и 128 GB
| Единая память | Реалистичная зона комфорта (Q4_K_M) | Растянуть (с осторожностью) |
|---|---|---|
| 32 GB | 7Б / 8Б / 13Б | 20-22Б в узком контексте |
| 64 GB | 13Б / 20Б / 34Б | 40-50B в тесном контексте |
| 128 GB | 34B / 70B / смешанные варианты | 100–120 Б в тесном контексте |
«Зона комфорта» означает, что модель загружается с достаточным пространством для большого контекстного окна, кэша KV и других запущенных приложений. «Растянуть» означает, что он загружается, но вы начинаете манипулировать длиной контекста и другими рабочими нагрузками. На моем компьютере с 128 GB я могу запустить 70B на Q4_K_M и при этом иметь примерно 80 GB запаса для VS Code, Chrome и пары процессов Python — это, честно говоря, ощущение роскоши.
5.4 Вызов Ollama из Node и Python
Ollama предоставляет HTTP API по адресу http://localhost:11434. Небольшая выборка Node выглядит так:
// node 20+
const res = await fetch("http://localhost:11434/api/generate", {
  method: "POST",
  headers: { "Content-Type": "application/json" },
  body: JSON.stringify({
    model: "llama3.1:8b",
    prompt: "Write a one-paragraph summary of unified memory architecture.",
    stream: false
  })
});

const data = await res.json();
console.log(data.response);
И из Питона:
import requests

r = requests.post(
    "http://localhost:11434/api/generate",
    json={
        "model": "llama3.1:8b",
        "prompt": "Explain HNSW indexes briefly.",
        "stream": False,
    },
    timeout=120,
)
print(r.json()["response"])
Это все, что вам нужно для подключения локального LLM к инструменту CLI, боту Slack, ярлыку, микросервису или внутренней автоматизации. Никаких ключей, никаких ограничений скорости, никаких квот.
6. Лучшие модели для работы на Mac Studio
Выбор модели — это частично производительность, частично лицензия, частично атмосфера. Вот что я на самом деле запускаю на коробке, сгруппированное по размеру.
6.1 Маленькие (до 10 В): быстрые повседневные рабочие лошадки
- Llama 3.1 8B - отличное общение общего назначения и рассуждения; разрешительная мета-лицензия с оговорками.
- Мистраль 7Б / Министраль 8Б - веские аргументы, доступны варианты под лицензией Apache.
- Квен 2.5 7B - очень сильная многоязычность и производительность кода.
- Фи-3,5 мини - крошечный, удивительно функциональный, идеальный, когда вам нужна пропускная способность и низкая задержка.
- Кодестрал/Квен 2.5 Кодер 7Б - быстрое встроенное автодополнение для работы IDE.
6.2 Mid (10B-40B): лучшее место на 64-128 GB
- Llama 3.1/3.3 70B (Q4_K_M) - если у вас 128 GB, то это головная модель; непревзойденное качество, комфортная работа.
- Квен 2.5 32Б - отличное соотношение качества и размера; хорошо сочетается с RAG.
- DeepSeek-Кодер 33B - силен в задачах генерации кода.
- Микстрал 8х7Б - смесь экспертов, одновременно активируются только 2 эксперта, удобно помещается.
6.3 Большой (70B и выше): только на 96-128 GB и только на Q4
На 128 GB дверь открыта для моделей класса 70B на Q4_K_M. Они есть помедленнее чем модели 8B, но скачок качества значителен для задач, которые требуют более широких знаний о мире и более длительных рассуждений. Ожидайте, что задержка первого токена будет больше, а скорость потоковой передачи снизится, но фактический опыт остается пригодным для многих рабочих процессов.
7. Создание локального конвейера RAG
Если у вас есть локальный LLM, самое полезное, что вы можете с ним сделать, — это направить его на свои собственные документы. Это генерация с расширенным поиском, и именно в этой рабочей нагрузке Mac Studio действительно является частной альтернативой облачным API.

7.1 Стек
- Парсер документов - PyMuPDF для PDF-файлов,
unstructuredдля приема смешанного формата. - Чанкер - Лангчейн
RecursiveCharacterTextSplitterили сплиттер с поддержкой токенов. Типичный размер фрагмента — 512–1024 токена с перекрытием 64–128 токенов. - Вложения -
nomic-embed-textилиmxbai-embed-large, оба доступны через Ollama. Оба работают на локальном GPU. - Векторный магазин - ChromaDB по умолчанию. SQLite-VSS для варианта без сервера. LanceDB, если вам нужен встроенный вариант с одним файлом, который масштабируется.
- Генератор - Llama 3.1 8B для быстрого ответа или 70B, если вам нужны ответы высочайшего качества.
7.2 Минимальный пример Python – от начала до конца
pip install chromadb requests pypdf

import os, glob, requests, chromadb
from chromadb.utils import embedding_functions
from pypdf import PdfReader

OLLAMA = "http://localhost:11434"
EMBED_MODEL = "nomic-embed-text"
GEN_MODEL   = "llama3.1:8b"

def embed(text: str) -> list[float]:
    r = requests.post(f"{OLLAMA}/api/embeddings", json={
        "model": EMBED_MODEL, "prompt": text,
    }, timeout=60)
    return r.json()["embedding"]

def generate(prompt: str) -> str:
    r = requests.post(f"{OLLAMA}/api/generate", json={
        "model": GEN_MODEL, "prompt": prompt, "stream": False,
    }, timeout=300)
    return r.json()["response"]

def chunk(text: str, size: int = 1000, overlap: int = 150):
    out, i = [], 0
    while i < len(text):
        out.append(text[i:i+size])
        i += size - overlap
    return out

client = chromadb.PersistentClient(path="./rag-db")
col = client.get_or_create_collection("docs")

for path in glob.glob("./docs/**/*.pdf", recursive=True):
    reader = PdfReader(path)
    full = "\n".join(p.extract_text() or "" for p in reader.pages)
    for j, c in enumerate(chunk(full)):
        col.add(
            ids=[f"{os.path.basename(path)}::{j}"],
            documents=[c],
            embeddings=[embed(c)],
            metadatas=[{"source": path, "chunk": j}],
        )

def ask(q: str, k: int = 5) -> str:
    qe = embed(q)
    res = col.query(query_embeddings=[qe], n_results=k)
    ctx = "\n\n".join(res["documents"][0])
    prompt = (
        "Answer the question using only the context below. "
        "If the answer is not in the context, say you do not know.\n\n"
        f"Context:\n{ctx}\n\nQuestion: {q}\nAnswer:"
    )
    return generate(prompt)

print(ask("What is unified memory and why does it matter for LLMs?"))
Это полноценный локальный конвейер RAG, состоящий менее чем из 60 строк Python. Все это работает на Mac Studio. Никаких внешних ключей API, никакой оплаты за каждый токен, никаких данных, покидающих машину. Первая загрузка большого набора PDF-файлов займет несколько минут; последующие запросы выполняются быстро.
7.3 Замечания по настройке
- Размер чанка - начать с 1000 символов и 150 перекрытий; увеличиться, если в ваших источниках есть длинные структурированные разделы (юридические, технические спецификации), а программа поиска фрагментирует ответы.
- Топ-к - 4-8 – это практический диапазон. Повышение гораздо выше увеличивает скорость запроса и замедляет генерацию без очевидных преимуществ.
- Изменение рейтинга - для достижения наивысшего качества извлеките топ-20 и измените рейтинг с помощью перекрестного кодировщика (например,
bge-reranker). На Mac Studio это дешево. - Фильтрация метаданных - помечать фрагменты их исходным путем, датой и разделом; фильтровать во время запроса перед векторным поиском. Это самая большая победа в точности.
- Потоковое вещание - выключатель
streamкtrueв вызове Ollama и передавайте токены клиенту для быстрого взаимодействия с пользователем.
8. Повседневный цикл разработки
После пары недель использования Mac Studio мой ежедневный цикл выглядит так:
- Откройте VS Code, Continue.dev просыпается против Ollama.
- Откройте чат в Open WebUI (или LM Studio) для более продолжительного диалога с вопросами и ответами по моим заметкам.
- Для работы с кодом: автозаполнение с помощью табуляции на моделях Codestral или Qwen Coder, более длительные чаты на Llama 3.1 8B, сеансы глубокого рассуждения на 70B, когда этого требует задача.
- Для внутреннего RAG — сценарий Python, указывающий на папку docs/ проекта и базу данных Chroma.
- Для создания прототипа агента используйте LangGraph или небольшой специальный цикл, вызывающий конечную точку Ollama — тот же шаблон, другой связующий элемент.
Что действительно меняется, когда LLM является локальным, так это то, как вы его используете. Запрос не требует дополнительных затрат, поэтому вы задаете модели больше вопросов. Не беспокойтесь о конфиденциальности, поэтому вы вставляете производственные журналы, внутренние документы, электронные письма клиентов. Вы пишете небольшие сценарии CLI, которые просматривают 200 документов для извлечения структурированного резюме, и вы не задумываетесь дважды о счете за токен, потому что счета нет.
9. Тесты и честное сравнение с облаком
Позвольте мне быть очень прямым: я не собираюсь публиковать цифры количества токенов в секунду, которые я не получил с помощью строго контролируемой методологии тестирования. Интернет переполнен такими цифрами, часто сравнивающими различные уровни квантования, длину контекста и форматы подсказок, и они больше сбивают с толку, чем проясняют. Вместо этого я опубликую матрицу решений, которая отражает в какой рабочей нагрузке Mac Studio на самом деле выигрывает, где это не так, и где правильный ответ — «используйте оба».

9.1 Математика безубыточности
Mac Studio M4 Max со 128 унифицированными памятью GB и твердотельным накопителем емкостью 2 ТБ продается примерно в том же ценовом диапазоне, что и постоянно включенный облачный экземпляр GPU на несколько месяцев. Считайте все конкретные цифры в долларах приблизительными и зависящими от региона и дисконтирования:
- Один Mac Studio M4 Max, хорошо настроенный: примерно 4000–6000 долларов США единовременно (приблизительно; конфигурации различаются).
- Один АВС
g5.xlarge(один A10G, 24 видеопамяти GB), работающие круглосуточно, 7 дней в неделю по требованию: порядка 700–900 долларов США в месяц (в зависимости от региона). - Один АВС
p4d.24xlarge(8x A100): заказ на 20 000–30 000 долларов в месяц по запросу, если вы каким-то образом оставили его включенным (вы бы этого не сделали, но это делает контраст очевидным).
Арифметика показывает, что для постоянно включенного устройства для разработки Mac Studio окупается за несколько месяцев по сравнению с сопоставимым постоянно включенным облачным экземпляром и продолжает окупаться с точки зрения электроэнергии в течение многих лет. При срочном обучении математика обратная: аренда на час, пробежка, сдача обратно. Используйте правильный инструмент для работы.
9.2 Когда облако — правильный ответ
- Вам необходимо обучить или настроить модель большего размера, чем поместится в 128 GB.
- Вам необходимо обслуживать глобальную базу пользователей со строгими SLO и гибкой емкостью.
- Вы проводите эксперимент, который выигрывает от параллелизма 8x A100 или H100.
- Положение вашей организации о соблюдении требований гласит, что вывод должен выполняться в определенном облачном регионе с определенными журналами аудита.
9.3 Когда Mac Studio — правильный ответ
- Вам нужен всегда доступный приватный блок выводов для вашей команды.
- Вы создаете RAG, агенты или вторые пилотные версии IDE, где важны местонахождение данных и конфиденциальность.
- Вам нужен тихий, маломощный компьютер для разработки, не требующий серверной комнаты.
- Вы быстро создаете прототипы, и вам мешает оплата за каждый токен облачного API.
- Вы хотите изучить стек — владейте моделью, владейте средой выполнения, владейте векторным хранилищем, владейте циклом.
10. Проблемы и ограничения
Я бы не оказал этой статье никакой пользы, если бы не назвал острые углы. Apple Silicon отлично подходит для локального ИИ, но есть серьезные предостережения.
10.1. Обучение — все еще более слабая история, чем вывод
История искусственного интеллекта Apple Silicon гораздо сильнее вывод чем для обучение. Серверная часть MPS PyTorch значительно усовершенствовалась, а собственная платформа MLX Apple действительно хороша, но набор инструментов обучения, использующих только CUDA, все еще шире. Если ваша основная работа — создание новых моделей архитектуры или масштабная точная настройка, вы столкнетесь с дырами, которые вы просто не заделаете в Linux + NVIDIA.
10.2 Экосистема предполагает использование CUDA во многих местах
Многие репозитории AI по-прежнему по умолчанию используют предположения CUDA. Большинство поддерживаемых проектов теперь имеют пути Metal/MPS, но ожидаются случайные трудности: библиотека, требующая сборки из исходного кода, ядро, не имеющее эквивалента Metal, набор тестов, работающий только на NVIDIA. Запланируйте для этого время.
10.3 Масштабирование можно сделать своими руками
Один Mac Studio представляет собой отдельный блок. Такие инструменты, как EXO и другие позволяют объединять компьютеры Mac для запуска очень больших моделей на нескольких устройствах, но это не та история, которую можно получить с кластером Kubernetes g5s. Если ваша рабочая нагрузка требует горизонтальной эластичности, облако все равно лучше.
10.4 Ремонтопригодность и модернизация
Вы не сможете добавить оперативную память позже. Вы не сможете заменить SSD позже (практически говоря). Купите то, что вам нужно, тогда плюс один - особенно на память. Уровень 128 GB — это тот, который я бы рекомендовал для серьезной работы с искусственным интеллектом; 64 GB — это пол.
10.5 Термические характеристики при длительной нагрузке
Mac Studio работает прохладно и тихо на холостом ходу (на снимке экрана выше показаны температуры 37°C и 30°C, вентиляторы не слышны). Под постоянной большой нагрузкой LLM вентиляторы раскручиваются — не громко, но слышно — и чип нагревается. Это находится в пределах номинального теплового диапазона; просто имейте в виду, что «тихий» — это характеристика простоя и малой нагрузки, а не абсолют.
11. Будущее локального искусственного интеллекта на Apple Silicon
Три тенденции сходятся воедино, что делает следующие 12–24 месяца захватывающими для местного ИИ на Apple Silicon.
Первый, модели с открытым весом продолжают уменьшаться, не теряя при этом возможностей. Phi-3.5, Qwen 2.5 small и семейство Llama 3.x 8B превосходят свою весовую категорию. Модель 2026 8B по качеству примерно сравнима с 2023 70B во многих задачах. Это означает, что больше рабочих нагрузок удобно помещается в 32–64 GB унифицированной памяти, а 128 GB Mac Studio становится многомодельным обслуживающим блоком.
Второй, Собственная платформа MLX от Apple продолжает улучшаться. MLX предоставляет API, подобный NumPy, ленивую оценку, унифицированную поддержку памяти по умолчанию и графики динамических вычислений. Сообщество MLX быстро переносило модели, токенизаторы и циклы обучения. Если вы сегодня начинаете новый проект машинного обучения на Mac, MLX — естественный выбор; если вы используете PyTorch, серверная часть MPS становится более удобной для использования с каждым выпуском.
Третий, квантование и сжатие KV-кэша продолжают улучшаться. Такие методы, как Q4_K_M, кванты семейства IQ и улучшения GGUF, означают, что та же модель занимает меньше памяти, чем шесть месяцев назад, с меньшей потерей качества. Локальный ИИ находится на пути к тому, что каждое поколение пар модель + квант расширяет практический охват аппаратного обеспечения по потребительской цене.
Добавьте ко всему этому слухи о будущих чипах серии M (M5, будущие Ultras, обновления Studio), и траектория станет ясна: настольный блок искусственного интеллекта уже здесь, и он становится все лучше.
12. Усиление Mac Studio как командного AI-блока
Если вы хотите поделиться своим Mac Studio с небольшой командой (скажем, предоставить доступ к Ollama, экземпляру Open WebUI и конечной точке RAG нескольким коллегам), я делаю следующее грубое усиление:
- FileVault включен и надежный пароль для входа. Держите его на ИБП.
- Хвостовая чешуя на коробке, чтобы к нему можно было получить доступ с устройств вашей команды, не подвергая его общедоступному Интернету.
- Привяжите Ollama к локальному хосту и передайте ему тонкий прокси-сервер аутентификации (Caddy, Traefik или небольшой сервер Node/Python), который обрабатывает аутентификацию и ограничение скорости перед пересылкой на
11434. - Запустите Open WebUI в Docker Desktop. с постоянным объемом; направьте его на локальную конечную точку Ollama.
- Резервные копии для базы данных RAG на зашифрованный внешний твердотельный накопитель или целевой объект Time Machine.
- Автообновление пакеты macOS и Homebrew по расписанию; прикрепите Ollama и версии модели намеренно, а не автоматически извлекайте последние версии.
Если все сделано хорошо, у вас есть частная, удобная для аудита конечная точка искусственного интеллекта, которую ваша команда использует каждый день и которая никогда не отправляет токен из сети здания.
13. Вывод: тихая революция на столе
Распаковка Mac Studio M4 Max в 2026 году больше похожа не на покупку настольного компьютера, а на покупку небольшого устройства искусственного интеллекта, которое также является Mac. 128 унифицированных памяти GB, 40 ядер GPU, 16 ядер CPU, Neural Engine, аппаратные кодировщики мультимедиа, твердотельный накопитель емкостью 2 ТБ и энергопотребление в режиме ожидания, измеряемое в отдельных ваттах — все это в коробке, которую можно взять одной рукой.
Настройка выполняется быстро, первый LLM запускается в течение часа, а уже через полдня у вас будет частный конвейер RAG, отвечающий на вопросы по вашим собственным документам. Все происходит на вашем столе, и в фоновом режиме не тикают облачные счета. Это меняет то, как вы строите с помощью ИИ, до такой степени, что это трудно передать, пока вы не попробуете.
Если вы оцениваете, входит ли Mac Studio в состав аппаратного обеспечения вашей команды, я надеюсь, что эта статья дала вам обоснованное представление: что удивительно, что грубо, где облако по-прежнему побеждает и где коробка на вашем столе является лучшим ответом. Компаньон короткий блог превращает тот же рабочий процесс в 5-минутное чтение для совместного использования.
Если это было полезно - посмотреть распаковку на YouTube (https://youtube.com/shorts/HUlUoHNsyNM), подпишитесь на канал, чтобы получать дополнительные руководства (тонкая настройка MLX, вывод для нескольких Mac, стеки агентов) и заходите сюда, чтобы увидеть следующую статью из этой серии. Локальный ИИ в Apple Silicon только начинает развиваться, и я буду продолжать писать по мере развития стека.
SEO-снимок для этой статьи
- SEO-заголовок: Распаковка Mac Studio M4: запустите свой первый LLM локально
- Мета-описание: Распакуйте Mac Studio M4 Max со 128 унифицированной памятью GB, установите Ollama, запустите Llama 3 локально и создайте частный конвейер RAG. Реальные чтения, честные сравнения.
- Основные ключевые слова: Mac Studio AI, Mac Studio LLM, Запуск LLM на Mac Studio, Ollama Mac Studio, Apple Silicon AI, Локальная настройка AI, Mac Studio RAG, Локальное руководство по LLM, Локальный запуск Llama, Обзор Mac Studio M4.
- Twitter/X (до 280 символов): Распаковал Mac Studio M4 Max. 128 унифицированных модулей памяти GB. В режиме ожидания — 6,48 Вт. Подключил Llama 3.1 8B через Ollama, за полдня построил локальный конвейер RAG, никаких счетов за облако. Полное пошаговое руководство на 4000 слов + 6 диаграмм + короткометражка на YouTube. #AppleSilicon #LocalLLM
- Сообщение в LinkedIn: Новый Mac Studio M4 Max оказался у меня на столе, и я относился к нему как к устройству искусственного интеллекта: реальные показания с Mactop (6,48 Вт в режиме ожидания, 128 ядер GB UMA, 40 ядер GPU), установка Ollama, работа Llama 3.1 8B локально, полный конвейер RAG в сравнении с моими собственными документами — и все это за один день. Я описал весь рабочий процесс с шестью оригинальными диаграммами, честной матрицей решений «облако-локальное решение» и разделом о том, в чем облако по-прежнему побеждает. Если вы оцениваете локальный ИИ для своей команды, это хорошее место для начала.