Workstation resumo técnico: como turbinar o atendimento e os agentes do LLM com PagedAttention, vLLM, Self-Debugging, PowerInfer, e EG-MLA. Companheiro: blog · cartilha: Artigo sobre LLMs no Kubernetes · laboratório: Laboratório de IA Empresarial.
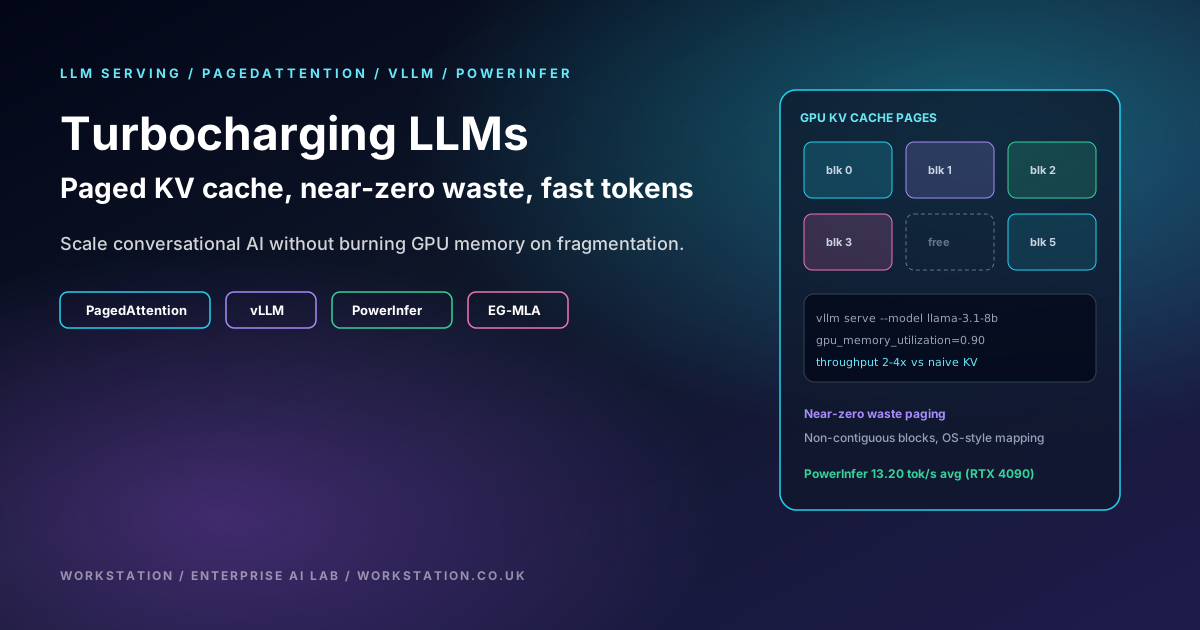
- Gargalo: Crescimento e fragmentação do cache KV, e não “o modelo é lento” em abstrato.
- PagedAttention: Paginação de blocos KV no estilo do sistema operacional; ajustar o tamanho do bloco e a hierarquia do cache.
- vLLM: servindo motor com desperdício de KV próximo de zero + dosagem contínua; assista TTFT vs tokens/s.
- Self-Debugging: o reparo de programas com poucas tentativas supera grandes conjuntos de candidatos; rodadas de boné em prod.
- PowerInfer: divisão quente/frio; Média de 13,20 tok/s / pico de 29,08 no RTX 4090 (números de papel/repo).
- EG-MLA: compressão KV em nível de arquitetura (~91,6% vs MHA); reavaliar antes da troca.
1. Por que servir, e não treinar, é a crise
Grandes modelos de linguagem mudaram a PNL: chat, geração, ferramentas. O treinamento já foi caro; servir custa caro a cada segundo. A decodificação é autoregressiva. Cada novo token precisa das chaves e valores anteriores. A memória para esse cache KV é proporcional a camadas × cabeças × ocultas × sequência × lote. O pré-preenchimento exige muita computação; a decodificação exige muita largura de banda de memória. Se você alocar um tensor KV de comprimento máximo contíguo por solicitação, a maior parte dele ficará vazia até que a sequência realmente cresça - fragmentação interna clássica. Solicitações simultâneas não podem roubar essas lacunas. O tamanho do lote diminui. Queda de tokens por segundo. As GPUs parecem ocupadas e ainda ociosas.
Esse é o problema que PagedAttention e vLLM atacaram em 2023, e o problema PowerInfer e variantes de atenção posteriores ainda atacam de diferentes ângulos.
Assista: modelo mental LLM
Vídeo de contexto: Introdução aos grandes modelos de linguagem. Explicador Workstation: como funcionam os LLMs e como executá-los no Kubernetes.
2. PagedAttention: paginação para o cache KV
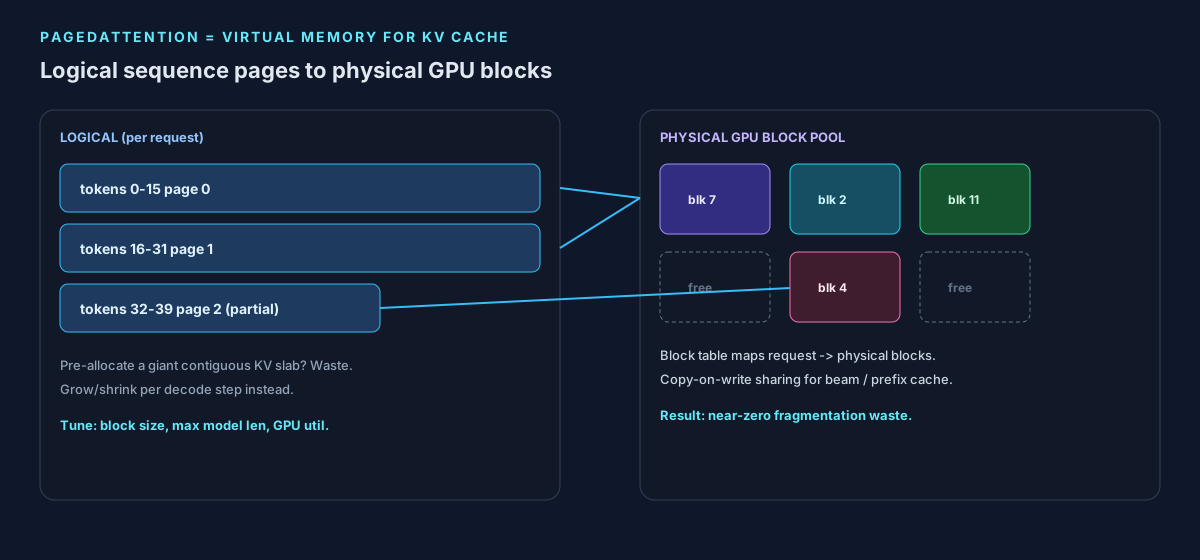
Kwon, Li, Zhuang, Sheng, Zheng, Yu, Gonzalez, Zhang e Stoica introduziram o PagedAttention como um algoritmo de atenção inspirado na memória virtual e na paginação do sistema operacional, e construíram o vLLM em cima dele [arXiv:2309.06180]. A ideia:
- Dividir KV em blocos de tamanho fixo (um pequeno número de tokens por bloco).
- Mantenha um tabela de blocos de posições de token lógico a blocos GPU físicos (possivelmente não contíguos).
- Aloque/libere blocos à medida que as sequências crescem ou terminam - como alocação de páginas, não como malloc de um array gigante.
- Compartilhe blocos (cópia na gravação) para reutilização de prefixos, pesquisa de feixe e amostragem paralela para não duplicar prefixos idênticos.
A implementação não é “definir um sinalizador no BERT”. O núcleo de atenção deve reunir blocos dispersos. O escalonador deve saber quais blocos estão livres. A hierarquia de cache é importante: blocos residentes em HBM vs descarregamento CPU vs peers NVLink. O tamanho do buffer (bloco) é um botão real. Muito pequeno: mais pesquisas de tabela e sobrecarga de kernel. Muito grande: slots desperdiçados dentro do último bloco parcial. Combine o tamanho do bloco com max_model_len e a combinação real de prompt/conclusão do seu tráfego.
Prática: fragmentação de perfil (bytes KV não utilizados/bytes KV reservados) e tokens/s juntos. Gráficos de memória sem taxa de transferência são vaidade.
3. vLLM: o sistema de atendimento em torno do pager
A afirmação do vLLM é de quase zero desperdício de memória cache KV, além de compartilhamento flexível dentro e entre solicitações. As avaliações no artigo mostraram aproximadamente 2–4× rendimento versus sistemas SOTA da época (FasterTransformer, Orca) com latência semelhante, com ganhos maiores em sequências longas e decodificação mais sofisticada. Hoje, o mecanismo também oferece lote contínuo, pré-preenchimento fragmentado, cache de prefixo e paralelo de tensor/pipeline para multi-GPU.
Lista de verificação operacional:
- Definir
gpu_memory_utilizationalto o suficiente para suportar pesos + KV, baixo o suficiente para sair do espaço de trabalho CUDA. - Habilite o cache de prefixo somente depois de confirmar as pontuações de avaliação e p95 TTFT ativado seu instruções.
- Separe pools pesados de pré-preenchimento e pesados de decodificação se o tráfego misto prejudicar o SLO (serviço desagregado).
- Exponha endpoints compatíveis com OpenAI atrás de seu gateway (as propriedades Workstation geralmente deixam isso para trás Gateway WSL Proxy/API padrões).
from vllm import LLM, SamplingParams

llm = LLM(
    model="meta-llama/Llama-3.1-8B-Instruct",
    gpu_memory_utilization=0.90,
    max_model_len=8192,
    enable_prefix_caching=True,
)
params = SamplingParams(temperature=0.2, max_tokens=256)
outs = llm.generate(["Summarise PagedAttention for a platform engineer."], params)
print(outs[0].outputs[0].text)
Antipadrão (este é não PagedAttention):
# Classifier forward pass — logits, not paged KV serving
import torch
from transformers import AutoModelForSequenceClassification
model = AutoModelForSequenceClassification.from_pretrained("bert-base-uncased")
out = model(torch.tensor([[1, 2, 3]]), attention_mask=torch.tensor([[1, 1, 1]]))
print(out.logits)
Assista: servindo sistemas em estado selvagem
Conversa de serviço contextual. Redação canônica: Blog vLLM (PagedAttention) · motor: projeto vllm/vllm.
4. Self-Debugging: mais qualidade por candidato, não mais candidatos
Chen, Lin, Klein, et al. mostraram que ensinar um LLM a depurar seu programa previsto com demonstrações de poucas tentativas pode igualar ou superar linhas de base que geram mais de 10 vezes mais candidatos [arXiv:2304.05128]. O loop é: gerar → executar ou teste de unidade → alimentar os rastreamentos → reparar.
Compromisso de produção: cada mensagem de feedback é outro pré-preenchimento + decodificação (ou um longo acréscimo de contexto). A precisão geralmente aumenta com mais rodadas; o mesmo acontece com a latência e o custo. Orientação Workstation para agentes (veja também Muse Glimmer/agentes locais):
- Limite rígido nas rodadas de depuração (por exemplo, 2–4) por chamada de ferramenta.
- Tokens de orçamento separados do bate-papo visível ao usuário.
- Escale para um modelo humano ou especializado em vez de tentativas infinitas.
- Log traces for eval – Self-Debugging sem telemetria é folclore.
5. PowerInfer: geração de token com reconhecimento de localidade
PowerInfer (SJTU IPADS / repositórios relacionados) é um sistema de geração de token que explora a localidade de ativação: um pequeno neurônio “quente” definido em GPU, pesos mais frios transmitidos ou executados em CPU. Os pontos operacionais publicados incluem Média de 13,20 tokens/s e Pico de 29,08 tokens/s em uma única NVIDIA RTX 4090 e até 11,69× versus llama.cpp com precisão mantida [PowerInfer GitHub]. (Forks voltados para o usuário, como Tiiny-AI/PowerInfer, rastreiam a mesma linha de trabalho.)
A expansão é a parte difícil. Um único perfil de localidade 4090 não se torna automaticamente uma implantação do Kubernetes íntegra. Você precisa de:
- Solicitações/limites GPU honestos e fixação CPU com reconhecimento de NUMA se especialistas CPU executarem.
- Um plano distribuído se o modelo não se ajustar mais: paralelo tensor vs pipeline vs paralelo especialista.
- Divisão de SLO: bate-papo interativo versus conclusão em lote versus loops de ferramentas do agente.
Use PowerInfer (ou llama.cpp, ou MLX) em estações de trabalho e caixas de borda; use vLLM (ou TensorRT-LLM ou SGLang) ao preencher GPUs de datacenter com tráfego simultâneo no estilo OpenAI. Meça ambos. Nosso Laboratório de IA Empresarial postura é a mesma que Polyglot Benchmarks: evidência, depois ADR.
6. EG-MLA: concentre a atenção na arquitetura
Servir truques não pode consertar um modelo cujo KV é intrinsecamente grande. Relatórios EG-MLA (atenção latente de múltiplas cabeças com controle de incorporação) mais de 91,6% de redução no tamanho do cache KV versus atenção multicabeças (MHA) com degradação insignificante, economia adicional versus MLA (até 59,9%) e maior precisão de referência de raciocínio. Os autores argumentam que a incorporação de gating induz interações implícitas de alta ordem e mostra a escala além dos parâmetros 1B [EG-MLA, arXiv].
Implicação de engenharia: esta é uma formação / arquitetura decisão. Você não pode inverter o EG-MLA em um vLLM aleatório todas as noites do Llama-3 e esperar as porcentagens do papel. Se você controlar o pré-treinamento ou o pré-treinamento contínuo, o EG-MLA é um candidato a reduzir o HBM antes de comprar outro GPU. Se você atende apenas pesos públicos, permaneça nas variantes PagedAttention + quantização + MLA que o mecanismo já suporta e rastreie os pontos de verificação EG-MLA conforme eles pousam.
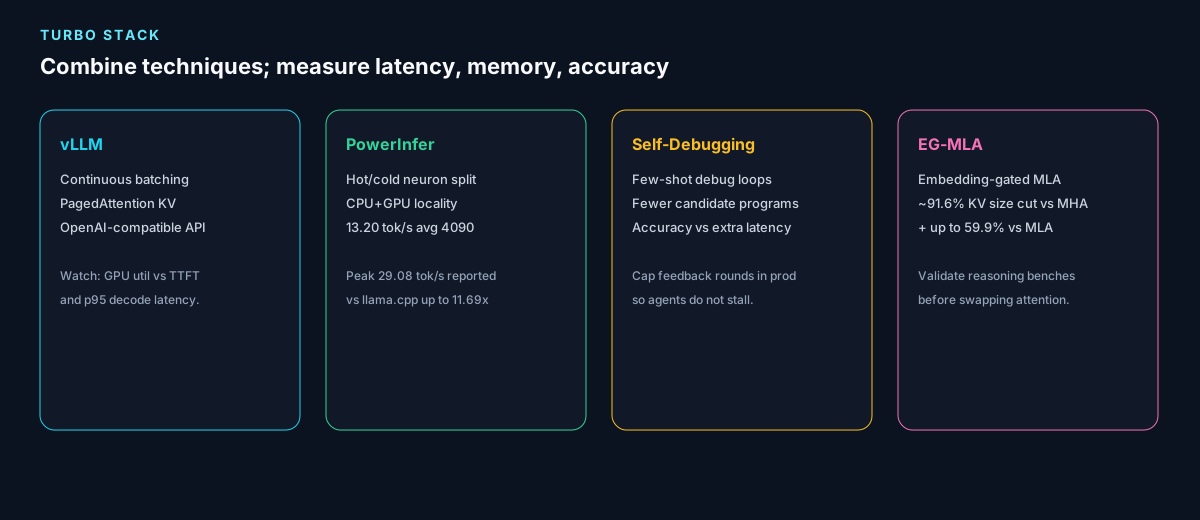
7. Combinando a pilha sem culto de carga
| Camada | Usar quando | Atenção |
|---|---|---|
| PagedAttention/vLLM | Serviço API simultâneo, contexto longo, prefixos compartilhados | Cache de prefixo vs correção; OOM em alta utilidade |
| PowerInfer | Taxa única de token GPU/estação de trabalho | Incompatibilidade de localidade; expansão confusa |
| Self-Debugging | Loops de código/agente que podem executar testes | Rodadas ilimitadas; custo extra de pré-preenchimento |
| EG-MLA | Você treina ou ajusta a espinha dorsal | Não é uma bandeira de serviço; executar novamente a avaliação completa |
8. Escalabilidade no Kubernetes
Uma arquitetura distribuída bem projetada aumenta o rendimento e também aumenta os modos de falha: retardatários, transferência de cache KV, distorção do tokenizador e escalonadores automáticos que eliminam prefixos quentes. Padrão prático (alinhado com nosso Ollama/vLLM no Kubernetes redação):
- Pools de nós GPU dedicados; nunca empacote pods de decodificação com trabalhos CPU aleatórios.
- Pré-preenchimento e decodificação separados se SLOs TTFT e tokens/s SLOs brigarem.
- HPA na profundidade da fila ou ocupação GPU KV, não apenas CPU.
- Promova pilhas de serviço por meio de anéis (Ring Promoter) portanto, uma construção de mecanismo incorreta não pode ignorar o teste.
9. Conclusão
Turbocharging LLMs não é um algoritmo. É paginação do cache KV (PagedAttention), um mecanismo de serviço que não desperdiça essas páginas (vLLM), geração com reconhecimento de localidade quando o hardware é uma estação de trabalho GPU (PowerInfer), loops de agente que depuram em vez de pulverizar candidatos (Self-Debugging) e - quando você possui os pesos - atenção que simplesmente armazena menos (EG-MLA). Cada camada troca memória, latência e precisão. Meça seu tráfego. Publicar o ADR. Enviar.
Referências
- Kwon et al. - Gerenciamento eficiente de memória para atendimento de modelos de linguagem grande com PagedAttention (arXiv:2309.06180, 14 de setembro de 2023).
- Chen et al. - Ensinando grandes modelos de linguagem para autodepuração (arXiv:2304.05128, 12 de abril de 2023).
- PowerInfer — SJTU-IPADS/PowerInfer (e garfos Tiiny-AI relacionados).
- EG-MLA — Atenção latente de múltiplas cabeças com controle de incorporação (arXiv, 20 de setembro de 2025).
- Blog vLLM — Servir LLM fácil, rápido e barato com PagedAttention.
Publicado por Workstation. Figuras de papel citadas conforme publicadas pelos autores originais; os números de produção em seu cluster serão diferentes.


