
Workstationतकनीकी संक्षिप्त:LangfuseOpenTelemetry, Prometheus / Grafana / Thanos, और LLM प्लेटफॉर्म जैसे Langfuse/LMNRके साथ को उजागर कैसे करें - जिसमें स्पैन स्कीमा, कॉस्ट एटट्रिब्यून, सैंपलिंग और हार्ड शामिल हैं। उपयोग कैप्स।टर्बोचार्जिंग LLMs· प्रयोगशाला:Enterprise AI Lab
- समस्या:एजेंट लागत और विलंबता हॉप्स (LLM → टूल्स → RAG → retries) में छिपा हुआ है, एक एकल "मॉडल धीमी है" मीट्रिक में नहीं।
- मानक:OpenTelemetry के साथ साधन; टोकन, मॉडल, किरायेदार, मार्ग, अनुमानित cost usd के लिए एक विशेषता स्कीमा।
- मीट्रिक पथ:Prometheus (+ Thanos) सुनहरा संकेतों के लिए; SLOs और FinOps बोर्ड के लिए Grafana। XT35X
- LLM पथ:Langfuse / LMNR निशान, स्कोर, डेटासेट, शीघ्र संस्करण के लिए।
- नियंत्रण:कैप टोकन, टूल कॉल और डिबग राउंड; चरण कठिनाई से मार्ग मॉडल।
- विन:इससे पहले कि आप अधिक GPU खरीदते हैं या एपीआई कोटा बढ़ाते हैं, लागत-प्रति-successful-task उपाय करें।
1. क्या "bottleneck" LLM एजेंट
के लिए मतलबप्रशिक्षण-समय की बाधाओं (डेटा, FLOP) सेवा समय औरएजेंट समयbottlenecks से भिन्न हैं। उत्पादन एजेंटों में प्रमुख अपशिष्ट मोड हैं:
- प्रॉम्प्ट ब्लॉट- ओवरसाइज़्ड सिस्टम प्रॉम्प्ट, अप्रयुक्त संदर्भ, लापता उपसर्ग / कैश हिट।
- मॉडल ओवरकिल- फ्रंटियर मॉडल का उपयोग वर्गीकरण / रूट चरणों के लिए किया जाता है जो एक छोटा मॉडल कर सकता है।
- Unbounded loops- एक हार्ड बजट के बिना टूल रिट्रीज़ और सेल्फ-डेबग चक्र (टर्बोचार्जिंग LLMs में Self-Debugging ट्रेड-ऑफ देखें).
- बाहरी प्रतीक्षा- वेक्टर डीबी, सास एपीआई, और मानव-in-the-loop गेट्स ने "LLM विलंबता" के लिए गलत योगदान दिया।
- खंडन- KV कैश अपशिष्ट GPU (PagedAttention / vLLM क्षेत्र) पर पहले से ही पुष्टि करने के बाद एजेंट ग्राफ़ साफ है।
वितरित निशान के बिना आप इन्हें अलग नहीं कर सकते। इसलिए अवलोकनशीलता एक अच्छा डैशबोर्ड नहीं है - यह एआई उत्पादों पर FinOps और SRE के लिए नियंत्रण विमान है।
2. संदर्भ वास्तुकला
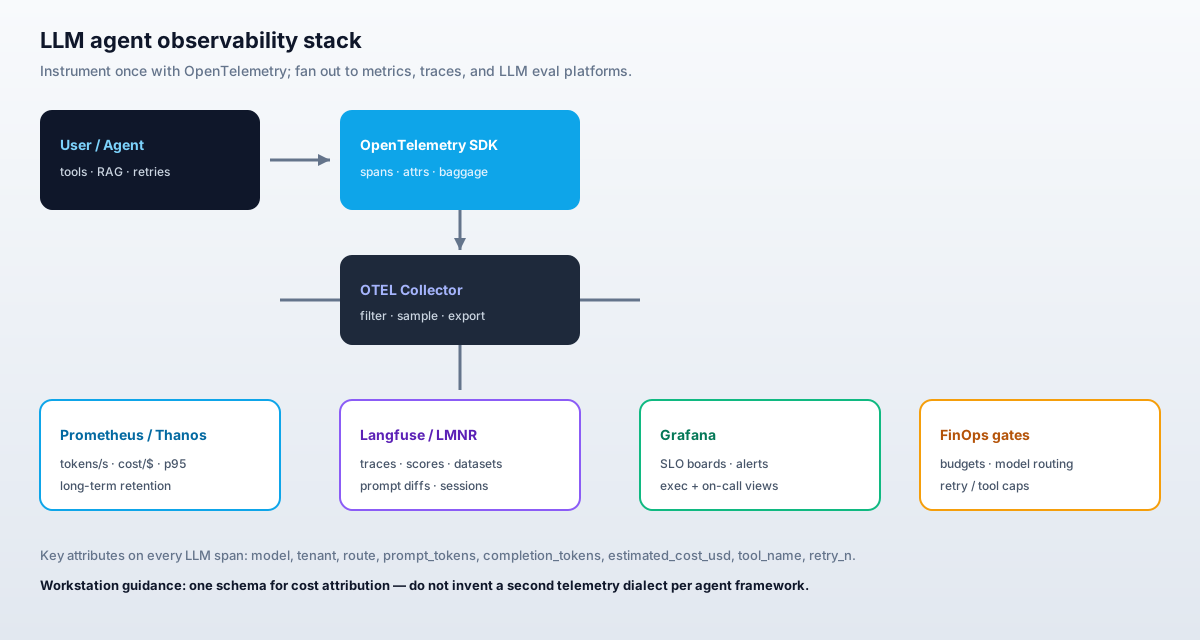
User / Orchestrator
    → Agent runtime (tools, RAG, LLM calls)
        → OpenTelemetry SDK (spans + metrics)
            → OTEL Collector (filter, sample, redact)
                ├─→ Prometheus / Thanos   (rates, costs, SLOs)
                ├─→ Grafana              (boards, alerts)
                └─→ Langfuse / LMNR      (traces, scores, datasets)
FinOps / policy layer reads the same metrics to enforce caps and model routing.
3. LLM कॉल के लिए OpenTelemetry स्पैन स्कीमा
फ्रेमवर्क (LangChain, कस्टम Go/Python एजेंट, Bedrock SDK) में एक सम्मेलन को अपनाने। जब वे अस्तित्व में हैं, और स्थिर Workstation विशेषताओं के साथ विस्तार:
| विशेषता | उदाहरण | क्यों |
|---|---|---|
gen_ai.system | openai / anthropic / bedrock / vllm | |
gen_ai.request.model | claude-sonnet-4 / llama-3.1-8b | लागत & amp; मॉडल |
gen_ai.usage.input_tokens | 1820 | शीघ्र लागत चालक |
gen_ai.usage.output_tokens | 410 | पूर्णता लागत चालक |
wsw.estimated_cost_usd | 0.0124 | FinOps |
wsw.tenant_id | acme-prod | चार्जबैक |
wsw.route | समर्थन.triage | उत्पाद सुविधा attribution |
wsw.agent_step | योजना / उपकरण / critique | महंगे कदम |
wsw.retry_n | 2 | लूप |
wsw.prompt_version | triage@v17 | Regression linkage |
from opentelemetry import trace
from opentelemetry.trace import Status, StatusCode

tracer = trace.get_tracer("workstation.agents")

PRICE_IN = 0.003 / 1000   # example $/token — load from config
PRICE_OUT = 0.015 / 1000

def complete_llm(model: str, prompt: str, tenant: str, route: str):
    with tracer.start_as_current_span("gen_ai.chat") as span:
        span.set_attribute("gen_ai.system", "openai")
        span.set_attribute("gen_ai.request.model", model)
        span.set_attribute("wsw.tenant_id", tenant)
        span.set_attribute("wsw.route", route)
        try:
            resp = client.chat.completions.create(
                model=model,
                messages=[{"role": "user", "content": prompt}],
            )
            usage = resp.usage
            cost = usage.prompt_tokens * PRICE_IN + usage.completion_tokens * PRICE_OUT
            span.set_attribute("gen_ai.usage.input_tokens", usage.prompt_tokens)
            span.set_attribute("gen_ai.usage.output_tokens", usage.completion_tokens)
            span.set_attribute("wsw.estimated_cost_usd", round(cost, 6))
            return resp.choices[0].message.content
        except Exception as e:
            span.record_exception(e)
            span.set_status(Status(StatusCode.ERROR, str(e)))
            raise
प्रैक्टिस:नेestimated_cost_usdको स्पैन में कम्प्यूट किया। एक रात के काम के लिए इंतजार न करें, टोकन गिनती में शामिल होने के लिए मूल्य शीट - ऑन-कॉल और उत्पाद मालिकों को लाइव FinOps की आवश्यकता होती है।3b। बहु एजेंट स्पैन पदानुक्रम और बैगेज
एजेंट ग्राफ़ को एक स्थिर माता-पिता / बच्चे मॉडल की आवश्यकता होती है ताकि लागत सही ढंग से रोल हो सके:
session (root)
  └─ agent.run {wsw.route, wsw.tenant_id}
       ├─ rag.retrieve {wsw.agent_step=retrieve}
       ├─ gen_ai.chat {wsw.agent_step=plan, model=…}
       ├─ tool.execute {tool=…, wsw.retry_n}
       ├─ gen_ai.chat {wsw.agent_step=synthesize}
       └─ eval.score {score.name, score.value}
- प्रति उपयोगकर्ता कार्य— प्रति LLM कॉल नहीं। सत्र लागत = बच्चे
wsw.estimated_cost_usdका योग। - बैगेज-
wsw.tenant_idऔरwsw.routeको async श्रमिकों / कतारों में प्रचारित करें ताकि उपकरण स्पैन बिना किसी चार्जबैक लेबल को प्राप्त कर सकें प्रत्येक कॉल साइट को पुनः लोड करना। - लिंक- जब एक उप-एजेंट एक नया ट्रेस शुरू करता है (उदाहरण के लिए अलग-अलग कतार उपभोक्ता), स्पैन लिंक का उपयोग माता-पिता सत्र के लिए वापस किया जाता है, इसलिए Langfuse / Grafana अभी भी ग्राफ को सिलाई कर सकता है।
- हमेशा-नमूना उच्च लागत- 5-20% पर सिर नमूना खुश पथ के लिए ठीक है; जब सत्र एक थ्रेसहोल्ड या स्टेटस = ERROR से अधिक होता है तो बल नमूना।
4. मीट्रिक जो पदार्थ (Prometheus)
एक्सपोर्ट हिस्टोग्राम और काउंटर ( OTEL मीट्रिक या Prometheus क्लाइंट के माध्यम से)। न्यूनतम व्यवहार्य सेट:
llm_requests_total{model,route,status}llm_tokens_total{model,direction}जहां दिशा निर्देश {input,output}llm_estimated_cost_usd_total{model,tenant,route}llm_ttft_seconds/llm_e2e_secondsहिस्टोग्रामagent_tool_calls_total{tool,status}agent_retries_total{route}agent_task_success_total{route}- लागत-प्रति-success के लिए विभाजक
Derived FinOps क्वेरीज़ (PromQL स्केच):
# Cost per successful task (last 1h), by route
sum(rate(llm_estimated_cost_usd_total[1h])) by (route)
  /
sum(rate(agent_task_success_total[1h])) by (route)

# Retry tax
sum(rate(agent_retries_total[1h])) by (route)
  /
sum(rate(llm_requests_total[1h])) by (route)
Thanos(or Mimir / Cortex) मामले जब वित्त तिमाही-अवधि मॉडल खर्च के लिए पूछता है। स्थानीय Prometheus अकेले ऑन-कॉल के लिए ठीक है; यह एक FinOps संग्रह नहीं है।
5. Grafana बोर्ड और अलर्ट
जहाज तीन दर्शकों से एक डेटासोर्स:
- On-call:त्रुटि दर, p95 e2e, निर्भरता विफलता (vector DB / उपकरण)।
- प्लेटफार्म:tokens/s, GPU Util (यदि स्वयं होस्ट किया गया है), queue गहराई, TTFT.
- FinOps / उत्पाद:किरायेदार और मार्ग, शीर्ष महंगे संकेत, मॉडल मिश्रण द्वारा $ / सफलता।
चेतावनी जलने पर, वैनिटी नहीं:
- कॉस्ट-per-success > 30m के लिए बजट SLO
- Retry rate > एक मार्ग के लिए 15%
- p95 e2e भंग के साथ बढ़ती इनपुट टोकन (prompt regression)
6. LLM-native प्लेटफॉर्म: Langfuse, LMNR, और दोस्तों
मेट्रिक्स आपकोबताते हैं किकी लागत बढ़ गई है; LLM प्लेटफॉर्म आपकोबताते हैं जोऔरको संकेत देते हैं जो टूल स्पैनने इसे किया था।LangfuseऔरLMNRइस वर्ग के खुले स्रोत उदाहरण हैं:
- Hierarchical निशान (session → एजेंट → LLM / उपकरण स्पैन)
- मानव और LLM-as-judge स्कोर जब ऑफ़लाइन eval के लिए
- डेटासेट आप को प्रेरित करते हैं उत्पाद सुधार के लिए
- वैकल्पिक उपयोग टेलीमेट्री
इंटीग्रेशन पैटर्न: OTEL को SRE के लिए रिकॉर्ड की प्रणाली के रूप में रखें; त्वरित इंजीनियरिंग के लिए Langfuse में दोहरी-निर्यात या पुल। एक दूसरे, असंगत विशेषता शब्दकोश का आविष्कार न करें।
फ्रेमवर्क प्रयोगों जैसे कि फंक्शन-पहली एजेंट रनटाइम्स (हाथ से संरचित स्ट्रीमिंग एजेंटों के आसपास विपणन) बॉयलरप्लेट को कम कर सकते हैं, लेकिन वैकल्पिक-अवलोकन मानकों के रूप में आला ढांचे का इलाज करते हैं उन्हें।
7. स्कोरिंग पाइपलाइन: मैनुअल बनाम स्वचालित
| विधि | कार्यान्वयन | विफलता मोड |
|---|---|---|
| मैनुअल | अंगूठे / Langfuse UI में rubrics; सोने सेट समीक्षा। | स्केल नहीं करता; अभी भी अंशांकन के लिए आवश्यक है। |
| स्वचालित | LLM-as-judge, यूनिट चेक, स्कीमा सत्यापनकर्ता, पुनर्प्राप्ति वापस। | न्यायाधीश बहाव; जुआ खेलने के लिए केवल न्यायाधीश के लिए आशाजनक है। |
अटैच स्कोर स्पैन इवेंट्स के रूप में याwsw.prompt_versionद्वारा की गई Langfuse स्कोर। गेट प्रोन्नति को उसी तरह से प्रेरित करता है जिस तरह से आप गेट ऐप संस्करण - Ring Promoter कोड के लिए; संकेत के लिए इवल गेट्स।
8. लागत बचत प्रक्रिया (विवरण)
- बेसलाइन सप्ताह:कोई व्यवहार परिवर्तन; केवल इंस्ट्रूमेंटेशन। $/success, tokens/success, retry rate.
- Attribution:रैंक मार्गों द्वारा खर्च × मात्रा। शीर्ष तीन चुनें।
- मॉडल रूटिंग:विभाजित वर्गीकरण / छोटे / स्थानीय मॉडल के लिए निकालें; संश्लेषण के लिए फ्रंटियर रखें। फिर से माप गुणवत्ता स्कोर।
- प्रोम्प्ट सर्जरी:अप्रयुक्त टूल स्कीमा को हटा देता है; कुछ-शॉट को छोटा करता है; प्रीफ़िक्स कैश को सक्षम करता है जहां सुरक्षित है।
- लूप कैप:मैक्स टूल कॉल, मैक्सिम सेल्फ-डेबग राउंड, सर्किट ब्रेकर के साथ एक्सोनेंशियल बैकऑफ।
- सैम्पलिंग:100% मीट्रिक रखता है; नमूना निशान (जैसे 5-20%) त्रुटियों और उच्च लागत वाले सत्रों के लिए हमेशा नमूना।
- Redaction:स्ट्रिप PII निर्यात से पहले स्पैन विशेषताओं से; केवल TTL के साथ अनुमोदित स्टोरों में स्टोर करें।
- समीक्षा कैडेंस:साप्ताहिक FinOps बोर्ड; मनुष्यों के खिलाफ मासिक न्यायाधीश अंशांकन।
8b। लाइव बजट
के साथ प्रबंध एजेंट उपयोगडैशबोर्ड अकेले चलने वाले एजेंटों को बंद नहीं करते हैं। रनटाइम में बजट को लागू करने के लिए, एक स्पैन इवेंट के रूप में निर्णय का उत्सर्जन करते हैं, और जब सत्र छत को अक्सर हिट करते हैं, तो चेतावनी देते हैं:
# Pseudocode: hard budget around an agent session
class Budget:
    def __init__(self, max_usd=0.50, max_tool_calls=8, max_llm_calls=12):
        self.max_usd, self.max_tool_calls, self.max_llm_calls = max_usd, max_tool_calls, max_llm_calls
        self.spent = 0.0
        self.tools = self.llms = 0

    def charge(self, usd: float, kind: str):
        self.spent += usd
        if kind == "tool":
            self.tools += 1
        else:
            self.llms += 1
        if self.spent > self.max_usd or self.tools > self.max_tool_calls or self.llms > self.max_llm_calls:
            raise RuntimeError("agent budget exhausted")
- प्रति सत्र कैप्स- USD, LLM कॉल, टूल कॉल (ऊपर)।
- प्रति किरायेदार दैनिक कोटा— Redis/काउंटर
wsw.tenant_idद्वारा कुंजी; निकास के दौरान एक नियंत्रित विकृत पथ वापस लौटें। - प्रति रूट मॉडल नीति-
support.triageबनामlegal.draftके लिए अनुमति देने वाले मॉडल; पॉलिसी मिस और रिकॉर्डwsw.policy_action=downshiftपर अस्वीकार या downshift। - Idempotent टूल कुंजी- हैश टूल आर्ग्स इसलिए रिट्रीज़ डबल-बिल बाहरी एपीआई नहीं हैं।
- कॉस्ट सूत्र-
cost = in_tokens × p_in + out_tokens × p_out + tool_fees;p_in/p_outको एक संस्करण मूल्य शीट से रिफ्रेश करें, इसलिए ऐतिहासिक Thanos डेटा तुलनात्मक रूप से रहता है।
मीट्रिक टोपी भूमि के बाद देखने के लिए:agent_budget_exhausted_total{route,reason}। एक स्पाइक का मतलब है या तो दुरुपयोग, टूटे हुए टूल लूप, या एक बजट जो वास्तविक वर्कलोड के लिए बहुत तंग है।
9. कलेक्टर विन्यास स्केच
# otel-collector-config.yaml (illustrative)
receivers:
  otlp:
    protocols:
      http:
      grpc:
processors:
  memory_limiter: {}
  batch: {}
  attributes/redact:
    actions:
      - key: gen_ai.prompt
        action: delete
exporters:
  prometheus:
    endpoint: "0.0.0.0:8889"
  otlp/langfuse:
    endpoint: "${LANGFUSE_OTLP_ENDPOINT}"
    headers:
      Authorization: "Bearer ${LANGFUSE_KEY}"
service:
  pipelines:
    traces:
      receivers: [otlp]
      processors: [memory_limiter, attributes/redact, batch]
      exporters: [otlp/langfuse]
    metrics:
      receivers: [otlp]
      processors: [memory_limiter, batch]
      exporters: [prometheus]
10. पेशेवरों, विपक्ष, और जब
को परेशान नहीं कियाPros:चार्जबैक, तेज घटना ट्रैज, त्वरित / मॉडल परिवर्तनों पर मापने योग्य ROI, अनुपालन-अनुकूल लेखा परीक्षा ट्रेल्स, एमएल और प्लेटफॉर्म टीमों के बीच साझा भाषा।
Cons:इंस्ट्रूमेंटेशन ऋण; भंडारण लागत अगर आप हमेशा के लिए हर कदम रखते हैं; गलत बैकएंड में PII शिपिंग का जोखिम; इंजीनियरों को सीखने के लिए एक और कंसोल।
स्किप (अब के लिए) यदि:आपके पास निश्चित दैनिक खर्च और कोई इंटरैक्टिव एजेंट के साथ एक ऑफलाइन बैच का काम है। फिर भी लॉग टोकन; पूर्ण बहु-बैकेंड स्टैक को छोड़ दें जब तक कि सहमति दिखाई न दे।
11. माइग्रेशन चेकलिस्ट
- एजेंट रनटाइम में OTEL SDK; क्लस्टर में कलेक्टर
- स्पैन विशेषताओं में मॉडल, टोकन, लागत, किरायेदार, मार्ग शामिल हैं।
- Prometheus मीट्रिक + Grafana FinOps बोर्ड
- Langfuse LMNR) कम से कम एक महत्वपूर्ण पथ के लिए वायर्ड
- tokens / tools / retries पर हार्ड कैप्स
- ने सुरक्षा द्वारा समीक्षा की
- ने शीर्ष मार्गों के लिए $ / success की साप्ताहिक समीक्षा
- दस्तावेज़ ADR जोड़ने observability → सेवारत (vLLM) → पदोन्नति (Ring Promoter)
12. संबंधित Workstation सामग्री
- व्यापार ब्लॉग साथी
- टर्बोचार्जिंग LLMs- ठीक करने के बाद आप बोतलबंद देख सकते हैं
- Ring Promoter- स्वास्थ्य द्वार के साथ एजेंट सेवाओं को बढ़ावा देना
- Muse Glimmer / स्थानीय एजेंट
- संपर्क Enterprise AI Lab सगाई के लिए Workstation
संदर्भ
Workstationद्वारा प्रकाशित।


