
El deep learning (DL) es aprendizaje de representaciones con redes neuronales multicapa: los parámetros θ se optimizan para que una composición de transformaciones no lineales mapee entradas de alta dimensión (píxeles, tokens, formas de onda) a salidas de tarea (etiquetas, boxes, embeddings o secuencias muestreadas). Este brief técnico de Workstation reescribe la visión conceptual de AWS para ingenieros y agentes de IA que despliegan sistemas en Kubernetes, SageMaker y Bedrock.
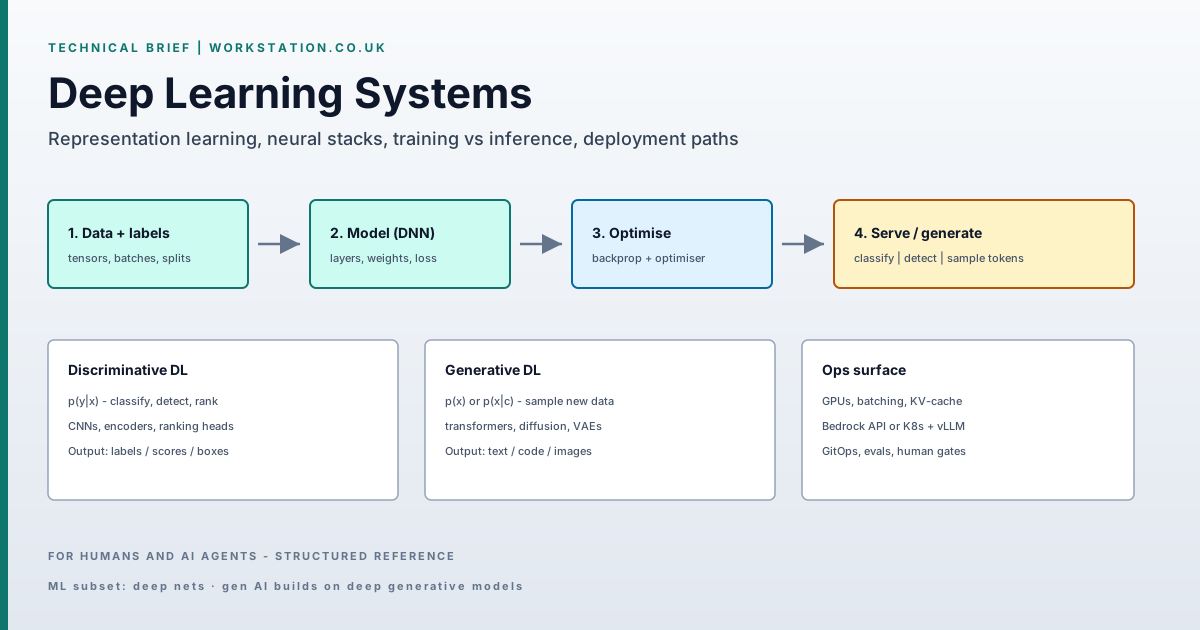
- Definición: DL ⊂ ML; ANN multicapa entrenadas principalmente por descenso de gradiente sobre una pérdida diferenciable.
- División: discriminativo p(y|x) vs generativo p(x) o p(x|c).
- Gen AI: normalmente grandes transformers (o difusión) + serving + política; no es una ciencia separada del DL.
- Restricciones duras: volumen de datos etiquetados/limpiados, FLOPs/VRAM del acelerador, drift/ops.
- Ruta: tabular → ML clásico; percepción → entrenar/servir DL; agentes de lenguaje → API de foundation model o inferencia open-weight.
Fuente primaria: AWS — What is Deep Learning?. Las specs y nombres de servicios cambian; verifique la documentación actual de AWS antes de aprovisionar.
1. Definición formal
Un modelo profundo es una función paramétrica f_θ compuesta de L capas. La capa ℓ calcula h^(ℓ) = σ(W^(ℓ) h^(ℓ−1) + b^(ℓ)) para una no linealidad σ (ReLU, GELU, SiLU, etc.). El entrenamiento busca θ = {W, b, …} para minimizar el riesgo empírico:
θ* = argmin_θ  (1/N) Σ_i  L( f_θ(x_i), y_i )  +  Ω(θ)
# L = CE / MSE / CTC / contrastive / RL objective, depending on task
# Gradients via reverse-mode autodiff (backpropagation); update with SGD/Adam/…
A diferencia de pipelines superficiales que dependen de features diseñadas a mano, las redes profundas aprenden features jerárquicas a partir de tensores crudos o ligeramente preprocesados. Por eso el DL domina visión, habla y NLP a gran escala: el espacio de features es demasiado alta dimensión para la ingeniería manual.
2. Deep learning discriminativo vs generativo
Los modelos discriminativos estiman p(y|x) o un límite de decisión — clasificadores, detectores, rankers, embedders. Los modelos generativos (deep generative) estiman p(x) o p(x|c) y pueden muestrear nuevas instancias: LLMs next-token, modelos de imagen por difusión, VAEs, GANs.
Los foundation models usados en agentes de producto son sistemas generativos profundos entrenados a escala, luego alineados y servidos. Llamar a Bedrock Converse o a un endpoint vLLM autoalojado es inferencia sobre tal modelo — sigue siendo deep learning debajo.
3. Por qué los sistemas de producción dependen de él
Superficies desplegadas que ya incrustan DL (o foundation models respaldados por DL):
- Agentes conversacionales y síntesis de código
- ASR / TTS e UIs de voz
- Scoring de fraude / anomalía en secuencias
- Pilas de percepción (ADAS, CV industrial, imagen médica)
- Personalización y ranking de búsqueda con torres profundas
Si un ítem de roadmap es «funcionalidad de IA», la implementación casi siempre es un modelo profundo, una API de foundation-model, o un híbrido (RAG + tools) encima.
4. Taxonomía de tareas (mapa de implementación)
4.1 Visión por computador
CNNs / ViTs mapean tensores de imagen a clases, boxes, masks o embeddings. Patrones de producción: moderación de contenido, reconocimiento de atributos, detección de logo/PPE, inspección de defectos en línea. Métricas: mAP, IoU, latencia a batch size 1 en GPU objetivo.
4.2 Habla
Modelos acústicos + modelos de lenguaje (o ASR end-to-end) toleran acento, SNR y varianza de velocidad de habla. Cargas: asistencia en contact-centre, dictado clínico, subtitulado. Métricas: WER, factor en tiempo real (RTF).
4.3 NLP
Desde clasificadores encoder hasta LLMs decoder-only. Cargas: intent/slot, resumen, QA documental, indexación de sentimiento. Los LLMs dominan texto abierto; encoders más pequeños aún ganan en classify/extract acotados por latencia.
4.4 Recomendadores
Rankers two-tower / DeepFM / transformer sobre secuencias de interacción user–item. Salidas: listas ordenadas con diversidad y restricciones de negocio. Offline: NDCG/recall; online: CTR/CVR con controles de exploración.
4.5 Aplicaciones generativas
Muestreo + uso de tools: RAG sobre corpora privados, asistencia de código, redacción de documentos, workflows multiagente. En AWS: Bedrock FMs o pesos alojados en SageMaker. En estates Workstation: pools GPU de Kubernetes (vLLM/Ollama) bajo GitOps cuando la residencia o la economía unitaria lo exigen.
5. Arquitectura: capas y forward pass
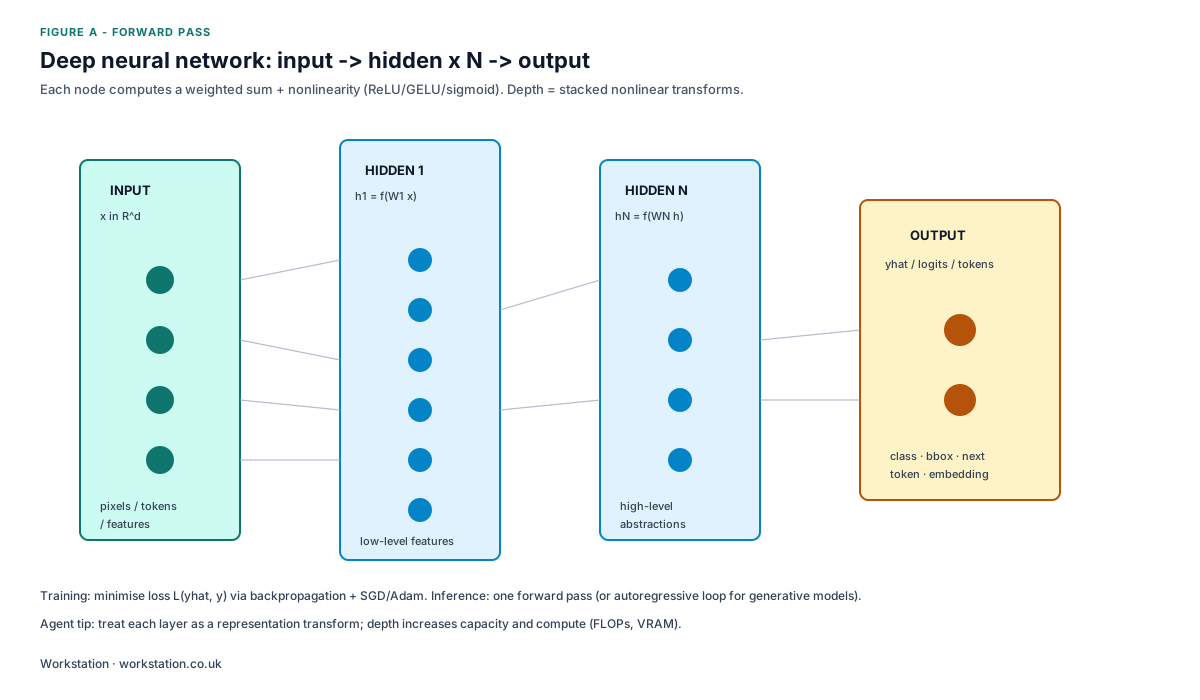
- Capa de entrada — interfaz de tensor: píxeles normalizados, IDs de tokens, frames log-mel o vectores tabulares.
- Capas ocultas — transforms de representación sucesivos. Las capas tempranas capturan estructura local (bordes, n-grams); las más profundas capturan semántica de tarea. La profundidad aumenta capacidad expresiva y compute (FLOPs, memoria de activación).
- Capa de salida — cabeza de tarea: logits softmax, regresión de bounding-box, CTC, o proyección de vocab para decodificación autorregresiva.
Entrenamiento = muchos forward + backward passes. Inferencia = solo forward (más KV-cache / speculative decoding para LLMs).
6. ML vs DL vs IA generativa
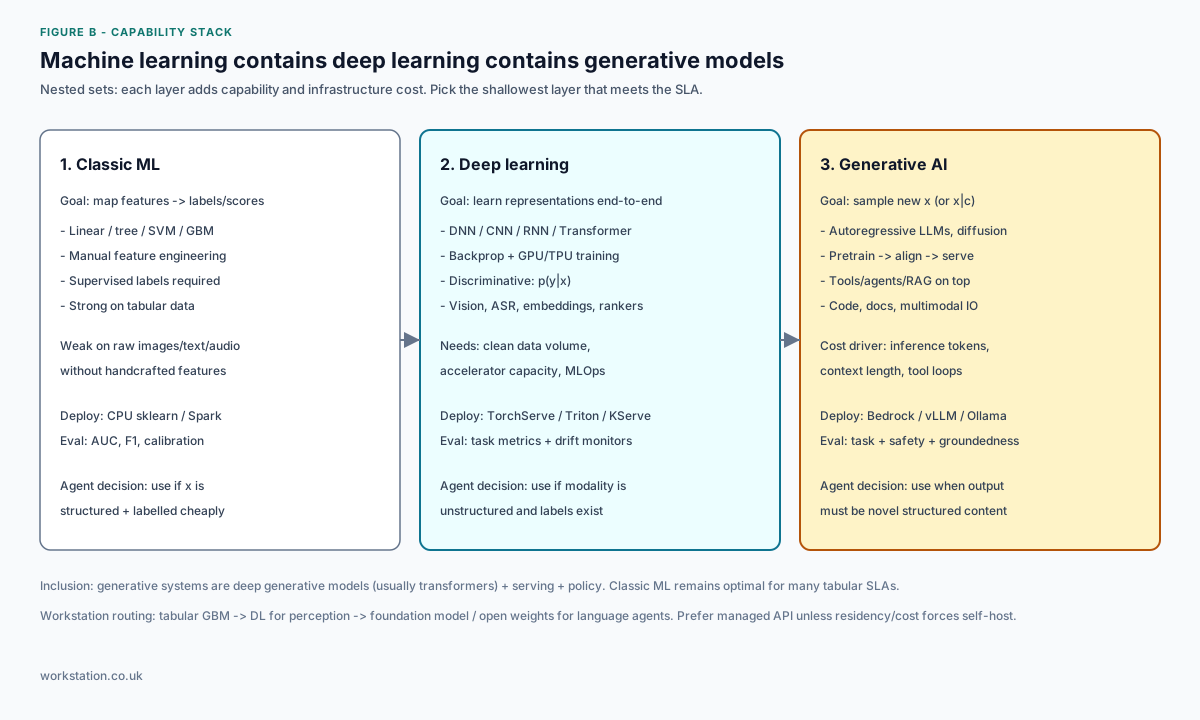
| Capa | Objetivo | Pila típica |
|---|---|---|
| ML clásico | p(y|φ(x)) con φ engineered | GBM / lineal en tablas de warehouse |
| Deep learning | f_θ(x) end-to-end en modalidades crudas | PyTorch + Triton/KServe en nodos GPU |
| IA generativa | muestrear x o x|c; agentes/tools encima | Bedrock Converse o vLLM + RAG |
6.1 Ventajas del DL sobre el ML superficial (cuando aplican)
- Modalidades no estructuradas — embeddings compartidos colapsan la varianza de paráfrasis («pagar» vs «transferir dinero»).
- Descubrimiento de features — los gradientes tallan internos útiles sin listas de features manuales.
- Transfer / fine-tune — reutilizar backbones preentrenados; reducir datos etiquetados vs entrenar from scratch.
- Modelado de secuencias / conjuntos — los transformers manejan dependencias de largo alcance que bag-of-features pierde.
El DL no supera automáticamente un GBM bien ajustado en datos tabulares densos con features fuertes. Elija por modalidad y régimen de datos, no por moda.
7. Modos de fallo y restricciones
- Calidad de datos — el ruido de etiquetas y el distribution shift dominan los presupuestos de error. Versionar datasets; poner en cuarentena outliers antes de que entren al set de entrenamiento.
- Compute — entrenamiento e inferencia large-batch están limitados por el acelerador. GPUs infra dimensionadas producen bucles de varios días y matan la velocidad de iteración.
- Ops — sin gates de eval, monitores de drift, telemetría de coste y rollback (GitOps), los modelos se pudren en producción sin importar los diagramas de arquitectura.
8. Aceleración cloud vs autoalojamiento
La nube acorta el ciclo de experimento: pools GPU/CPU elásticos, notebooks/pipelines gestionados y foundation models como APIs. Bloques de construcción AWS:
- Amazon SageMaker — entrenar, tunear, alojar artefactos DL custom.
- Amazon Bedrock — invocar foundation models con IAM, Guardrails y ZDR opcional.
Autoaloje en Kubernetes cuando pesos abiertos, residencia de datos o economía de tokens favorezcan GPUs propios. Patrón: model registry + KServe/vLLM + sync Argo CD.
9. Checklist de ejecución
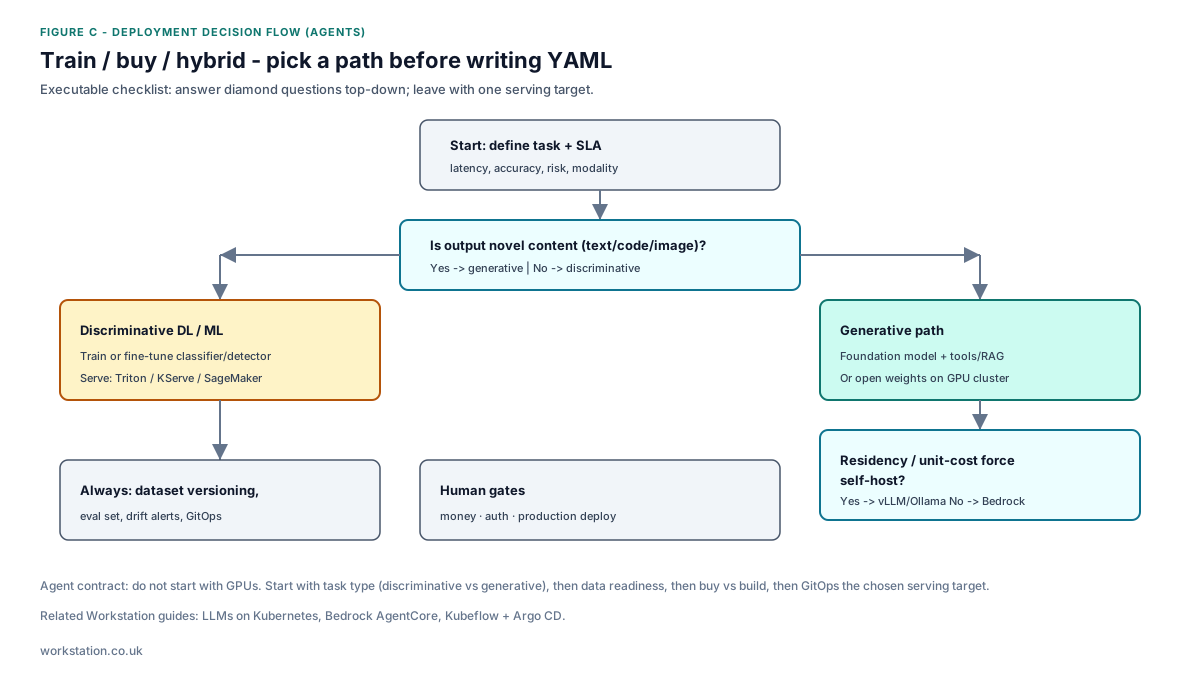
- Escribir la tarea como objetivo medible (métrica + latencia + clase de riesgo).
- Seleccionar la capa de pila de la Figura B; no salte a gen AI para un scorecard tabular.
- Presupuestar prep de datos + OpEx de inferencia; el entrenamiento suele ser minoría del coste de vida.
- Implementar el harness de eval antes del rollout amplio; cablear alertas de drift.
- Siguientes lecturas: serving LLM o agentes Bedrock.
Publicado por Workstation — plataformas de automatización, software multiagente, entrega en Kubernetes.


