
Workstation Resumen técnico: cómo descubrir LLM y cuellos de botella multiagente con OpenTelemetría, Prometheus/Grafana/Thanos y plataformas LLM como Langfuse / LMNR - incluidos esquemas de amplitud, atribución de costos, muestreo y límites de uso estrictos. Compañero: blog de negocios · servir: Turbocompresor LLM · laboratorio: Laboratorio de IA empresarial.
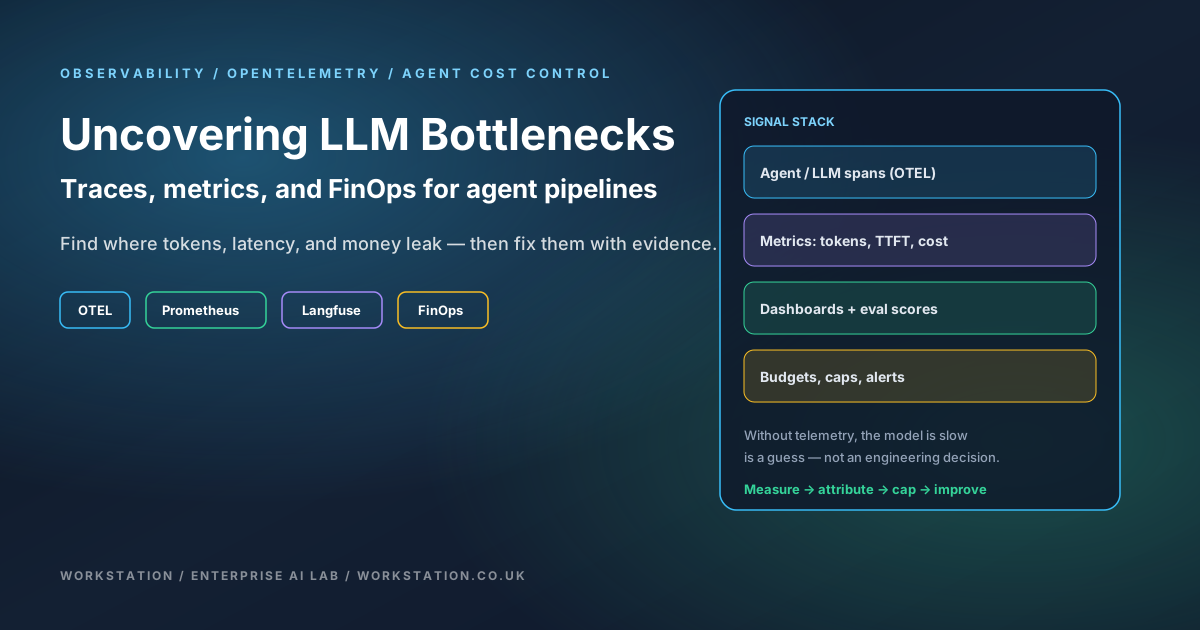
- Problema: El costo y la latencia del agente se esconden en los saltos (LLM → herramientas → RAG → reintentos), no en una única métrica de "el modelo es lento".
- Estándar: Instrumento con OpenTelemetry; un esquema de atributo para tokens, modelo, inquilino, ruta, costo_estimado_usd.
- Ruta de métricas: Prometeo (+ Thanos) para señales doradas; Grafana para tableros SLO y FinOps.
- Ruta LLM: Langfuse/LMNR para seguimientos, puntuaciones, conjuntos de datos y versiones de avisos.
- Control: Limitar tokens, llamadas a herramientas y rondas de depuración; Modelos de ruta por dificultad de paso.
- Ganar: Mida el costo por tarea exitosa antes de comprar más GPU o aumentar las cuotas de API.
1. Qué significa "cuello de botella" para los agentes LLM
Los cuellos de botella en el tiempo de entrenamiento (datos, FLOP) difieren del tiempo de servicio y tiempo-agente cuellos de botella. En los agentes de producción los modos de desperdicio dominantes son:
- hinchazón inmediata - mensajes del sistema de gran tamaño, contexto no reutilizado, falta de prefijos/accesos de caché.
- Modelo excesivo — modelos de frontera utilizados para clasificar/enrutar pasos que un modelo pequeño puede realizar.
- Bucles ilimitados — reintentos de herramientas y ciclos de autodepuración sin un presupuesto estricto (consulte las compensaciones de Self-Debugging en Turbocompresor LLM).
- Esperas externas – Vector DB, SaaS API y puertas de bucle humano atribuidas erróneamente a la “latencia LLM”.
- Al servicio de la fragmentación — Desperdicio de caché de KV en GPU (territorio PagedAttention/vLLM) después de haber confirmado que el gráfico del agente es correcto.
Sin rastros distribuidos no se pueden separar. Por lo tanto, la observabilidad no es un panel agradable de tener: es el plano de control para FinOps y SRE en productos de IA.
2. Arquitectura de referencia
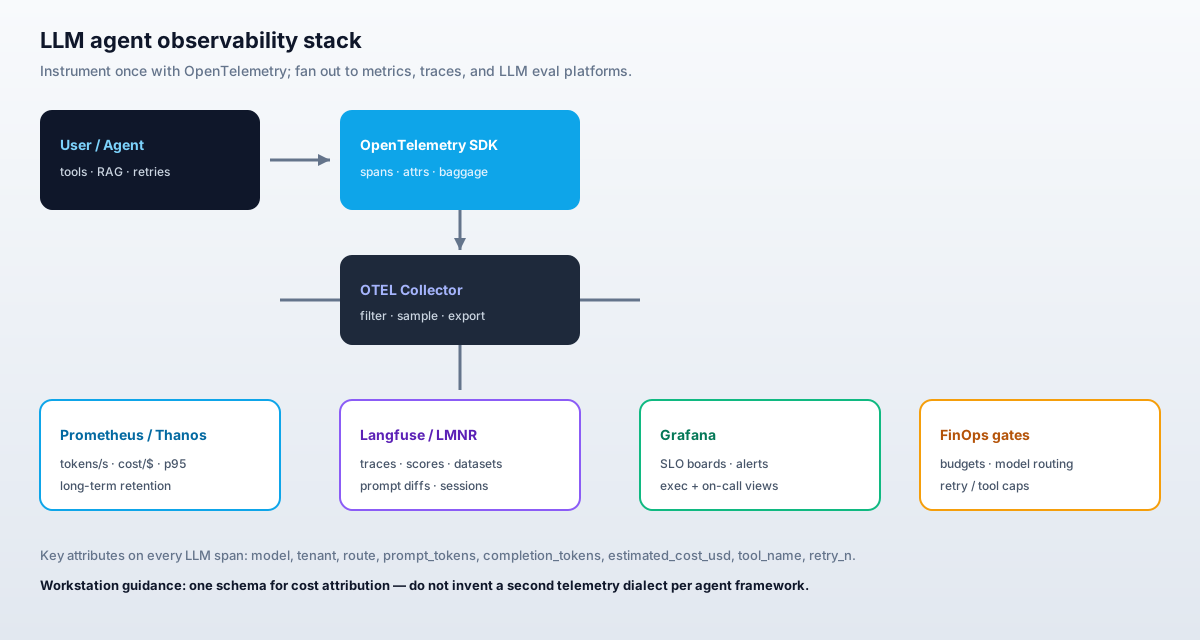
User / Orchestrator
    → Agent runtime (tools, RAG, LLM calls)
        → OpenTelemetry SDK (spans + metrics)
            → OTEL Collector (filter, sample, redact)
                ├─→ Prometheus / Thanos   (rates, costs, SLOs)
                ├─→ Grafana              (boards, alerts)
                └─→ Langfuse / LMNR      (traces, scores, datasets)
FinOps / policy layer reads the same metrics to enforce caps and model routing.
3. Esquema de extensión de OpenTelemetry para llamadas LLM
Adopte una convención en todos los marcos (LangChain, agentes Go/Python personalizados, SDK de Bedrock). Prefiera las convenciones semánticas donde existan y extienda con atributos Workstation estables:
| Atributo | Ejemplo | Por qué |
|---|---|---|
gen_ai.system | openai / antrópico / lecho de roca / vllm | Resúmenes de proveedores |
gen_ai.request.model | claude-soneto-4 / llama-3.1-8b | Costo y calidad por modelo |
gen_ai.usage.input_tokens | 1820 | Generador de costos inmediatos |
gen_ai.usage.output_tokens | 410 | Impulsor del costo de finalización |
wsw.estimated_cost_usd | 0.0124 | FinOps sin unir hojas de precios más tarde |
wsw.tenant_id | acme-prod | Contracargo |
wsw.route | soporte.triage | Atribución de características del producto |
wsw.agent_step | plan / herramienta / crítica | Encuentra pasos costosos |
wsw.retry_n | 2 | Detección de bucle |
wsw.prompt_version | triaje@v17 | Enlace de regresión |
from opentelemetry import trace
from opentelemetry.trace import Status, StatusCode

tracer = trace.get_tracer("workstation.agents")

PRICE_IN = 0.003 / 1000   # example $/token — load from config
PRICE_OUT = 0.015 / 1000

def complete_llm(model: str, prompt: str, tenant: str, route: str):
    with tracer.start_as_current_span("gen_ai.chat") as span:
        span.set_attribute("gen_ai.system", "openai")
        span.set_attribute("gen_ai.request.model", model)
        span.set_attribute("wsw.tenant_id", tenant)
        span.set_attribute("wsw.route", route)
        try:
            resp = client.chat.completions.create(
                model=model,
                messages=[{"role": "user", "content": prompt}],
            )
            usage = resp.usage
            cost = usage.prompt_tokens * PRICE_IN + usage.completion_tokens * PRICE_OUT
            span.set_attribute("gen_ai.usage.input_tokens", usage.prompt_tokens)
            span.set_attribute("gen_ai.usage.output_tokens", usage.completion_tokens)
            span.set_attribute("wsw.estimated_cost_usd", round(cost, 6))
            return resp.choices[0].message.content
        except Exception as e:
            span.record_exception(e)
            span.set_status(Status(StatusCode.ERROR, str(e)))
            raise
Práctica: calcular estimated_cost_usd en el lapso. No espere a que haya un trabajo nocturno para unir los recuentos de tokens a las hojas de precios: los propietarios de productos y de guardia necesitan FinOps en vivo.
3b. Jerarquía y equipaje de múltiples agentes
Los gráficos de agentes necesitan un modelo padre/hijo estable para que los costos se acumulen correctamente:
session (root)
  └─ agent.run {wsw.route, wsw.tenant_id}
       ├─ rag.retrieve {wsw.agent_step=retrieve}
       ├─ gen_ai.chat {wsw.agent_step=plan, model=…}
       ├─ tool.execute {tool=…, wsw.retry_n}
       ├─ gen_ai.chat {wsw.agent_step=synthesize}
       └─ eval.score {score.name, score.value}
- Una raíz por tarea de usuario – no por llamada LLM. Costo de la sesión = suma del niño
wsw.estimated_cost_usd. - equipaje - propagar
wsw.tenant_idywsw.routea través de trabajadores/colas asíncronos para que las herramientas hereden etiquetas de contracargo sin volver a conectar cada sitio de llamada. - Campo de golf — cuando un subagente inicia un nuevo seguimiento (por ejemplo, un consumidor de cola separado), use enlaces de intervalo a la sesión principal para que Langfuse/Grafana aún pueda unir el gráfico.
- Alto costo de muestreo siempre — el muestreo de cabeza al 5-20% está bien para caminos felices; forzar muestra cuando el gasto de la sesión excede un umbral o estado = ERROR.
4. Métricas que importan (Prometheus)
Exporte histogramas y contadores (a través de métricas de OTEL o un cliente de Prometheus). Conjunto mínimo viable:
llm_requests_total{model,route,status}llm_tokens_total{model,direction}donde dirección ∈ {entrada,salida}llm_estimated_cost_usd_total{model,tenant,route}llm_ttft_seconds/llm_e2e_secondshistogramasagent_tool_calls_total{tool,status}agent_retries_total{route}agent_task_success_total{route}— denominador del costo por éxito
Consultas FinOps derivadas (bocetos de PromQL):
# Cost per successful task (last 1h), by route
sum(rate(llm_estimated_cost_usd_total[1h])) by (route)
  /
sum(rate(agent_task_success_total[1h])) by (route)

# Retry tax
sum(rate(agent_retries_total[1h])) by (route)
  /
sum(rate(llm_requests_total[1h])) by (route)
Thanos (o Mimir/Cortex) importa cuando Finanzas solicita el gasto del modelo trimestre tras trimestre. El Prometheus local por sí solo está bien para estar de guardia; no es un archivo FinOps.
5. Tableros y alertas de Grafana
Envíe tres audiencias desde una fuente de datos:
- De guardia: tasa de error, p95 e2e, fallas de dependencia (DB vectorial/herramientas).
- Plataforma: tokens/s, utilidad GPU (si es autohospedado), profundidad de la cola, TTFT.
- FinOps/producto: $/éxito por inquilino y ruta, indicaciones más caras, combinación de modelos.
Alerta sobre el ardor, no sobre la vanidad:
- Costo por éxito > SLO presupuestado para 30 m
- Tasa de reintento > 15% para una ruta
- incumplimiento de p95 e2e con tokens de entrada en aumento (regresión rápida)
6. Plataformas nativas de LLM: Langfuse, LMNR y amigos
Las métricas te lo dicen eso el costo se disparó; Las plataformas LLM te lo dicen cual versión inmediata y qué herramienta abarca lo hizo. Langfuse y LMNR son ejemplos de código abierto de esta clase:
- Seguimientos jerárquicos (sesión → agente → LLM / tramos de herramientas)
- Puntuaciones humanas y de LLM como juez
- Conjuntos de datos para evaluación fuera de línea cuando cambia las indicaciones
- Telemetría de uso opcional para mejora del producto (respetar las políticas de privacidad)
Patrón de integración: mantener a OTEL como sistema de registro de la SRE; Exportación dual o puente hacia Langfuse para una ingeniería rápida. No invente un segundo diccionario de atributos incompatible.
Los experimentos de marcos, como los tiempos de ejecución de agentes de función primero (históricamente comercializados en torno a agentes de transmisión estructurados) pueden reducir el texto estándar, pero tratan los marcos de nicho como opcionales: los estándares de observabilidad los sobreviven.
7. Proceso de puntuación: manual versus automático
| Método | Implementación | Modo de falla |
|---|---|---|
| Manual | Pulgares/rúbricas en la interfaz de usuario de Langfuse; revisiones del conjunto de oro. | No escala; todavía es necesario para la calibración. |
| Automático | LLM-as-juez, verificaciones unitarias, validadores de esquemas, recuperación de recuperación. | Deriva del juez; juego si se optimiza solo para el juez. |
Adjunte partituras como eventos de extensión o partituras Langfuse codificadas por wsw.prompt_version. Obtenga promociones de mensajes de la misma manera que acceda a las versiones de la aplicación: Ring Promoter para el código; puertas de evaluación para indicaciones.
8. Proceso de ahorro de costes (detallado)
- Semana de referencia: ningún cambio de comportamiento; sólo instrumentación. Capture $/éxito, tokens/éxito, tasa de reintentos.
- Atribución: Clasifique las rutas por gasto × volumen. Elige los tres primeros.
- Enrutamiento modelo: dividir, clasificar/extraer en modelos pequeños/locales; mantener la frontera para la síntesis. Vuelva a medir los puntajes de calidad.
- Cirugía inmediata: eliminar esquemas de herramientas no utilizados; acortar algunos tiros; habilite el caché de prefijo donde sea seguro.
- Tapas de bucle: llamadas máximas a herramientas, rondas máximas de autodepuración, retroceso exponencial con disyuntores.
- Muestreo: mantener el 100% de las métricas; seguimientos de muestra (por ejemplo, 5–20 %) más muestreo siempre activo para errores y sesiones de alto costo.
- Redacción: eliminar la PII de los atributos de extensión antes de exportar; almacene indicaciones completas solo en tiendas aprobadas con TTL.
- Cadencia de revisión: tablero semanal de FinOps; Calibración mensual de jueces contra humanos.
8b. Administrar el uso de agentes con presupuestos en vivo
Los paneles de control por sí solos no detienen a los agentes desbocados. Haga cumplir los presupuestos en el tiempo de ejecución, emita la decisión como un evento de intervalo y avise cuando las sesiones lleguen al límite con frecuencia:
# Pseudocode: hard budget around an agent session
class Budget:
    def __init__(self, max_usd=0.50, max_tool_calls=8, max_llm_calls=12):
        self.max_usd, self.max_tool_calls, self.max_llm_calls = max_usd, max_tool_calls, max_llm_calls
        self.spent = 0.0
        self.tools = self.llms = 0

    def charge(self, usd: float, kind: str):
        self.spent += usd
        if kind == "tool":
            self.tools += 1
        else:
            self.llms += 1
        if self.spent > self.max_usd or self.tools > self.max_tool_calls or self.llms > self.max_llm_calls:
            raise RuntimeError("agent budget exhausted")
- Límites por sesión – USD, llamadas LLM, llamadas de herramientas (arriba).
- Cuotas diarias por inquilino — Redis/contador codificado por
wsw.tenant_id; devolver una ruta degradada controlada cuando se agote. - Política de modelo por ruta — modelos de lista permitida para
support.triagevslegal.draft; Rechazar o reducir cambios en políticas fallidas y registrarwsw.policy_action=downshift. - Teclas de herramientas idempotentes – argumentos de la herramienta hash para que los reintentos no facturen dos veces los API externos.
- Fórmula de costo —
cost = in_tokens × p_in + out_tokens × p_out + tool_fees; refrescarp_in/p_outde una hoja de precios versionada para que los datos históricos de Thanos sigan siendo comparables.
Métrica a tener en cuenta después de que lleguen los límites: agent_budget_exhausted_total{route,reason}. Un pico significa abuso, un ciclo de herramientas roto o un presupuesto demasiado ajustado para cargas de trabajo reales.
9. Croquis de configuración del colector
# otel-collector-config.yaml (illustrative)
receivers:
  otlp:
    protocols:
      http:
      grpc:
processors:
  memory_limiter: {}
  batch: {}
  attributes/redact:
    actions:
      - key: gen_ai.prompt
        action: delete
exporters:
  prometheus:
    endpoint: "0.0.0.0:8889"
  otlp/langfuse:
    endpoint: "${LANGFUSE_OTLP_ENDPOINT}"
    headers:
      Authorization: "Bearer ${LANGFUSE_KEY}"
service:
  pipelines:
    traces:
      receivers: [otlp]
      processors: [memory_limiter, attributes/redact, batch]
      exporters: [otlp/langfuse]
    metrics:
      receivers: [otlp]
      processors: [memory_limiter, batch]
      exporters: [prometheus]
10. Pros, contras y cuándo no molestarse
Ventajas: Devolución de cargo, clasificación de incidentes más rápida, retorno de la inversión medible en cambios de modelo/indicador, pistas de auditoría amigables con el cumplimiento, lenguaje compartido entre los equipos de plataforma y aprendizaje automático.
Contras: deuda de instrumentación; costo de almacenamiento si conserva cada mensaje para siempre; riesgo de enviar PII al backend equivocado; Otra consola para que los ingenieros aprendan.
Omita (por ahora) si: Tiene un único trabajo por lotes fuera de línea con un gasto diario fijo y sin agentes interactivos. Aún registra tokens; omita la pila completa de múltiples backend hasta que aparezca la simultaneidad.
11. Lista de verificación de migración
- ☐ OTEL SDK en el tiempo de ejecución del agente; coleccionista en el cluster
- ☐ Los atributos de extensión incluyen modelo, tokens, costo, inquilino y ruta.
- ☐ Métricas de Prometheus + tablero Grafana FinOps
- ☐ Langfuse (o LMNR) cableado para al menos una ruta crítica
- ☐ Límites estrictos en tokens/herramientas/reintentos
- ☐ Política de redacción revisada por seguridad
- ☐ Revisión semanal de $/éxito para las rutas principales
- ☐ Documento ADR que vincula observabilidad → publicación (vLLM) → promoción (Ring Promoter)
12. Material relacionado con Workstation
- Compañero de blog de negocios
- Turbocompresor LLM — arregla la publicación después de que puedas ver el cuello de botella
- Ring Promoter — promover servicios de agentes con puertas de salud
- Muse Glimmer / agentes locales
- Contacto Workstation para compromisos del laboratorio de IA empresarial
Referencias
Publicado por Workstation.


