টার্বোচার্জিং LLMs
PagedAttention, vLLM, Self-Debugging, PowerInfer, এবং EG-MLA — GPU কেভি ক্যাশে নষ্ট না করে কীভাবে LLM এজেন্ট স্কেল করবেন
 Balinder Walia৩০ আগস্ট, ২০২৬3 min read
Workstationকিভাবে উৎপাদনে বড় ভাষার মডেলগুলিকে টার্বোচার্জ করা যায়: PagedAttention, vLLM, Self-Debugging, PowerInfer, এবং EG-MLA — ট্রেড-অফগুলির সাথে যা প্রকৃতপক্ষে GPU-এ প্রদর্শিত হয়৷ গভীর ডুব:দীর্ঘ নিবন্ধ। প্রাইমার:LLMs ব্যাখ্যা করা হয়েছে + Kubernetes।
দেখুন: LLM আসলে
কিকনটেক্সট, প্রোডাক্ট ডেমো নয়:ইন্ট্রো টু লার্জ ল্যাঙ্গুয়েজ মডেল(Andrej Karpathy)। আমাদেরপ্লেইন-ইংরেজি LLM + Kubernetes গাইডএর সাথে পেয়ার করুন।
স্কেলিং সমস্যা
LLMs কথোপকথন AI এবং জেনারেশন আনলক করে, তারপর অবিলম্বে একটি পরিবেশন সমস্যা হয়ে ওঠে। প্রতিটি ডিকোড ধাপ একটি KV ক্যাশে কী এবং মান যুক্ত করে যা ক্রম দৈর্ঘ্য এবং ব্যাচের আকারের সাথে বৃদ্ধি পায়। সাদাসিধা ইঞ্জিনগুলি বিশাল সংলগ্ন স্ল্যাবগুলিকে প্রাক-সংরক্ষিত রাখে। সেই মেমরির বেশিরভাগই নিষ্ক্রিয় থাকে যখন অন্যান্য অনুরোধ অপেক্ষা করে। GPU "পূর্ণ" দেখালেও থ্রুপুট ভেঙে পড়ে।
PagedAttention: মনোযোগের জন্য ভার্চুয়াল মেমরি
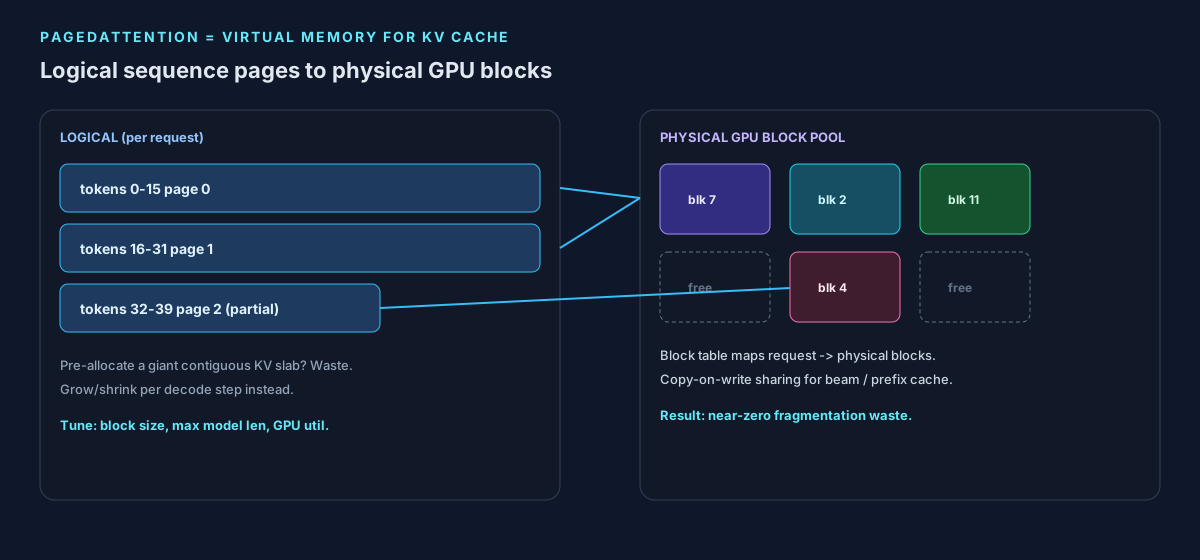
PagedAttention (Kwon et al., SOSP 2023) OS পেজিং-এর মতো KV ক্যাশে ব্যবহার করে: নির্দিষ্ট-আকারের ব্লক, অনুরোধ প্রতি একটি ব্লক টেবিল, অ-সংলগ্ন শারীরিক পৃষ্ঠাগুলি[arXiv:2309.06180]। কার্নেল মনোযোগের সময় ব্লক সংগ্রহ করে। আপনাকে এখনও টিউন করতে হবেব্লক সাইজ,সর্বোচ্চ মডেলের দৈর্ঘ্য, এবংক্যাশে হায়ারার্কি(GPU HBM বনাম CPU অফলোড বনাম প্রিফিক্স ক্যাশে)৷ খুব ছোট ব্লক ওভারহেড ম্যাপিং যোগ করে; খুব বড় ব্লক বর্জ্য পুনঃপ্রবর্তন করে।
vLLM:
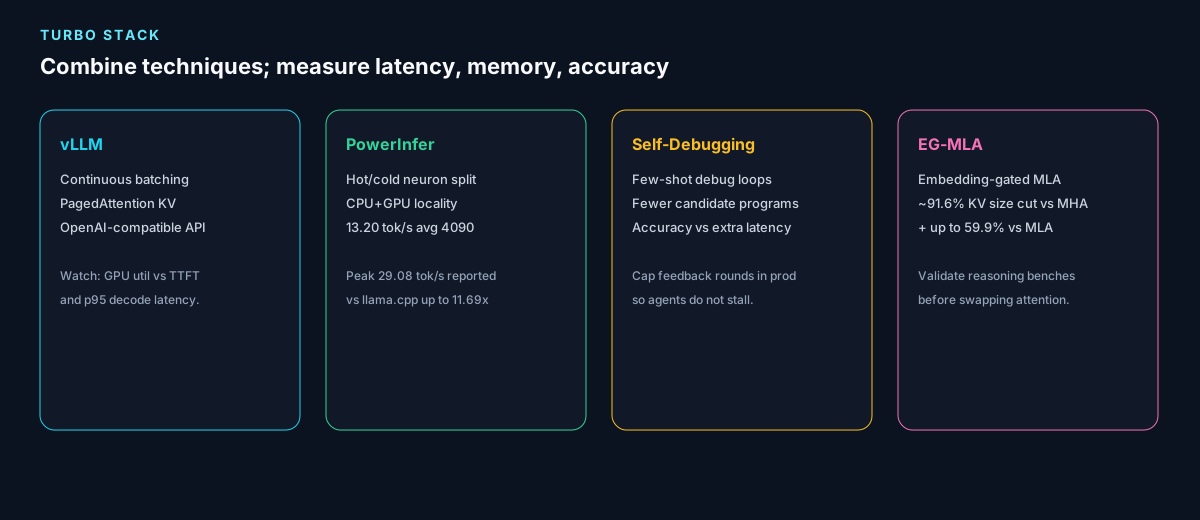
পরিবেশন করা প্রায়-শূন্য বর্জ্য৷vLLM হল PagedAttention-এর চারপাশে তৈরি পরিবেশন ব্যবস্থা। এটি প্রায় শূন্য KV বর্জ্য, ক্রমাগত ব্যাচিং এবং একটি OpenAI-সামঞ্জস্যপূর্ণ HTTP পৃষ্ঠকে লক্ষ্য করে। উৎপাদনে, তিনটি জিনিস দেখুন: (1)gpu_memory_utilizationবনাম OOM, (2) টাইম-টু-ফার্স্ট-টোকেন বনাম ডিকোড টোকেন/s, (3) প্রিফিক্স/প্রম্পট ক্যাশিং আপনার ইভাল সেটের উত্তর পরিবর্তন করে কিনা। ক্যাশিং একটি থ্রুপুট জয়; এটি সঠিকতা এবং টেল-লেটেন্সি প্রভাব থেকে মুক্ত নয়।
from vllm import LLM, SamplingParams

llm = LLM(model="meta-llama/Llama-3.1-8B-Instruct", gpu_memory_utilization=0.90)
params = SamplingParams(temperature=0.2, max_tokens=256)
outs = llm.generate(["Explain PagedAttention in one paragraph."], params)
print(outs[0].outputs[0].text)
এটি বাস্তব vLLM ব্যবহার। একটি আলিঙ্গন ফেস BERTforward()কল হলনয়PagedAttention — পেজড KV পরিবেশনের সাথে ক্লাসিফায়ার লগিটগুলিকে বিভ্রান্ত করবেন না৷
Self-Debugging: লেটেন্সি বাজেট
সহ মানের লুপSelf-Debugging (চেন এট আল।) একটি মডেলকে কয়েকটি শট ট্রেস থেকে তার নিজস্ব ভবিষ্যদ্বাণী করা প্রোগ্রামগুলি ঠিক করতে শেখায়, বেসলাইন মেলানো বা মারধর করে যা 10 গুণ বেশি প্রার্থী[arXiv:2304.05128]। এজেন্টদের জন্য, সেটা হল সোনা — যতক্ষণ না ফিডব্যাক রাউন্ড স্ট্যাক হয়। ডিবাগ বার্তার সংখ্যা ক্যাপ করুন, প্রতিটি রাউন্ডে লগ করুন, এবং বাজেট শেষ হয়ে গেলে একজন মানুষ বা একটি ছোট বিশেষজ্ঞ মডেলের কাছে ব্যর্থ হন।
ঘড়ি: পরিবেশন এবং অনুমান প্রসঙ্গ
দ্রুত LLM পরিবেশনের উপর প্রাসঙ্গিক আলোচনা — একটি অফিসিয়াল Workstation ডেমো নয়। vLLM কাগজ এবংdocs.vllm.aiএর সাথে পেয়ার করুন।
PowerInfer: একটি একক ফ্যাট GPU
-এ টোকেনPowerInfer গরম/ঠান্ডা নিউরনকে বিভক্ত করে যাতে একজন ভোক্তা GPU প্লাস CPU দ্রুত টোকেন তৈরি করতে পারে। রিপোর্ট করা পরিসংখ্যান:13.20 টোকেন/সেকেন্ড গড়, সর্বোচ্চ29.08 টোকেন/সেএক NVIDIA RTX 4090 পর্যন্ত,11.69xবনাম llama.cpp যথার্থতা বজায় রাখার সময়। ফ্লিট স্কেলে আপনার এখনও প্লেসমেন্ট প্রয়োজন: কোন স্তরগুলি GPU-এ থাকে, আপনি কীভাবে নোড জুড়ে শার্ড করেন এবং-এর স্থানীয় প্রোফাইল আপনারপ্রম্পটগুলি কাগজের মডেলগুলির সাথে মেলে কিনা৷
EG-MLA:
বেঞ্চ নষ্ট না করে KV সঙ্কুচিত করুনEG-MLA (এমবেডিং-গেটেড মাল্টি-হেড ল্যাটেন্ট অ্যাটেনশন)91.6% কেভি ক্যাশে হ্রাসবনাম মাল্টি-হেড মনোযোগ নগণ্য অবক্ষয়, অতিরিক্ত সঞ্চয় বনাম এমএলএ (59.9% পর্যন্ত), এবং যুক্তিযুক্ত স্যুটগুলিতে আরও ভাল স্কোর রিপোর্ট করে। এটিকে একটি আর্কিটেকচার পছন্দ হিসাবে বিবেচনা করুন, একটি হিমায়িত vLLM চেকপয়েন্টে ড্রপ-ইন পতাকা নয় - আপনি মেমরি গ্রাফ উদযাপন করার আগে আপনার ইভাল জোতা যাচাই করুন৷
এটিকে একসাথে রাখা
৷ক্লাস্টার পরিবেশনের জন্য PagedAttention + vLLM একত্রিত করুন, যখন বাক্সটি একটি ওয়ার্কস্টেশন GPU হয় তখন PowerInfer, একটি হার্ড রাউন্ড সীমা সহ কোডিং এজেন্টের ভিতরে Self-Debugging এবং আপনি যখন মডেল পরিবার নিয়ন্ত্রণ করেন তখন EG-MLA। বিতরণ করা পরিবেশন জটিলতা যোগ করে: কেভি সমান্তরালতা, প্রিফিল/ডিকোড স্প্লিট, এবং অটোস্কেলিং যা পৃষ্ঠা টেবিলগুলিকে থ্রাশ করে না। পরিমাপ. তারপর ADR লিখুন।
পরবর্তী
পড়ুন- দীর্ঘ নিবন্ধ— knobs, ব্যর্থতার মোড, Kubernetes নোট।
- LLMs ব্যাখ্যা করা হয়েছে + Kubernetes -এ নিজের চালান
- Muse Glimmer / স্থানীয় এজেন্ট·এন্টারপ্রাইজ এআই ল্যাব
Workstationদ্বারা প্রকাশিত।