এটি দীর্ঘ-রূপ গভীর-ডুব। একটি দ্রুত, স্কিম-পঠনযোগ্য সংস্করণের জন্য, দেখুন সহচর ব্লগ পোস্ট.
1. ভূমিকা: কেন স্থানীয় AI এর জন্য একটি Mac Studio?
স্থানীয় এআই এখন আর শখের কৌতূহল নয়। মেটা, মিস্ট্রাল, কুয়েন, এবং মাইক্রোসফ্টের ওপেন-ওয়েট মডেলগুলি দ্রুত পরিপক্ক হচ্ছে এবং Apple Silicon এর ইউনিফাইড মেমরি 128 GB থ্রেশহোল্ড অতিক্রম করছে, আপনি এখন একটি একক ডেস্ক-সাইড মেশিনে সক্ষম বড় ল্যাঙ্গুয়েজ মডেল, এমবেডিং পাইপলাইন এবং সম্পূর্ণ RAG স্ট্যাক চালাতে পারেন - চুপচাপ, XPR 2 এর ক্ষমতার বাজেটের সবচেয়ে কম বাজেটে।
এই নিবন্ধটি একটি আনবক্সিং মাধ্যমে হাঁটা M4 Max চিপ সহ Mac Studio, প্রথম বুট, থেকে আসল অন-ডিভাইস রিডিং mactop, এবং "বক্স আমার ডেস্কে আছে" থেকে "আমি স্থানীয়ভাবে Llama 3 এর সাথে চ্যাট করছি এবং RAG এর সাথে আমার নিজস্ব নথি অনুসন্ধান করছি" পর্যন্ত একটি ব্যবহারিক পথ। এখানে প্রতিটি সুপারিশ আমি আসলে মেশিনে যা পর্যবেক্ষণ করেছি তার উপর ভিত্তি করে। কোন উদ্ভাবিত বেঞ্চমার্ক সংখ্যা নেই, কোন বিপণন ফ্লাফ নেই - শুধু কর্মপ্রবাহ।
আপনি যদি একজন প্রকৌশলী, একজন AI নির্মাতা, একজন SRE, অথবা আপনার দলের হার্ডওয়্যার মিক্সে Mac Studio এর অন্তর্গত কিনা তা সিদ্ধান্ত নেওয়ার জন্য একজন টেক লিড হন, এই নির্দেশিকা আপনার জন্য।

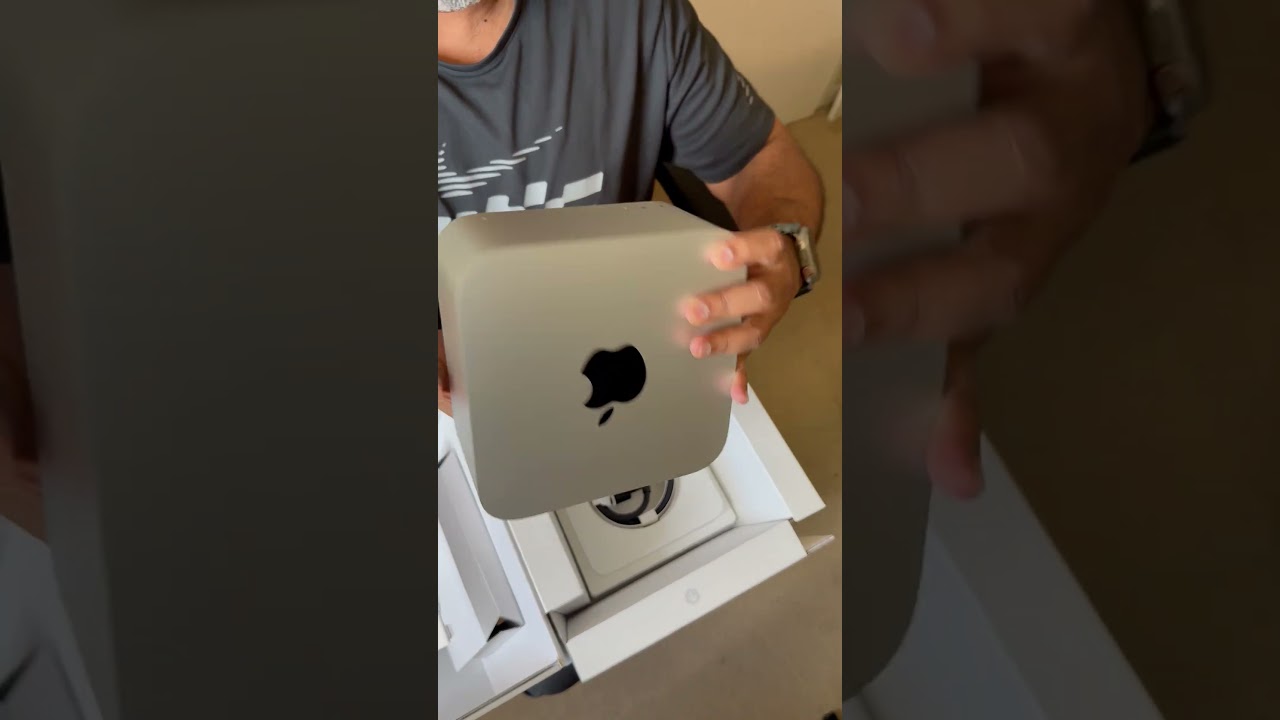
2. Mac Studio M4 Max আনবক্স করা৷
আনবক্সিং অভিজ্ঞতা হল ক্লাসিক অ্যাপল: ন্যূনতম কার্ডবোর্ড, মেশিনটি একটি ছাঁচে তৈরি অবকাশের মধ্যে জড়ানো, একটি ছোট কালো পাওয়ার তার, এবং এটিই। কোন ফোলা আনুষঙ্গিক বান্ডিল. Mac Studio নিজেই একই কমপ্যাক্ট অ্যালুমিনিয়াম-এক্সট্রুশন এনক্লোজার যা আসল M1 আল্ট্রার সাথে চালু করা হয়েছে: মোটামুটি 7.7 ইঞ্চি বর্গক্ষেত্র, হাতে ঘন, নীচের দিকে পরিচিত স্ল্যাটেড ইনটেক এবং পিছনে পোর্টগুলির একটি অ্যারে সহ।
ইউটিউবে আনবক্সিং শর্ট দেখুন: https://youtube.com/shorts/HUlUoHNsyNM
আমি আনবক্সিংয়ের একটি ছোট ক্লিপ শট করেছি - উপরে YouTube শর্ট দেখুন। এই ফরম্যাটের জন্য একটি Short এত ভাল কাজ করার কারণ হল প্রকৃত সেটআপটি সত্যিকারের দ্রুত। প্রথম প্লাগ-ইন, মনিটর ওয়েক-আপ, অ্যাপল আইডি সাইন-ইন, ভাষা এবং অঞ্চল, ফাইলভল্ট, এবং আপনি কয়েক মিনিটের মধ্যে একটি ব্যবহারযোগ্য ডেস্কটপে পৌঁছেছেন।
2.1 প্রথম বুট - প্রকৃত রিডিং থেকে mactop
সিস্টেমের প্রাথমিক সিঙ্ক শেষ করার পরে আমি প্রথম যে কাজটি করেছি তা হল ইনস্টল ম্যাকটপ - একটি চমৎকার ওপেন সোর্স TUI ড্যাশবোর্ড যা রিয়েল টাইমে Apple Silicon এর অভ্যন্তরীণ কাউন্টারগুলিকে দেখায়। 37 মিনিটের আপটাইমে সেই ফ্রেশ-ইনস্টল ড্যাশবোর্ডটি কেমন দেখায় তা এখানে:

/img/mac-studio-mactop-firstboot.png পরে এটি অদলবদল করতে।সেই স্ক্রিনশটের সংখ্যাগুলি হল একমাত্র কঠিন সংখ্যা যা আমি এই নিবন্ধে উদ্ধৃত করব। একটি নতুন সেটআপে নিষ্ক্রিয় থাকা আমার মেশিনের জন্য তারাই আসল সত্য:
- Apple Silicon: M4 Max
- CPU: মোট 16টি কোর - 4টি দক্ষতার কোর + 12টি কর্মক্ষমতা কোর; 1.6 GHz-এ ই-ক্লাস্টার, 0.2 GHz-এ P-ক্লাস্টার; 37 C এ প্যাকেজ
- GPU: 40 কোর 784 MHz, 30 C
- নিউরাল ইঞ্জিন (ANE): 16-কোর, নিষ্ক্রিয় অবস্থায় 0.00 W অঙ্কন
- ইউনিফাইড মেমরি: মোট 128.00 GB, নিষ্ক্রিয় অবস্থায় 16.62 GB ব্যবহার হচ্ছে (প্রায় 13%)
- শক্তি: মোট 6.48 ওয়াট - CPU 0.10 W, GPU 0.02 W, ANE 0 W, DRAM 0.36 W, সিস্টেম 6.01 W. সেশনে পর্যবেক্ষণ করা সর্বোচ্চ ছিল 46.33 W। তাপীয়: নামমাত্র।
- সঞ্চয়স্থান: 2.0 TB Mac HD, 1.9 TB বিনামূল্যে; 53.9 GB OS এবং প্রাথমিক সেটআপ দ্বারা ব্যবহৃত
- নেটওয়ার্ক: Wi-Fi 6, ব্যাকগ্রাউন্ড সিঙ্কের সময় 19.0 KB/s আপলোড এবং 156.8 KB/s ডাউনলোডের নমুনা রিডিং সহ
দুটি জিনিস স্ট্যান্ড আউট. প্রথম, নিষ্ক্রিয় অবস্থায় 6.48 ওয়াট 128 GB ব্যবহারযোগ্য মেমরি সহ একটি ডেস্কটপের জন্য উল্লেখযোগ্য - যা অনেক ল্যাপটপের স্ক্রিন বন্ধ থাকার চেয়ে কম। দ্বিতীয়ত, GPU 784 MHz এ বসে আছে যেখানে 40টি কোর উপলব্ধ; আপনি এটির সামনে একটি LLM রাখার সাথে সাথে সেই পুলটি আসল কাজ করার জন্য প্রস্তুত।
3. কেন Mac Studio M4 Max স্থানীয় AI এর জন্য আশ্চর্যজনক
কেন এই হার্ডওয়্যারটি স্থানীয় AI-এর জন্য এত উপযুক্ত - এবং কেন "ইউনিফায়েড মেমরি" একটি বিপণন লাইনের চেয়ে বেশি - তা বোঝার জন্য এটি সরাসরি ক্যানোনিকাল বিকল্পের সাথে তুলনা করতে সাহায্য করে: একটি পিসিতে একটি বিচ্ছিন্ন GPU কার্ড, PCIe এর উপর সিস্টেম RAM এর সাথে যোগাযোগ করে৷

3.1 সরল ভাষায় ইউনিফাইড মেমরি
একটি ঐতিহ্যগত পিসি এআই রিগে, আপনার দুটি মেমরি পুল আছে। সিস্টেম RAM (সাধারণত DDR5 এর 64-256 GB) OS, অ্যাপ্লিকেশন এবং মডেলের ওজন ধরে রাখে যখন আপনি সেগুলিকে ডিস্ক থেকে লোড করেন। GPU-এর নিজস্ব VRAM রয়েছে - RTX 4090-এ 24 GB, 5090-এ 32 GB, A100-এ 80 GB৷ GPU একটি একক মাটমুল চালানোর আগে, মডেলটি হতে হবে অনুলিপি করা সিস্টেম RAM থেকে VRAM-এ PCIe বাস জুড়ে। যদি মডেলটি VRAM-এর থেকে বড় হয়, তবে এটি হয় একেবারেই লোড হয় না, অথবা এটি PCIe-এর মাধ্যমে নৃশংস খরচে পেজ করা হয় (প্রায়শই VRAM-এ সম্পূর্ণরূপে চলার চেয়ে 10-100x ধীর গতিতে)।
Apple Silicon এই দুটি পুলকে একটিতে ভেঙে দেয়। CPU, GPU, নিউরাল ইঞ্জিন এবং মিডিয়া ইঞ্জিনগুলি সবই দেখতে পায় একই শারীরিক স্মৃতি. কোন কপি নেই. কোন PCIe বাধা নেই. ডিস্কে 40 GB একটি মডেল ইউনিফাইড মেমরিতে 40 GB, এবং GPU এটি সরাসরি পড়তে পারে।
স্থানীয় LLM-এর জন্য, এটি হত্যাকারী বৈশিষ্ট্য। Q4_K_M-এ পরিমাপ করা একটি 70B-প্যারামিটার মডেল ডিস্কে প্রায় 40 GB (সেই কোয়ান্ট স্তরে Llama-শ্রেণীর ওজনের জন্য প্রকাশ্যে উদ্ধৃত চিত্র - আনুমানিক হিসাবে বিবেচনা করুন)। একটি 24 GB ভোক্তা GPU-এ, সেই মডেলটি কেবল মানায় না। 128 GB ইউনিফাইড মেমরিতে, এটি প্রায় 80 GB এর সাথে লোড হয় যা এখনও প্রসঙ্গ, অ্যাপ্লিকেশন কোড এবং সরঞ্জামগুলির জন্য বিনামূল্যে।
3.2 শক্তি দক্ষতা যা বিশ্বাস করা কঠিন
ম্যাকটপ স্ক্রিনশটটি নিষ্ক্রিয় অবস্থায় 6.48 ওয়াট এবং সেশন চলাকালীন সর্বাধিক 46.33 ওয়াট দেখায়। এটিকে পরিপ্রেক্ষিতে রাখার জন্য: একটি একক RTX 4090 15-25 W এ নিষ্ক্রিয় থাকে এবং বাকি সিস্টেমটি উপরে থাকে এবং লোডের নিচে 450 W পর্যন্ত টানে। একটি Mac Studio হল একটি ডেস্ক-সাইড এআই বক্স যা আপনি বিদ্যুৎ বিলের দিকে লক্ষ্য না করেই 24/7 চালিয়ে যেতে পারেন। এটি নীরব। অনুমান কাজের চাপের সময় ভক্তরা প্রায় কখনই ঘোরে না। এটি একটি হিসাবে এটি কার্যকর করে তোলে কি সর্বদা চালু ডেভ বক্স একটি পৃথক GPU পিসি খুব কমই হয়।
3.3 অ্যাপল নিউরাল ইঞ্জিন আসলে কি করে
ANE হল একটি 16-কোর ফিক্সড-ফাংশন অ্যাক্সিলারেটর যা CoreML তৈরি করা টেনসর অপারেশনের জন্য অপ্টিমাইজ করা হয়েছে। 2026 সালে বেশিরভাগ ওপেন-ওয়েট LLM ওয়ার্কলোডের জন্য (GGUF ফর্ম্যাট llama.cpp বা Ollama এর মাধ্যমে চলছে), ANE হট পাথে নেই - GPU হল, মেটাল পারফরম্যান্স শেডার্সের মাধ্যমে। ANE CoreML-রূপান্তরিত মডেল, অন-ডিভাইস স্পিচ রিকগনিশন, ইমেজ সেগমেন্টেশন, এবং অনুরূপ ফিক্সড-শেপ ওয়ার্কলোডের জন্য উজ্জ্বল। এটি চালানোর সময় এটি অত্যন্ত শক্তি-দক্ষ। এটা আছে জানতে দরকারী; প্রতিটি LLM স্ট্যাক এটি ব্যবহার করার আশা করবেন না।
4. AI কাজের জন্য Mac Studio সেট আপ করা
স্ট্যান্ডার্ড macOS অনবোর্ডিং-এর পর, এখানে আমি একটি নতুন Mac Studio-এর জন্য অনুসরণ করি যা আমি স্থানীয় AI ডেভ বক্স হিসেবে ব্যবহার করতে চাই।
4.1 Homebrew, Xcode CLT, এবং মৌলিক বিষয়গুলি ইনস্টল করুন৷
/bin/bash -c "$(curl -fsSL https://raw.githubusercontent.com/Homebrew/install/HEAD/install.sh)"

xcode-select --install

brew install git wget jq python@3.12 node pyenv
brew install --cask iterm2 visual-studio-code
Homebrew আনে ইউনিক্স টুলিং, এক্সকোড কমান্ড লাইন টুল কম্পাইলার এবং লিঙ্কার প্রদান করে, পাইথন এবং নোড আপনাকে অ্যাপ কোডের জন্য একটি রানটাইম দেয় এবং iTerm2 + VS কোড হল সম্পাদক + টার্মিনাল পেয়ার যা আমি ডিফল্ট করি।
4.2 Ollama ইনস্টল করুন
Ollama macOS-এ ওপেন-ওয়েট LLMs ডাউনলোড, চালানো এবং পরিবেশন করার সবচেয়ে সহজ উপায়। ফণা অধীনে এটি মোড়ানো llama.cpp মেটাল ত্বরণ সহ এবং 11434 পোর্টে একটি সাধারণ HTTP API প্রদান করে।
brew install ollama

ollama serve &

ollama --version
আপনি অফিসিয়ালের মাধ্যমেও ইনস্টল করতে পারেন .dmg ollama.com থেকে, যা একটি মেনু-বার অ্যাপ সেট আপ করে। যে কোনো পথ কাজ করে। আমি হেডলেস বক্সের জন্য ব্রু ইন্সটল এবং ডেইলি-ড্রাইভার ম্যাকের জন্য ডিএমজি পছন্দ করি।
4.3 LM স্টুডিও ইনস্টল করুন (ঐচ্ছিক কিন্তু এটি মূল্যবান)
এলএম স্টুডিও GGUF মডেলগুলির সাথে ব্রাউজিং, ডাউনলোড এবং চ্যাট করার জন্য একটি ডেস্কটপ UI৷ এটি একটি OpenAI- সামঞ্জস্যপূর্ণ APIও প্রকাশ করে। আমি এটিকে Ollama এর সাথে ইনস্টল করি কারণ মডেল ব্রাউজারটি চমৎকার এবং আপনি যখন Q4_K_M এবং Q5_K_M এর মধ্যে সিদ্ধান্ত নিচ্ছেন তখন প্রতি-মডেল পারফরম্যান্স টিউনিং UI বন্ধুত্বপূর্ণ।
4.4 VS কোডে Continue.dev ইনস্টল করুন
Continue.dev আপনাকে VS কোডের মধ্যে ChatGPT-স্টাইল সহায়তা দেয়, কিন্তু আপনার স্থানীয় Ollama-এর দিকে নির্দেশ করে। এক্সটেনশন ইনস্টল করার পরে, এটি আপনার ~/.continue/config.json:
{
  "models": [
    {
      "title": "Llama 3.1 8B (local)",
      "provider": "ollama",
      "model": "llama3.1:8b",
      "apiBase": "http://localhost:11434"
    },
    {
      "title": "Qwen 2.5 Coder 14B (local)",
      "provider": "ollama",
      "model": "qwen2.5-coder:14b",
      "apiBase": "http://localhost:11434"
    }
  ],
  "tabAutocompleteModel": {
    "title": "Codestral (local)",
    "provider": "ollama",
    "model": "codestral:latest",
    "apiBase": "http://localhost:11434"
  }
}
এখন আপনার কাছে ইনলাইন চ্যাট, সম্পাদনা এবং স্বয়ংসম্পূর্ণতা রয়েছে - সমস্ত হিটিং মডেল যা আপনার সম্পাদকের মতো একই ডেস্কে থাকে৷ জিরো ডেটা মেশিন ছেড়ে যায়।
5. আপনার প্রথম LLM চালানো

সত্যের মুহুর্তের জন্য সময়। একটি মডেল টানুন এবং এটি চালান।
5.1 টানা Llama 3.1 8B
ollama pull llama3.1:8b

ollama list

ollama run llama3.1:8b "Explain unified memory architecture to me in 3 sentences."
পুল Q4_K_M GGUF ডাউনলোড করে (Q4_K_M এ Llama 3.1 8B ডিস্কে প্রায় 4.7 GB - সর্বজনীনভাবে উদ্ধৃত চিত্র, আনুমানিক হিসাবে বিবেচনা করুন)। আমার মত একটি Wi-Fi 6 সংযোগে, ডাউনলোড করতে কয়েক মিনিট সময় লাগে; তারযুক্ত গিগাবিটে এটি দ্রুত। একবার এটি অবতরণ, প্রথম ollama run ইউনিফাইড মেমরিতে একটি এককালীন মডেল লোড অন্তর্ভুক্ত করে - আপনি প্রথম টোকেন স্ট্রিমগুলির আগে একটি সংক্ষিপ্ত বিরতি লক্ষ্য করবেন - এবং তারপরে পরবর্তী রানগুলি দ্রুত হয়৷
আমি ইচ্ছাকৃতভাবে এখানে আমার নিজস্ব মেশিনের জন্য টোকেন-প্রতি-সেকেন্ড নম্বরগুলি উদ্ধৃত করব না, কারণ আমি একটি জোড়া পদ্ধতি সহ একটি নিয়ন্ত্রিত বেঞ্চমার্ক স্যুট চালাইনি৷ আমি যা বলব তা হল এই শ্রেণীর হার্ডওয়্যারে (40 GPU কোর সহ M4 Max) আপনার আশা করা উচিত মসৃণ, কথোপকথন স্ট্রিমিং Q4_K_M-এ একটি 8B মডেল থেকে, একটি লক্ষণীয় প্রাথমিক লোড বিলম্ব এবং প্রতিক্রিয়া জুড়ে অবিচলিত আউটপুট। আপনি যদি অন্য কোথাও "আমি আমার ম্যাকে প্রতি সেকেন্ডে 60টি টোকেন পাই" এর মতো দাবিগুলি পড়ে থাকেন তবে সেগুলিকে বলপার্ক নির্দেশিকা হিসাবে বিবেচনা করুন; প্রম্পট দৈর্ঘ্য, প্রসঙ্গ উইন্ডো, কোয়ান্টাইজেশন লেভেল, মডেল আর্কিটেকচার এবং আর কি চলছে তার সাথে আপনার প্রকৃত সংখ্যা পরিবর্তিত হবে।
5.2 একটি পরিমাপ নির্বাচন করা - Q4_K_M, Q5_K_M, Q8_0
কোয়ান্টাইজেশন মডেল ওজনের নির্ভুলতা হ্রাস করে যাতে ডিস্কে এবং মেমরিতে সঙ্কুচিত হয়। বাণিজ্য বন্ধ মান. স্থানীয় অনুমানের জন্য একটি পরিমাণ বাছাই করার সময় আমি যে রুক্ষ মানসিক মডেলটি ব্যবহার করি তা এখানে:
| কোয়ান্ট | 8B এর জন্য আনুমানিক আকার | গুণমান বনাম FP16 | কখন ব্যবহার করতে হবে |
|---|---|---|---|
| Q4_K_M | ~4.7 GB | খুব ভাল, ছোট ড্রপ | ডিফল্ট চ্যাট এবং কোডের জন্য সেরা গতি/গুণমানের ব্যালেন্স। |
| Q5_K_M | ~5.7 GB | FP16 এর কাছাকাছি | আপনি একটি স্পর্শ আরো নির্ভুলতা প্রয়োজন এবং অতিরিক্ত মেমরি আছে. |
| প্রশ্ন ৮_০ | ~8.5 GB | কাছাকাছি-ক্ষতিহীন | যখন আপনার ছোট মডেলগুলিতে সর্বাধিক গুণমান এবং সর্বনিম্ন শব্দের প্রয়োজন হয়। |
সমস্ত মাপ আনুমানিক, Llama-শ্রেণীর 8B ওজনের জন্য সর্বজনীনভাবে উদ্ধৃত পরিসংখ্যান। আপেক্ষিক আদেশ কি গুরুত্বপূর্ণ.
5.3 যা 32, 64, এবং 128 GB-এ ফিট করে
| ইউনিফাইড মেমরি | বাস্তবসম্মত আরাম অঞ্চল (Q4_K_M) | প্রসারিত (যত্ন সহ) |
|---|---|---|
| 32 GB | 7B/8B/13B | 20-22B টাইট প্রসঙ্গে |
| 64 GB | 13B/20B/34B | টাইট প্রসঙ্গে 40-50B |
| 128 GB | 34B / 70B / বিশেষজ্ঞদের মিশ্রণের ভেরিয়েন্ট | টাইট প্রসঙ্গে 100-120B |
"কমফোর্ট জোন" মানে মডেলটি একটি উদার কনটেক্সট উইন্ডো, একটি কেভি ক্যাশে এবং অন্যান্য অ্যাপ্লিকেশন চলার জন্য পর্যাপ্ত জায়গা সহ লোড হয়৷ "স্ট্রেচ" এর অর্থ এটি লোড হয় কিন্তু আপনি প্রসঙ্গ দৈর্ঘ্য এবং অন্যান্য কাজের চাপ নিয়ে কাজ শুরু করেন। আমার 128 GB বক্সে আমি Q4_K_M এ একটি 70B চালাতে পারি এবং এখনও VS কোড, ক্রোম এবং কয়েকটি পাইথন প্রসেসের জন্য প্রায় 80 GB হেডরুম আছে - যা সত্যি বলতে, একটি বিলাসবহুল অনুভূতি।
5.4 নোড এবং পাইথন থেকে Ollama কল করা
Ollama এ একটি HTTP API প্রকাশ করে৷ http://localhost:11434. একটি ছোট নোড আনয়ন এই মত দেখায়:
// node 20+
const res = await fetch("http://localhost:11434/api/generate", {
  method: "POST",
  headers: { "Content-Type": "application/json" },
  body: JSON.stringify({
    model: "llama3.1:8b",
    prompt: "Write a one-paragraph summary of unified memory architecture.",
    stream: false
  })
});

const data = await res.json();
console.log(data.response);
এবং পাইথন থেকে:
import requests

r = requests.post(
    "http://localhost:11434/api/generate",
    json={
        "model": "llama3.1:8b",
        "prompt": "Explain HNSW indexes briefly.",
        "stream": False,
    },
    timeout=120,
)
print(r.json()["response"])
একটি CLI টুল, একটি স্ল্যাক বট, একটি শর্টকাট, একটি মাইক্রোসার্ভিস, বা একটি অভ্যন্তরীণ অটোমেশনে একটি স্থানীয় LLM ওয়্যার করার জন্য এটি আপনার প্রয়োজন। কোন কী, কোন হার সীমা, কোন কোটা.
6. Mac Studio চালানোর জন্য সেরা মডেল
একটি মডেল বাছাই অংশ কর্মক্ষমতা, অংশ লাইসেন্স, অংশ vibe. এখানে আমি আসলে বাক্সে কি চালাই, আকারের স্তর অনুসারে গোষ্ঠীবদ্ধ।
6.1 ছোট (10B এর নিচে): দ্রুত দৈনন্দিন কাজের ঘোড়া
- Llama 3.1 8B - চমৎকার সাধারণ-উদ্দেশ্য চ্যাট এবং যুক্তি; সতর্কতা সহ অনুমতিমূলক মেটা লাইসেন্স।
- Mistral 7B / Ministral 8B - শক্তিশালী যুক্তি, Apache-লাইসেন্সযুক্ত বৈকল্পিক উপলব্ধ।
- Qwen 2.5 7B - খুব শক্তিশালী বহুভাষিক এবং কোড কর্মক্ষমতা।
- ফি-3.5 মিনি - ক্ষুদ্র, আশ্চর্যজনকভাবে সক্ষম, আদর্শ যখন আপনার থ্রুপুট এবং কম বিলম্বের প্রয়োজন হয়।
- কোডেস্ট্রাল / কুয়েন 2.5 কোডার 7B - IDE কাজের জন্য দ্রুত ইনলাইন স্বয়ংসম্পূর্ণতা।
6.2 মিড (10B-40B): 64-128 GB-এ মিষ্টি জায়গা
- Llama 3.1 / 3.3 70B (Q4_K_M) - যদি আপনার কাছে 128 GB থাকে তবে এটি শিরোনাম মডেল; কাছাকাছি-সীমান্ত মানের, আরামে চলে।
- Qwen 2.5 32B - চমৎকার মানের থেকে আকার অনুপাত; RAG এর সাথে ভালোভাবে জুড়ুন।
- DeepSeek-Coder 33B - কোড তৈরির কাজে শক্তিশালী।
- মিক্সট্রাল 8x7B - বিশেষজ্ঞদের মিশ্রণ, একবারে শুধুমাত্র 2 জন বিশেষজ্ঞকে সক্রিয় করে, আরামে ফিট করে।
6.3 বড় (70B এবং তার বেশি): শুধুমাত্র 96-128 GB এ এবং শুধুমাত্র Q4 এ
128 GB-এ দরজাটি Q4_K_M-এ 70B-শ্রেণীর মডেলের জন্য খোলা। তারা ধীর 8B মডেলের তুলনায়, কিন্তু মানের লাফ সেই কাজের জন্য গুরুত্বপূর্ণ যা বিস্তৃত বিশ্ব জ্ঞান এবং দীর্ঘতর যুক্তি থেকে উপকৃত হয়। প্রথম-টোকেন লেটেন্সি দীর্ঘ হবে এবং স্ট্রিমিং গতি কমে যাবে বলে আশা করুন, কিন্তু বাস্তব অভিজ্ঞতা অনেক কর্মপ্রবাহের জন্য ব্যবহারযোগ্য থাকে।
7. একটি স্থানীয় RAG পাইপলাইন নির্মাণ
একবার আপনার একটি স্থানীয় LLM হয়ে গেলে, আপনি এটির সাথে সবচেয়ে দরকারী জিনিসটি আপনার নিজের নথিতে নির্দেশ করতে পারেন। এটি হল পুনরুদ্ধার-অগমেন্টেড জেনারেশন, এবং এটি হল সেই কাজের চাপ যেখানে Mac Studio সত্যিই ক্লাউড APIs-এর ব্যক্তিগত বিকল্প হিসাবে উজ্জ্বল।

7.1 স্ট্যাক
- নথি পার্সার - পিডিএফের জন্য PyMuPDF,
unstructuredমিশ্র বিন্যাস ইনজেশন জন্য. - চুনকার - ল্যাংচেইনের
RecursiveCharacterTextSplitterঅথবা একটি টোকেন-সচেতন স্প্লিটার। ওভারল্যাপের 64-128 টোকেন সহ সাধারণ খণ্ড আকার 512-1024 টোকেন। - এমবেডিং -
nomic-embed-textবাmxbai-embed-large, উভয়ই Ollama এর মাধ্যমে উপলব্ধ। উভয়ই স্থানীয় GPU এ চলে। - ভেক্টর স্টোর - ডিফল্টরূপে ChromaDB। একটি শূন্য-সার্ভার বিকল্পের জন্য SQLite-VSS। LanceDB যদি আপনি একটি একক-ফাইল এমবেডেড বিকল্প চান যা স্কেল করে।
- জেনারেটর - দ্রুত পরিবর্তনের জন্য Llama 3.1 8B, অথবা আপনি যদি সর্বোচ্চ মানের উত্তর চান তাহলে 70B।
7.2 ন্যূনতম পাইথন উদাহরণ - শেষ থেকে শেষ
pip install chromadb requests pypdf

import os, glob, requests, chromadb
from chromadb.utils import embedding_functions
from pypdf import PdfReader

OLLAMA = "http://localhost:11434"
EMBED_MODEL = "nomic-embed-text"
GEN_MODEL   = "llama3.1:8b"

def embed(text: str) -> list[float]:
    r = requests.post(f"{OLLAMA}/api/embeddings", json={
        "model": EMBED_MODEL, "prompt": text,
    }, timeout=60)
    return r.json()["embedding"]

def generate(prompt: str) -> str:
    r = requests.post(f"{OLLAMA}/api/generate", json={
        "model": GEN_MODEL, "prompt": prompt, "stream": False,
    }, timeout=300)
    return r.json()["response"]

def chunk(text: str, size: int = 1000, overlap: int = 150):
    out, i = [], 0
    while i < len(text):
        out.append(text[i:i+size])
        i += size - overlap
    return out

client = chromadb.PersistentClient(path="./rag-db")
col = client.get_or_create_collection("docs")

for path in glob.glob("./docs/**/*.pdf", recursive=True):
    reader = PdfReader(path)
    full = "\n".join(p.extract_text() or "" for p in reader.pages)
    for j, c in enumerate(chunk(full)):
        col.add(
            ids=[f"{os.path.basename(path)}::{j}"],
            documents=[c],
            embeddings=[embed(c)],
            metadatas=[{"source": path, "chunk": j}],
        )

def ask(q: str, k: int = 5) -> str:
    qe = embed(q)
    res = col.query(query_embeddings=[qe], n_results=k)
    ctx = "\n\n".join(res["documents"][0])
    prompt = (
        "Answer the question using only the context below. "
        "If the answer is not in the context, say you do not know.\n\n"
        f"Context:\n{ctx}\n\nQuestion: {q}\nAnswer:"
    )
    return generate(prompt)

print(ask("What is unified memory and why does it matter for LLMs?"))
এটি পাইথনের 60টি লাইনের মধ্যে একটি সম্পূর্ণ স্থানীয় RAG পাইপলাইন। পুরো জিনিসটি Mac Studio এ চলে। কোনও বাহ্যিক API কী, কোনও প্রতি-টোকেন বিলিং নেই, কোনও ডেটা মেশিন ছেড়ে যাচ্ছে না। একটি বড় পিডিএফ সেটের প্রথম ইনজেশন কয়েক মিনিট সময় নেবে; পরবর্তী প্রশ্ন দ্রুত হয়.
7.3 টিউনিং নোট
- খণ্ড আকার - 1000টি অক্ষর এবং 150টি ওভারল্যাপ দিয়ে শুরু করুন; যদি আপনার সূত্রে দীর্ঘ কাঠামোগত বিভাগ থাকে (আইনি, প্রযুক্তিগত চশমা) এবং পুনরুদ্ধারকারী উত্তরগুলি খণ্ডিত করে থাকে।
- টপ-ক - 4-8 হল ব্যবহারিক পরিসীমা। অনেক উপরে যাওয়া প্রম্পটকে স্ফীত করে এবং সুস্পষ্ট লাভ ছাড়াই প্রজন্মকে ধীর করে দেয়।
- পুনরায় র্যাঙ্কিং - সর্বোচ্চ মানের জন্য, শীর্ষ-২০ পুনরুদ্ধার করুন এবং একটি ক্রস-এনকোডার দিয়ে পুনরায় র্যাঙ্ক করুন (যেমন
bge-reranker) Mac Studio এ এটি সস্তা। - মেটাডেটা ফিল্টারিং - ট্যাগ খণ্ডগুলিকে তাদের উত্স পথ, তারিখ এবং বিভাগ সহ; ভেক্টর অনুসন্ধানের আগে ক্যোয়ারী সময়ে ফিল্টার করুন। এটি একক সবচেয়ে বড় নির্ভুল জয়।
- স্ট্রিমিং - সুইচ
streamথেকেtrueOllama কলে এবং একটি চটকদার UX-এর জন্য ক্লায়েন্টকে টোকেন স্ট্রিম করুন।
8. প্রতিদিনের বিকাশকারী লুপ
Mac Studio-এ কয়েক সপ্তাহ পরে আমার দৈনিক লুপটি এরকম দেখাচ্ছে:
- VS কোড খুলুন, Continue.dev Ollama এর বিপরীতে জেগে ওঠে।
- আমার নোটের বিরুদ্ধে দীর্ঘ কথোপকথনমূলক প্রশ্নোত্তরের জন্য Open WebUI (বা LM স্টুডিও) এ একটি চ্যাট খুলুন।
- কোড কাজের জন্য: একটি কোডেস্ট্রাল বা কুয়েন কোডার মডেলে ট্যাব-স্বয়ংসম্পূর্ণ, Llama 3.1 8B-তে দীর্ঘ চ্যাট, 70B-তে গভীর যুক্তির সেশন যখন টাস্ক এটির নিশ্চয়তা দেয়।
- অভ্যন্তরীণ RAG এর জন্য, একটি পাইথন স্ক্রিপ্ট যা প্রজেক্টের ডক্স/ফোল্ডার এবং একটি ক্রোমা ডাটাবেসের দিকে নির্দেশ করে।
- এজেন্ট প্রোটোটাইপিংয়ের জন্য, ল্যাংগ্রাফ বা একটি ছোট কাস্টম লুপ যা Ollama এন্ডপয়েন্টকে কল করে - একই প্যাটার্ন, বিভিন্ন আঠালো।
আপনার LLM স্থানীয় হলে যে জিনিসটি সত্যিই পরিবর্তিত হয় তা হল আপনি এটি ব্যবহার করার উপায়। একটি প্রশ্নের জন্য কোন বর্ধিত খরচ নেই, তাই আপনি মডেলটিকে আরও প্রশ্ন জিজ্ঞাসা করুন৷ কোন গোপনীয়তা উদ্বেগ নেই, তাই আপনি প্রোডাকশন লগ, অভ্যন্তরীণ ডক্স, গ্রাহক ইমেল পেস্ট করুন। আপনি ছোট CLI স্ক্রিপ্ট লেখেন যা একটি কাঠামোগত সারাংশ বের করতে 200টি নথির মধ্য দিয়ে যায় এবং আপনি প্রতি-টোকেন বিল সম্পর্কে দুবার চিন্তা করেন না, কারণ সেখানে কোনো বিল নেই।
9. বেঞ্চমার্ক এবং সৎ তুলনা বনাম ক্লাউড
আমাকে খুব সরাসরি বলতে দিন: আমি টোকেন-প্রতি-সেকেন্ড সংখ্যা প্রকাশ করতে যাচ্ছি না যা আমি শক্তভাবে নিয়ন্ত্রিত বেঞ্চমার্ক পদ্ধতিতে তৈরি করিনি। ইন্টারনেট এই ধরনের সংখ্যায় ভরা, প্রায়শই বিভিন্ন পরিমাণের মাত্রা এবং প্রসঙ্গ দৈর্ঘ্য এবং প্রম্পট ফর্ম্যাটের তুলনা করে এবং তারা স্পষ্ট করার চেয়ে বেশি বিভ্রান্ত করে। পরিবর্তে আমি যা করব তা হল একটি সিদ্ধান্তের ম্যাট্রিক্স প্রকাশ করা যা ক্যাপচার করে Mac Studio আসলে কি ধরনের কাজের চাপে জয়ী হয়, যেখানে এটি না, এবং যেখানে সঠিক উত্তর হল "উভয় ব্যবহার করুন"।

9.1 ব্রেক-ইভেন গণিত
128 GB ইউনিফাইড মেমরি সহ একটি Mac Studio M4 Max এবং একটি 2 TB SSD মোটামুটি একই প্রাইস ব্যান্ডে অবতরণ করে যা কয়েক মাসের ক্লাউড GPU দৃষ্টান্তের মতোই। সমস্ত নির্দিষ্ট ডলারের পরিসংখ্যানকে আনুমানিক এবং অঞ্চল এবং ছাড়ের ফাংশন হিসাবে বিবেচনা করুন:
- একটি Mac Studio M4 Max, ভালভাবে কনফিগার করা হয়েছে: মোটামুটি $4,000-$6,000 এককালীন (আনুমানিক; কনফিগারেশন পরিবর্তিত হয়)।
- একটি AWS
g5.xlarge(একক A10G, 24 GB VRAM) 24x7 অন-ডিমান্ড চলছে: প্রতি মাসে $700-$900 (অঞ্চল-নির্ভর)। - একটি AWS
p4d.24xlarge(8x A100): প্রতি মাসে $20,000-$30,000 এর অর্ডার অন-ডিমান্ড যদি আপনি এটিকে কোনোভাবে রেখে দেন (আপনি করবেন না, তবে এটি বৈপরীত্যকে স্পষ্ট করে তোলে)।
পাটিগণিত বলছে যে একটি সর্বদা-অন-অন ডেভ বক্সের জন্য, Mac Studio একটি তুলনীয় সর্বদা-অন-ক্লাউড উদাহরণের বিপরীতে কয়েক মাসের মধ্যে নিজের জন্য অর্থ প্রদান করে এবং বছরের পর বছর বিদ্যুতের শর্তে নিজের জন্য অর্থ প্রদান করে। বিস্ফোরিত প্রশিক্ষণের কাজের জন্য গণিতগুলি উল্টে যায়: এক ঘন্টার জন্য ভাড়া, দৌড়ান, ফিরিয়ে দিন। কাজের জন্য সঠিক টুল ব্যবহার করুন.
9.2 যখন মেঘ সঠিক উত্তর
- 128 GB-এ ফিট হওয়ার চেয়ে বড় একটি মডেল আপনাকে প্রশিক্ষণ দিতে বা সূক্ষ্ম-টিউন করতে হবে।
- আপনাকে কঠোর SLO এবং স্থিতিস্থাপক ক্ষমতা সহ একটি বিশ্বব্যাপী ব্যবহারকারী বেসে স্কেলে পরিবেশন করতে হবে।
- আপনি একটি পরীক্ষা চালাচ্ছেন যা 8x A100 বা H100 সমান্তরালতা থেকে উপকৃত হয়।
- আপনার প্রতিষ্ঠানের কমপ্লায়েন্স ভঙ্গি বলে যে অনুমান অবশ্যই নির্দিষ্ট অডিট ট্রেল সহ একটি নির্দিষ্ট ক্লাউড অঞ্চলে চলতে হবে।
9.3 যখন Mac Studio সঠিক উত্তর
- আপনি আপনার দলের জন্য একটি সর্বদা চালু ব্যক্তিগত অনুমান বাক্স চান.
- আপনি RAG, এজেন্ট বা IDE কপিলট তৈরি করছেন যেখানে ডেটা রেসিডেন্সি এবং গোপনীয়তা গুরুত্বপূর্ণ।
- আপনি একটি শান্ত, কম-পাওয়ার ডেভ বক্স চান যাতে সার্ভার রুম প্রয়োজন হয় না।
- আপনি দ্রুত প্রোটোটাইপ করছেন এবং একটি ক্লাউড API-এর প্রতি-টোকেন বিলিং আপনার পথে।
- আপনি স্ট্যাক শিখতে চান - একটি মডেলের মালিক, একটি রানটাইমের মালিক, একটি ভেক্টর স্টোরের মালিক, লুপের মালিক৷
10. চ্যালেঞ্জ এবং সীমাবদ্ধতা
আমি রুক্ষ প্রান্তের নাম না দিলে আমি এই নিবন্ধটি কোন উপকার করব না। Apple Silicon স্থানীয় AI-এর জন্য চমৎকার, কিন্তু বাস্তব সতর্কতা রয়েছে।
10.1 প্রশিক্ষণ এখনও অনুমানের চেয়ে দুর্বল গল্প
Apple Silicon AI গল্পের জন্য অনেক শক্তিশালী অনুমান জন্য চেয়ে প্রশিক্ষণ. PyTorch এর MPS ব্যাকএন্ড উল্লেখযোগ্যভাবে পরিপক্ক হয়েছে, এবং Apple এর নিজস্ব MLX ফ্রেমওয়ার্ক প্রকৃতপক্ষে ভাল, কিন্তু CUDA-কেবল প্রশিক্ষণ টুলিংয়ের প্রশস্ততা এখনও বিস্তৃত। যদি আপনার দিনের কাজটি হয় অভিনব মডেল আর্কিটেকচার বা বড় আকারের ফাইন-টিউনিং, তাহলে আপনি এমন গর্তগুলিকে আঘাত করবেন যা আপনি লিনাক্স + NVIDIA-এ আঘাত করবেন না।
10.2 ইকোসিস্টেম অনেক জায়গায় CUDA অনুমান করে
অনেক AI রেপো এখনও CUDA অনুমানে ডিফল্ট। বেশিরভাগ রক্ষণাবেক্ষণ করা প্রকল্পগুলিতে এখন মেটাল/এমপিএস পাথ রয়েছে, তবে মাঝে মাঝে ঘর্ষণ আশা করে: একটি লাইব্রেরি যার জন্য উত্স থেকে বিল্ডিং প্রয়োজন, একটি কার্নেল যার কোন মেটাল সমতুল্য নেই, একটি বেঞ্চমার্ক স্যুট যা শুধুমাত্র NVIDIA-এ চলে৷ এর জন্য সময় পরিকল্পনা করুন।
10.3 স্কেলিং আউট হল DIY
একটি Mac Studio হল একটি একক বাক্স৷ টুলের মত EXO এবং অন্যরা আপনাকে একাধিক ডিভাইস জুড়ে খুব বড় মডেলগুলি চালানোর জন্য ক্লাস্টার ম্যাকের অনুমতি দেয়, তবে এটি জি 5 এর কুবারনেটস ক্লাস্টারের সাথে আপনি যে পলিশড গল্প পান তা নয়। আপনার কাজের চাপের যদি অনুভূমিক স্থিতিস্থাপকতার প্রয়োজন হয়, তবে মেঘটি আরও ভাল।
10.4 মেরামতযোগ্যতা এবং আপগ্রেড
আপনি পরে RAM যোগ করতে পারবেন না। আপনি পরে SSD অদলবদল করতে পারবেন না (ব্যবহারিকভাবে বলতে গেলে)। আপনার যা প্রয়োজন তা কিনুন, তারপর প্লাস ওয়ান - বিশেষ করে স্মৃতিতে। 128 GB স্তরটি আমি গুরুতর AI কাজের জন্য সুপারিশ করব; 64 GB হল মেঝে।
10.5 টেকসই লোড অধীনে তাপ
Mac Studio নিষ্ক্রিয় অবস্থায় শীতল এবং শান্তভাবে চলে (উপরের স্ক্রিনশটটি 37 C এবং 30 C অনুরাগীদের অশ্রাব্য সহ দেখায়)। টেকসই ভারী LLM লোডের অধীনে, ফ্যানগুলি ঘুরতে থাকে - জোরে নয়, কিন্তু শ্রবণে - এবং চিপটি উষ্ণ হয়৷ এটি নামমাত্র তাপীয় খামের মধ্যে ভাল; শুধু সচেতন থাকুন যে "নীরব" একটি নিষ্ক্রিয় এবং হালকা-লোড বৈশিষ্ট্য, একটি পরম নয়।
11. Apple Silicon-এ স্থানীয় AI-এর ভবিষ্যৎ
তিনটি প্রবণতা একত্রিত হচ্ছে যা Apple Silicon-এ স্থানীয় AI-এর জন্য পরবর্তী 12-24 মাসকে উত্তেজনাপূর্ণ করে তুলছে।
প্রথম, ওপেন-ওয়েট মডেলগুলি সামর্থ্য হারানো ছাড়াই ছোট হতে থাকে. Phi-3.5, Qwen 2.5 ছোট, এবং Llama 3.x পরিবার তাদের ওজন শ্রেণীর উপরে 8B পাঞ্চে। একটি 2026 8B মডেল অনেক কাজের ক্ষেত্রে 2023 70B এর সাথে গুণমানের দিক থেকে তুলনীয়। তার মানে আরও কাজের চাপ 32-64 GB ইউনিফাইড মেমরিতে আরামদায়কভাবে ফিট করে এবং একটি 128 GB Mac Studio একটি মাল্টি-মডেল সার্ভিং বক্সে পরিণত হয়।
দ্বিতীয়, অ্যাপলের নিজস্ব MLX ফ্রেমওয়ার্কের উন্নতি হচ্ছে. MLX একটি NumPy-এর মতো API, অলস মূল্যায়ন, ডিফল্টরূপে ইউনিফাইড মেমরি সচেতনতা এবং গতিশীল গণনা গ্রাফ প্রদান করে। MLX সম্প্রদায় একটি দ্রুত ক্লিপে মডেল, টোকেনাইজার এবং প্রশিক্ষণ লুপ পোর্ট করছে। আপনি যদি আজ একটি Mac এ একটি নতুন ML প্রকল্প শুরু করেন, তাহলে MLX হল স্বাভাবিক পছন্দ; আপনি যদি PyTorch ব্যবহার করেন, তাহলে MPS ব্যাকএন্ড প্রতিটি রিলিজে বেশি ব্যবহারযোগ্য।
তৃতীয়, কোয়ান্টাইজেশন এবং কেভি-ক্যাশে কম্প্রেশন আরও ভাল হচ্ছে. Q4_K_M, IQ-ফ্যামিলি কোয়ান্টস, এবং GGUF উন্নতির মত কৌশলগুলির মানে হল যে একই মডেল কম মেমরিতে ফিট করে ছয় মাস আগে, কম মানের ক্ষতি সহ। স্থানীয় AI একটি বক্ররেখায় রয়েছে যেখানে প্রতিটি প্রজন্মের মডেল + কোয়ান্ট পেয়ারিং গ্রাহক-মূল্যের হার্ডওয়্যারের ব্যবহারিক নাগালের প্রসারিত করে।
ভবিষ্যতের এম-সিরিজ চিপস (M5, ভবিষ্যতের আল্ট্রাস, স্টুডিও রিফ্রেশ) এর চারপাশে গুজব মিল যোগ করুন এবং গতিপথ পরিষ্কার: ডেস্ক-সাইড এআই বক্স এখানে আছে, এবং এটি আরও ভাল হচ্ছে.
12. একটি টিম এআই বক্স হিসাবে Mac Studio শক্ত করা
আপনি যদি একটি ছোট দলের সাথে আপনার Mac Studio শেয়ার করতে চান - বলুন, Ollama, একটি ওপেন WebUI উদাহরণ, এবং একটি RAG এন্ডপয়েন্ট মুষ্টিমেয় সহকর্মীদের কাছে তুলে ধরুন - এখানে আমি যা করি তা হল:
- FileVault চালু আছে এবং একটি শক্তিশালী লগইন পাসওয়ার্ড। এটি একটি UPS এ রাখুন।
- টেলস্কেল বাক্সে যাতে এটি সর্বজনীন ইন্টারনেটে প্রকাশ না করেই আপনার দলের ডিভাইস থেকে পৌঁছানো যায়।
- Ollama লোকালহোস্টে আবদ্ধ করুন এবং এটিকে একটি পাতলা প্রমাণীকরণ প্রক্সি (ক্যাডি, ট্র্যাফিক, বা একটি ছোট নোড/পাইথন সার্ভার) দিয়ে সামনে রাখুন যা ফরওয়ার্ড করার আগে প্রমাণীকরণ এবং হার সীমিতকরণ পরিচালনা করে
11434. - ডকার ডেস্কটপে ওপেন ওয়েবইউআই চালান একটি অবিরাম ভলিউম সঙ্গে; এটিকে স্থানীয় Ollama এন্ডপয়েন্টে নির্দেশ করুন।
- ব্যাকআপ RAG ডাটাবেসের জন্য একটি এনক্রিপ্ট করা বাহ্যিক SSD বা একটি টাইম মেশিন টার্গেট।
- স্বয়ংক্রিয় আপডেট একটি সময়সূচীতে macOS এবং Homebrew প্যাকেজ; পিন Ollama এবং মডেল সংস্করণগুলি অটো-টানিং লেটেস্টের পরিবর্তে ইচ্ছাকৃতভাবে।
ভাল হয়েছে, আপনার কাছে একটি ব্যক্তিগত, অডিট-বান্ধব এআই এন্ডপয়েন্ট রয়েছে যা আপনার দল প্রতিদিন ব্যবহার করে এবং এটি কখনই বিল্ডিংয়ের নেটওয়ার্ক বন্ধ করে টোকেন পাঠায় না।
13. উপসংহার: ডেস্কে একটি শান্ত বিপ্লব
2026 সালে একটি Mac Studio M4 Max আনবক্স করা একটি ডেস্কটপ কেনার মতো কম এবং একটি ছোট AI অ্যাপ্লায়েন্স কেনার মতো যা ম্যাকও হতে পারে৷ ইউনিফাইড মেমরির 128 GB, 40 GPU কোর, 16 CPU কোর, একটি নিউরাল ইঞ্জিন, হার্ডওয়্যার মিডিয়া এনকোডার, একটি 2 TB SSD, এবং একক ওয়াটে পরিমাপ করা একটি নিষ্ক্রিয় পাওয়ার ড্র - সবই একটি বাক্সে আপনি এক হাতে তুলতে পারেন৷
সেটআপটি দ্রুত, প্রথম LLM এক ঘন্টার মধ্যে চলছে, এবং একটি বিকেলের মধ্যে আপনার কাছে একটি ব্যক্তিগত RAG পাইপলাইন রয়েছে যা আপনার নিজের নথিতে প্রশ্নের উত্তর দেয়। পুরো জিনিসটি আপনার ডেস্কে ঘটে, ব্যাকগ্রাউন্ডে কোনও ক্লাউড বিল টিক আপ না করে। এটি পরিবর্তন করে যে আপনি কীভাবে এআই দিয়ে তৈরি করেন তা এমনভাবে বোঝানো কঠিন যে আপনি এটি চেষ্টা না করা পর্যন্ত।
যদি আপনি মূল্যায়ন করছেন যে আপনার টিমের হার্ডওয়্যার মিশ্রণে একটি Mac Studio আছে কিনা, আমি আশা করি এই নিবন্ধটি আপনাকে একটি গ্রাউন্ডেড ভিউ দিয়েছে: কী আশ্চর্যজনক, কী রুক্ষ, যেখানে মেঘ এখনও জয়ী হয় এবং যেখানে আপনার ডেস্কের বাক্সটি ভাল উত্তর। সঙ্গী ছোট ব্লগ ভাগ করে নেওয়ার জন্য 5-মিনিটের মধ্যে একই ওয়ার্কফ্লো ডিস্টিল করে।
যদি এই দরকারী ছিল - ইউটিউবে আনবক্সিং দেখুন (https://youtube.com/shorts/HUlUoHNsyNM), ফলো-আপ টিউটোরিয়ালের জন্য চ্যানেলে সাবস্ক্রাইব করুন (MLX ফাইন-টিউনিং, মাল্টি-ম্যাক ইনফারেন্স, এজেন্ট স্ট্যাক), এবং সিরিজের পরবর্তী নিবন্ধের জন্য এখানে আবার দেখুন। Apple Silicon-এ স্থানীয় AI সবেমাত্র শুরু হচ্ছে, এবং স্ট্যাক পরিপক্ক হওয়ার সাথে সাথে আমি লিখতে থাকব।
এই নিবন্ধের জন্য এসইও স্ন্যাপশট
- SEO শিরোনাম: আনবক্সিং Mac Studio M4: আপনার প্রথম LLM স্থানীয়ভাবে চালান
- মেটা বর্ণনা: 128 GB ইউনিফাইড মেমরি সহ একটি Mac Studio M4 Max আনবক্স করুন, Ollama ইনস্টল করুন, Llama 3 স্থানীয়ভাবে চালান এবং একটি ব্যক্তিগত RAG পাইপলাইন তৈরি করুন। বাস্তব পড়া, সৎ তুলনা।
- প্রাথমিক কীওয়ার্ড: Mac Studio AI, Mac Studio LLM, Mac Studio-এ LLM চালানো, Ollama Mac Studio, Apple Silicon AI, স্থানীয় AI সেটআপ, Mac Studio RAG, স্থানীয় LLM টিউটোরিয়াল, Llama স্থানীয়ভাবে চালান, Mac Studio M4 পর্যালোচনা।
- Twitter / X (280 অক্ষরের নিচে): একটি Mac Studio M4 Max আনবক্স করা হয়েছে৷ 128 GB ইউনিফাইড মেমরি। 6.48 W এ নিষ্ক্রিয়। Ollama এর মাধ্যমে Llama 3.1 8B টানা, একটি বিকেলে একটি স্থানীয় RAG পাইপলাইন তৈরি করা হয়েছে, ক্লাউড বিল নেই। সম্পূর্ণ 4000-শব্দের ওয়াকথ্রু + 6 ডায়াগ্রাম + YouTube শর্ট। #AppleSilicon #LocalLLM
- লিঙ্কডইন পোস্ট: নতুন Mac Studio M4 Max আমার ডেস্কে অবতরণ করেছে এবং আমি এটিকে একটি AI অ্যাপ্লায়েন্সের মতো ব্যবহার করেছি: ম্যাকটপ থেকে আসল রিডিং (6.48 W নিষ্ক্রিয়, 128 GB UMA, 40 GPU কোর), Ollama ইনস্টল, Llama 3.1 8B স্থানীয়ভাবে চলছে, একটি সম্পূর্ণ RAG পাইপলাইনের বিপরীতে আমার নিজস্ব এক বিকালে। আমি ছয়টি মূল চিত্র, একটি সৎ ক্লাউড-বনাম-স্থানীয় সিদ্ধান্ত ম্যাট্রিক্স এবং যেখানে ক্লাউড এখনও জিতেছে তার একটি বিভাগ সহ সম্পূর্ণ ওয়ার্কফ্লো লিখেছি। আপনি যদি আপনার দলের জন্য স্থানীয় AI মূল্যায়ন করছেন, এটি শুরু করার জন্য একটি গ্রাউন্ডেড জায়গা।