فتح علبة Mac Studio M4 وتشغيل أول LLM
قراءات حقيقية من mactop على تثبيت M4 Max وOllama جديد وLlama 3 محليًا وخط أنابيب RAG خاص في فترة ما بعد الظهر
 Balinder Walia15 مايو 20264 min read

رفيق قصير وقابل للقراءة للغوص العميق الطويل. للحصول على الإرشادات الكاملة، انتقل إلى المقال الطويل.
أصبح الصندوق الموجود على المكتب الآن أحد أجهزة الذكاء الاصطناعي
لقد قمت بفتح علبة Mac Studio جديدة مع شريحة M4 Max، و128 GB من الذاكرة الموحدة، و40 نواة GPU، و16 نواة CPU، وقرص SSD بسعة 2 تيرابايت. وفي فترة ما بعد الظهر، كان يتم تشغيل Llama 3.1 8B محليًا عبر Ollama، مع تضمين المستندات الخاصة بي، والإجابة على الأسئلة المتعلقة بها من خلال خط أنابيب RAG صغير. لا توجد فاتورة سحابية، ولا يوجد مفتاح API، ولا توجد بيانات تغادر الغرفة.
هذه المدونة هي النسخة القصيرة. تتناول المقالة الكاملة نفس سير العمل بعمق.
فتح العلبة في 60 ثانية
شاهد مقطع فتح العلبة القصير على YouTube: https://youtube.com/shorts/HUlUoHNsyNM
فتح علبة Apple الكلاسيكية: الحد الأدنى من الورق المقوى، والجهاز في تجويف مقولب، وكابل طاقة. تبلغ مساحة حاوية Mac Studio حوالي 7.7 بوصة مربعة وكثيفة؛ تشعر بجودة البناء لحظة استلامها. الإعداد سريع حقًا - تم الانتهاء من معرف Apple واللغة وFileVault.
التمهيد الأول - قراءات حقيقية من mactop
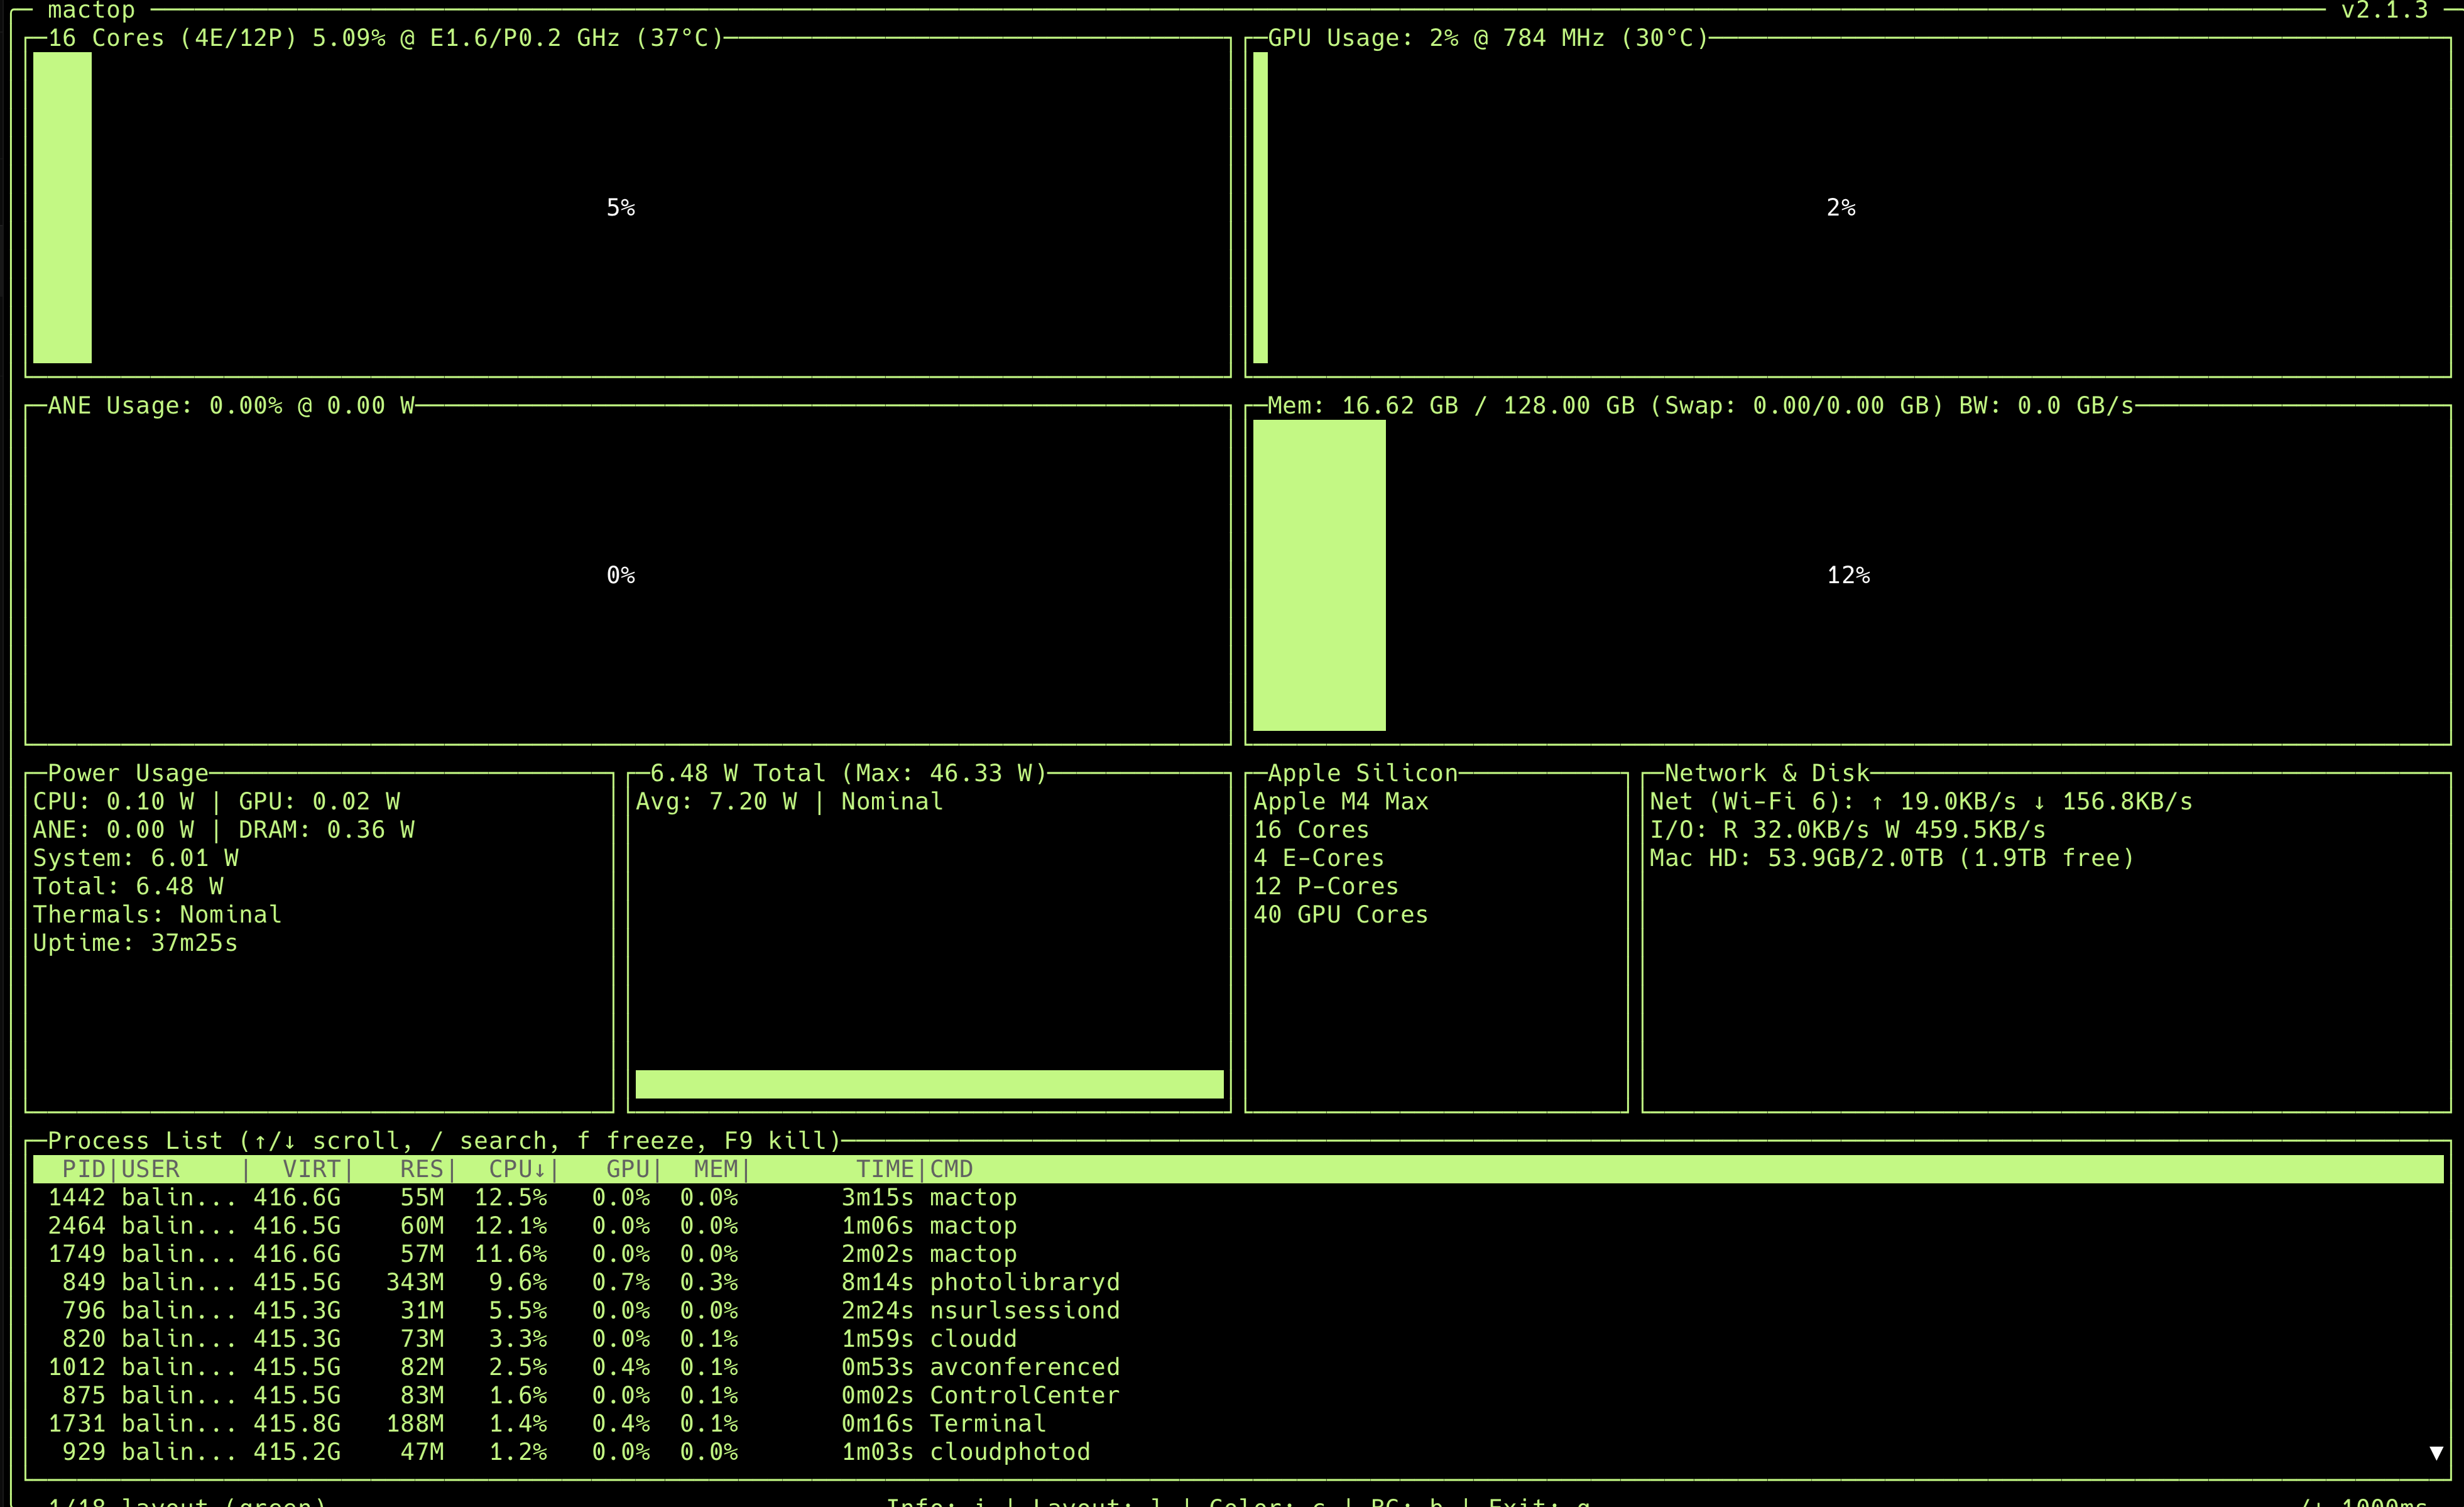
/img/mac-studio-mactop-firstboot.png لتبديلها في وقت لاحق.الأرقام المذكورة أعلاه هي الأرقام الثابتة الوحيدة التي سأذكرها. هم الحقيقة الأرضية من mactop على جهازي في 37 دقيقة من وقت التشغيل:
- M4 Max - 16 نواة (4 E + 12 P)، 40 نواة GPU بتردد 784 ميجا هرتز، 16 نواة ANE.
- 128GB ذاكرة موحدة - 16.62 GB قيد الاستخدام في وضع الخمول (حوالي 13%).
- 6.48 واط إجمالي الطاقة الخاملة، 46.33 واط كحد أقصى. الحرارية: الاسمية.
- 2 تيرابايت اس اس دي، 1.9 تيرابايت مجانًا بعد الإعداد الأولي.
6.48 واط في وضع الخمول لسطح المكتب مع 128 GB من الذاكرة القابلة للاستخدام هو الرقم الرئيسي بالنسبة لي. هذا الصندوق هو حقًا جهاز منخفض الطاقة يعمل دائمًا بالذكاء الاصطناعي ويمكنك تركه يعمل على مدار 24 ساعة طوال أيام الأسبوع دون التفكير في فاتورة الكهرباء.
لماذا يعتبر هذا الجهاز مميزًا - ذاكرة موحدة في فقرة واحدة
على جهاز كمبيوتر تقليدي، يحتوي جهاز CPU على ذاكرة وصول عشوائي (RAM) للنظام، بينما يحتوي جهاز GPU على ذاكرة فيديو منفصلة (VRAM). يجب نسخ النموذج عبر PCIe قبل أن يتمكن GPU من تشغيله؛ إذا كان النموذج أكبر من VRAM، فهو غير مناسب. في Apple Silicon، تتشارك محركات CPU وGPU والمحرك العصبي ومحركات الوسائط واحد 128GB بركة. لا يتم نسخ أي شيء. يتم تحميل معلمة LLM ذات 70B في Q4_K_M (حوالي 40 GB على القرص، تقدير عام) مع ما يقرب من 80 GB لا تزال مجانية للسياق والتطبيقات والأدوات. ولهذا السبب تبدو أجهزة LLM المحلية مختلفة على جهاز Mac.
من الصندوق إلى LLM الأول في ثلاثة أوامر
brew install ollama
ollama serve &
ollama run llama3.1:8b "Explain unified memory in 3 sentences."
هذا هو حقا التحضر كله. يقوم التشغيل الأول بتنزيل النموذج (Llama 3.1 8B Q4_K_M حوالي 4.7 GB على القرص، تقدير عام) ويحمله في ذاكرة موحدة. بعد ذلك، يصبح تدفق المحادثة سلسًا، مع تأخير ملحوظ للرمز الأول وإخراج ثابت من خلال الاستجابة. إنني لا أقوم عمدًا بنشر أرقام الرموز المميزة في الثانية هنا دون اتباع منهجية قياس مناسبة؛ المقالة الطويلة تدخل في المنطق.
RAG المحلي في أقل من 60 سطرًا من لغة Python
الشيء الأكثر فائدة الذي يمكنك القيام به باستخدام LLM المحلي هو توجيهه إلى مستنداتك الخاصة. الحد الأدنى للمكدس القابل للتطبيق هو:
- PyMuPDF أو
unstructuredللتحليل - nomic-embed-text عبر Ollama للتضمين
- ChromaDB لمتجر المتجهات
- إكس بي آر 0 إكس 8 بي عبر Ollama للجيل
الكود الكامل موجود في مقالة طويلة. العنوان الرئيسي هو: كل شيء يعمل على Mac Studio، ولا توجد مفاتيح API خارجية، ولا توجد فواتير لكل رمز، ولا توجد بيانات تخرج من الجهاز.
Mac Studio مقابل السحابة - مصفوفة القرار الصادق
يفوز Mac Studio بما يلي: الاستدلال الخاص الدائم، وRAG على بياناتك الخاصة، ومساعدي IDE، والنماذج الأولية للوكلاء، وتعلم المكدس، والمختبرات المنزلية. تفوز السحابة بما يلي: وظائف التدريب المتواصل، وخدمة الإنتاج التي تزيد عن 70 مليار على نطاق واسع، وحركة المرور العالمية التي لا يمكن التنبؤ بها، وأحمال العمل التي تحتاج إلى توازي 8x A100/H100. سينتهي الأمر بمعظم الفرق باستخدام كليهما. تحتوي المقالة الطويلة على مصفوفة قرار كاملة باعتبارها SVG.
خمسة دروس بعد أسبوع
- الخصوصية تفتح حالات استخدام جديدة. عندما يكون النموذج محليًا، أقوم بلصق سجلات الإنتاج والمستندات الداخلية ورسائل البريد الإلكتروني للعملاء دون تردد. وهذا يغير طريقة عملي.
- التكلفة لكل استعلام هي تكلفة نفسية ومالية. عدم وجود فاتورة يعني المزيد من الاستفسارات، والمزيد من التجارب، والمزيد من الفضول.
- 128 GB هو المكان المناسب. 64 GB هو الأرضية المناسبة للعمل الجاد. يمنحك 128 GB مساحة رأسية لتشغيل 70B في Q4_K_M ولا يزال لديك مساحة لكل شيء آخر.
- Ollama هو الطريق المنحدر السهل. يعد LM Studio رائعًا كمتصفح نموذجي، ويعتبر MLX رائعًا إذا كنت قد بدأت حديثًا في لغة Python، ويدعم llama.cpp كل ذلك.
- السحابة ليست ميتة. فهي لا تزال الأداة المناسبة للتدريب والعرض الموسع وأحمال العمل غير المعروفة.
ما هو التالي
ستغطي المقالات المستقبلية ضبط MLX الدقيق على Apple Silicon، ومجموعات استدلال أجهزة Mac المتعددة مع EXO، ومكدسات الوكيل (LangGraph + Ollama)، وقطعة منهجية أعمق لقياس الأداء. إذا كنت تريد النسخة الطويلة التي تحتوي على جميع المخططات والتعليمات البرمجية ومصفوفة القرار، فاقرأ المقال الطويل. إذا كنت تريد النسخة المرئية، شاهد يوتيوب قصير. وفي كلتا الحالتين - اشترك في بقية السلسلة.