المتجر متاح الآن

نبني أجهزة Workstation AI للمواقع ووكلاء الذكاء الاصطناعي وتدريب LLM — اضبطوها واشتروها عبر الإنترنت.

احصل على أسعار التجار
منتجات الذكاء الاصطناعي
مختبرات الذكاء الاصطناعيوكلاء OpenAIوكلاء ClaudeGrok Botنظام CRM الأصلي من Workstation AIالتسويقجميع المنتجات
حلول الذكاء الاصطناعي
الذكاء الاصطناعي التطبيقيوكلاء الذكاء الاصطناعيالذكاء الاصطناعي التوليديأتمتة بالذكاء الاصطناعيرفع مهارات الذكاء الاصطناعيحزم الذكاء الاصطناعي للمنشآت الصغيرة والمتوسطةمختبر الذكاء الاصطناعي للمؤسساتمحطات عمل الذكاء الاصطناعيعتاد وبرمجيات NVIDIAالحوسبة المسرّعة من NVIDIAالذكاء الاصطناعي الخاصسحابة GPU خاصةعناقيد GPUالذكاء الاصطناعي الطرفيالذكاء الاصطناعي حسب القطاع
خدمات الذكاء الاصطناعي
تحديث المنصاتالهندسة الرقميةأسس البيانات والذكاء الاصطناعيعمليات مستقلةاستشارات الذكاء الاصطناعيأتمتة DevOpsالأمن السيبرانيتطوير البرمجياتبناء الوكلاءإعداد MLOpsتأجير وحدات GPUسحابة GPU خاصة
من نحن
الشركةقصتناالشركاءقصص العملاء
مراكز بيانات الذكاء الاصطناعي
مراكز بيانات الذكاء الاصطناعيسحابة GPU خاصةعناقيد GPUتأجير وحدات GPU
رؤى الذكاء الاصطناعيسلسلة Jevمختبر المعاييراختيار النماذج
ملاحظات تقنية
التوثيق
نظام LinuxUbuntuRed Hat Enterprise LinuxSUSE LinuxAlpine LinuxDebian, Rocky & AlmaLinux
منصات الذكاء الاصطناعي السحابيةAWS & Amazon BedrockGoogle Cloud & Vertex AIMicrosoft Azure & AI Foundryسحابات وأسواق وحدات GPU
مراكز بيانات الذكاء الاصطناعي الخاصةلمكاتب المحاماةلشركات المحاسبةالمنصات المحليةسحابة مؤمنة بالكامل
الأدواتRing PromoterJobshout
الأخبار
المدونة
اتصل بناتسجيل الدخول

محطات عمل الذكاء الاصطناعي وبرمجيات الوكلاء المتعددة والبنية التحتية لوحدات GPU وحلول الوكلاء الأذكياء للشركات الحديثة.

اتصل بنا

حلول الذكاء الاصطناعي

الذكاء الاصطناعي التطبيقيوكلاء الذكاء الاصطناعيالذكاء الاصطناعي التوليديأتمتة بالذكاء الاصطناعيرفع مهارات الذكاء الاصطناعيحزم الذكاء الاصطناعي للمنشآت الصغيرة والمتوسطةمختبر الذكاء الاصطناعي للمؤسساتالذكاء الاصطناعي حسب القطاع

المنتجات

جميع المنتجاتWorkstation AI native CRM و ERPالتسويقوكلاء OpenAIRing PromoterJobshout

الشركة

من نحنالشركةمراكز بيانات الذكاء الاصطناعيلماذا Workstationالشركاءقصص العملاءالأسعاراتصلTenthMatrix

الموارد

رؤى الذكاء الاصطناعيملاحظات تقنيةالتوثيقنظام Linuxمنصات الذكاء الاصطناعي السحابيةمراكز بيانات الذكاء الاصطناعي الخاصةالمدونةبحثخريطة الموقع
المقر الرئيسي في المملكة المتحدة
77-79 Marlowes, Hemel Hempstead HP1 1LFالاتجاهات - اسلك المخرج 20 من الطريق M25 في لندن الخارجيةرقم الشركة: 11641870الاثنين - الجمعة: 9:00 ص - 6:00 م بتوقيت GMT
+44 7515 356 146
مكتب بلجيكا
Workstation SRL, Rue Vanderkindere 34, 1180 Uccle, BrusselsBE 0751.518.683الاثنين - الجمعة: 9:00 ص - 6:00 م بتوقيت CET
+32 492 45 67 46
مكتب الهند
#159 Sector 9, Pocket 1, DDA Flats, 110077 Dwarka, New Delhi
+91 98881 98841
مكتب تايوان
3F, No. 2-4, Aisi Rd., Ren'ai Dist., Keelung City 200, Taiwan基隆市仁愛區愛四路2之4號3樓الاثنين - الجمعة: 9:00 ص - 6:00 م بتوقيت تايوان (GMT+8)
+886 926 892 701

© 2026 Workstation AI. جميع الحقوق محفوظة.

الخصوصيةحذف البياناتملفات تعريف الارتباطشروط الخدمةخريطة الموقع الإلكتروني

NVIDIA, the NVIDIA logo, RTX, RTX PRO, Blackwell, CUDA, NVLink, MGX, Omniverse, Spectrum-X, Quantum, BlueField, DGX and HGX are trademarks and/or registered trademarks of NVIDIA Corporation in the US and other countries. AMD, the AMD Arrow logo, EPYC, Instinct, Ryzen and Threadripper are trademarks of Advanced Micro Devices, Inc. Dell and PowerEdge are trademarks of Dell Inc. or its subsidiaries. Intel and Xeon are trademarks of Intel Corporation or its subsidiaries. AMAX, AceleMax and LiquidMax are trademarks of AMAX Engineering Corporation. All other product names, logos and brands are the property of their respective owners. We use them only to identify the products we describe, supply or support; their use does not mean their owners endorse us.

Loading blog...

الرئيسية / المدونات
AILLMMachine LearningGPUMLOpsPerformanceKubernetes

الشحن التوربيني LLMs

PagedAttention، وvLLM، وSelf-Debugging، وPowerInfer، وEG-MLA - كيفية توسيع نطاق عوامل LLM دون إهدار ذاكرة التخزين المؤقت لـ GPU KV

Balinder Walia30 أغسطس 20264 min read
Turbocharging LLMs with PagedAttention, vLLM, PowerInfer and EG-MLA

Workstationحول كيفية تعزيز نماذج اللغات الكبيرة في الإنتاج: PagedAttention، وvLLM، وSelf-Debugging، وPowerInfer، وEG-MLA - مع المقايضات التي تظهر بالفعل على GPUs. الغوص العميق: مقال طويل. التمهيدي: شرحLLMs + Kubernetes.
Turbocharging LLMs cover

خلاصة القول. تموت إنتاجيةعند تجزئة ذاكرة التخزين المؤقت KV. قم بصفحة ذاكرة التخزين المؤقت مثل نظام التشغيل (PagedAttention داخل vLLM)، واختر محرك الرمز المميز الذي يطابق الصندوق (PowerInfer على مستهلك سمين GPU، وvLLM على مجموعة تقديم)، وتقليص الانتباه عندما تسمح البنية (EG-MLA)، وحلقات تصحيح أخطاء عامل الحد الأقصى بحيث لا تشتري الجودة زمن انتقال غير محدود.
شاهد

: ما هو LLM في الواقع

سياق

، وليس عرضًا توضيحيًا للمنتج:مقدمة لنماذج اللغات الكبيرة(أندريه كارباثي). قم بالاقتران مع دليلLLM + Kubernetes باللغة الإنجليزية العادية.

مشكلة القياس

فتح

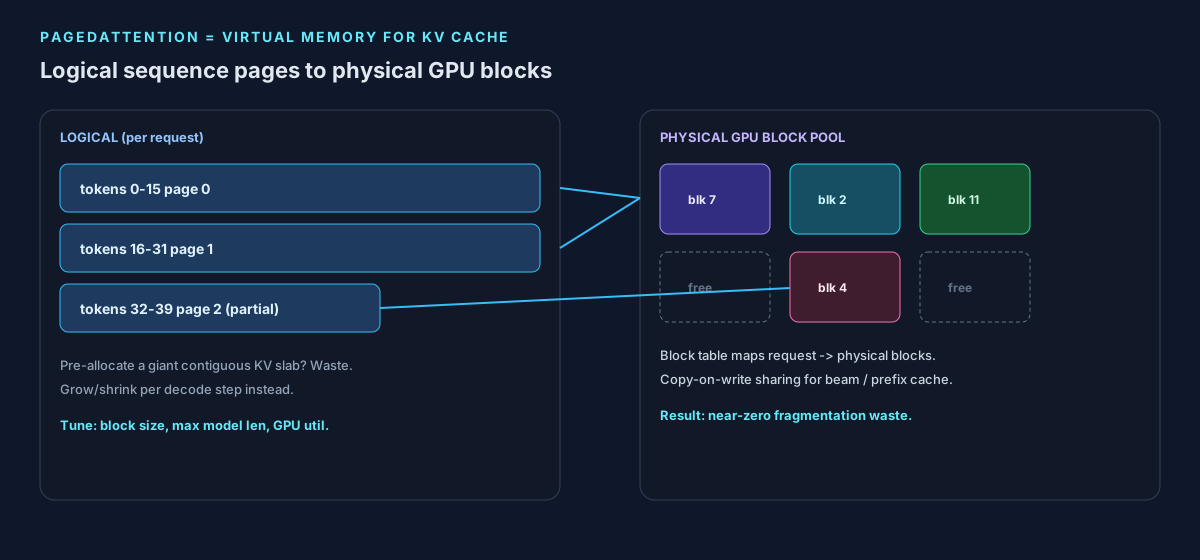
LLMs الذكاء الاصطناعي للمحادثة والجيل، ثم أصبح على الفور مشكلة في الخدمة. تقوم كل خطوة فك تشفير بإلحاق المفاتيح والقيم بذاكرة التخزين المؤقت KV التي تنمو مع طول التسلسل وحجم الدُفعة. تقوم المحركات الساذجة بحجز ألواح ضخمة متجاورة مسبقًا. معظم تلك الذاكرة تظل خاملة بينما تنتظر الطلبات الأخرى. ينهار معدل النقل على الرغم من أن GPU يبدو "ممتلئًا".

PagedAttention: الذاكرة الافتراضية للانتباه
PagedAttention maps logical token pages to physical GPU KV blocks

يتعامل

PagedAttention (Kwon et al., SOSP 2023) مع ذاكرة التخزين المؤقت KV مثل ترحيل صفحات نظام التشغيل: كتل ذات حجم ثابت، وجدول كتلة لكل طلب، وصفحات فعلية غير متجاورة[arXiv:2309.06180]. تقوم النواة بتجميع الكتل في وقت الانتباه. لا يزال يتعين عليك ضبط حجم كتلةوالحد الأقصى لطول الطرازوالتسلسل الهرمي لذاكرة التخزين المؤقت(إلغاء التحميل GPU HBM مقابل CPU مقابل ذاكرة التخزين المؤقت للبادئة). تضيف الكتل الصغيرة جدًا رسم الخرائط في الأعلى؛ الكتل الكبيرة جدًا تعيد إنتاج النفايات.

vLLM: نفايات قريبة من الصفر تخدم

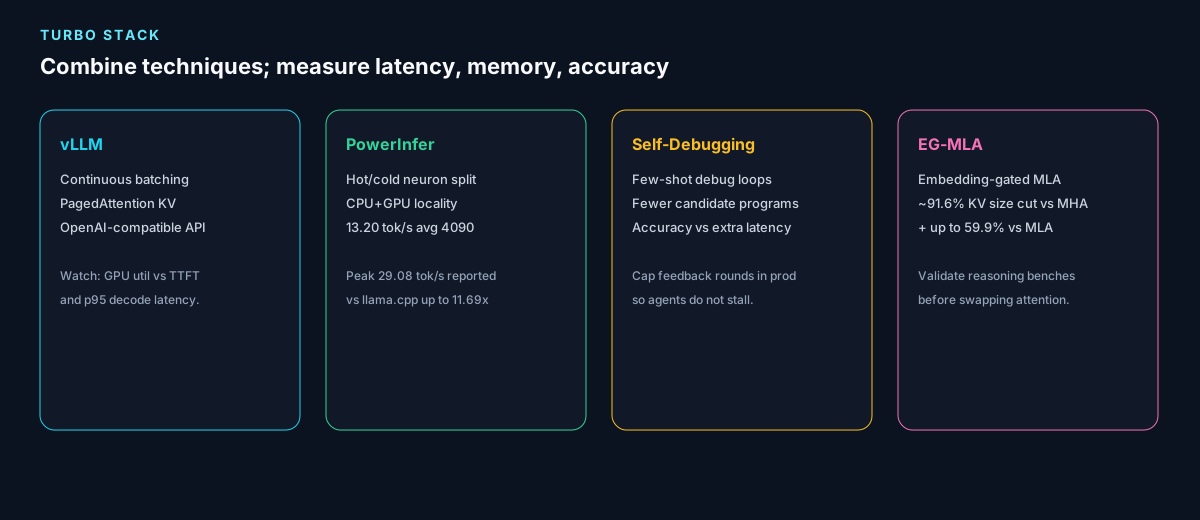
vLLM هو نظام التقديم المبني على PagedAttention. إنه يستهدف نفايات كيلو فولت قريبة من الصفر، والخلط المستمر، وسطح HTTP المتوافق مع OpenAI. في الإنتاج، شاهد ثلاثة أشياء: (1)gpu_memory_utilizationمقابل OOM، (2) وقت ظهور الرمز المميز الأول مقابل الرموز/الرموز المميزة لفك التشفير، (3) ما إذا كان التخزين المؤقت للبادئة/المطالبة يغير الإجابات لمجموعة التقييم الخاصة بك. يعد التخزين المؤقت بمثابة فوز في الإنتاجية؛ فهو لا يخلو من آثار الصواب والكمون الخلفي.

from vllm import LLM, SamplingParams

llm = LLM(model="meta-llama/Llama-3.1-8B-Instruct", gpu_memory_utilization=0.90)
params = SamplingParams(temperature=0.2, max_tokens=256)
outs = llm.generate(["Explain PagedAttention in one paragraph."], params)
print(outs[0].outputs[0].text)

هذا هو الاستخدام الحقيقي لـ vLLM. مكالمة Hugging Face BERTforward()هيوليستPagedAttention - لا تخلط بين سجلات المصنف وخدمة KV المقسمة إلى صفحات.

Self-Debugging: حلقات الجودة بميزانية زمن الوصول

يقوم

Self-Debugging (تشن وآخرون) بتعليم نموذج لإصلاح البرامج المتوقعة الخاصة به من آثار قليلة الطلقات، أو مطابقة أو التغلب على خطوط الأساس التي تنبعث منها مرشحات أكثر بعشر مرات[arXiv:2304.05128]. بالنسبة للوكلاء، هذا هو الذهب - حتى تتراكم جولات ردود الفعل. قم بتحديد عدد رسائل التصحيح، وقم بتسجيل كل جولة، ثم فشل في الإغلاق أمام نموذج بشري أو متخصص أصغر عند انتهاء الميزانية.

ساعة

: سياق التقديم والاستدلال

حديث سياقي عن خدمة LLM السريعة - وليس عرضًا توضيحيًا رسميًا لـ Workstation. قم بالاقتران مع ورق vLLM وdocs.vllm.ai.

PowerInfer: الرموز المميزة على دهون واحدة GPU

يقوم

PowerInfer بتقسيم الخلايا العصبية الساخنة/الباردة حتى يتمكن المستهلك GPU بالإضافة إلى CPU من إنشاء الرموز المميزة بسرعة. الأرقام المبلغ عنها:13.20 رمزًا/ثانية متوسط ​​، ذروة29.08 رمزًا/ثانيةعلى NVIDIA RTX 4090 واحد، حتى11.69xمقابل llama.cpp مع الحفاظ على الدقة[PowerInfer]. على نطاق الأسطول، لا تزال بحاجة إلى التنسيب: ما هي الطبقات التي تبقى على GPU، وكيفية تقسيمها عبر العقد، وما إذا كان ملف تعريف المنطقةالذي يطالبك بهيتطابق مع نماذج الورقة.

EG-MLA: تقليص KV دون تدمير المقعد

يُبلغ

(الانتباه الكامن متعدد الرؤوس المضمن) عنتقليل ذاكرة التخزين المؤقت بنسبة تزيد عن 91.6% كيلو فولت،مقابل الانتباه متعدد الرؤوس مع تدهور لا يُذكر، وتوفير إضافي مقابل MLA (يصل إلى 59.9%)، ونتائج أفضل في مجموعات الاستدلال، تتجاوز معلمات 1B[ورقة EG-MLA]. تعامل معه كخيار معماري، وليس علامة منسدلة على نقطة تفتيش vLLM المجمدة - تحقق من صحة أداة التقييم الخاصة بك قبل الاحتفال بالرسم البياني للذاكرة.
vLLM, PowerInfer, Self-Debugging and EG-MLA stack

تجميعها معًا

اجمع بين PagedAttention + vLLM لخدمة المجموعة، وPowerInfer عندما يكون الصندوق عبارة عن محطة عمل GPU، وSelf-Debugging داخل عوامل الترميز ذات الحد الدائري الصلب، وEG-MLA عندما تتحكم في عائلة الطراز. يضيف العرض الموزع التعقيد: توازي KV، وتقسيم التعبئة المسبقة/فك التشفير، والقياس التلقائي الذي لا يؤدي إلى جداول الصفحات. يقيس. ثم اكتب ADR.

اقرأ

التالي
  1. مقالة طويلة— المقابض، أوضاع الفشل، ملاحظات Kubernetes.
  2. شرح
  3. LLMs + تشغيل الخاص بك على Kubernetes
  4. Muse Glimmer / الوكلاء المحليون·Enterprise AI Lab

تم النشر بواسطةWorkstation.