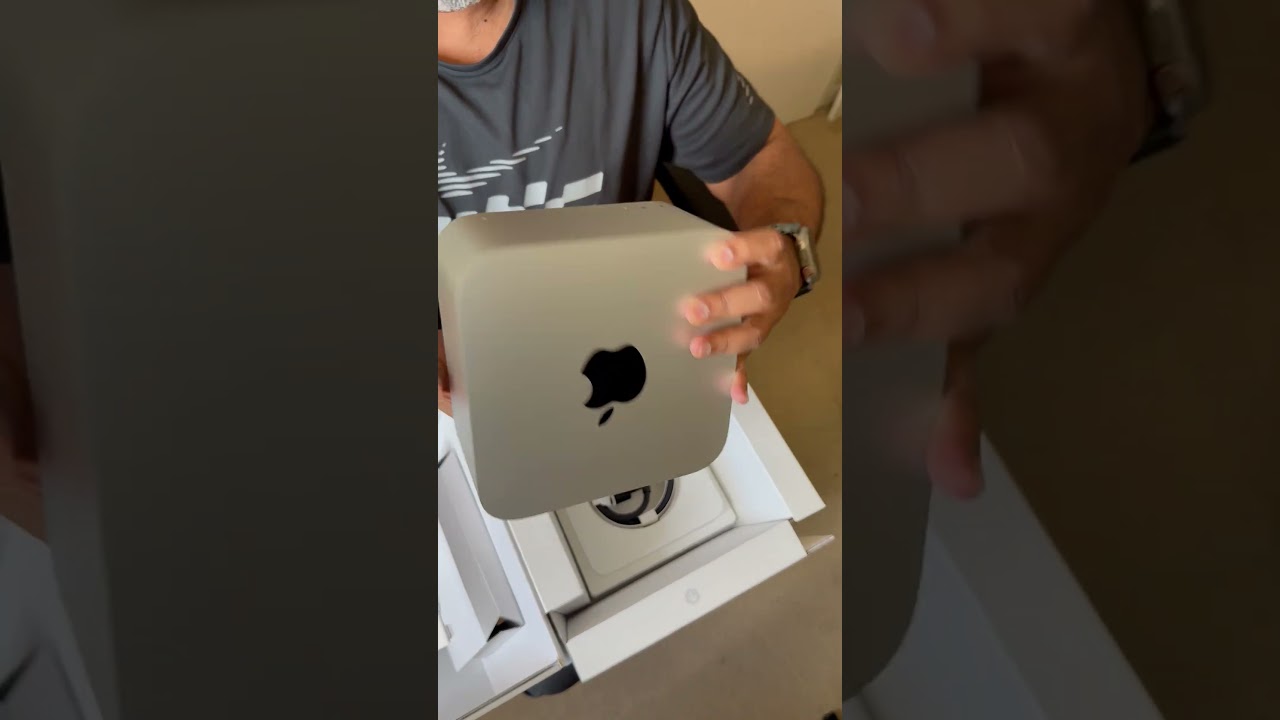
یہ لمبی شکل کا گہرا غوطہ ہے۔ تیز تر، سکم پڑھنے کے قابل ورژن کے لیے، دیکھیں ساتھی بلاگ پوسٹ.
1. تعارف: مقامی AI کے لیے Mac Studio کیوں؟
مقامی AI اب شوقین کا تجسس نہیں رہا۔ Meta, Mistral, Qwen، اور Microsoft کے کھلے وزن والے ماڈلز تیزی سے پختہ ہو رہے ہیں، اور Apple Silicon کی متحد میموری 128 GB کی حد کو عبور کر رہی ہے، اب آپ قابل بڑے لینگویج ماڈلز، ایمبیڈنگز پائپ لائنز، اور مکمل RAG سٹیکس کو ایک ہی ڈیسک سائیڈ مشین پر چلا سکتے ہیں۔
یہ مضمون ان باکسنگ کے ذریعے چلتا ہے۔ Mac Studio M4 Max چپ کے ساتھ, پہلا بوٹ، اصلی آن ڈیوائس ریڈنگ سے mactop، اور ایک عملی راستہ "دی باکس میری میز پر ہے" سے لے کر "میں مقامی طور پر چلنے والے Llama 3 کے ساتھ چیٹنگ کر رہا ہوں اور RAG کے ساتھ اپنے دستاویزات سے استفسار کر رہا ہوں"۔ یہاں کی ہر سفارش اس بات پر مبنی ہے کہ میں نے اصل میں مشین پر کیا مشاہدہ کیا ہے۔ کوئی ایجاد کردہ بینچ مارک نمبر نہیں، کوئی مارکیٹنگ فلف نہیں - صرف ورک فلو۔
اگر آپ انجینئر ہیں، ایک AI بلڈر، ایک SRE، یا ٹیک لیڈ جو یہ فیصلہ کر رہے ہیں کہ آیا Mac Studio آپ کی ٹیم کے ہارڈویئر مکس میں ہے، تو یہ گائیڈ آپ کے لیے ہے۔

2. Mac Studio M4 Max کو ان باکس کرنا
ان باکسنگ کا تجربہ ایپل کا کلاسک ہے: کم سے کم گتے، مشین ایک مولڈ ریسیس میں جکڑی ہوئی، ایک چھوٹی بلیک پاور کیبل، اور بس۔ کوئی فولا ہوا لوازمات کا بنڈل نہیں۔ Mac Studio بذات خود وہی کمپیکٹ ایلومینیم-ایکسٹروژن انکلوژر ہے جو اصل M1 الٹرا کے ساتھ متعارف کرایا گیا ہے: تقریباً 7.7 انچ مربع، ہاتھ میں گھنا، نیچے کی طرف مانوس سلیٹڈ انٹیک اور پیچھے کے ساتھ بندرگاہوں کی ایک صف۔
یوٹیوب پر ان باکسنگ مختصر دیکھیں: https://youtube.com/shorts/HUlUoHNsyNM
میں نے ان باکسنگ کا ایک مختصر کلپ شوٹ کیا - اوپر یوٹیوب شارٹ دیکھیں۔ اس فارمیٹ کے لیے شارٹ کے اتنے اچھے کام کرنے کی وجہ یہ ہے کہ اصل سیٹ اپ حقیقی طور پر تیز ہے۔ پہلے پلگ ان، مانیٹر ویک اپ، ایپل آئی ڈی سائن ان، زبان اور علاقہ، فائل والٹ، اور آپ چند منٹوں میں قابل استعمال ڈیسک ٹاپ پر ہیں۔
2.1 پہلا بوٹ - اصلی ریڈنگز سے mactop
سسٹم کی ابتدائی مطابقت پذیری ختم کرنے کے بعد میں نے پہلی چیز جو کی وہ انسٹال تھی۔ mactop - ایک بہترین اوپن سورس TUI ڈیش بورڈ جو Apple Silicon کے اندرونی کاؤنٹرز کو حقیقی وقت میں پیش کرتا ہے۔ یہ ہے وہ تازہ انسٹال ڈیش بورڈ 37 منٹ کے اپ ٹائم پر کیسا لگتا ہے:

/img/mac-studio-mactop-firstboot.png اسے بعد میں تبدیل کرنے کے لیے۔اس اسکرین شاٹ میں موجود نمبرز ہی وہ مشکل نمبر ہیں جن کا میں اس مضمون میں حوالہ دوں گا۔ وہ ایک تازہ سیٹ اپ پر بیکار میری مشین کے لئے زمینی سچائی ہیں:
- Apple Silicon: M4 Max
- CPU: کل 16 کور - 4 کارکردگی کور + 12 کارکردگی کور؛ ای کلسٹر 1.6 GHz پر، P- کلسٹر 0.2 GHz پر؛ 37 C پر پیکیج
- GPU: 784 میگاہرٹز پر 40 کور، 30 سی
- اعصابی انجن (ANE): 16-core، 0.00 W ڈرائنگ بیکار پر
- متحد میموری: 128.00 GB کل، 16.62 GB استعمال میں (تقریباً 13%) بیکار پر
- طاقت: کل 6.48 ڈبلیو - CPU 0.10 W، GPU 0.02 W، ANE 0 W، DRAM 0.36 W، سسٹم 6.01 W. زیادہ سے زیادہ سیشن میں مشاہدہ کیا گیا 46.33 W تھرملز: برائے نام۔
- ذخیرہ: 2.0 TB Mac HD، 1.9 TB مفت؛ 53.9 GB OS اور ابتدائی سیٹ اپ کے ذریعے استعمال کیا گیا۔
- نیٹ ورک: Wi-Fi 6، بیک گراؤنڈ سنک کے دوران 19.0 KB/s اپ لوڈ اور 156.8 KB/s ڈاؤن لوڈ کے نمونہ پڑھنے کے ساتھ
دو چیزیں نمایاں ہیں۔ پہلے، بیکار میں 6.48 ڈبلیو قابل استعمال میموری کے 128 GB والے ڈیسک ٹاپ کے لیے قابل ذکر ہے - یہ بہت سے لیپ ٹاپ کے اسکرین آف ہونے پر ڈرا کرنے سے کم ہے۔ دوسرا، GPU 784 میگاہرٹز پر 40 کور دستیاب ہے۔ جیسے ہی آپ اس کے سامنے ایک LLM رکھتے ہیں وہ پول اصلی کام کرنے کے لیے تیار ہو جاتا ہے۔
3. کیوں Mac Studio M4 Max مقامی AI کے لیے حیرت انگیز ہے۔
یہ سمجھنے کے لیے کہ یہ ہارڈویئر مقامی AI کے لیے اتنا موزوں کیوں ہے - اور کیوں "یونیفائیڈ میموری" ایک مارکیٹنگ لائن سے زیادہ ہے - یہ اس کا براہ راست کینونیکل متبادل کے ساتھ موازنہ کرنے میں مدد کرتا ہے: PC میں ایک مجرد GPU کارڈ، PCIe پر سسٹم RAM کے ساتھ بات چیت کرنا۔

3.1 سادہ زبان میں متحد میموری
روایتی PC AI رگ پر، آپ کے پاس دو میموری پول ہیں۔ سسٹم RAM (عام طور پر DDR5 کا 64-256 GB) جب آپ انہیں ڈسک سے لوڈ کرتے ہیں تو OS، ایپلیکیشن اور ماڈل کا وزن رکھتا ہے۔ GPU کا اپنا VRAM ہے - RTX 4090 پر 24 GB، 5090 پر 32 GB، A100 پر 80 GB۔ اس سے پہلے کہ GPU ایک واحد متمول چلا سکے، ماڈل ہونا ضروری ہے۔ کاپی سسٹم RAM سے VRAM میں PCIe بس میں۔ اگر ماڈل VRAM سے بڑا ہے، تو یہ یا تو بالکل لوڈ نہیں ہوتا ہے، یا PCIe کے ذریعے سفاکانہ قیمت پر صفحہ کیا جاتا ہے (اکثر VRAM میں مکمل طور پر چلنے سے 10-100x سست)۔
Apple Silicon ان دو تالابوں کو ایک میں سمیٹتا ہے۔ CPU، GPU، نیورل انجن، اور میڈیا انجن سبھی دیکھتے ہیں۔ ایک ہی جسمانی میموری. کوئی نقل نہیں ہے۔ کوئی PCIe رکاوٹ نہیں ہے۔ ایک ماڈل جو ڈسک پر 40 GB ہے متحد میموری میں 40 GB ہے، اور GPU اسے براہ راست پڑھ سکتا ہے۔
مقامی LLMs کے لیے، یہ قاتل خصوصیت ہے۔ Q4_K_M کے لیے 70B-پیرامیٹر ماڈل کی مقدار ڈسک پر تقریباً 40 GB ہے (اس مقدار کی سطح پر Llama-کلاس وزن کے لیے عوامی طور پر حوالہ دیا گیا اعداد و شمار - تخمینہ کے طور پر علاج کریں)۔ 24 GB صارف GPU پر، وہ ماڈل صرف فٹ نہیں ہوتا ہے۔ 128 GB یونیفائیڈ میموری پر، یہ تقریباً 80 GB کے ساتھ لوڈ ہوتا ہے جو ابھی بھی سیاق و سباق، ایپلیکیشن کوڈ اور ٹولز کے لیے مفت ہے۔
3.2 طاقت کی کارکردگی جس پر یقین کرنا مشکل ہے۔
میک ٹاپ اسکرین شاٹ 6.48 ڈبلیو کو بیکار اور سیشن کے دوران زیادہ سے زیادہ 46.33 ڈبلیو دکھاتا ہے۔ اس کو تناظر میں رکھنے کے لیے: ایک سنگل RTX 4090 15-25 W پر بقیہ سسٹم کے ساتھ سب سے اوپر ہے، اور بوجھ کے نیچے 450 W تک کھینچتا ہے۔ ایک Mac Studio ایک ڈیسک سائیڈ AI باکس ہے جسے آپ بجلی کے بل پر توجہ دیئے بغیر 24/7 چلانا چھوڑ سکتے ہیں۔ یہ خاموش ہے۔ قیاس کام کے بوجھ کے دوران شائقین تقریبا کبھی نہیں گھومتے ہیں۔ یہ وہی ہے جو اسے بطور قابل عمل بناتا ہے۔ ہمیشہ آن ڈیو باکس اس طرح کہ ایک مجرد GPU PC شاذ و نادر ہی ہوتا ہے۔
3.3 ایپل نیورل انجن دراصل کیا کرتا ہے۔
ANE ایک 16 کور فکسڈ فنکشن ایکسلریٹر ہے جس کو ان قسم کے ٹینسر آپریشنز کے لیے بہتر بنایا گیا ہے جو CoreML تیار کرتا ہے۔ 2026 میں زیادہ تر کھلے وزن والے LLM کام کے بوجھ کے لیے (GGUF فارمیٹ llama.cpp یا Ollama کے ذریعے چل رہا ہے)، ANE گرم راستے میں نہیں ہے - GPU ہے، میٹل پرفارمنس شیڈرز کے ذریعے۔ ANE CoreML میں تبدیل شدہ ماڈلز، آن ڈیوائس اسپیچ ریکگنیشن، امیج سیگمنٹیشن، اور اسی طرح کے فکسڈ شیپ ورک بوجھ کے لیے چمکتا ہے۔ جب یہ چلتا ہے تو یہ انتہائی طاقتور بھی ہے۔ یہ جاننا مفید ہے کہ یہ وہاں ہے۔ ہر LLM اسٹیک کے استعمال کی توقع نہ کریں۔
4. AI کام کے لیے Mac Studio ترتیب دینا
معیاری macOS آن بورڈنگ کے بعد، یہاں بالکل وہی لائیو اپ ہے جس کی میں ایک تازہ Mac Studio کی پیروی کرتا ہوں جسے میں مقامی AI دیو باکس کے طور پر استعمال کرنا چاہتا ہوں۔
4.1 ہومبریو، ایکس کوڈ CLT، اور بنیادی باتیں انسٹال کریں۔
/bin/bash -c "$(curl -fsSL https://raw.githubusercontent.com/Homebrew/install/HEAD/install.sh)"

xcode-select --install

brew install git wget jq python@3.12 node pyenv
brew install --cask iterm2 visual-studio-code
ہومبریو یونکس ٹولنگ لاتا ہے، ایکس کوڈ کمانڈ لائن ٹولز کمپائلرز اور لنکرز فراہم کرتے ہیں، پائتھون اور نوڈ آپ کو ایپ کوڈ کے لیے رن ٹائم دیتے ہیں، اور iTerm2 + VS Code وہ ایڈیٹر + ٹرمینل جوڑا ہے جس کے لیے میں ڈیفالٹ کرتا ہوں۔
4.2 Ollama انسٹال کریں۔
Ollama macOS پر اوپن ویٹ LLMs کو ڈاؤن لوڈ، چلانے اور پیش کرنے کا آسان ترین طریقہ ہے۔ ہڈ کے نیچے یہ لپیٹتا ہے۔ llama.cpp میٹل ایکسلریشن کے ساتھ اور پورٹ 11434 پر ایک سادہ HTTP API فراہم کرتا ہے۔
brew install ollama

ollama serve &

ollama --version
آپ آفیشل کے ذریعے بھی انسٹال کر سکتے ہیں۔ .dmg ollama.com سے، جو ایک مینو بار ایپ سیٹ کرتا ہے۔ یا تو راستہ کام کرتا ہے۔ میں ہیڈ لیس بکس کے لیے بریو انسٹال اور ڈیلی ڈرائیور میک کے لیے ڈی ایم جی کو ترجیح دیتا ہوں۔
4.3 LM اسٹوڈیو انسٹال کریں (اختیاری لیکن قابل قدر)
ایل ایم اسٹوڈیو GGUF ماڈلز کے ساتھ براؤزنگ، ڈاؤن لوڈ، اور چیٹنگ کے لیے ایک ڈیسک ٹاپ UI ہے۔ یہ ایک OpenAI سے ہم آہنگ API کو بھی بے نقاب کرتا ہے۔ میں اسے Ollama کے ساتھ انسٹال کرتا ہوں کیونکہ ماڈل براؤزر بہترین ہے اور جب آپ Q4_K_M اور Q5_K_M کے درمیان فیصلہ کر رہے ہیں تو فی ماڈل پرفارمنس ٹیوننگ UI دوستانہ ہے۔
4.4 VS کوڈ میں Continue.dev انسٹال کریں۔
Continue.dev آپ کو VS کوڈ کے اندر ChatGPT طرز کی مدد فراہم کرتا ہے، لیکن آپ کے مقامی Ollama کی طرف اشارہ کیا گیا ہے۔ ایکسٹینشن انسٹال کرنے کے بعد اسے اپنے میں چھوڑ دیں۔ ~/.continue/config.json:
{
  "models": [
    {
      "title": "Llama 3.1 8B (local)",
      "provider": "ollama",
      "model": "llama3.1:8b",
      "apiBase": "http://localhost:11434"
    },
    {
      "title": "Qwen 2.5 Coder 14B (local)",
      "provider": "ollama",
      "model": "qwen2.5-coder:14b",
      "apiBase": "http://localhost:11434"
    }
  ],
  "tabAutocompleteModel": {
    "title": "Codestral (local)",
    "provider": "ollama",
    "model": "codestral:latest",
    "apiBase": "http://localhost:11434"
  }
}
اب آپ کے پاس ان لائن چیٹ، ترمیم، اور خودکار تکمیل ہے - تمام ہٹ ماڈلز جو آپ کے ایڈیٹر کے طور پر اسی ڈیسک پر رہتے ہیں۔ صفر ڈیٹا مشین چھوڑ دیتا ہے۔
5. اپنا پہلا LLM چلانا

سچائی کے لمحے کا وقت۔ ایک ماڈل کھینچیں اور اسے چلائیں۔
5.1 کھینچنا Llama 3.1 8B
ollama pull llama3.1:8b

ollama list

ollama run llama3.1:8b "Explain unified memory architecture to me in 3 sentences."
پل Q4_K_M GGUF کو ڈاؤن لوڈ کرتا ہے (Q4_K_M پر Llama 3.1 8B ڈسک پر تقریبا 4.7 GB ہے - عوامی طور پر حوالہ دیا گیا اعداد و شمار، تخمینہ کے طور پر علاج کریں)۔ میرے جیسے Wi-Fi 6 کنکشن پر، ڈاؤن لوڈ میں چند منٹ لگتے ہیں۔ وائرڈ گیگابٹ پر یہ تیز ہے۔ ایک بار جب یہ اترتا ہے، پہلا ollama run یونیفائیڈ میموری میں ایک بار ماڈل کا بوجھ شامل ہے - آپ کو پہلی ٹوکن اسٹریمز سے پہلے ایک مختصر وقفہ نظر آئے گا - اور پھر اس کے بعد کے رنز تیز ہوں گے۔
میں جان بوجھ کر یہاں اپنی مشین کے لیے ٹوکن فی سیکنڈ نمبرز کا حوالہ نہیں دوں گا، کیونکہ میں نے جوڑے کے طریقہ کار کے ساتھ کنٹرول شدہ بینچ مارک سویٹ نہیں چلایا ہے۔ میں جو کہوں گا وہ یہ ہے کہ ہارڈ ویئر کی اس کلاس پر (40 GPU کور کے ساتھ M4 Max) آپ کو توقع کرنی چاہئے۔ ہموار، بات چیت کا سلسلہ Q4_K_M پر ایک 8B ماڈل سے، ایک قابل توجہ ابتدائی لوڈ میں تاخیر اور پورے ردعمل میں مستحکم آؤٹ پٹ کے ساتھ۔ اگر آپ نے کہیں اور "مجھے اپنے میک پر 60 ٹوکن فی سیکنڈ ملتے ہیں" جیسے دعوے پڑھے ہیں، تو انہیں بالپارک رہنمائی کے طور پر سمجھیں۔ آپ کے اصل نمبر پرامپٹ کی لمبائی، سیاق و سباق کی کھڑکی، کوانٹائزیشن لیول، ماڈل آرکیٹیکچر، اور کیا چل رہا ہے کے ساتھ مختلف ہوں گے۔
5.2 مقدار کا انتخاب - Q4_K_M, Q5_K_M, Q8_0
کوانٹائزیشن ماڈل وزن کی درستگی کو کم کرتی ہے تاکہ انہیں ڈسک پر اور میموری میں سکڑ جائے۔ تجارت کا معیار ہے۔ مقامی تخمینہ کے لیے مقدار کا انتخاب کرتے وقت میں یہ کھردرا ذہنی ماڈل استعمال کرتا ہوں:
| کوانٹ | 8B کے لیے تقریباً سائز | معیار بمقابلہ FP16 | کب استعمال کرنا ہے۔ |
|---|---|---|---|
| Q4_K_M | ~4.7 GB | بہت اچھا، چھوٹا قطرہ | طے شدہ چیٹ اور کوڈ کے لیے بہترین رفتار/کوالٹی بیلنس۔ |
| Q5_K_M | ~5.7 GB | FP16 کے قریب | جب آپ کو ٹچ کی ضرورت ہو تو زیادہ درستگی اور میموری کو بچانا ہے۔ |
| Q8_0 | ~8.5 GB | بے نقصان | جب آپ کو چھوٹے ماڈلز پر زیادہ سے زیادہ معیار اور کم از کم شور کی ضرورت ہو۔ |
تمام سائز تخمینی ہیں، Llama-کلاس 8B وزن کے لیے عوامی طور پر حوالہ کردہ اعداد و شمار۔ متعلقہ ترتیب وہی ہے جو اہم ہے۔
5.3 جو 32، 64، اور 128 GB میں فٹ بیٹھتا ہے۔
| متحد میموری | حقیقت پسندانہ کمفرٹ زون (Q4_K_M) | کھینچنا (دیکھ بھال کے ساتھ) |
|---|---|---|
| 32 GB | 7B/8B/13B | 20-22B سخت تناظر میں |
| 64 GB | 13B/20B/34B | سخت تناظر میں 40-50B |
| 128 GB | 34B / 70B / ماہرین کی مختلف اقسام | سخت تناظر میں 100-120B |
"کمفرٹ زون" کا مطلب ہے کہ ماڈل میں کافی گنجائش ہے جس میں ایک فراخ سیاق و سباق کی کھڑکی، ایک KV کیش، اور دیگر ایپلیکیشنز چل رہی ہیں۔ "اسٹریچ" کا مطلب ہے کہ یہ لوڈ ہوتا ہے لیکن آپ سیاق و سباق کی لمبائی اور دوسرے کام کے بوجھ کو جگانا شروع کر دیتے ہیں۔ اپنے 128 GB باکس پر میں Q4_K_M پر 70B چلا سکتا ہوں اور ابھی بھی VS کوڈ، کروم، اور Python کے کچھ عملوں کے لیے تقریباً 80 GB ہیڈ روم ہے - جو کہ واضح طور پر، ایک پرتعیش احساس ہے۔
5.4 نوڈ اور ازگر سے Ollama کال کرنا
Ollama پر ایک HTTP API کو بے نقاب کرتا ہے۔ http://localhost:11434. ایک چھوٹا نوڈ بازیافت اس طرح لگتا ہے:
// node 20+
const res = await fetch("http://localhost:11434/api/generate", {
  method: "POST",
  headers: { "Content-Type": "application/json" },
  body: JSON.stringify({
    model: "llama3.1:8b",
    prompt: "Write a one-paragraph summary of unified memory architecture.",
    stream: false
  })
});

const data = await res.json();
console.log(data.response);
اور ازگر سے:
import requests

r = requests.post(
    "http://localhost:11434/api/generate",
    json={
        "model": "llama3.1:8b",
        "prompt": "Explain HNSW indexes briefly.",
        "stream": False,
    },
    timeout=120,
)
print(r.json()["response"])
یہ وہ سب کچھ ہے جس کی آپ کو مقامی LLM کو CLI ٹول، ایک Slack bot، ایک شارٹ کٹ، ایک microservice، یا اندرونی آٹومیشن میں وائر کرنے کی ضرورت ہے۔ کوئی چابیاں نہیں، شرح کی کوئی حد نہیں، کوئی کوٹہ نہیں۔
6. Mac Studio پر چلانے کے لیے بہترین ماڈل
ماڈل کا انتخاب جزوی کارکردگی، جزوی لائسنس، جزوی وائب ہے۔ یہ ہے جو میں اصل میں باکس پر چلاتا ہوں، سائز کے درجے کے لحاظ سے گروپ کیا گیا ہے۔
6.1 چھوٹا (10B سے کم): روزمرہ کے کام کے گھوڑے تیز
- Llama 3.1 8B - عمدہ عام مقصد کی بات چیت اور استدلال؛ انتباہات کے ساتھ اجازت دینے والا میٹا لائسنس۔
- Mistral 7B / Ministral 8B - مضبوط استدلال، اپاچی لائسنس یافتہ مختلف حالتیں دستیاب ہیں۔
- Qwen 2.5 7B - بہت مضبوط کثیر لسانی اور کوڈ کی کارکردگی۔
- Phi-3.5 منی - چھوٹا، حیرت انگیز طور پر قابل، مثالی جب آپ کو تھرو پٹ اور کم تاخیر کی ضرورت ہو۔
- Codestral / Qwen 2.5 Coder 7B - IDE کام کے لیے تیز ان لائن خودکار تکمیل۔
6.2 مڈ (10B-40B): 64-128 GB پر خوبصورت جگہ
- Llama 3.1 / 3.3 70B (Q4_K_M) - اگر آپ کے پاس 128 GB ہے، تو یہ ہیڈ لائن ماڈل ہے۔ قریب ترین معیار، آرام سے چلتا ہے۔
- Qwen 2.5 32B - بہترین معیار سے سائز کا تناسب؛ RAG کے ساتھ اچھی طرح جوڑیں۔
- ڈیپ سیک کوڈر 33B - کوڈ بنانے کے کاموں میں مضبوط۔
- Mixtral 8x7B - ماہرین کا مرکب، ایک وقت میں صرف 2 ماہرین کو متحرک کرتا ہے، آرام سے فٹ بیٹھتا ہے۔
6.3 بڑا (70B اور اوپر): صرف 96-128 GB پر اور صرف Q4 پر
128 GB پر دروازہ Q4_K_M پر 70B کلاس ماڈلز کے لیے کھلا ہے۔ وہ ہیں۔ سست 8B ماڈلز سے زیادہ، لیکن کوالٹی جمپ ان کاموں کے لیے اہم ہے جو وسیع تر عالمی علم اور طویل استدلال سے فائدہ اٹھاتے ہیں۔ توقع ہے کہ پہلے ٹوکن میں تاخیر طویل ہوگی اور اسٹریمنگ کی رفتار کم ہوگی، لیکن اصل تجربہ بہت سے ورک فلو کے لیے قابل استعمال رہتا ہے۔
7. مقامی RAG پائپ لائن بنانا
ایک بار جب آپ کے پاس مقامی LLM ہو جائے تو، سب سے زیادہ مفید چیز جو آپ اس کے ساتھ کر سکتے ہیں وہ ہے اسے اپنی دستاویزات کی طرف اشارہ کریں۔ یہ Retrieval-Augmented Generation ہے، اور یہ کام کا بوجھ ہے جہاں Mac Studio واقعی کلاؤڈ APIs کے نجی متبادل کے طور پر چمکتا ہے۔

7.1 اسٹیک
- دستاویز کا تجزیہ کرنے والا - پی ڈی ایف کے لئے پی ایم یو پی ڈی ایف،
unstructuredمخلوط شکل کے ادخال کے لیے۔ - چنکر - LangChain's
RecursiveCharacterTextSplitterیا ٹوکن سے آگاہ سپلٹر۔ اوورلیپ کے 64-128 ٹوکن کے ساتھ عام ٹکڑا سائز 512-1024 ٹوکن۔ - ایمبیڈنگز -
nomic-embed-textیاmxbai-embed-large، دونوں Ollama کے ذریعے دستیاب ہیں۔ دونوں مقامی GPU پر چلتے ہیں۔ - ویکٹر اسٹور - ChromaDB بطور ڈیفالٹ۔ SQLite-VSS صفر سرور آپشن کے لیے۔ LanceDB اگر آپ ایک واحد فائل ایمبیڈڈ آپشن چاہتے ہیں جو اسکیل کرتا ہے۔
- جنریٹر - تیز رفتار تبدیلی کے لیے Llama 3.1 8B، یا اگر آپ اعلیٰ معیار کے جوابات چاہتے ہیں تو 70B۔
7.2 کم سے کم ازگر کی مثال - آخر سے آخر تک
pip install chromadb requests pypdf

import os, glob, requests, chromadb
from chromadb.utils import embedding_functions
from pypdf import PdfReader

OLLAMA = "http://localhost:11434"
EMBED_MODEL = "nomic-embed-text"
GEN_MODEL   = "llama3.1:8b"

def embed(text: str) -> list[float]:
    r = requests.post(f"{OLLAMA}/api/embeddings", json={
        "model": EMBED_MODEL, "prompt": text,
    }, timeout=60)
    return r.json()["embedding"]

def generate(prompt: str) -> str:
    r = requests.post(f"{OLLAMA}/api/generate", json={
        "model": GEN_MODEL, "prompt": prompt, "stream": False,
    }, timeout=300)
    return r.json()["response"]

def chunk(text: str, size: int = 1000, overlap: int = 150):
    out, i = [], 0
    while i < len(text):
        out.append(text[i:i+size])
        i += size - overlap
    return out

client = chromadb.PersistentClient(path="./rag-db")
col = client.get_or_create_collection("docs")

for path in glob.glob("./docs/**/*.pdf", recursive=True):
    reader = PdfReader(path)
    full = "\n".join(p.extract_text() or "" for p in reader.pages)
    for j, c in enumerate(chunk(full)):
        col.add(
            ids=[f"{os.path.basename(path)}::{j}"],
            documents=[c],
            embeddings=[embed(c)],
            metadatas=[{"source": path, "chunk": j}],
        )

def ask(q: str, k: int = 5) -> str:
    qe = embed(q)
    res = col.query(query_embeddings=[qe], n_results=k)
    ctx = "\n\n".join(res["documents"][0])
    prompt = (
        "Answer the question using only the context below. "
        "If the answer is not in the context, say you do not know.\n\n"
        f"Context:\n{ctx}\n\nQuestion: {q}\nAnswer:"
    )
    return generate(prompt)

print(ask("What is unified memory and why does it matter for LLMs?"))
یہ Python کی 60 لائنوں سے کم میں ایک مکمل مقامی RAG پائپ لائن ہے۔ پوری چیز Mac Studio پر چلتی ہے۔ کوئی بیرونی API کیز نہیں، کوئی فی ٹوکن بلنگ نہیں، مشین کو چھوڑنے والا کوئی ڈیٹا نہیں۔ ایک بڑے پی ڈی ایف سیٹ کے پہلے ادخال میں چند منٹ لگیں گے۔ بعد کے سوالات تیز ہیں۔
7.3 ٹیوننگ نوٹ
- ٹکڑے کا سائز - 1000 حروف اور 150 اوورلیپ کے ساتھ شروع کریں؛ اگر آپ کے ذرائع میں لمبے ڈھانچے والے حصے (قانونی، تکنیکی تفصیلات) ہیں اور بازیافت کرنے والا جوابات کو ٹکڑے ٹکڑے کر رہا ہے۔
- ٹاپ-کے - 4-8 عملی رینج ہے۔ بہت اونچا جانا فوری طور پر بڑھتا ہے اور بغیر کسی واضح فائدہ کے جنریشن کو سست کر دیتا ہے۔
- دوبارہ درجہ بندی کرنا - اعلیٰ ترین معیار کے لیے، ٹاپ-20 بازیافت کریں اور کراس انکوڈر کے ساتھ دوبارہ درجہ بندی کریں (جیسے
bge-reranker)۔ Mac Studio پر یہ سستا ہے۔ - میٹا ڈیٹا فلٹرنگ - ٹکڑوں کو ان کے ماخذ کے راستے، تاریخ اور حصے کے ساتھ ٹیگ کریں۔ ویکٹر کی تلاش سے پہلے استفسار کے وقت فلٹر کریں۔ یہ واحد سب سے بڑی درستگی کی جیت ہے۔
- سلسلہ بندی --.سوئچ
streamکوtrueOllama کال میں اور ایک تیز UX کے لیے کلائنٹ کو ٹوکن سٹریم کریں۔
8. روزمرہ کا ڈویلپر لوپ
Mac Studio پر چند ہفتوں کے بعد میرا یومیہ لوپ اس طرح نظر آتا ہے:
- VS کوڈ کھولیں، Continue.dev Ollama کے خلاف اٹھتا ہے۔
- میرے نوٹس کے خلاف طویل گفتگو کے سوال و جواب کے لیے Open WebUI (یا LM Studio) میں چیٹ کھولیں۔
- کوڈ کے کام کے لیے: کوڈسٹریل یا کیوین کوڈر ماڈل پر ٹیب خودکار تکمیل، Llama 3.1 8B پر طویل چیٹس، 70B پر گہری استدلال کے سیشن جب ٹاسک اس کی ضمانت دیتا ہے۔
- اندرونی RAG کے لیے، ایک Python اسکرپٹ جو پروجیکٹ کے ڈاکس/فولڈر اور کروما ڈیٹا بیس کی طرف اشارہ کرتا ہے۔
- ایجنٹ پروٹو ٹائپنگ کے لیے، لینگ گراف یا ایک چھوٹا کسٹم لوپ جو کہ Ollama اینڈ پوائنٹ کو کہتے ہیں - ایک ہی پیٹرن، مختلف گلو۔
جب آپ کا LLM مقامی ہوتا ہے تو وہ چیز جو واقعی تبدیل ہوتی ہے وہ ہے جس طرح سے آپ اسے استعمال کرتے ہیں۔ استفسار پر کوئی اضافی لاگت نہیں ہے، لہذا آپ ماڈل سے مزید سوالات پوچھیں۔ رازداری کی کوئی فکر نہیں ہے، لہذا آپ پروڈکشن لاگز، اندرونی دستاویزات، کسٹمر ای میلز میں پیسٹ کریں۔ آپ چھوٹی سی سی ایل آئی اسکرپٹ لکھتے ہیں جو 200 دستاویزات سے گزرتے ہیں تاکہ ایک ساختی خلاصہ نکالا جا سکے، اور آپ فی ٹوکن بل کے بارے میں دو بار نہیں سوچتے، کیونکہ کوئی بل نہیں ہے۔
9. بینچ مارکس اور ایماندارانہ موازنہ بمقابلہ کلاؤڈ
مجھے بہت سیدھی بات کرنے دو: میں ٹوکن فی سیکنڈ نمبر شائع نہیں کروں گا جو میں نے سختی سے کنٹرول شدہ بینچ مارک طریقہ کار کے ساتھ تیار نہیں کیے ہیں۔ انٹرنیٹ ایسے نمبروں سے بھرا ہوا ہے، اکثر مختلف مقداری سطحوں اور سیاق و سباق کی لمبائی اور فوری فارمیٹس کا موازنہ کرتا ہے، اور وہ واضح کرنے سے کہیں زیادہ الجھتے ہیں۔ اس کے بجائے میں کیا کروں گا ایک فیصلہ میٹرکس شائع کروں گا جو گرفت کرتا ہے۔ کس قسم کا کام کا بوجھ Mac Studio اصل میں جیتتا ہے۔، جہاں یہ نہیں ہے، اور جہاں صحیح جواب ہے "دونوں کا استعمال کریں"۔

9.1 بریک ایون ریاضی
ایک Mac Studio M4 Max 128 GB یونیفائیڈ میموری کے ساتھ اور 2 TB SSD تقریباً ایک ہی قیمت کے بینڈ میں آتا ہے جیسا کہ ہمیشہ جاری رہنے والے کلاؤڈ GPU مثال کے چند مہینوں میں ہوتا ہے۔ تمام مخصوص ڈالر کے اعداد و شمار کو تخمینی اور علاقے اور رعایت کے کام کے طور پر سمجھیں:
- ایک Mac Studio M4 Max، اچھی طرح سے ترتیب شدہ: تقریباً $4,000-$6,000 ایک بار (تخمینہ؛ ترتیب مختلف ہوتی ہے)۔
- ایک AWS
g5.xlarge(سنگل A10G، 24 GB VRAM) 24x7 آن ڈیمانڈ پر چل رہا ہے: $700-$900 فی مہینہ کی ترتیب میں (علاقے پر منحصر)۔ - ایک AWS
p4d.24xlarge(8x A100): $20,000-$30,000 فی مہینہ آن ڈیمانڈ کا آرڈر اگر آپ اسے کسی طرح چھوڑ دیتے ہیں (آپ نہیں کریں گے، لیکن اس سے تضاد واضح ہوجاتا ہے)۔
ریاضی کا کہنا ہے کہ ہمیشہ جاری رہنے والے ڈیو باکس کے لیے، Mac Studio چند مہینوں میں اپنے لیے ادائیگی کرتا ہے بمقابلہ ایک موازنہ ہمیشہ آن کلاؤڈ مثال، اور برسوں تک بجلی کی شرائط میں اپنے لیے ادائیگی کرتا رہتا ہے۔ برسٹ ٹریننگ ملازمتوں کے لیے ریاضی پلٹ جاتی ہے: ایک گھنٹے کے لیے کرایہ، دوڑیں، واپس دیں۔ کام کے لیے صحیح ٹول استعمال کریں۔
9.2 جب بادل صحیح جواب ہے۔
- آپ کو 128 GB میں فٹ ہونے سے بڑے ماڈل کو تربیت دینے یا ٹھیک کرنے کی ضرورت ہے۔
- آپ کو سخت SLOs اور لچکدار صلاحیت کے ساتھ عالمی صارف کی بنیاد پر بڑے پیمانے پر خدمت کرنے کی ضرورت ہے۔
- آپ ایک ایسا تجربہ چلا رہے ہیں جو 8x A100 یا H100 متوازی سے فائدہ اٹھاتا ہے۔
- آپ کے org کی تعمیل کی کرنسی کہتی ہے کہ اندازہ مخصوص آڈٹ ٹریلز کے ساتھ ایک مخصوص کلاؤڈ ریجن میں چلنا چاہیے۔
9.3 جب Mac Studio صحیح جواب ہے۔
- آپ اپنی ٹیم کے لیے ہمیشہ پرائیویٹ انفرنس باکس چاہتے ہیں۔
- آپ RAG، ایجنٹس، یا IDE copilots بنا رہے ہیں جہاں ڈیٹا کی رہائش اور رازداری کی اہمیت ہے۔
- آپ ایک پرسکون، کم طاقت والا ڈیو باکس چاہتے ہیں جس کے لیے سرور روم کی ضرورت نہ ہو۔
- آپ تیزی سے پروٹو ٹائپ کر رہے ہیں اور کلاؤڈ API کی فی ٹوکن بلنگ آپ کے راستے میں ہے۔
- آپ اسٹیک سیکھنا چاہتے ہیں - ایک ماڈل کے مالک، رن ٹائم کے مالک، ویکٹر اسٹور کے مالک، لوپ کے مالک۔
10. چیلنجز اور حدود
اگر میں کھردری کناروں کا نام نہیں لیتا تو میں اس مضمون کو کوئی احسان نہیں کر رہا ہوں۔ Apple Silicon مقامی AI کے لیے بہترین ہے، لیکن حقیقی انتباہات موجود ہیں۔
10.1 تربیت اب بھی تخمینہ کے مقابلے میں ایک کمزور کہانی ہے۔
Apple Silicon AI کہانی کے لیے بہت مضبوط ہے۔ اندازہ کے مقابلے میں تربیت. PyTorch کا MPS بیک اینڈ نمایاں طور پر پختہ ہو چکا ہے، اور ایپل کا اپنا MLX فریم ورک حقیقی طور پر اچھا ہے، لیکن CUDA- صرف ٹریننگ ٹولنگ کی وسعت اب بھی وسیع ہے۔ اگر آپ کا دن کا کام ناول ماڈل آرکیٹیکچرز یا بڑے پیمانے پر فائن ٹیوننگ ہے، تو آپ ایسے سوراخوں کو ماریں گے جو آپ لینکس + NVIDIA پر نہیں مارتے ہیں۔
10.2 ایکو سسٹم کئی جگہوں پر CUDA کو فرض کرتا ہے۔
بہت سے AI ریپوز اب بھی CUDA کے مفروضوں پر ڈیفالٹ ہیں۔ زیادہ تر دیکھ بھال والے پروجیکٹس میں اب میٹل / ایم پی ایس راستے ہیں، لیکن کبھی کبھار رگڑ کی توقع کرتے ہیں: ایک لائبریری جس میں ماخذ سے تعمیر کی ضرورت ہوتی ہے، ایک دانا جس میں دھات کے برابر نہیں ہوتا، ایک بینچ مارک سوٹ جو صرف NVIDIA پر چلتا ہے۔ اس کے لیے وقت کی منصوبہ بندی کریں۔
10.3 اسکیلنگ آؤٹ DIY ہے۔
ایک Mac Studio ایک واحد باکس ہے۔ جیسے اوزار EXO اور دوسرے آپ کو ایک سے زیادہ آلات پر بہت بڑے ماڈل چلانے کے لیے کلسٹر Macs کی اجازت دیتے ہیں، لیکن یہ وہ پالش کہانی نہیں ہے جو آپ کو g5s کے Kubernetes کلسٹر کے ساتھ ملتی ہے۔ اگر آپ کے کام کے بوجھ کو افقی لچک کی ضرورت ہے، تو بادل اب بھی بہتر ہے۔
10.4 مرمت اور اپ گریڈ
آپ بعد میں رام شامل نہیں کر سکتے۔ آپ SSD کو بعد میں تبدیل نہیں کر سکتے ہیں (عملی طور پر)۔ اپنی ضرورت کی چیز خریدیں، پھر پلس ون - خاص طور پر میموری پر۔ 128 GB ٹائر وہی ہے جس کی میں سنجیدہ AI کام کے لیے تجویز کروں گا۔ 64 GB منزل ہے۔
10.5 مسلسل بوجھ کے تحت تھرمل
Mac Studio بیکار میں ٹھنڈا اور پرسکون چلتا ہے (اوپر اسکرین شاٹ 37 C اور 30 C دکھاتا ہے جس میں شائقین کو سنا نہیں جا سکتا)۔ مسلسل بھاری LLM بوجھ کے تحت، پرستار گھومتے ہیں - زور سے نہیں، بلکہ سنائی دیتے ہیں - اور چپ گرم ہوتی ہے۔ یہ برائے نام تھرمل لفافوں کے اندر ہے۔ بس اتنا جان لیں کہ "خاموش" ایک بیکار اور ہلکے بوجھ والی خصوصیت ہے، مطلق نہیں۔
11. Apple Silicon پر مقامی AI کا مستقبل
تین رجحانات یکجا ہو رہے ہیں جو اگلے 12-24 مہینوں کو Apple Silicon پر مقامی AI کے لیے دلچسپ بناتے ہیں۔
پہلے، کھلے وزن والے ماڈل صلاحیت کھوئے بغیر چھوٹے ہوتے رہتے ہیں۔. Phi-3.5، Qwen 2.5 چھوٹا، اور Llama 3.x فیملی اپنے وزن کی کلاس سے اوپر 8B پنچ پر۔ ایک 2026 8B ماڈل بہت سے کاموں میں 2023 70B کے معیار کے لحاظ سے تقریباً موازنہ ہے۔ اس کا مطلب ہے کہ زیادہ کام کا بوجھ یونیفائیڈ میموری کے 32-64 GB میں آرام سے فٹ ہوجاتا ہے، اور 128 GB Mac Studio ملٹی ماڈل سرونگ باکس بن جاتا ہے۔
دوسرا، ایپل کا اپنا MLX فریم ورک بہتر ہوتا رہتا ہے۔. MLX NumPy کی طرح API، سست تشخیص، پہلے سے طے شدہ طور پر متحد میموری آگاہی، اور متحرک کمپیوٹیشن گراف فراہم کرتا ہے۔ MLX کمیونٹی ماڈلز، ٹوکنائزرز، اور ٹریننگ لوپس کو تیز رفتار کلپ پر پورٹ کر رہی ہے۔ اگر آپ آج میک پر ایک نیا ML پروجیکٹ شروع کر رہے ہیں، MLX قدرتی انتخاب ہے۔ اگر آپ PyTorch استعمال کر رہے ہیں، MPS بیک اینڈ ہر ریلیز میں زیادہ قابل استعمال ہے۔
تیسرا، کوانٹائزیشن اور KV-کیشے کمپریشن بہتر ہوتے رہتے ہیں۔. Q4_K_M، IQ-family quants، اور GGUF میں بہتری جیسی تکنیکوں کا مطلب ہے کہ وہی ماڈل کم میموری میں فٹ بیٹھتا ہے جو اس نے چھ ماہ پہلے کیا تھا، کم معیار کے نقصان کے ساتھ۔ مقامی AI ایک منحنی خطوط پر ہے جہاں ماڈل + کوانٹ جوڑی کی ہر نسل صارفین کی قیمت والے ہارڈ ویئر کی عملی رسائی کو بڑھاتی ہے۔
اس سب میں مستقبل کے M-series چپس (M5، مستقبل کے الٹراس، اسٹوڈیو ریفریش) کے ارد گرد افواہوں کی چکی کو شامل کریں، اور رفتار واضح ہے: ڈیسک سائیڈ اے آئی باکس یہاں ہے، اور یہ بہتر ہوتا جا رہا ہے۔.
12. ٹیم AI باکس کے طور پر Mac Studio کو سخت کرنا
اگر آپ اپنے Mac Studio کو ایک چھوٹی ٹیم کے ساتھ بانٹنا چاہتے ہیں - کہو، Ollama، ایک Open WebUI مثال، اور RAG اختتامی نقطہ کو مٹھی بھر ساتھیوں کے سامنے پیش کریں - یہ ہے سخت سختی جو میں کرتا ہوں:
- فائل والٹ آن اور ایک مضبوط لاگ ان پاس ورڈ۔ اسے UPS پر رکھیں۔
- دم کا پیمانہ باکس پر ہے تاکہ اسے عوامی انٹرنیٹ پر ظاہر کیے بغیر آپ کی ٹیم کے آلات سے قابل رسائی ہو۔
- Ollama کو لوکل ہوسٹ سے باندھیں۔ اور اسے ایک پتلی auth پراکسی (Caddy، Traefik، یا ایک چھوٹا نوڈ/Python سرور) کے ساتھ سامنے رکھیں جو کہ آگے بھیجنے سے پہلے توثیق اور شرح کو محدود کرتا ہے۔
11434. - Docker ڈیسک ٹاپ میں Open WebUI چلائیں۔ مسلسل حجم کے ساتھ؛ اسے مقامی Ollama اختتامی نقطہ پر اشارہ کریں۔
- بیک اپس RAG ڈیٹا بیس کے لیے ایک خفیہ کردہ بیرونی SSD یا ٹائم مشین کے ہدف کے لیے۔
- خودکار اپ ڈیٹ میکوس اور ہومبریو پیکجز ایک شیڈول پر؛ Ollama اور ماڈل ورژنز کو خودکار تازہ ترین کھینچنے کے بجائے جان بوجھ کر پن کریں۔
اچھا کیا، آپ کے پاس ایک پرائیویٹ، آڈٹ کے لیے دوستانہ AI اینڈ پوائنٹ ہے جسے آپ کی ٹیم ہر روز استعمال کرتی ہے اور جو کبھی بھی عمارت کے نیٹ ورک کو ٹوکن نہیں بھیجتی ہے۔
13. نتیجہ: میز پر ایک خاموش انقلاب
2026 میں Mac Studio M4 Max کو ان باکس کرنا ایک ڈیسک ٹاپ خریدنے جیسا کم محسوس ہوتا ہے اور ایک چھوٹا AI آلات خریدنے جیسا لگتا ہے جو کہ میک بھی ہوتا ہے۔ یونیفائیڈ میموری کے 128 GB، 40 GPU cores، 16 CPU cores، ایک نیورل انجن، ہارڈویئر میڈیا انکوڈرز، ایک 2 TB SSD، اور ایک بیکار پاور ڈرا جس کی پیمائش سنگل واٹس میں ہوتی ہے - یہ سب ایک باکس میں ہے جسے آپ ایک ہاتھ سے اٹھا سکتے ہیں۔
سیٹ اپ تیز ہے، پہلا LLM ایک گھنٹے کے اندر چل رہا ہے، اور ایک دوپہر کے اندر آپ کے پاس ایک پرائیویٹ RAG پائپ لائن ہے جو آپ کے اپنے دستاویزات پر سوالات کا جواب دیتی ہے۔ پوری چیز آپ کی میز پر ہوتی ہے، پس منظر میں کوئی کلاؤڈ بل ٹک اپ نہیں ہوتا ہے۔ یہ تبدیل کرتا ہے کہ آپ کس طرح AI کے ساتھ اس طرح سے بناتے ہیں جب تک کہ آپ اسے آزمانے تک پہنچانا مشکل ہو۔
اگر آپ اس بات کا جائزہ لے رہے ہیں کہ آیا آپ کی ٹیم کے ہارڈویئر مکس میں Mac Studio کا تعلق ہے، تو مجھے امید ہے کہ اس مضمون نے آپ کو ایک بنیادی نظریہ دیا ہے: کیا حیرت انگیز ہے، کیا کھردرا ہے، جہاں بادل اب بھی جیتتا ہے، اور جہاں آپ کی میز پر موجود باکس بہتر جواب ہے۔ ساتھی ۔ مختصر بلاگ اسی ورک فلو کو شیئر کرنے کے لیے 5 منٹ کی پڑھائی میں ڈسٹل کرتا ہے۔
اگر یہ مفید تھا۔ - یوٹیوب پر ان باکسنگ دیکھیں (https://youtube.com/shorts/HUlUoHNsyNM)، فالو اپ ٹیوٹوریلز (MLX فائن ٹیوننگ، ملٹی میک انفرنس، ایجنٹ اسٹیک) کے لیے چینل کو سبسکرائب کریں، اور سیریز کے اگلے مضمون کے لیے یہاں دوبارہ چیک کریں۔ Apple Silicon پر مقامی AI ابھی شروع ہو رہا ہے، اور میں اسٹیک کے پختہ ہونے پر لکھتا رہوں گا۔
اس مضمون کے لیے SEO سنیپ شاٹ
- SEO عنوان: ان باکسنگ Mac Studio M4: اپنا پہلا LLM مقامی طور پر چلائیں۔
- میٹا تفصیل: Mac Studio M4 Max کو 128 GB متحد میموری کے ساتھ ان باکس کریں، Ollama انسٹال کریں، Llama 3 کو مقامی طور پر چلائیں، اور ایک نجی RAG پائپ لائن بنائیں۔ حقیقی پڑھنا، ایماندارانہ موازنہ۔
- بنیادی مطلوبہ الفاظ: Mac Studio AI، Mac Studio LLM، Mac Studio پر LLMs چلانا، Ollama Mac Studio، Apple Silicon AI، مقامی AI سیٹ اپ، Mac Studio RAG، مقامی LLM ٹیوٹوریل، Llama مقامی طور پر چلائیں، Mac Studio M4 جائزہ۔
- ٹویٹر / ایکس (280 حروف سے کم): ایک Mac Studio M4 Max کو ان باکس کیا۔ 128 GB یونیفائیڈ میموری۔ Ollama کے ذریعے 6.48 W. Pulled Llama 3.1 8B پر بیکار، ایک دوپہر میں ایک مقامی RAG پائپ لائن بنائی، کوئی کلاؤڈ بل نہیں۔ مکمل 4000 الفاظ کا واک تھرو + 6 خاکے + YouTube شارٹ۔ #AppleSilicon #LocalLLM
- لنکڈ ان پوسٹ: نیا Mac Studio M4 Max میری میز پر اترا اور میں نے اس کے ساتھ ایک AI آلات کی طرح سلوک کیا: mactop سے حقیقی ریڈنگ (6.48 W idle, 128 GB UMA, 40 GPU cores)، Ollama انسٹال، Llama 3.1 8B مقامی طور پر چل رہا ہے، ایک مکمل RAG پائپ لائن کے خلاف میری اپنی ایک دوپہر میں - میں نے پورا ورک فلو لکھا، چھ اصل خاکوں کے ساتھ، ایک ایماندار کلاؤڈ بمقابلہ مقامی فیصلہ میٹرکس، اور ایک سیکشن جہاں بادل اب بھی جیتتا ہے۔ اگر آپ اپنی ٹیم کے لیے مقامی AI کا جائزہ لے رہے ہیں، تو یہ شروع کرنے کے لیے ایک بنیادی جگہ ہے۔