Moonshot AI کا Kimi K3 نے open weights ایجاد نہیں کیے — Llama، DeepSeek، Qwen اور دیگر پہلے ہی اس زمرے کو ثابت کر چکے ہیں۔ جولائی 2026 کے آخر میں جو بدلا وہ یہ ہے کہ تقریباً 2.8 ٹریلین پیرامیٹرز، 1M-ٹوکن سیاق اور day-0 پروڈکشن serving والا open-weight ماڈل اب ان agent ورک لوڈز پر مقابلہ کر رہا ہے جو پہلے Anthropic اور OpenAI کے لیے محفوظ تھے۔ یہ Workstation گائیڈ ڈویلپرز اور ٹیک لیڈرز کے لیے ہے جنہیں فیصلہ چاہیے: self-host، managed API، یا hybrid — اور کون سے دیگر open ماڈلز ریڈار پر ہوں۔
1. Moonshot نے کیا شپ کیا
Moonshot کے GitHub اور تکنیکی مواد کے مطابق (weights عوامی ~27 جولائی 2026):
- Kimi K3 — open-weight، نیٹو ملٹی موڈل agentic ماڈل؛ کل ~2.8T پیرامیٹرز (MoE)۔
- آرکیٹیکچر ہائی لائٹس: Kimi Delta Attention (KDA)، Attention Residuals (AttnRes)، Stable LatentMoE؛ sparse expert ایکٹیویشن (ترتیب 896 میں سے 16 experts / فی ٹوکن ~100B-کلاس فعال params — لائیو model card پر تصدیق کریں)۔
- 1M-ٹوکن سیاق؛ vision + tool use + long-horizon coding/knowledge work۔
- Weights: Hugging Face
moonshotai/Kimi-K3(عام طور پر MXFP4؛ footprint ~1.4TB)۔ - Day-0 inference انجنز: vLLM، SGLang، TokenSpeed؛ hosted API platform.kimi.ai پر۔
لائسنس: Kimi K3 License — سب کے لیے مفت SaaS اجازت نہیں۔ Enterprises اور Model-as-a-Service فراہم کنندگان کو پروڈکٹ بنانے سے پہلے قانونی جائزہ لینا چاہیے (VentureBeat اور آزاد تحریروں نے تجارتی حدیں نوٹ کیں)۔ Open weights ≠ ہر کاروباری ماڈل کے لیے کھلا۔
2. کیا یہ Anthropic اور OpenAI کے ساتھ قدم ملا سکتا ہے؟
بلڈرز کے لیے مختصر جواب: کئی agent-متعلق benches پر، ہاں — اتنی قریب کہ ڈیفالٹ اب «صرف closed» نہیں رہنا چاہیے۔
لانچ کے بعد community اور vendor جائزوں نے K3 کو SWE-bench Verified اور LiveCodeBench-طرز suites پر سرکردہ proprietary ماڈلز کے اسی بینڈ میں رکھا، Claude Sonnet اور GPT-4o-class baselines کے مقابلے میں مسابقتی tool-use کے ساتھ۔ یہی سنگ میل ہے: open weights agent کاموں پر بار عبور کر رہے ہیں، صرف MMLU trivia نہیں۔
Caveats جن پر Workstation زور دیتا ہے:
- بینچ مارکس harness-حساس ہیں — اپنا golden set چلائیں۔
- p50 latency فتح multi-tool agent chains پر p95/p99 درد چھپا سکتی ہے۔
- Closed labs اب بھی product polish، safety tooling اور support SLAs میں آگے ہیں۔
- Hybrid routing (نجی ڈیٹا کے لیے open + peak-critical کے لیے closed) عملی آرکیٹیکچر رہتا ہے۔
3. انفرا مہینوں نہیں، دنوں میں کیوں ہلی
حکمتِ عملی کی تبدیلی serving کی پختگی ہے:
- vLLM نے day-0 پروڈکشن رہنمائی شائع کی: KDA-aware prefix caching، NVIDIA/AMD kernels، prefill/decode disaggregation، speculative decoding (DSpark draft models)، tool calling، structured output۔
- Cloud inference engines اور hyperscalers (بشمول AWS SageMaker HyperPod / EKS recipes) نے weights آنے کے اسی ہفتے deploy راستے شائع کیے۔
- نتیجہ: self-host بمقابلہ managed بڑھتے ہوئے ایک config اور FinOps فیصلہ ہے، سہ ماہی تحقیقاتی منصوبہ نہیں — اگر آپ کے پاس پہلے سے GPU صلاحیت اور MLOps muscle ہو۔
4. ہارڈویئر حقیقت (چھوڑیں نہیں)
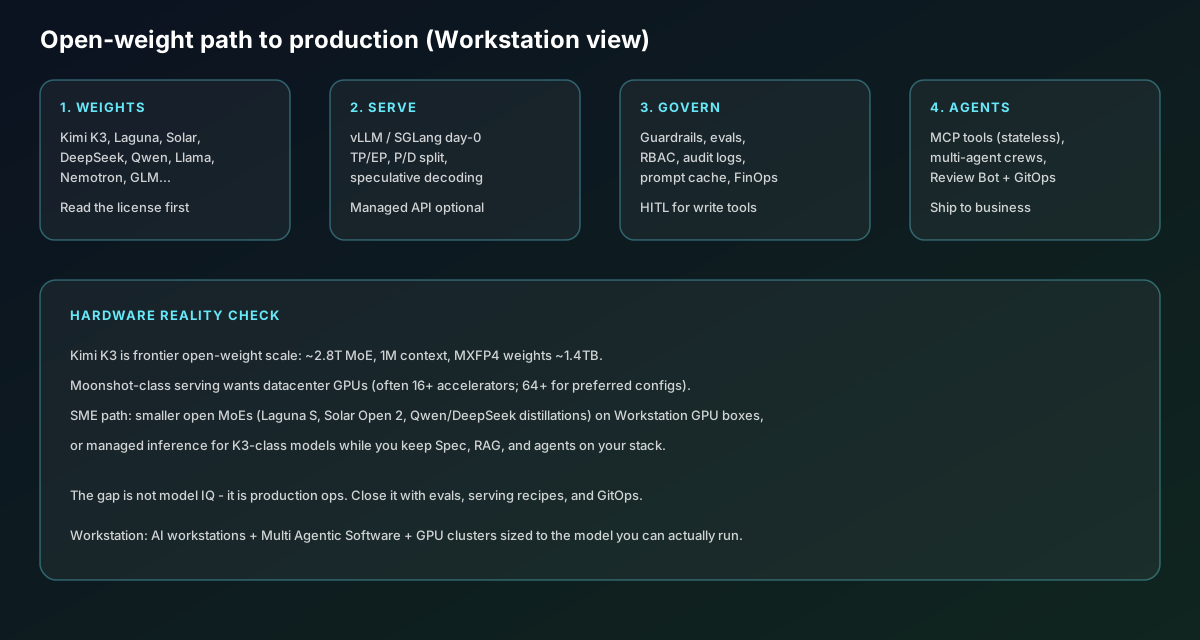
K3 لیپ ٹاپ ماڈل نہیں ہے۔ Moonshot-مبنی رہنمائی datacenter-scale ڈپلائمنٹس کی طرف اشارہ کرتی ہے (شائع شدہ vLLM notes میں اکثر کم از کم معتبر راستہ 16+ high-end GPUs؛ پسندیدہ configs 64+ accelerators تک)۔ صرف weights ہی terabyte-کلاس ہیں۔
SME / mid-market راستہ: Workstation AI boxes پر چھوٹے open MoE چلائیں؛ جب اس IQ کی ضرورت ہو تو managed API سے K3 کال کریں؛ RAG corpora اور agents نجی رکھیں۔
Enterprise راستہ: GPU cluster + vLLM/SGLang + GitOps + evals — یا managed capacity خریدیں اور kernels کی بجائے agent پرت میں انجینئرنگ لگائیں۔
ویڈیو: عملی vLLM کلاؤڈ serve واک تھرو — K3-کلاس نوڈ سائز کرنے سے پہلے مفید۔
5. پالیسی اور سیکیورٹی پس منظر
اسی ونڈو میں NVIDIA اور پارٹنرز نے Open Secure AI Alliance کو آگے بڑھایا اور Open Weights and American AI Leadership خط کو وسعت دی (270+ orgs)۔ دلیل: open weights صرف معاشیات کی کہانی نہیں — defenders کو agents اور سافٹ ویئر سپلائی چینز کا red-team کرنے کے لیے قابلِ معائنہ ماڈلز چاہییں۔ openness کو evals، guardrails اور تیز پیچ کلچر سے جوڑیں — wishful «open ماڈلز پر پابندی» نہیں۔
6. MCP stateless ہو گیا (agents کو کیوں فرق پڑتا ہے)
MCP 2026-07-28 تخصیص لانچ کے بعد سب سے بڑی پروٹوکول ریویژن ہے:
- initialize handshake اور
Mcp-Session-Idہٹاتی ہے — درخواستیں_metaمیں version/capabilities لے جاتی ہیں۔ - سادہ load balancer کے پیچھے کوئی بھی instance کوئی بھی درخواست سرور کر سکتا ہے (کوئی sticky Redis session ٹیکس نہیں)۔
- OAuth/OIDC کے ساتھ سخت auth alignment؛ رسمی ~12-ماہ deprecation پالیسی۔
- ایکسٹینشنز: MCP Apps (server-rendered UIs)، MCP Tasks (پائیدار long-running job handles)۔
Workstation multi-agent stacks کے لیے، stateless MCP کا مطلب ہے کہ tool fleets عام HTTP microservices کی طرح اسکیل کرتے ہیں — وہ گم شدہ ٹکڑا جب open ماڈلز آخرکار agent-grade IQ پاتے ہیں۔
7. پروڈکشن گیپ (اب بھی اصل کہانی)
صنعتی سروے (بشمول Mozilla کی open-source AI رپورٹنگ) ایک پیٹرن دہراتے رہتے ہیں: ڈویلپرز اعلیٰ شرح پر open weights آزماتے ہیں، مگر closed-API ٹیموں کے مقابلے میں چھوٹا حصہ پروڈکشن تک پہنچتا ہے — اور گیپ اکثر کمپنی کے سائز کے ساتھ بڑھتا ہے۔ Closed vendors پکی سڑک بیچتے ہیں؛ open ماڈلز اب بھی چاہتے ہیں کہ آپ serving، scaling، observability اور security کے مالک ہوں۔ Kimi K3 چھت اٹھاتا ہے؛ یہ کام کے ops آدھے حصے کو مٹاتا نہیں۔
8. ہمارے ریڈار پر ماڈلز (توسیع شدہ)
K3 سے آگے، Workstation agentic coding اور نجی AI stacks کے لیے اس open / semi-open سیٹ کو دیکھ رہا ہے (procurement سے پہلے لائسنس اور benches تصدیق کریں):
| ماڈل | کیوں اہم | Fit |
|---|---|---|
| Kimi K3 (Moonshot) | 2.8T MoE، 1M ctx، frontier open agent coding | Cluster / managed API |
| Laguna S 2.1 (Poolside) | 118B-A8B MoE، 1M ctx، مضبوط Terminal/SWE benches، OpenMDW | Self-host SWE agents |
| Solar Open 2 (Upstage) | 250B-A15B، 1M ctx، agentic office/coding، KR sovereign زاویہ | 4–8× H200 class |
| DeepSeek-V4 family | reasoning/coding price-performance پر مسلسل open MoE دباؤ | Cost-sensitive agents |
| Qwen 3.x / Max (Alibaba) | وسیع کثیر لسانی + tool ecosystem؛ workstations کے لیے distillations | Default open stack |
| Llama 4 class (Meta) | اجازت مند ecosystem، عظیم fine-tune/community tooling | Fine-tunes / RAG |
| Nemotron 3 (NVIDIA) | NVIDIA serving/security کہانی سے ہم آہنگ open weights | GPU-native estates |
| GLM-4.x / 5 (Zhipu) | مضبوط agent/tooling نسب؛ لائسنس + hosting علاقہ دیکھیں | Tool-heavy agents |
| KAT-Coder-V2.5 (Kwaipilot) | ~35B-A3B MoE coding ماہر؛ Apache 2.0؛ SWE-bench سائز | Workstation SWE |
| Mistral Large / Magistral | EU-دوستانہ commercial open اختیارات؛ مضبوط tooling کہانی | EU private AI |
| Gemma 3 (Google) | edge اور on-device کے لیے موثر open ماڈلز | Edge / Mac Silicon |
| Phi-4 class (Microsoft) | constrained boxes کے لیے چھوٹے، قابل reasoners | SME workstations |
| Mage-Flow (Microsoft) | کمپیکٹ ~4B text-to-image / edit؛ MIT؛ بڑے diffusion stacks کا حریف | Local creative |
| Inflect v2 (Owen Song) | Tiny local English TTS (Nano/Micro)؛ Apache 2.0 | Offline voice |
| Claude Opus 5 / Fable 5 (closed) | Bedrock پر کئی coding/agent راستوں کے لیے اب بھی quality ceiling | Hybrid peak path |
| GPT-5.6 Sol/Terra/Luna (closed) | router designs کے لیے tiered closed inference | Managed failover |
9. عملی پیٹرنز جو Workstation تجویز کرتا ہے
Private RAG + tools on open weights (Qwen / Laguna / Solar / DeepSeek)
        │
        ├─ Lead planner on K3 API or Opus 5 (Bedrock) when stuck
        ├─ Builders on mid open MoE self-hosted
        ├─ Review Bot + human gate
        └─ GitOps promote
- ADR لکھیں: ڈیفالٹ open ماڈل + failover closed ماڈل۔
- پروڈکشن پلٹنے سے پہلے golden eval set (50–100 کام)۔
- multi-tool agent chains پر p95/p99 ناپیں — صرف median TTFT نہیں۔
- Prompt-cache احتیاط سے (prompt کے اوپر UUID hit rates تباہ کر سکتا ہے)۔
- افقی اسکیل سے پہلے MCP servers کو 2026-07-28 پر اپ گریڈ کریں۔
- GPUs کو اس ماڈل کے مطابق سائز کریں جو آپ واقعی سرور کریں گے — بلاگ ہیڈ لائن کے مطابق نہیں۔
10. اختتام
Kimi K3 ایک proof point ہے: open weights اب frontier agent کام کو چیلنج کرتے ہیں، اور serving ecosystem (vLLM، SGLang، cloud recipes) دنوں میں رفتار رکھ رہا ہے۔ پالیسی گروپ دلیل دیتے ہیں کہ open ماڈلز سائبر دفاع کا حصہ ہیں، صرف لاگت کنٹرول نہیں۔ کاروباروں کے لیے جیتنے والا قدم Workstation-grade ہارڈویئر اور Multi Agentic Software پر hybrid router ہے — جہاں privacy اور لاگت غالب ہوں وہاں open، جہاں quality SLA مانگیں وہاں closed، MCP، evals اور GitOps کے ساتھ تاکہ «ہم نے open ماڈل آزمایا» بن جائے «ہم open ماڈلز پر ship کرتے ہیں»۔
Workstation کی طرف سے شائع۔ Specs اور benches ہفتہ وار بدلتے ہیں — silicon خریدنے سے پہلے model cards، لائسنس اور علاقائی پالیسی دوبارہ چیک کریں۔


