
Workstation บทสรุปทางเทคนิค: วิธีเปิดเผยปัญหาคอขวดของ LLM และหลายเอเจนต์ OpenTelemetry, Prometheus/Grafana/Thanos และแพลตฟอร์ม LLM เช่น แลงฟิวส์ / LMNR — รวมถึงสแปนสคีมา การระบุแหล่งที่มาของต้นทุน การสุ่มตัวอย่าง และขีดจำกัดการใช้งานหนัก สหาย: บล็อกธุรกิจ · ให้บริการ: เทอร์โบชาร์จเจอร์ LLM · ห้องปฏิบัติการ: ห้องปฏิบัติการ AI ขององค์กร.
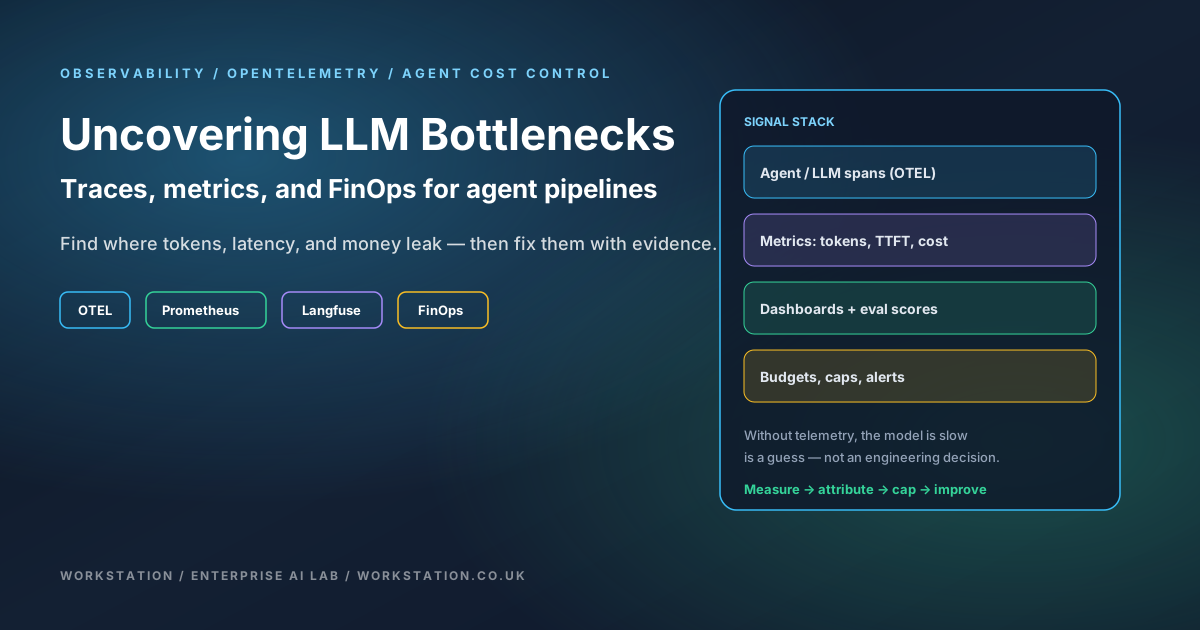
- ปัญหา: ต้นทุนและเวลาแฝงของตัวแทนซ่อนอยู่ในกระโดด (LLM → เครื่องมือ → RAG → ลองใหม่) ไม่ใช่ในตัวชี้วัด “โมเดลช้า” เดียว
- มาตรฐาน: เครื่องมือที่มี OpenTelemetry; สคีมาแอตทริบิวต์หนึ่งรายการสำหรับโทเค็น โมเดล ผู้เช่า เส้นทาง ประมาณ_ต้นทุน_usd
- เส้นทางเมตริก: Prometheus (+ Thanos) สำหรับสัญญาณทองคำ Grafana สำหรับบอร์ด SLO และ FinOps
- เส้นทาง LLM: Langfuse/LMNR สำหรับการติดตาม คะแนน ชุดข้อมูล เวอร์ชันพร้อมท์
- ควบคุม: โทเค็นหมวก การเรียกใช้เครื่องมือ และรอบการแก้ไขข้อบกพร่อง โมเดลเส้นทางตามความยากของขั้นตอน
- ชนะ: วัดต้นทุนต่องานที่ประสบความสำเร็จก่อนที่คุณจะซื้อ GPU เพิ่มหรือเพิ่มโควต้า API
1. “คอขวด” หมายถึงอะไรสำหรับตัวแทน LLM
ปัญหาคอขวดของเวลาการฝึกอบรม (ข้อมูล, FLOP) แตกต่างจากเวลาให้บริการและ เวลาตัวแทน คอขวด ในตัวแทนการผลิต รูปแบบของเสียหลักคือ:
- บวมทันที — ข้อความเตือนของระบบขนาดใหญ่เกินไป บริบทที่ไม่ได้ใช้ซ้ำ คำนำหน้า/การเข้าถึงแคชหายไป
- โมเดลเกินกำลัง — โมเดลชายแดนใช้สำหรับจำแนก/กำหนดเส้นทางที่โมเดลขนาดเล็กสามารถทำได้
- ลูปไม่มีขอบเขต — การลองใช้เครื่องมือใหม่และรอบการแก้ไขข้อบกพร่องด้วยตนเองโดยไม่ต้องใช้งบประมาณจำนวนมาก (ดูการแลกเปลี่ยน Self-Debugging ใน เทอร์โบชาร์จเจอร์ LLM).
- ภายนอกรออยู่. — vector DB, SaaS APIs และเกทแบบ human-in-the-loop มีสาเหตุมาจาก “LLM latency” ไม่ถูกต้อง
- ให้บริการแบบกระจายตัว — KV cache เสียบน GPU (อาณาเขต PagedAttention/vLLM) หลังจากที่คุณยืนยันแล้วว่ากราฟตัวแทนมีความเหมาะสม
หากไม่มีร่องรอยแบบกระจาย คุณจะไม่สามารถแยกสิ่งเหล่านี้ออกได้ ความสามารถในการสังเกตจึงไม่ใช่แดชบอร์ดที่ดีที่จะมี แต่เป็นระนาบควบคุมสำหรับ FinOps และ SRE ในผลิตภัณฑ์ AI
2. สถาปัตยกรรมอ้างอิง
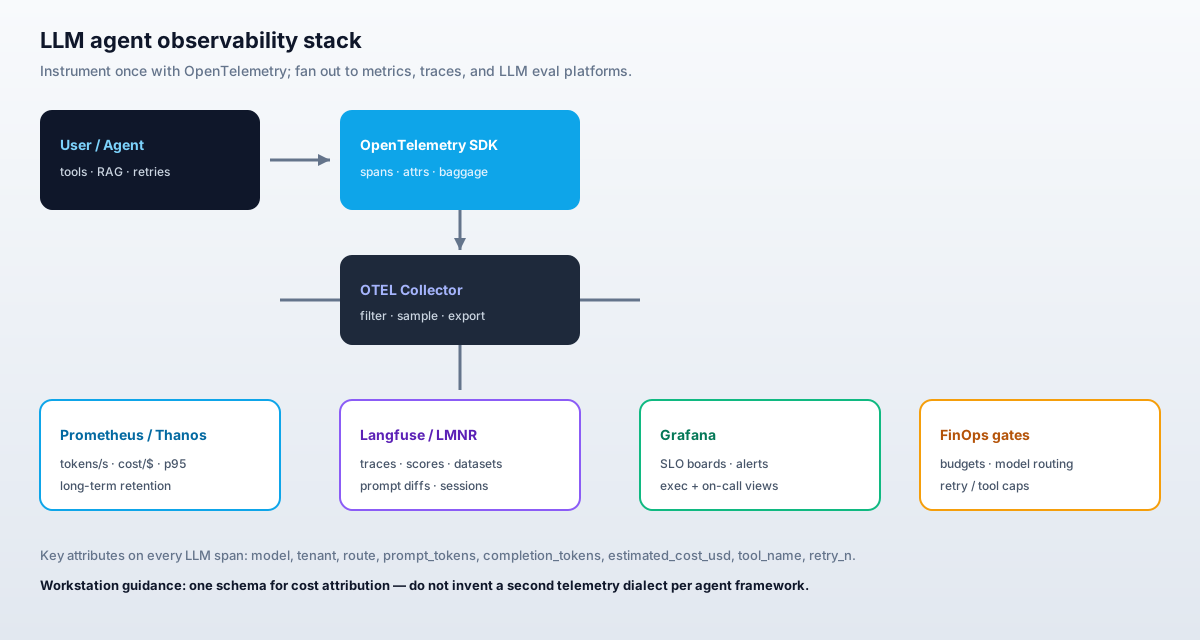
User / Orchestrator
    → Agent runtime (tools, RAG, LLM calls)
        → OpenTelemetry SDK (spans + metrics)
            → OTEL Collector (filter, sample, redact)
                ├─→ Prometheus / Thanos   (rates, costs, SLOs)
                ├─→ Grafana              (boards, alerts)
                └─→ Langfuse / LMNR      (traces, scores, datasets)
FinOps / policy layer reads the same metrics to enforce caps and model routing.
3. สคีมาการขยาย OpenTelemetry สำหรับการโทร LLM
ใช้แบบแผนเดียวข้ามเฟรมเวิร์ก (LangChain, เอเจนต์ Go/Python แบบกำหนดเอง, Bedrock SDK) ต้องการแบบแผนเชิงความหมายหากมีอยู่ และขยายด้วยแอตทริบิวต์ Workstation ที่เสถียร:
| คุณลักษณะ | ตัวอย่าง | ทำไม |
|---|---|---|
gen_ai.system | openai / มานุษยวิทยา / ข้อเท็จจริง / vllm | การยกเลิกของผู้ให้บริการ |
gen_ai.request.model | claude-sonnet-4 / llama-3.1-8b | ราคาและคุณภาพตามรุ่น |
gen_ai.usage.input_tokens | 1820 | โปรแกรมควบคุมต้นทุนที่รวดเร็ว |
gen_ai.usage.output_tokens | 410 | ตัวขับเคลื่อนต้นทุนความสำเร็จ |
wsw.estimated_cost_usd | 0.0124 | FinOps โดยไม่ต้องเข้าร่วมแผ่นราคาในภายหลัง |
wsw.tenant_id | จุดสุดยอด-ผลิตภัณฑ์ | การปฏิเสธการชำระเงิน |
wsw.route | support.triage | การระบุแหล่งที่มาของคุณลักษณะผลิตภัณฑ์ |
wsw.agent_step | แผน/เครื่องมือ/คำวิจารณ์ | ค้นหาขั้นตอนที่มีราคาแพง |
wsw.retry_n | 2 | การตรวจจับลูป |
wsw.prompt_version | ไตรเอจ@v17 | การเชื่อมโยงการถดถอย |
from opentelemetry import trace
from opentelemetry.trace import Status, StatusCode

tracer = trace.get_tracer("workstation.agents")

PRICE_IN = 0.003 / 1000   # example $/token — load from config
PRICE_OUT = 0.015 / 1000

def complete_llm(model: str, prompt: str, tenant: str, route: str):
    with tracer.start_as_current_span("gen_ai.chat") as span:
        span.set_attribute("gen_ai.system", "openai")
        span.set_attribute("gen_ai.request.model", model)
        span.set_attribute("wsw.tenant_id", tenant)
        span.set_attribute("wsw.route", route)
        try:
            resp = client.chat.completions.create(
                model=model,
                messages=[{"role": "user", "content": prompt}],
            )
            usage = resp.usage
            cost = usage.prompt_tokens * PRICE_IN + usage.completion_tokens * PRICE_OUT
            span.set_attribute("gen_ai.usage.input_tokens", usage.prompt_tokens)
            span.set_attribute("gen_ai.usage.output_tokens", usage.completion_tokens)
            span.set_attribute("wsw.estimated_cost_usd", round(cost, 6))
            return resp.choices[0].message.content
        except Exception as e:
            span.record_exception(e)
            span.set_status(Status(StatusCode.ERROR, str(e)))
            raise
ฝึกฝน: คำนวณ estimated_cost_usd ที่ช่วง อย่ารองานกลางคืนเพื่อเข้าร่วมการนับโทเค็นในใบราคา — เจ้าของผลิตภัณฑ์และทางโทรศัพท์ต้องการ FinOps แบบสด
3บี ลำดับชั้นและสัมภาระของช่วงหลายตัวแทน
กราฟตัวแทนจำเป็นต้องมีโมเดลพาเรนต์/รองที่เสถียร ดังนั้นต้นทุนจึงจะเพิ่มขึ้นอย่างถูกต้อง:
session (root)
  └─ agent.run {wsw.route, wsw.tenant_id}
       ├─ rag.retrieve {wsw.agent_step=retrieve}
       ├─ gen_ai.chat {wsw.agent_step=plan, model=…}
       ├─ tool.execute {tool=…, wsw.retry_n}
       ├─ gen_ai.chat {wsw.agent_step=synthesize}
       └─ eval.score {score.name, score.value}
- หนึ่งรูทต่องานของผู้ใช้ — ไม่ใช่ต่อการโทร LLM ค่าใช้จ่ายเซสชัน = ผลรวมของเด็ก
wsw.estimated_cost_usd. - สัมภาระ — เผยแพร่
wsw.tenant_idและwsw.routeข้ามผู้ปฏิบัติงาน/คิวแบบอะซิงก์ ดังนั้นช่วงเครื่องมือจึงสืบทอดป้ายกำกับการปฏิเสธการชำระเงินโดยไม่ต้องเปลี่ยนท่อทุกไซต์การโทร - ลิงค์ — เมื่อตัวแทนย่อยเริ่มการติดตามใหม่ (เช่น ผู้บริโภคคิวที่แยกจากกัน) ให้ใช้ลิงก์ขยายกลับไปยังเซสชันหลักเพื่อให้ Langfuse/Grafana ยังสามารถต่อกราฟได้
- ตัวอย่างค่าใช้จ่ายสูงเสมอ — การสุ่มตัวอย่างส่วนหัวที่ 5–20% นั้นใช้ได้สำหรับเส้นทางที่มีความสุข บังคับตัวอย่างเมื่อการใช้จ่ายเซสชันเกินเกณฑ์หรือสถานะ=ข้อผิดพลาด
4. ตัวชี้วัดที่สำคัญ (โพร)
ส่งออกฮิสโตแกรมและตัวนับ (ผ่านตัวชี้วัด OTEL หรือไคลเอนต์ Prometheus) ชุดขั้นต่ำที่เป็นไปได้:
llm_requests_total{model,route,status}llm_tokens_total{model,direction}โดยที่ทิศทาง ∈ {อินพุตเอาต์พุต}llm_estimated_cost_usd_total{model,tenant,route}llm_ttft_seconds/llm_e2e_secondsฮิสโตแกรมagent_tool_calls_total{tool,status}agent_retries_total{route}agent_task_success_total{route}— ตัวส่วนของต้นทุนต่อความสำเร็จ
ข้อความค้นหา FinOps ที่ได้รับ (ภาพร่าง PromQL):
# Cost per successful task (last 1h), by route
sum(rate(llm_estimated_cost_usd_total[1h])) by (route)
  /
sum(rate(agent_task_success_total[1h])) by (route)

# Retry tax
sum(rate(agent_retries_total[1h])) by (route)
  /
sum(rate(llm_requests_total[1h])) by (route)
ธานอส (หรือ Mimir/Cortex) มีความสำคัญเมื่อ Finance ขอการใช้จ่ายแบบจำลองแบบไตรมาสต่อไตรมาส Prometheus ในพื้นที่เพียงอย่างเดียวก็ใช้ได้สำหรับการโทร ไม่ใช่ไฟล์เก็บถาวร FinOps
5. บอร์ด Grafana และการแจ้งเตือน
จัดส่งผู้ชมสามคนจากแหล่งข้อมูลเดียว:
- เมื่อโทร: อัตราข้อผิดพลาด, p95 e2e, ความล้มเหลวในการพึ่งพา (เวกเตอร์ DB / เครื่องมือ)
- แพลตฟอร์ม: โทเค็น/วินาที, ยูทิลิตี้ GPU (หากโฮสต์ด้วยตนเอง), ความลึกของคิว, TTFT
- FinOps / ผลิตภัณฑ์: $/ความสำเร็จตามผู้เช่าและเส้นทาง ข้อความแจ้งที่มีราคาแพงที่สุด การผสมผสานโมเดล
เตือนเรื่องการเผาไหม้ ไม่ใช่ความไร้สาระ:
- ราคาต่อความสำเร็จ > งบประมาณ SLO สำหรับ 30 ล้าน
- อัตราการลองซ้ำ > 15% สำหรับเส้นทาง
- p95 e2e ละเมิดด้วยโทเค็นอินพุตที่เพิ่มขึ้น (การถดถอยพร้อมท์)
6. แพลตฟอร์มดั้งเดิม LLM: Langfuse, LMNR และเพื่อน ๆ
ตัวชี้วัดบอกคุณ ที่ ต้นทุนถูกแทง; แพลตฟอร์ม LLM บอกคุณ พรอมต์เวอร์ชันใด และ ช่วงเครื่องมือใด ทำมัน แลงฟิวส์ และ LMNR เป็นตัวอย่างโอเพ่นซอร์สของคลาสนี้:
- การติดตามแบบลำดับชั้น (เซสชัน → เอเจนต์ → LLM / ช่วงเครื่องมือ)
- คะแนนมนุษย์และ LLM ในฐานะผู้ตัดสิน
- ชุดข้อมูลสำหรับการประเมินแบบออฟไลน์เมื่อคุณเปลี่ยนพร้อมท์
- การวัดและส่งข้อมูลทางไกลการใช้งานเสริมสำหรับการปรับปรุงผลิตภัณฑ์ (เคารพนโยบายความเป็นส่วนตัว)
รูปแบบการรวมระบบ: ให้ OTEL เป็นระบบบันทึก SRE การส่งออกแบบคู่หรือเชื่อมต่อเข้ากับ Langfuse เพื่อวิศวกรรมที่รวดเร็ว อย่าสร้างพจนานุกรมคุณลักษณะที่สองที่เข้ากันไม่ได้
การทดลองเฟรมเวิร์ก เช่น รันไทม์ของเอเจนต์ที่เน้นฟังก์ชันเป็นอันดับแรก (ในอดีตทำการตลาดโดยใช้เอเจนต์การสตรีมแบบมีโครงสร้าง) สามารถลดขนาดสำเร็จรูปได้ แต่ถือว่าเฟรมเวิร์กเฉพาะเป็นทางเลือก — มาตรฐานความสามารถในการสังเกตยังคงอยู่ได้นานกว่า
7. ไปป์ไลน์การให้คะแนน: แบบแมนนวลและแบบอัตโนมัติ
| วิธี | การนำไปปฏิบัติ | โหมดความล้มเหลว |
|---|---|---|
| คู่มือ | Thumbs / rubrics ใน Langfuse UI; รีวิวชุดทอง. | ไม่ปรับขนาด ยังคงจำเป็นสำหรับการสอบเทียบ |
| อัตโนมัติ | LLM-ในฐานะผู้พิพากษา, การตรวจสอบหน่วย, เครื่องมือตรวจสอบสคีมา, การเรียกคืนข้อมูล | ผู้พิพากษาดริฟท์; การเล่นเกมหากปรับให้เหมาะสมสำหรับผู้ตัดสินเท่านั้น |
แนบคะแนนเป็นเหตุการณ์ช่วงหรือคะแนน Langfuse ที่คีย์โดย wsw.prompt_version. การเลื่อนระดับของการแจ้งเตือนแบบเดียวกับที่คุณเกตเวอร์ชันแอป — Ring Promoter สำหรับโค้ด; ประตูประเมินสำหรับการแจ้งเตือน
8. กระบวนการประหยัดต้นทุน (รายละเอียด)
- สัปดาห์พื้นฐาน: ไม่มีการเปลี่ยนแปลงพฤติกรรม เครื่องมือวัดเท่านั้น จับ $/ความสำเร็จ โทเค็น/ความสำเร็จ อัตราการลองใหม่
- การแสดงที่มา: จัดอันดับเส้นทางด้วยการใช้จ่าย × ปริมาณ เลือกสามอันดับแรก
- การกำหนดเส้นทางโมเดล: แยกประเภท/แยกเป็นรุ่นขนาดเล็ก/ท้องถิ่น รักษาขอบเขตสำหรับการสังเคราะห์ วัดคะแนนคุณภาพอีกครั้ง
- การผ่าตัดด่วน: ลบสกีมาเครื่องมือที่ไม่ได้ใช้ ย่อภาพสองสามภาพให้สั้นลง เปิดใช้งานแคชคำนำหน้าที่ปลอดภัย
- หมวกห่วง: การเรียกเครื่องมือสูงสุด, รอบการดีบักตัวเองสูงสุด, การถอยกลับแบบเอกซ์โปเนนเชียลพร้อมเซอร์กิตเบรกเกอร์
- การสุ่มตัวอย่าง: เก็บตัวชี้วัด 100%; การติดตามตัวอย่าง (เช่น 5–20%) บวกกับการสุ่มตัวอย่างตลอดเวลาสำหรับข้อผิดพลาดและเซสชันที่มีค่าใช้จ่ายสูง
- การแก้ไข: ตัด PII ออกจากแอตทริบิวต์ span ก่อนส่งออก จัดเก็บพร้อมท์แบบเต็มเฉพาะในร้านค้าที่ได้รับอนุมัติด้วย TTL
- จังหวะการทบทวน: บอร์ด FinOps รายสัปดาห์ การสอบเทียบผู้พิพากษารายเดือนกับมนุษย์
8ข. การจัดการการใช้งานตัวแทนด้วยงบประมาณปัจจุบัน
แดชบอร์ดเพียงอย่างเดียวไม่ได้หยุดเอเจนต์ที่ควบคุมไม่ได้ บังคับใช้งบประมาณในรันไทม์ ปล่อยการตัดสินใจเป็นเหตุการณ์ช่วง และแจ้งเตือนเมื่อเซสชันถึงขีดจำกัดบ่อยครั้ง:
# Pseudocode: hard budget around an agent session
class Budget:
    def __init__(self, max_usd=0.50, max_tool_calls=8, max_llm_calls=12):
        self.max_usd, self.max_tool_calls, self.max_llm_calls = max_usd, max_tool_calls, max_llm_calls
        self.spent = 0.0
        self.tools = self.llms = 0

    def charge(self, usd: float, kind: str):
        self.spent += usd
        if kind == "tool":
            self.tools += 1
        else:
            self.llms += 1
        if self.spent > self.max_usd or self.tools > self.max_tool_calls or self.llms > self.max_llm_calls:
            raise RuntimeError("agent budget exhausted")
- ตัวพิมพ์ใหญ่ต่อเซสชัน — การเรียก USD, LLM, การเรียกเครื่องมือ (ด้านบน)
- โควต้ารายวันต่อผู้เช่า — Redis/ตัวนับคีย์โดย
wsw.tenant_id; คืนเส้นทางเสื่อมโทรมที่ถูกควบคุมเมื่อหมดแรง - นโยบายรูปแบบต่อเส้นทาง — รุ่นที่อนุญาตสำหรับ
support.triageเทียบกับlegal.draft; ปฏิเสธหรือลดระดับนโยบายและบันทึกwsw.policy_action=downshift. - ปุ่มเครื่องมือ Idempotent — เครื่องมือแฮชหาเหตุผล ดังนั้นการลองใหม่จะไม่เรียกเก็บเงิน API ภายนอกสองครั้ง
- สูตรต้นทุน —
cost = in_tokens × p_in + out_tokens × p_out + tool_fees; รีเฟรชp_in/p_outจากแผ่นราคาตามเวอร์ชัน ดังนั้นข้อมูลในอดีตของธานอสจึงสามารถเปรียบเทียบได้
ตัวชี้วัดที่น่าจับตามองหลังจากแคปลงจอด: agent_budget_exhausted_total{route,reason}. การเพิ่มขึ้นอย่างรวดเร็วหมายถึงการละเมิด การวนซ้ำของเครื่องมือที่เสียหาย หรืองบประมาณที่จำกัดเกินไปสำหรับปริมาณงานจริง
9. ร่างการกำหนดค่าตัวสะสม
# otel-collector-config.yaml (illustrative)
receivers:
  otlp:
    protocols:
      http:
      grpc:
processors:
  memory_limiter: {}
  batch: {}
  attributes/redact:
    actions:
      - key: gen_ai.prompt
        action: delete
exporters:
  prometheus:
    endpoint: "0.0.0.0:8889"
  otlp/langfuse:
    endpoint: "${LANGFUSE_OTLP_ENDPOINT}"
    headers:
      Authorization: "Bearer ${LANGFUSE_KEY}"
service:
  pipelines:
    traces:
      receivers: [otlp]
      processors: [memory_limiter, attributes/redact, batch]
      exporters: [otlp/langfuse]
    metrics:
      receivers: [otlp]
      processors: [memory_limiter, batch]
      exporters: [prometheus]
10. ข้อดี ข้อเสีย และเมื่อไม่ควรกังวล
ข้อดี: การปฏิเสธการชำระเงิน, การคัดแยกเหตุการณ์ที่เร็วขึ้น, ROI ที่วัดได้เมื่อมีการเปลี่ยนแปลงพรอมต์/โมเดล, เส้นทางการตรวจสอบที่สอดคล้องกับข้อกำหนด, ภาษาที่แบ่งปันระหว่าง ML และทีมแพลตฟอร์ม
จุดด้อย: หนี้เครื่องมือวัด ค่าใช้จ่ายในการจัดเก็บหากคุณเก็บทุกการแจ้งเตือนตลอดไป ความเสี่ยงในการจัดส่ง PII ไปยังแบ็กเอนด์ที่ไม่ถูกต้อง อีกหนึ่งคอนโซลสำหรับวิศวกรในการเรียนรู้
ข้าม (ตอนนี้) หาก: คุณมีงานแบตช์ออฟไลน์งานเดียวที่มีการใช้จ่ายรายวันคงที่ และไม่มีตัวแทนแบบโต้ตอบ ยังคงบันทึกโทเค็น ข้ามสแต็กแบ็กเอนด์หลายตัวเต็มจนกว่าการทำงานพร้อมกันจะปรากฏขึ้น
11. รายการตรวจสอบการย้ายถิ่นฐาน
- ☐ OTEL SDK ในรันไทม์ของตัวแทน ตัวสะสมในคลัสเตอร์
- ☐ คุณลักษณะ Span ประกอบด้วยโมเดล โทเค็น ต้นทุน ผู้เช่า เส้นทาง
- ☐ ตัวชี้วัด Prometheus + บอร์ด Grafana FinOps
- ☐ ต่อสาย Langfuse (หรือ LMNR) สำหรับเส้นทางวิกฤติอย่างน้อยหนึ่งเส้นทาง
- ☐ ฮาร์ดแคปบนโทเค็น / เครื่องมือ / ลองใหม่
- ☐ นโยบายการปกปิดได้รับการตรวจสอบโดยฝ่ายรักษาความปลอดภัย
- ☐ ตรวจสอบ $/ความสำเร็จรายสัปดาห์สำหรับเส้นทางยอดนิยม
- ☐ เอกสาร ADR เชื่อมโยงความสามารถในการสังเกต → การให้บริการ (vLLM) → โปรโมชั่น (Ring Promoter)
12. วัสดุ Workstation ที่เกี่ยวข้อง
- สหายบล็อกธุรกิจ
- เทอร์โบชาร์จเจอร์ LLM — แก้ไขการให้บริการหลังจากที่คุณมองเห็นปัญหาคอขวดแล้ว
- Ring Promoter — ส่งเสริมบริการตัวแทนด้วยประตูสุขภาพ
- Muse Glimmer / ตัวแทนท้องถิ่น
- ติดต่อ Workstation สำหรับการนัดหมาย Enterprise AI Lab
อ้างอิง
จัดพิมพ์โดย Workstation.


