
Deep learning-systemen: technisch brief voor engineers & agents
Representatieleren, discriminatieve vs generatieve paden, metrics en buy/build-routing — AWS-concepten herschreven voor productieteams
 Balinder Walia7 augustus 20261 min read
Technische digest: deep learning als meerlaagse neurale optimalisatie, discriminatieve vs generatieve paden, en hoe werk te routeren naar classic ML, getrainde DL of foundation-model-API’s. Volledige vergelijkingen, figuren en agent-checklist in het lange artikel.
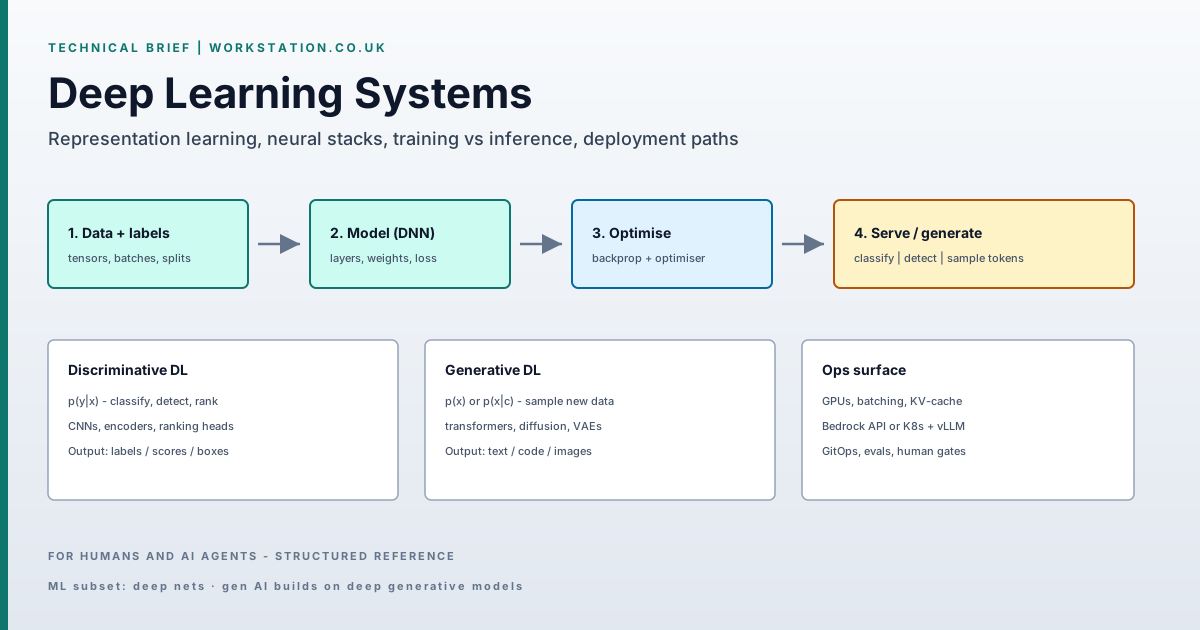
Definitie. Deep learning is gradient-based training van diepe neurale netten zodat f_θ(x) hiërarchische features leert uit hoogdimensionaal x. Het vormt de basis van moderne vision/ASR/NLP en is het substraat van generative AI (transformers / diffusion). Kostendrijvers: schoon datavolume, accelerator-tijd en inference OpEx — geen slideware.
Agent-digest. DL ⊂ ML. Discriminatief = p(y|x). Generatief = sample x of x|c. Prefer GBM voor sterke tabulaire features; train DL voor perceptie; gebruik Bedrock/vLLM voor taalagents. GitOps-serving; gate money/auth/prod.
Aangepast van AWS — What is Deep Learning? — voor Workstation-engineeringteams.
Capability-splitsing
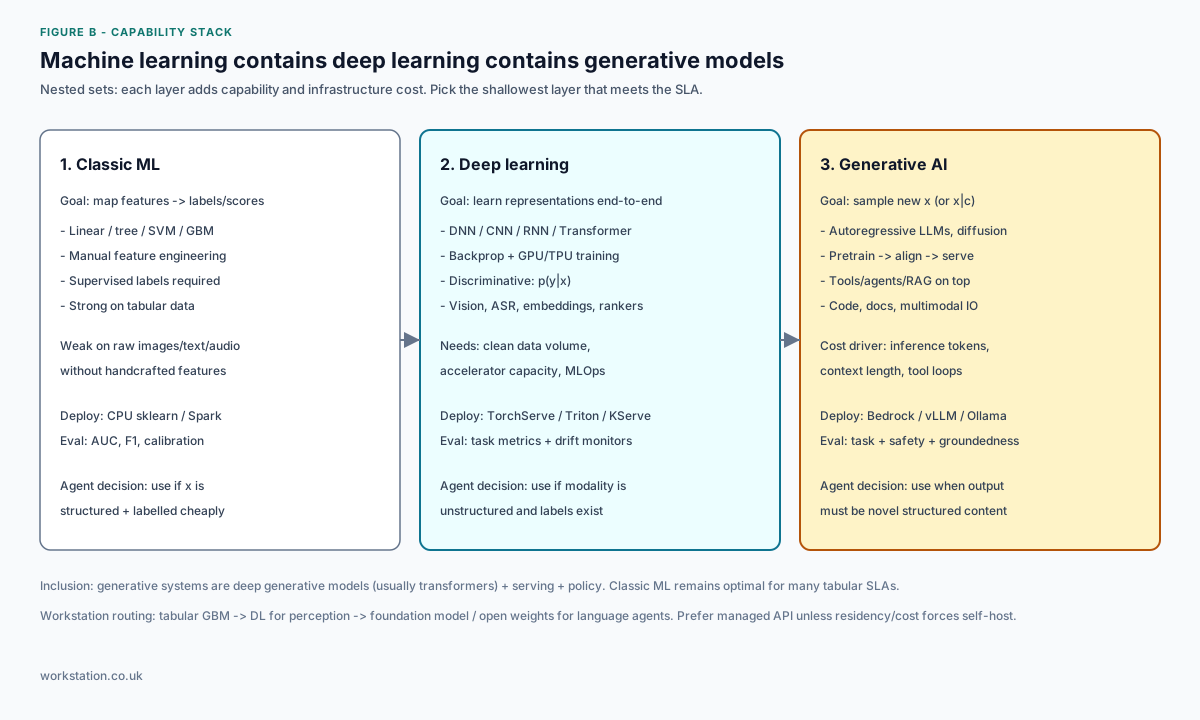
- Classic ML — engineered features; trees/lineaire modellen; beste default voor dichte tabulaire SLA’s.
- Deep learning — end-to-end nets op images/text/audio; backprop + GPU’s; serve via Triton/KServe/SageMaker.
- Generative AI — sample nieuwe content; LLM’s/diffusion + RAG/tools; Bedrock API of open-weight inference.
Taakfamilies (metrics doen ertoe)
| Familie | Typisch doel / metric |
|---|---|
| Vision | detecteren/classificeren — mAP, IoU, p99 latency |
| Speech | ASR/TTS — WER, real-time factor |
| NLP | classificeren / genereren — F1, exact-match, groundedness |
| Recommend | ranken — NDCG, CTR/CVR |
| Gen AI agents | taaksucces + safety + $/request |
Beperkingen
- Data — labelruis en shift domineren; version datasets.
- Compute — training en LLM-decode zijn accelerator-gebonden.
- Ops — eval harness, drift, cost, GitOps-rollback vóór brede promote.
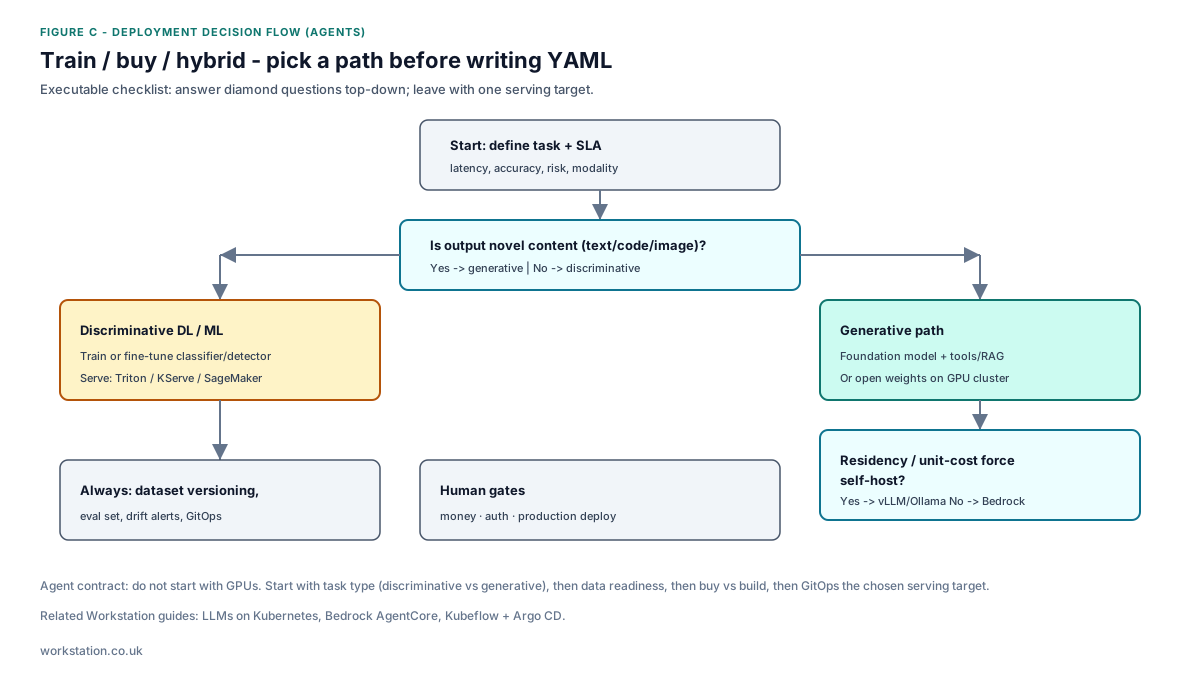
Workstation-aanbeveling
Classificeer eerst discriminatief vs generatief. Prefer managed foundation models voor taalagents tenzij residency/cost open weights afdwingt. Houd classic ML voor tabulaire data. Details, layer diagram en checklist: lange artikel. Gepubliceerd door Workstation.