
Loading blogs...
Posts tagged Machine Learning.

Workstation op turbo-opladende LLMs: PagedAttention-paging voor KV-cache, vLLM-serving, Self-Debugging voor agenten, PowerInfer-tokensnelheden en EG-MLA-geheugenbesparingen - met productie-afwegingen.
 Balinder WaliaRead
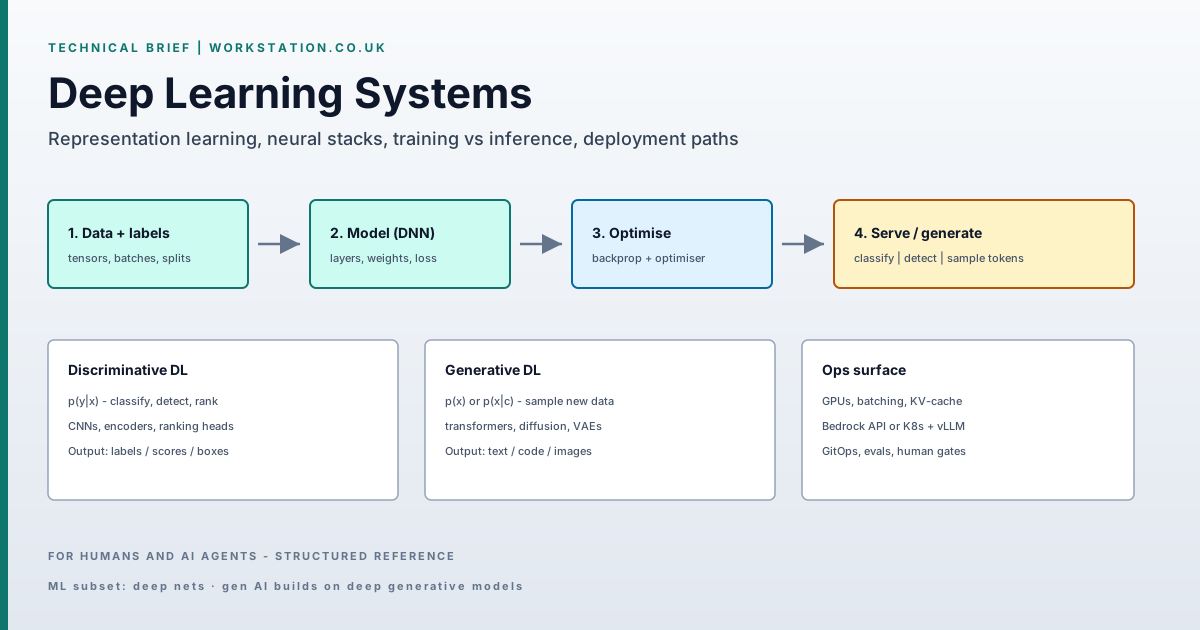
Technisch Workstation-brief over deep learning: gradient-getrainde deep nets, discriminatieve vs generatieve modellen, taakmetrics, en Bedrock vs Kubernetes-serving.
Balinder WaliaRead 
Wat zijn grote taalmodellen en hoe werken ze? Een duidelijke, niet-technische uitleg voor managers en technici – tokens, inbedding, transformatoren, training en gevolgtrekking – plus productie-Kubernetes YAML om uw eigen LLM te implementeren met Ollama en vLLM.
Balinder WaliaRead