Deep learning (DL) is representation learning met meerlaagse neurale netwerken: parameters θ worden geoptimaliseerd zodat een compositie van niet-lineaire transforms hoogdimensionale inputs (pixels, tokens, waveforms) mapt naar taakoutputs (labels, boxes, embeddings of gesamplede sequenties). Dit Workstation-technisch brief herschrijft AWS’s conceptuele overzicht voor engineers en AI-agents die systemen opleveren op Kubernetes, SageMaker en Bedrock.
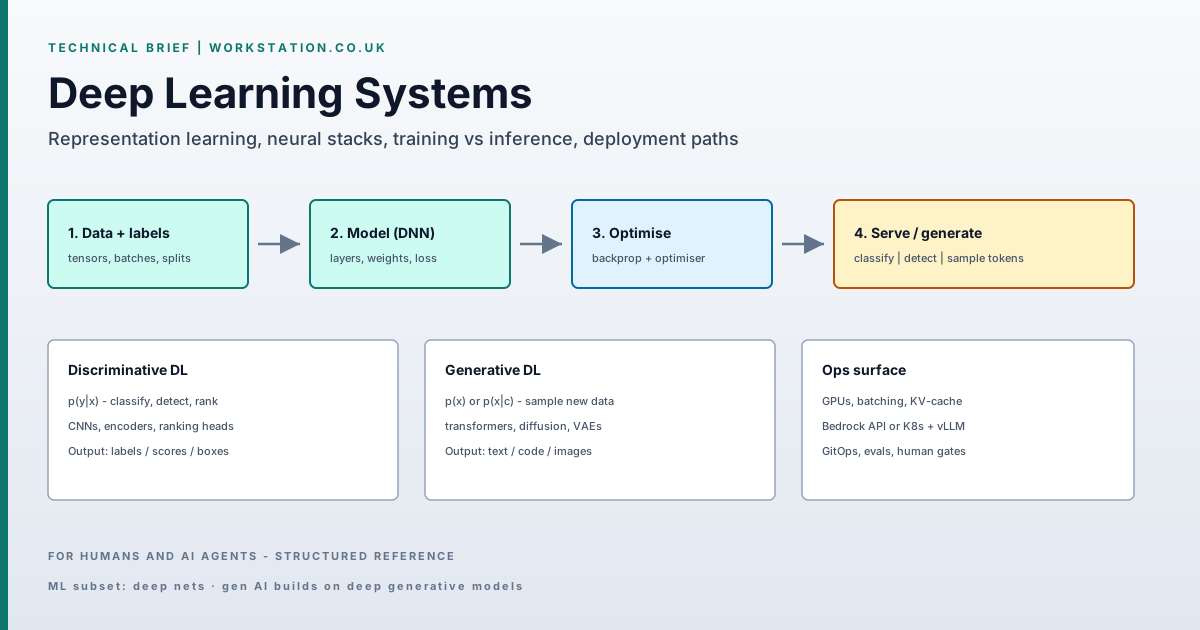
- Definitie: DL ⊂ ML; meerlaagse ANNs vooral getraind met gradient descent op een differentieerbare loss.
- Splitsing: discriminatief p(y|x) vs generatief p(x) of p(x|c).
- Gen AI: meestal grote transformers (of diffusie) + serving + policy; geen aparte wetenschap naast DL.
- Harde constraints: volume gelabelde/schone data, accelerator-FLOPs/VRAM, drift/ops.
- Route: tabulair → classic ML; perceptie → train/serve DL; taalagents → foundation-model-API of open-weight-inferentie.
Primaire bron: AWS — What is Deep Learning?. Specs en servicenamen wijzigen; verifieer actuele AWS-docs vóór provisioning.
1. Formele definitie
Een deep model is een parametrische functie f_θ samengesteld uit L lagen. Laag ℓ berekent h^(ℓ) = σ(W^(ℓ) h^(ℓ−1) + b^(ℓ)) voor een non-lineariteit σ (ReLU, GELU, SiLU, enz.). Training zoekt θ = {W, b, …} om empirisch risico te minimaliseren:
θ* = argmin_θ  (1/N) Σ_i  L( f_θ(x_i), y_i )  +  Ω(θ)
# L = CE / MSE / CTC / contrastive / RL objective, depending on task
# Gradients via reverse-mode autodiff (backpropagation); update with SGD/Adam/…
In tegenstelling tot shallow pipelines die leunen op handontworpen features, leren deep nets hiërarchische features uit ruwe of licht voorbewerkte tensors. Daarom domineert DL vision, speech en grootschalige NLP: de featureruimte is te hoogdimensionaal voor handmatige engineering.
2. Discriminatief vs generatief deep learning
Discriminatieve modellen schatten p(y|x) of een decision boundary — classifiers, detectors, rankers, embedders. Generatieve (deep generative) modellen schatten p(x) of p(x|c) en kunnen nieuwe instanties samplen: next-token LLMs, diffusie-beeldmodellen, VAEs, GANs.
Foundation models in productagents zijn deep generative systemen op schaal getraind, daarna aligned en geserveerd. Bedrock Converse of een self-hosted vLLM-endpoint aanroepen is inferentie over zo’n model — nog steeds deep learning eronder.
3. Waarom productiesystemen ervan afhangen
Deployed surfaces die al DL (of DL-backed foundation models) inbedden:
- Conversationele agents en codesynthese
- ASR / TTS en voice-UIs
- Fraud / anomaly-scoring op sequenties
- Perceptiestacks (ADAS, industriële CV, medische imaging)
- Personalisatie en search ranking met deep towers
Als een roadmap-item «AI-feature» is, is de implementatie bijna altijd een deep model, een foundation-model-API, of een hybride (RAG + tools) erbovenop.
4. Taaktaxonomie (implementatiekaart)
4.1 Computer vision
CNNs / ViTs mappen beeldtensors naar classes, boxes, masks of embeddings. Productiepatronen: content moderation, attribuutherkenning, logo/PPE-detectie, inline defectinspectie. Metrics: mAP, IoU, latency bij batch size 1 op target-GPU.
4.2 Spraak
Akoestische modellen + language models (of end-to-end ASR) tolereren accent, SNR en spreektempo-variantie. Workloads: contact-centre-assist, klinische dictatie, ondertiteling. Metrics: WER, real-time factor (RTF).
4.3 NLP
Van encoder-classifiers tot decoder-only LLMs. Workloads: intent/slot, samenvatting, document-QA, sentimentindexering. LLMs domineren open tekst; kleinere encoders winnen nog bij latency-gebonden classify/extract.
4.4 Recommenders
Two-tower / DeepFM / transformer-rankers over user–item-interactiesequenties. Outputs: gerankte lijsten met diversiteit en business constraints. Offline: NDCG/recall; online: CTR/CVR met exploration-controls.
4.5 Generatieve toepassingen
Sampling + tool use: RAG over private corpora, code-assist, document drafting, multi-agent workflows. Op AWS: Bedrock FMs of SageMaker-gehoste weights. Op Workstation-estates: Kubernetes GPU-pools (vLLM/Ollama) onder GitOps wanneer residency of unit economics dat vereisen.
5. Architectuur: lagen en forward pass
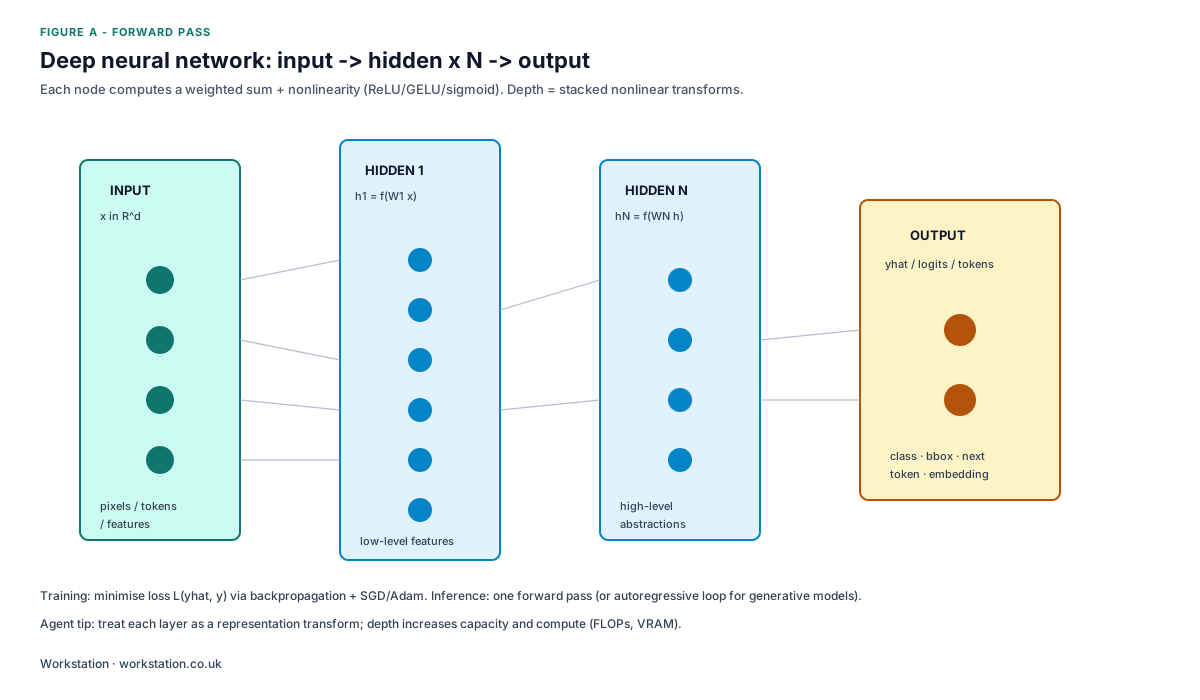
- Input layer — tensor-interface: genormaliseerde pixels, token-IDs, log-mel frames of tabulaire vectoren.
- Hidden layers — opeenvolgende representation transforms. Vroege lagen vangen lokale structuur (edges, n-grams); diepere lagen vangen taaksemantiek. Diepte vergroot expressieve capaciteit en compute (FLOPs, activation memory).
- Output layer — taakkop: softmax-logits, bounding-box-regressie, CTC, of vocab-projectie voor autoregressive decoding.
Training = veel forward + backward passes. Inferentie = alleen forward (plus KV-cache / speculative decoding voor LLMs).
6. ML vs DL vs generatieve AI
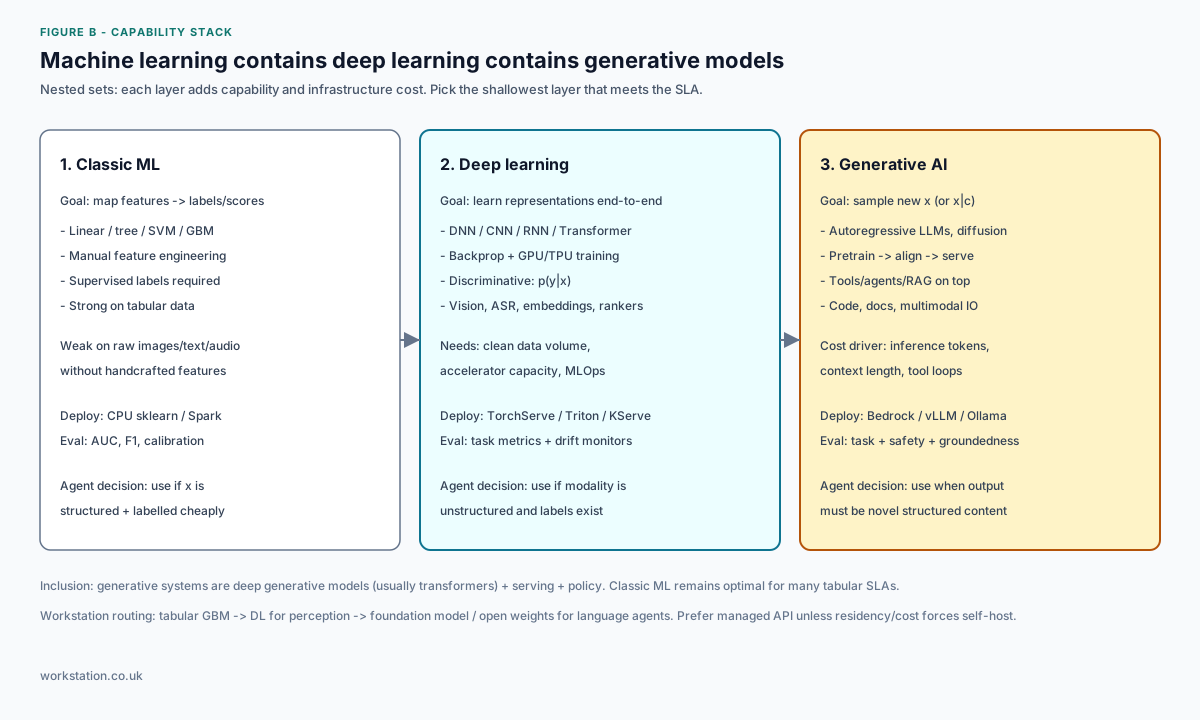
| Laag | Doel | Typische stack |
|---|---|---|
| Classic ML | p(y|φ(x)) met engineered φ | GBM / lineair op warehouse-tabellen |
| Deep learning | end-to-end f_θ(x) op ruwe modalities | PyTorch + Triton/KServe op GPU-nodes |
| Generatieve AI | sample x of x|c; agents/tools erboven | Bedrock Converse of vLLM + RAG |
6.1 Voordelen van DL boven shallow ML (wanneer ze gelden)
- Ongestructureerde modalities — gedeelde embeddings collapsen parafrasevariantie («betalen» vs «geld overmaken»).
- Feature discovery — gradients snijden nuttige internals zonder handmatige featurelijsten.
- Transfer / fine-tune — hergebruik pretrained backbones; minder gelabelde data vs from-scratch training.
- Sequentie- / setmodellering — transformers hanteren long-range dependencies die bag-of-features mist.
DL verslaat niet automatisch een goed getunede GBM op dichte tabulaire data met sterke features. Kies op modality en dataregime, niet op mode.
7. Faalwijzen en constraints
- Datakwaliteit — labelruis en distribution shift domineren foutbudgetten. Version datasets; quarantine outliers voordat ze de trainingset binnenkomen.
- Compute — training en large-batch-inferentie zijn accelerator-gebonden. Te kleine GPUs leveren meerdaagse loops op en doden iteratiesnelheid.
- Ops — zonder eval-gates, drift-monitors, cost-telemetry en rollback (GitOps) rotten modellen in productie, ongeacht architectuurdiagrammen.
8. Cloudversnelling vs self-host
Cloud verkort de experimentcyclus: elastische GPU/CPU-pools, managed notebooks/pipelines, en foundation models als APIs. AWS-bouwstenen:
- Amazon SageMaker — train, tune, host custom DL-artefacten.
- Amazon Bedrock — invoke foundation models met IAM, Guardrails en optionele ZDR.
Self-host op Kubernetes wanneer open weights, data residency of token economics owned GPUs begunstigen. Patroon: model registry + KServe/vLLM + Argo CD-sync.
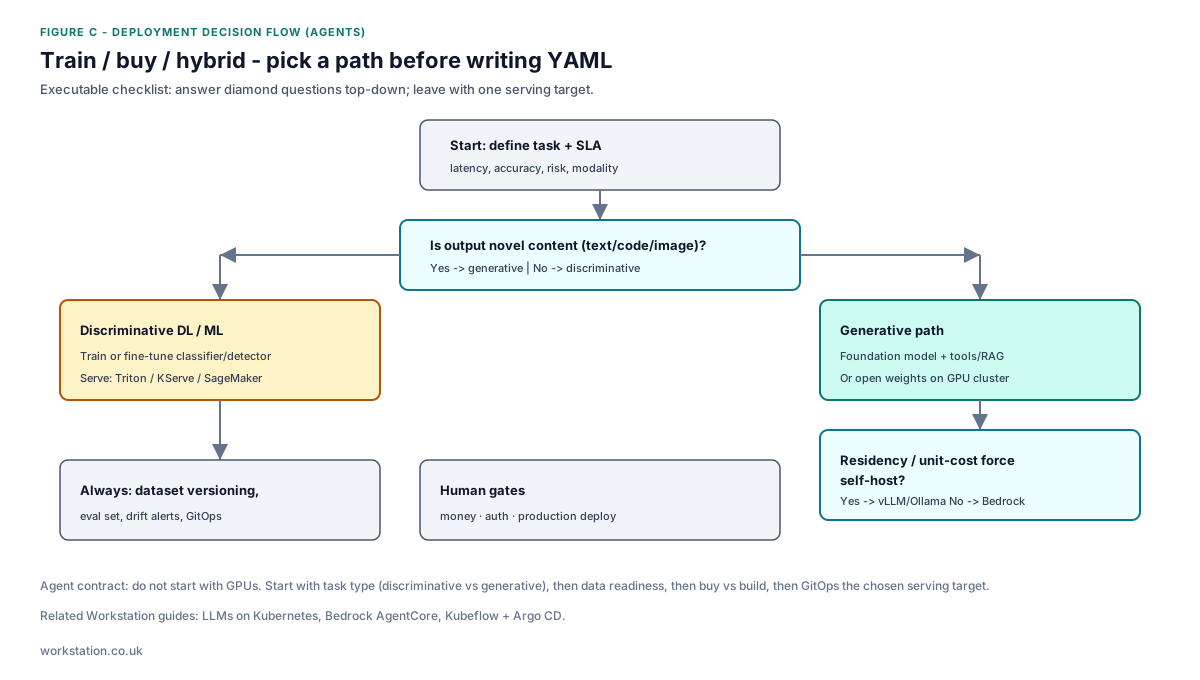
9. Uitvoeringschecklist
- Schrijf de taak als meetbaar doel (metric + latency + risk class).
- Selecteer stacklaag uit Figuur B; spring niet naar gen AI voor een tabulaire scorecard.
- Budgetteer dataprep + inference OpEx; training is vaak een minderheid van lifetime cost.
- Implementeer eval harness vóór brede rollout; wire drift alerts.
- Volgende reads: LLM serving of Bedrock agents.
Gepubliceerd door Workstation — automation platforms, multi-agent software, Kubernetes delivery.