Глубокое обучение (DL) — это обучение представлений многослойными нейронными сетями: параметры θ оптимизируются так, чтобы композиция нелинейных преобразований отображала высокоразмерные входы (пиксели, токены, волны) в выходы задачи (метки, боксы, эмбеддинги или сэмплированные последовательности). Этот технический бриф Workstation переписывает концептуальный обзор AWS для инженеров и ИИ-агентов, поставляющих системы на Kubernetes, SageMaker и Bedrock.
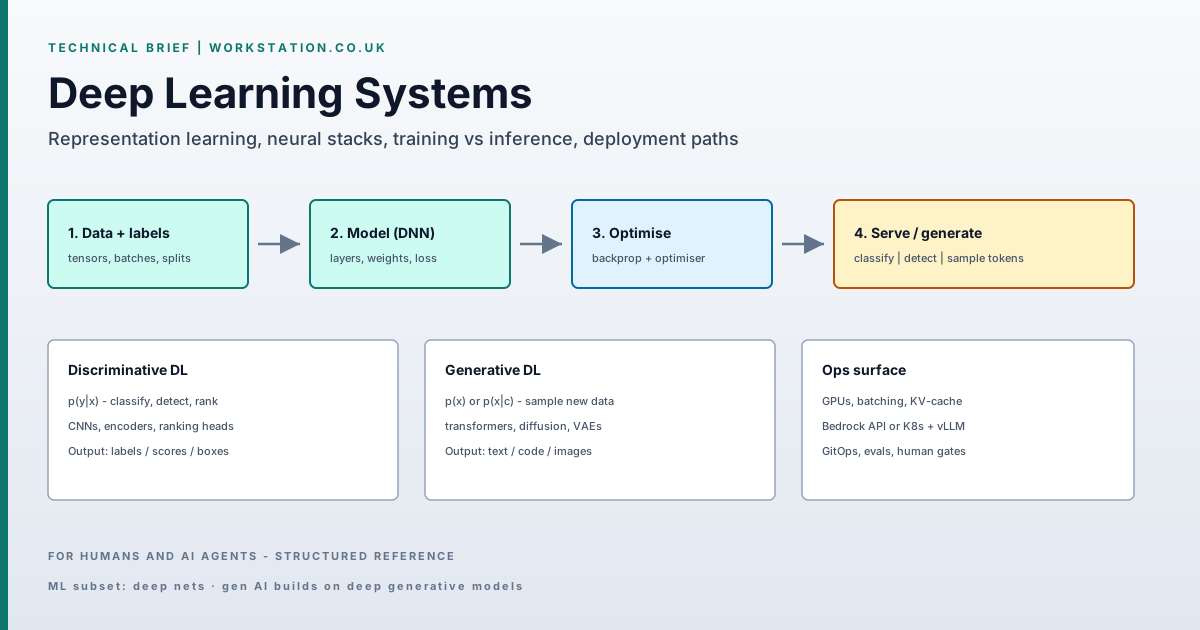
- Определение: DL ⊂ ML; многослойные ANN обучаются в основном градиентным спуском по дифференцируемому лоссу.
- Разделение: дискриминативный p(y|x) vs генеративный p(x) или p(x|c).
- Gen AI: обычно крупные transformers (или диффузия) + serving + политика; не отдельная наука от DL.
- Жёсткие ограничения: объём размеченных/очищенных данных, FLOPs/VRAM ускорителя, drift/ops.
- Маршрут: табличные → классический ML; восприятие → train/serve DL; языковые агенты → API foundation model или open-weight инференс.
Первичный источник: AWS — What is Deep Learning?. Спецификации и имена сервисов меняются; проверяйте актуальные документы AWS перед провижинингом.
1. Формальное определение
Глубокая модель — параметрическая функция f_θ из L слоёв. Слой ℓ вычисляет h^(ℓ) = σ(W^(ℓ) h^(ℓ−1) + b^(ℓ)) для нелинейности σ (ReLU, GELU, SiLU и т.д.). Обучение ищет θ = {W, b, …} для минимизации эмпирического риска:
θ* = argmin_θ  (1/N) Σ_i  L( f_θ(x_i), y_i )  +  Ω(θ)
# L = CE / MSE / CTC / contrastive / RL objective, depending on task
# Gradients via reverse-mode autodiff (backpropagation); update with SGD/Adam/…
В отличие от мелких пайплайнов, опирающихся на ручные признаки, глубокие сети учатся иерархическим признакам из сырых или слегка предобработанных тензоров. Поэтому DL доминирует в зрении, речи и крупномасштабном NLP: пространство признаков слишком высокоразмерное для ручного инжиниринга.
2. Дискриминативное vs генеративное глубокое обучение
Дискриминативные модели оценивают p(y|x) или границу решения — классификаторы, детекторы, ранкеры, эмбеддеры. Генеративные (deep generative) модели оценивают p(x) или p(x|c) и могут сэмплировать новые экземпляры: next-token LLM, диффузионные модели изображений, VAE, GAN.
Foundation models в продуктовых агентах — глубокие генеративные системы, обученные в масштабе, затем выровненные и обслуживаемые. Вызов Bedrock Converse или self-hosted vLLM endpoint — это инференс над такой моделью: внизу всё ещё глубокое обучение.
3. Почему продакшен-системы зависят от него
Развёрнутые поверхности, уже встраивающие DL (или foundation models на базе DL):
- Разговорные агенты и синтез кода
- ASR / TTS и голосовые UI
- Скоринг мошенничества / аномалий на последовательностях
- Стеки восприятия (ADAS, промышленное CV, медвизуализация)
- Персонализация и поисковый ранжинг с глубокими башнями
Если пункт дорожной карты — «AI-фича», реализация почти всегда глубокая модель, API foundation-model или гибрид (RAG + инструменты) поверх них.
4. Таксономия задач (карта реализации)
4.1 Компьютерное зрение
CNN / ViT отображают тензоры изображений в классы, боксы, маски или эмбеддинги. Прод-паттерны: модерация контента, распознавание атрибутов, детекция логотипа/PPE, инлайн-инспекция дефектов. Метрики: mAP, IoU, латентность при batch size 1 на целевом GPU.
4.2 Речь
Акустические модели + языковые модели (или end-to-end ASR) терпят акцент, SNR и вариацию темпа речи. Нагрузки: ассист контакт-центра, клиническая диктовка, субтитры. Метрики: WER, real-time factor (RTF).
4.3 NLP
От encoder-классификаторов до decoder-only LLM. Нагрузки: intent/slot, суммаризация, документный QA, индексация тональности. LLM доминируют открытый текст; меньшие энкодеры всё ещё выигрывают на latency-ограниченных classify/extract.
4.4 Рекомендатели
Ранкеры two-tower / DeepFM / transformer по последовательностям взаимодействий user–item. Выходы: ранжированные списки с разнообразием и бизнес-ограничениями. Offline: NDCG/recall; online: CTR/CVR с контролем exploration.
4.5 Генеративные приложения
Сэмплирование + использование инструментов: RAG по частным корпусам, code assist, черновики документов, мультиагентные workflow. На AWS: Bedrock FM или веса на SageMaker. На эстейтах Workstation: GPU-пулы Kubernetes (vLLM/Ollama) под GitOps, когда требуют residency или unit economics.
5. Архитектура: слои и forward pass
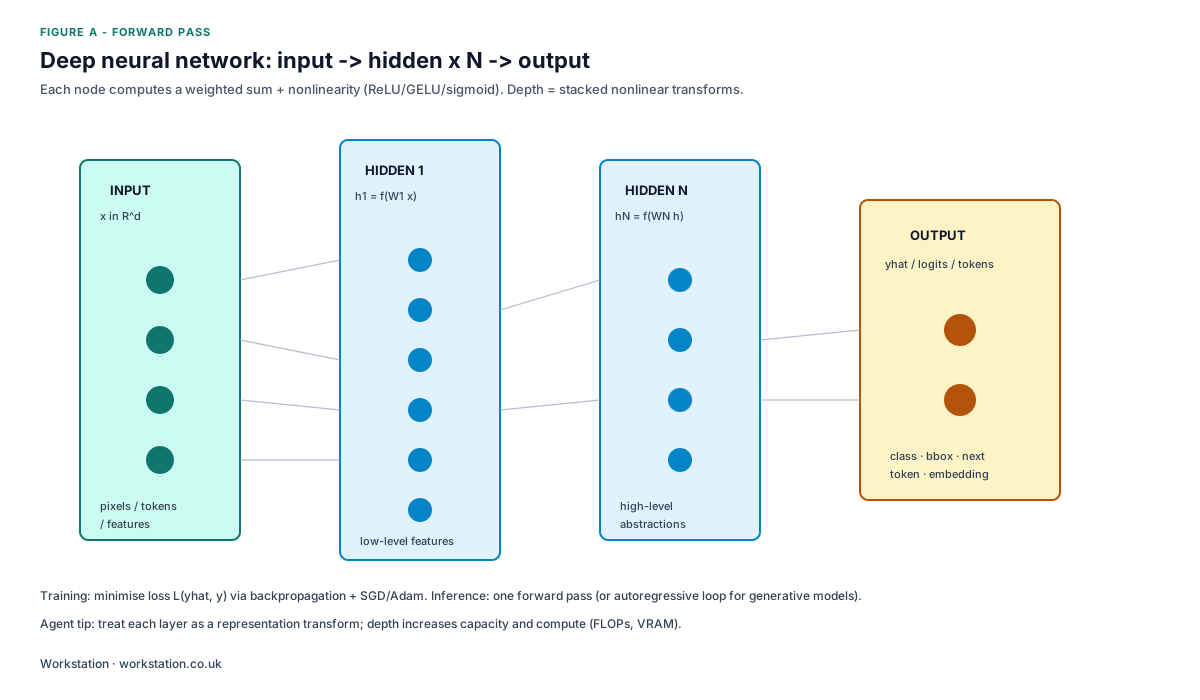
- Входной слой — тензорный интерфейс: нормализованные пиксели, ID токенов, log-mel кадры или табличные векторы.
- Скрытые слои — последовательные преобразования представлений. Ранние слои захватывают локальную структуру (края, n-grams); более глубокие — семантику задачи. Глубина увеличивает выразительную ёмкость и compute (FLOPs, память активаций).
- Выходной слой — голова задачи: softmax logits, регрессия bounding-box, CTC или проекция словаря для авторегрессивного декодирования.
Обучение = много forward + backward проходов. Инференс = только forward (плюс KV-cache / speculative decoding для LLM).
6. ML vs DL vs генеративный ИИ
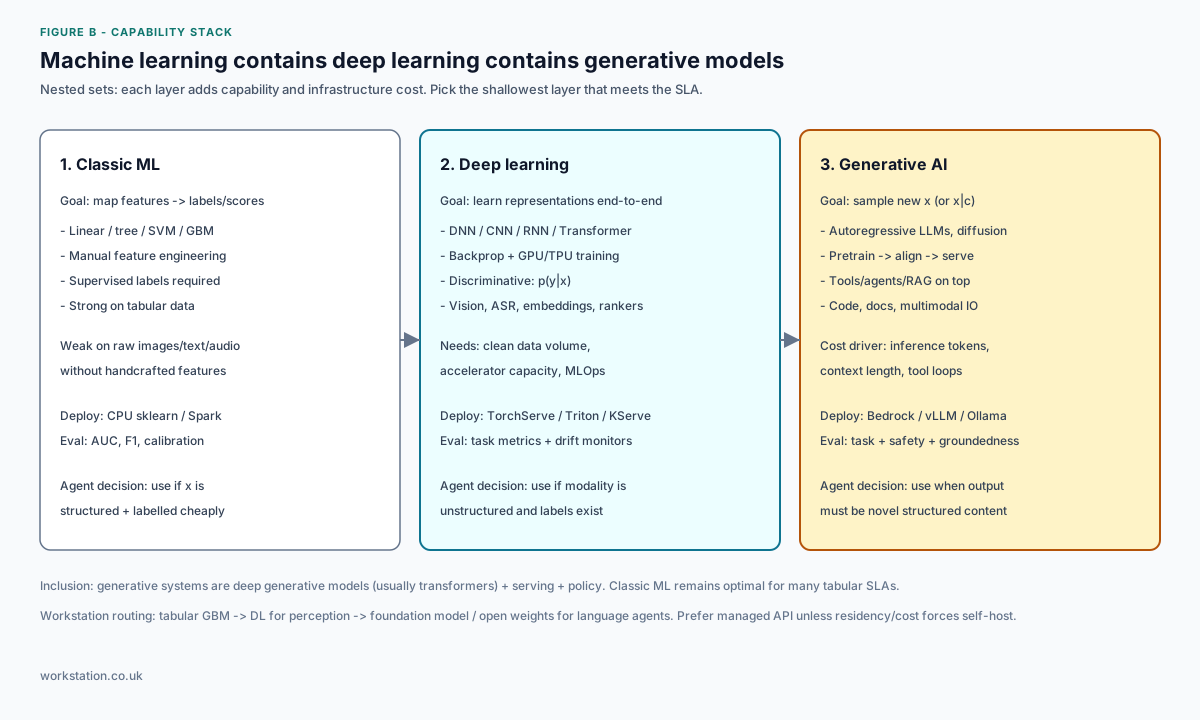
| Слой | Цель | Типичный стек |
|---|---|---|
| Классический ML | p(y|φ(x)) с engineered φ | GBM / линейные модели на таблицах warehouse |
| Глубокое обучение | end-to-end f_θ(x) на сырых модальностях | PyTorch + Triton/KServe на GPU-нодах |
| Генеративный ИИ | сэмплировать x или x|c; агенты/инструменты сверху | Bedrock Converse или vLLM + RAG |
6.1 Преимущества DL над мелким ML (когда применимы)
- Неструктурированные модальности — общие эмбеддинги сжимают вариацию парафраза («оплатить» vs «перевести деньги»).
- Открытие признаков — градиенты вырезают полезные внутренности без ручных списков признаков.
- Transfer / fine-tune — переиспользование предобученных backbone; меньше размеченных данных vs обучение с нуля.
- Моделирование последовательностей / множеств — transformers обрабатывают дальние зависимости, которые bag-of-features пропускает.
DL не автоматически побеждает хорошо настроенный GBM на плотных табличных данных с сильными признаками. Выбирайте по модальности и режиму данных, а не по моде.
7. Режимы отказов и ограничения
- Качество данных — шум меток и distribution shift доминируют бюджет ошибок. Версионируйте датасеты; карантинируйте выбросы до попадания в обучающий набор.
- Compute — обучение и large-batch инференс ограничены ускорителем. Недостаточные GPU дают многодневные циклы и убивают скорость итераций.
- Ops — без eval-гейтов, мониторов drift, телеметрии стоимости и rollback (GitOps) модели гниют в продакшене независимо от архитектурных диаграмм.
8. Облачное ускорение vs self-host
Облако сокращает цикл экспериментов: эластичные пулы GPU/CPU, управляемые ноутбуки/пайплайны и foundation models как API. Строительные блоки AWS:
- Amazon SageMaker — обучение, тюнинг, хостинг кастомных DL-артефактов.
- Amazon Bedrock — вызов foundation models с IAM, Guardrails и опциональным ZDR.
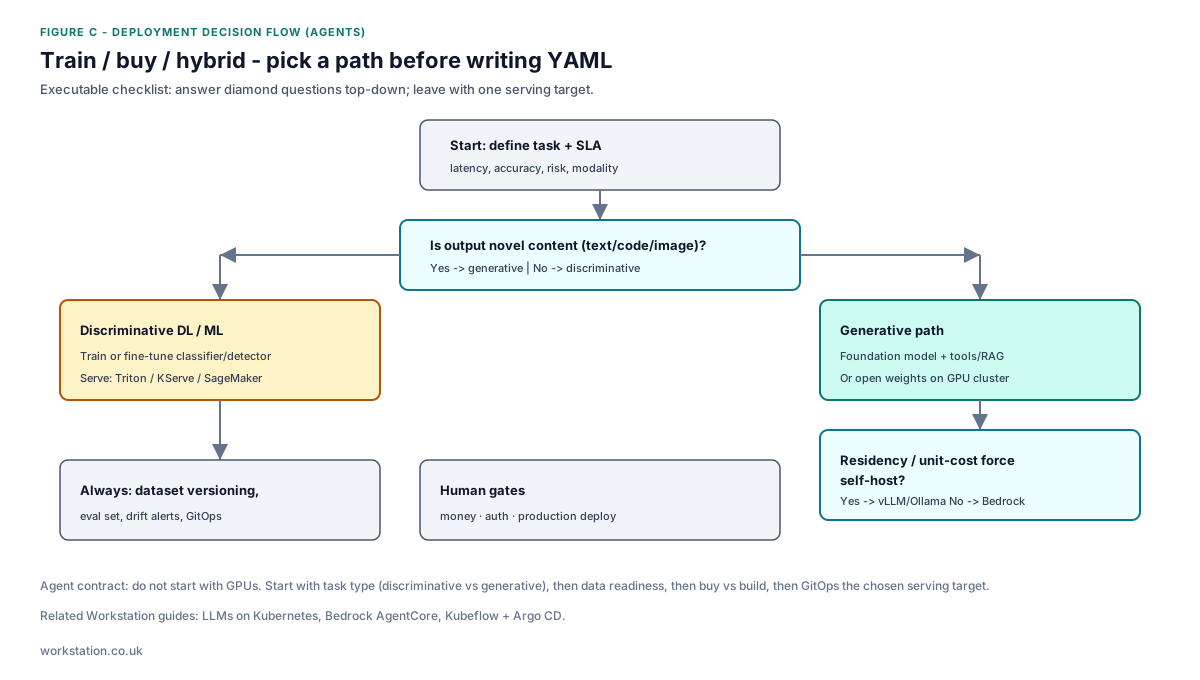
Self-host на Kubernetes, когда открытые веса, residency данных или экономика токенов благоприятствуют собственным GPU. Паттерн: model registry + KServe/vLLM + синхронизация Argo CD.
9. Чеклист исполнения
- Запишите задачу как измеримую цель (метрика + латентность + класс риска).
- Выберите слой стека из рисунка B; не прыгайте в gen AI ради табличного scorecard.
- Заложите бюджет подготовки данных + OpEx инференса; обучение часто меньшинство lifetime-стоимости.
- Реализуйте eval harness до широкого rollout; подключите алерты drift.
- Дальше читать: LLM serving или агенты Bedrock.
Опубликовано Workstation — платформы автоматизации, мультиагентное ПО, доставка Kubernetes.


