
Muse Glimmer — это причинно-языковая модель Meta с 30 миллиардами параметров и специальным кодировщиком восприятия, созданная на основе Muse Spark и опубликованная для автономных агентских рабочих нагрузок на потребительском оборудовании и рабочих станциях. Распространяется через Ollama под Apache 2.0, он нацелен на надежное использование инструментов, долгосрочные задачи, мультимодальное понимание и восстановление после сбоев — без необходимости вывода из облака. Данное техническое описание Workstation переписывает и расширяет карточку общедоступной модели для инженеров, занимающихся доставкой местных агентов.
- Сорт: 30B причинный LM + кодер восприятия; дистиллированный из Muse Spark; видение + инструменты + мышление.
- Служить:
ollama run muse-glimmer(~18GB, 128 КБ, текст+изображение); Apple Silicon:muse-glimmer:30b-mlx(~21GB, DFlash). - Соответствовать: постоянно включенные локальные агенты с воздушным зазором на одном GPU или Mac Silicon, а не модель кластера MoE с несколькими ТБ.
- Сила сигнала: лидирует в представленной Meta матрице классов размеров на MCP-Atlas, DeepSearch QA, WildClawBench, SWE-Bench Pro, AA-LCR, Beam128K (высокие аргументы).
- Операции: эшафот через
ollama launch(Claude Code, OpenCode, Гермес, OpenClaw); управлять с помощью evals, HITL, аутентификации MCP.
Первичные источники: Библиотека Ollama — муза-мерцание; Методика метаоценки — Методика Muse Glimmer. Меняются номера и теги; проверьте карточку живой модели перед закупкой.
1. Архитектура и дизайнерский замысел
Muse Glimmer не позиционируется как общий чат МЧС. Фрейминг Меты сквозное агентское завершение задачи по фурнитуре можно купить для письменного стола или небольшого лабораторного стеллажа:
- Причинный позвоночник LM (30B) — следующее поколение токенов с многоэтапными цепочками рассуждений, поддерживаемыми в течение длительных рабочих процессов.
- Специальный кодер восприятия — принимает чередующийся текст и изображения, чтобы агенты могли анализировать снимки экрана, диаграммы и документы в том же контекстном окне, что и стенограммы инструментов.
- Дистилляция из Muse Spark — перенос возможностей в среду, ориентированную на развертывание одного GPU / потребительского класса, а не обслуживание только центров обработки данных.
- Поведение восстановления после сбоя — когда вызов инструмента терпит неудачу или возвращает неожиданную полезную нагрузку, модель обучается/настраивается для диагностики и повторной попытки, а не остановки эпизода.
- Контролируемое усилие — сила обоснования выбирается, чтобы операторы могли жертвовать задержкой ради качества на каждом маршруте.
- Многоязычное обучение — Мета-состояния обучающих данных более чем на 100 языках.
Для стеков Workstation значение продукта следующее: относитесь к Glimmer как к мозг во время выполнения агента за инструментами MCP, оболочками, браузерами и редакторами файлов, а не в качестве полной замены для каждого закрытого пограничного вызова API.
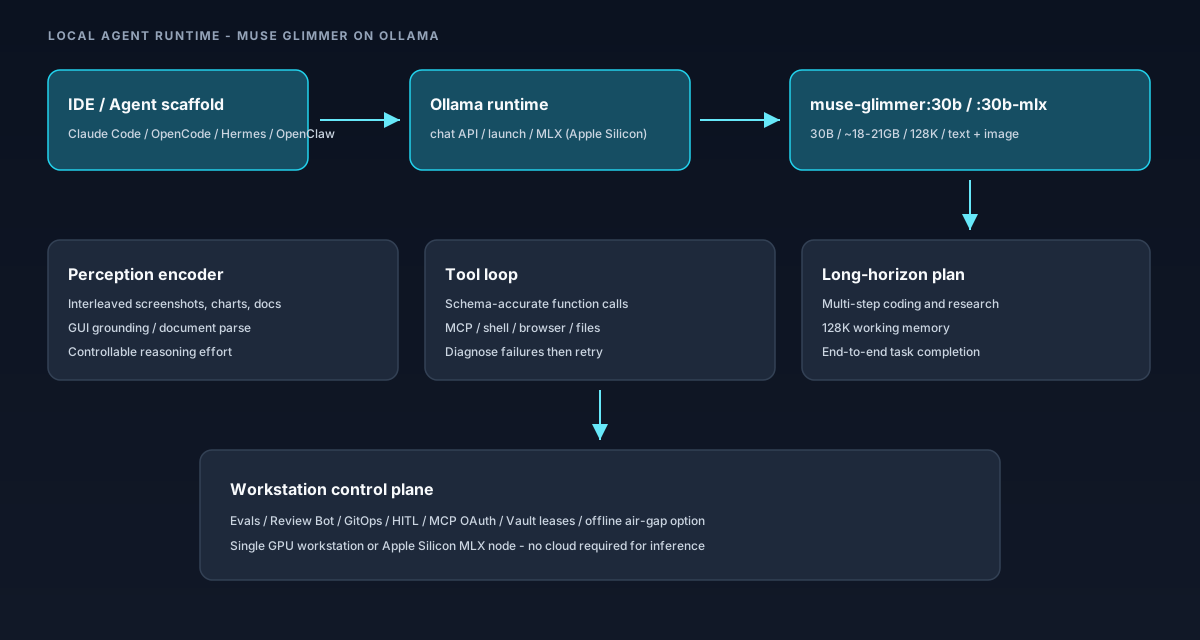
2. Распространение Ollama (теги, посадочное место, ввод-вывод)
Как указано на библиотечной карте Ollama (проверьте реальные размеры):
| Ярлык | Прибл. размер | Контекст | Вход | Примечания |
|---|---|---|---|---|
muse-glimmer:latest / :30b | ~18GB | 128 тыс. | Текст, Изображение | Путь по умолчанию для одного GPU |
muse-glimmer:30b-mlx | ~21GB | 128 тыс. | Текст, Изображение | двигатель Ollama MLX; DFlash + изображение на Apple Silicon |
# Pull + interactive
ollama run muse-glimmer

# Apple Silicon (MLX)
ollama run muse-glimmer:30b-mlx

# HTTP chat (localhost Ollama)
curl http://localhost:11434/api/chat \
  -d '{"model":"muse-glimmer","messages":[{"role":"user","content":"Hello!"}]}'

# Scaffold launchers (from Ollama applications list)
ollama launch claude --model muse-glimmer
ollama launch opencode --model muse-glimmer
ollama launch hermes --model muse-glimmer
ollama launch openclaw --model muse-glimmer
Клиенты Python/JS должны закрепить проверенный вами тег (muse-glimmer против :30b-mlx) в конфигурации, а не в жестком коде latest в производственных агентах.
3. Поверхность возможностей (инженерное чтение)
- Сквозное агентское завершение — Meta приводит хорошие результаты в задачах DeepSearch QA, MCP-Atlas, τ3-Bench (банковское дело) и семействе SWE-Bench, которые измеряют многоэтапный успех, а не единичные пустяки.
- Надежное использование инструмента — широкий охват вызовов функций с точностью схемы в расширенных рабочих процессах (критически важно для парка инструментов MCP).
- Многоэтапное рассуждение — согласованность плана на долгосрочную перспективу; сочетается с контекстным окном размером 128 КБ для сохранения стенограммы и документа.
- Восстановление после сбоя — диагностировать неожиданные результаты инструмента и повторить попытку; уменьшает количество аварий из-за «хрупких агентов» при выполнении ночных работ.
- Мультимодальные рассуждения — кодировщик восприятия позволяет чередовать скриншоты/диаграммы/документы с текстом (основание графического интерфейса пользователя и средства анализа документов включены в матрицу Meta).
- Совместимость с лесами — OpenClaw, Hermes Agent и аналогичные шаблоны оркестровки; Ollama называет средства запуска Claude Code и OpenCode первоклассными приложениями.
4. Матрица эталонных показателей (мета-отчеты, высокая аргументация)
Мета сравнивает Muse Glimmer-30B (высокое рассуждение) с Gemma4-31B и Qwen3.6-27B в режиме мышления. Заголовок Workstation гласит: Глиммер возглавляет несколько агентный общедоступные пакеты (MCP-Atlas, DeepSearch QA, WildClawBench, Gaia2, SWE-Bench Pro), одновременно отслеживая или связывая одноранговые устройства по некоторым метрикам Desktop-Agent и GDP-val. Всегда перезапускать твой обуздать.
| Категория | Контрольный показатель | Глиммер-30Б | Джемма4-31Б | Квен3.6-27B |
|---|---|---|---|---|
| Генеральный агент | MCP-Atlas (публичный) | 75.5 | 54.2 | 62.5 |
| Контроль качества DeepSearch | 74.6 | 61.7 | 71.1 | |
| τ3-Банкинг | 23.5 | 15.1 | 16.7 | |
| ДикийКоготьСкамейка | 47.6 | 37.6 | 43.2 | |
| ВВПВал-АА v2 | 953 | 811 | 1141 | |
| Гайя2 | 43.3 | 36.4 | 40.0 | |
| SkillsBench (с навыками) | 44.3 | 32.4 | 46.6 | |
| ОСПроверено в мире | 65.9 | 58.5 | 75.6 | |
| Агентское кодирование | SWE-Bench Про | 51.2 | 36.9 | 50.2 |
| SWE-Bench проверено | 76.0 | 66.6 | 77.2 | |
| ТерминалБенч 2.1 | 51.7 | 43.4 | 60.7 | |
| Научный код | 43.6 | 43.4 | 39.8 | |
| Мультимодальный | Рассуждение ЧарXiv | 78.8 | 77.7 | 78.4 |
| ЭкранСпот Про | 75.4 | 75.9 | 76.1 | |
| ОмниДокБенч v1.5 | 75.8 | 72.5 | 77.8 | |
| МММУ Про | 74 | 73 | 75 | |
| Рассуждение / LCR | IFBench | 77.0 | 76.0 | 70.8 |
| ЭИМЭ 2026 | 94.7 | 89.2 | 94.1 | |
| GPQA Бриллиант (AA) | 83.5 | 85.7 | 84.2 | |
| Текст HLE (AA) | 22.0 | 23.6 | 23.1 | |
| АА-ЛКР | 80.0 | 68.3 | 73.3 | |
| Балка128К | 65.1 | 58.2 | 63.0 |
Стенды безопасности (CI Memories, Siren AgentDojo) демонстрируют компромиссы: Glimmer сообщает о высокой полезности при внедрении AgentDojo со средним пакетом ASR; относитесь к безопасности как к проблеме управления развертыванием (быстрые межсетевые экраны, списки разрешенных инструментов, HITL), а не как решаемое свойство модели. См. PDF-файл с методологией Meta, чтобы узнать о моделях судейства, подсчете попыток и предостережениях по использованию.
5. Методика оценки (что означают цифры)
Прежде чем цитировать любую ячейку колоды на доске, необходимо выполнить методическое примечание Meta:
- Выбор коллег: открытые модели размерного класса (Gemma4-31B, Qwen3.6-27B); сверстники могут использовать оценки, сообщаемые самостоятельно или воспроизводимые внутри компании; Искусственный анализ используется, когда доступен для всех трех.
- Выборка: Глиммер сообщил о высокой силе рассуждения с температурой = 1,0 / top_p = 0,95 / top_k = 64; одноранговые узлы используют рекомендованные поставщиком конфигурации мышления (Qwen использует более низкие температуры на некоторых стендах агентов).
- Предупреждение о смещении ремня безопасности: Мета-примечания: сторонние модели могут быть не настроены на подсказки инструментов/системы Meta — абсолютные ранги могут меняться в рамках одноранговых систем.
- MCP-Atlas: многооборотное использование инструмента на более чем 20 серверах MCP; Показатель успешности оценки судьей LLM (порог 0,75) по 500 общедоступным заданиям, в среднем за 4 запуска.
- Контроль качества DeepSearch: автономный цикл просмотра (поиск/открытие/найти) по 900 сложным исследовательским вопросам; F1 через удаление судьи.
- WildClawBench / Gaia2: долгосрочные задачи Dockerized агента с помощью средств OpenClaw с внедрением событий и смешанной детерминированной/LLM оценкой.
- SWE-Bench: bash + файловый инструментарий; Pro и Verified усреднены по нескольким запускам. Сравнение Pro позволяет избежать варианта Qwen с уточненными задачами.
- OSWorld-Проверено: Управление виртуальной машиной Ubuntu только с графическим интерфейсом со скриншотов (без прямой оболочки); Различия в пространстве действия между моделями имеют значение.
- Луч128К: неагентный зонд памяти с длинным контекстом на уровне 128 КБ — актуально, если вы храните большие транскрипты в контексте без RAG.
Политика Workstation: опубликуйте матрицу Meta для ориентации, а затем запустите производство на внутреннем золотом наборе (ваши инструменты MCP, ваши репозитории, ваш SLO по задержке).
6. Аппаратное обеспечение и обслуживание реальности
- Одиночный класс GPU: Вес ~18GB подразумевает современный потребительский/профессиональный уровень 24GB+. GPU — это практичный пол NVIDIA с учетом активации KV-кэша и машинного зрения; профиль с вашим максимальным контекстом и одновременными сеансами.
- Apple Silicon: предпочитать
:30b-mlx(~21GB) для пути MLX Ollama со спекулятивным декодированием DFlash и собственным вводом изображений — конфигурации Mac Studio/Mac mini Max являются первоклассными узлами для малого и среднего бизнеса. - Не Кими-К3-класс: это не многоузловое МЧС. Если вам нужны открытые агенты с триллионом параметров, см. руководство по открытым весам; Глиммер владеет на столе, всегда включен ниша.
- Кубернетес: пакет Ollama или OpenAI-совместимая коляска на каждый узел; храните полученные модели в своем личном реестре/кэше; не оставляйте Ollama отключенным от Интернета.
7. Безопасность и управление для постоянно работающих агентов
Локальные веса сокращают исходящие данные, но увеличивают радиус атаки хоста скомпрометированного агента. Минимальный базовый уровень Workstation:
- MCP OAuth 2.1 + кратковременные секреты (аренда хранилища) — см. статья об агентской безопасности.
- Списки разрешений инструментов и политики выхода из сети для каждого идентификатора агента.
- HITL запрещает необратимые действия (платежи, развертывание продуктов, массовая рассылка).
- Мониторинг оперативного внедрения содержимого, возвращаемого инструментом (модель угроз в стиле Siren AgentDojo).
- Автономный режим/режим воздушного зазора тестировался как первоклассный Runbook, а не как надежда.
8. Контрольный список производства
- Вывод метки Ollama (
30bпротив30b-mlx) и запишите дайджест/хэш в GitOps. - Создайте золотой набор задач из 20–50, отражающий ваши инструменты MCP и рабочие процессы кодирования; отслеживать задержку pass@1 и p95 на каждом уровне усилий.
- Проволочная подставка (
ollama launch …или настраиваемый) со структурированным журналированием вызовов и повторов инструментов. - Определите гибридный маршрутизатор: Glimmer local для частных RAG/агентов; Облачное аварийное переключение при переполнении/пиковом IQ.
- Документируйте запас VRAM/унифицированной памяти в разрешении 32K/64K/128K с включенной функцией Vision.
- Юридическая информация: проверка Apache 2.0 для вашей модели распространения (обычно простые или ограничительные лицензии с открытым весом).
- Отправьте бот-проверку + оценочные шлюзы перед включением автоматических ночных агентов.
Опубликовано Workstation. Модель карты: ollama.com/library/muse-glimmer.


