Deep learning (DL) é aprendizagem de representações com redes neurais multicamada: os parâmetros θ são otimizados para que uma composição de transforms não lineares mapeie entradas de alta dimensão (pixels, tokens, formas de onda) para saídas de tarefa (labels, boxes, embeddings ou sequências amostradas). Este brief técnico da Workstation reescreve a visão conceitual da AWS para engenheiros e agentes de IA que entregam sistemas em Kubernetes, SageMaker e Bedrock.
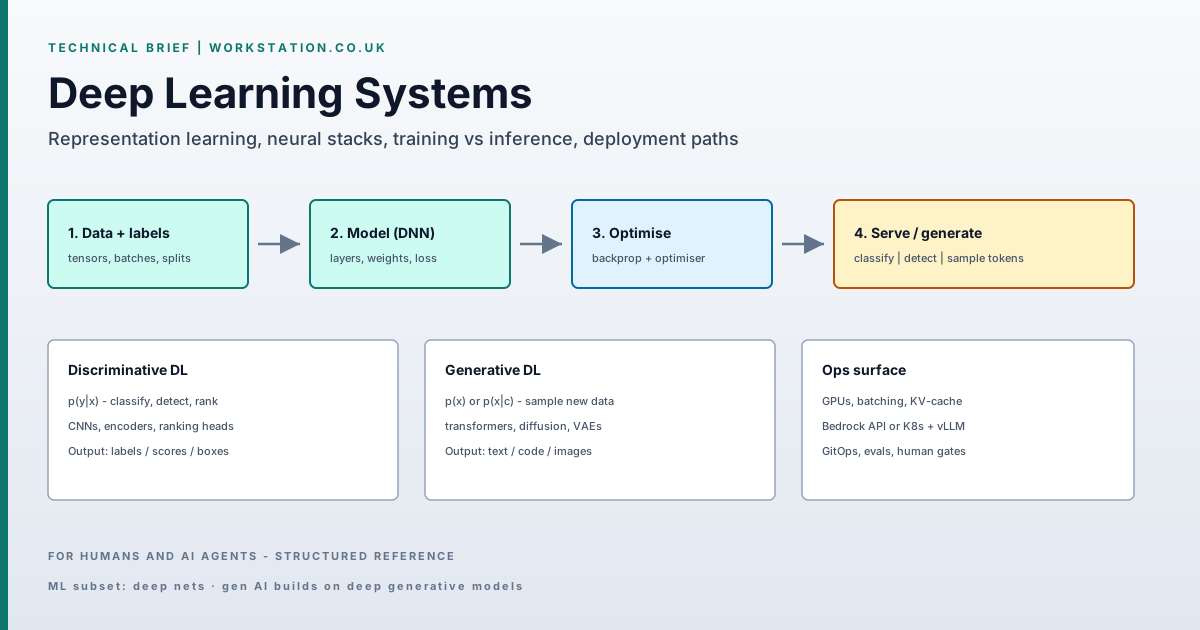
- Definição: DL ⊂ ML; ANNs multicamada treinadas principalmente por descida de gradiente sobre uma loss diferenciável.
- Divisão: discriminativo p(y|x) vs generativo p(x) ou p(x|c).
- Gen AI: normalmente grandes transformers (ou difusão) + serving + política; não é uma ciência separada do DL.
- Restrições duras: volume de dados rotulados/limpos, FLOPs/VRAM do acelerador, drift/ops.
- Rota: tabular → ML clássico; percepção → treinar/servir DL; agentes de linguagem → API de foundation model ou inferência open-weight.
Fonte primária: AWS — What is Deep Learning?. Specs e nomes de serviços mudam; verifique a documentação atual da AWS antes de provisionar.
1. Definição formal
Um modelo profundo é uma função paramétrica f_θ composta de L camadas. A camada ℓ calcula h^(ℓ) = σ(W^(ℓ) h^(ℓ−1) + b^(ℓ)) para uma não linearidade σ (ReLU, GELU, SiLU, etc.). O treino busca θ = {W, b, …} para minimizar o risco empírico:
θ* = argmin_θ  (1/N) Σ_i  L( f_θ(x_i), y_i )  +  Ω(θ)
# L = CE / MSE / CTC / contrastive / RL objective, depending on task
# Gradients via reverse-mode autodiff (backpropagation); update with SGD/Adam/…
Ao contrário de pipelines rasos que dependem de features desenhadas à mão, redes profundas aprendem features hierárquicas a partir de tensores brutos ou levemente pré-processados. Por isso o DL domina visão, fala e NLP em larga escala: o espaço de features é demasiado alta dimensão para engenharia manual.
2. Deep learning discriminativo vs generativo
Modelos discriminativos estimam p(y|x) ou um limite de decisão — classificadores, detectores, rankers, embedders. Modelos generativos (deep generative) estimam p(x) ou p(x|c) e podem amostrar novas instâncias: LLMs next-token, modelos de imagem por difusão, VAEs, GANs.
Foundation models usados em agentes de produto são sistemas generativos profundos treinados em escala, depois alinhados e servidos. Chamar Bedrock Converse ou um endpoint vLLM self-hosted é inferência sobre tal modelo — ainda deep learning por baixo.
3. Por que sistemas de produção dependem dele
Superfícies deployadas que já embutem DL (ou foundation models respaldados por DL):
- Agentes conversacionais e síntese de código
- ASR / TTS e UIs de voz
- Scoring de fraude / anomalia em sequências
- Pilhas de percepção (ADAS, CV industrial, imagem médica)
- Personalização e ranking de busca com torres profundas
Se um item de roadmap é «feature de IA», a implementação é quase sempre um modelo profundo, uma API de foundation-model, ou um híbrido (RAG + tools) por cima.
4. Taxonomia de tarefas (mapa de implementação)
4.1 Visão computacional
CNNs / ViTs mapeiam tensores de imagem para classes, boxes, masks ou embeddings. Padrões de produção: moderação de conteúdo, reconhecimento de atributos, detecção de logo/PPE, inspeção de defeitos inline. Métricas: mAP, IoU, latência em batch size 1 na GPU alvo.
4.2 Fala
Modelos acústicos + modelos de linguagem (ou ASR end-to-end) toleram sotaque, SNR e variância de ritmo de fala. Cargas: assistência em contact-centre, ditado clínico, legendagem. Métricas: WER, fator em tempo real (RTF).
4.3 NLP
De classificadores encoder a LLMs decoder-only. Cargas: intent/slot, sumarização, QA documental, indexação de sentimento. LLMs dominam texto aberto; encoders menores ainda vencem em classify/extract limitados por latência.
4.4 Recomendadores
Rankers two-tower / DeepFM / transformer sobre sequências de interação user–item. Saídas: listas ranqueadas com diversidade e restrições de negócio. Offline: NDCG/recall; online: CTR/CVR com controles de exploração.
4.5 Aplicações generativas
Amostragem + uso de tools: RAG sobre corpora privados, assistência de código, redação de documentos, workflows multiagente. Na AWS: Bedrock FMs ou pesos hospedados no SageMaker. Em estates Workstation: pools GPU Kubernetes (vLLM/Ollama) sob GitOps quando residência ou economia unitária exigem.
5. Arquitetura: camadas e forward pass
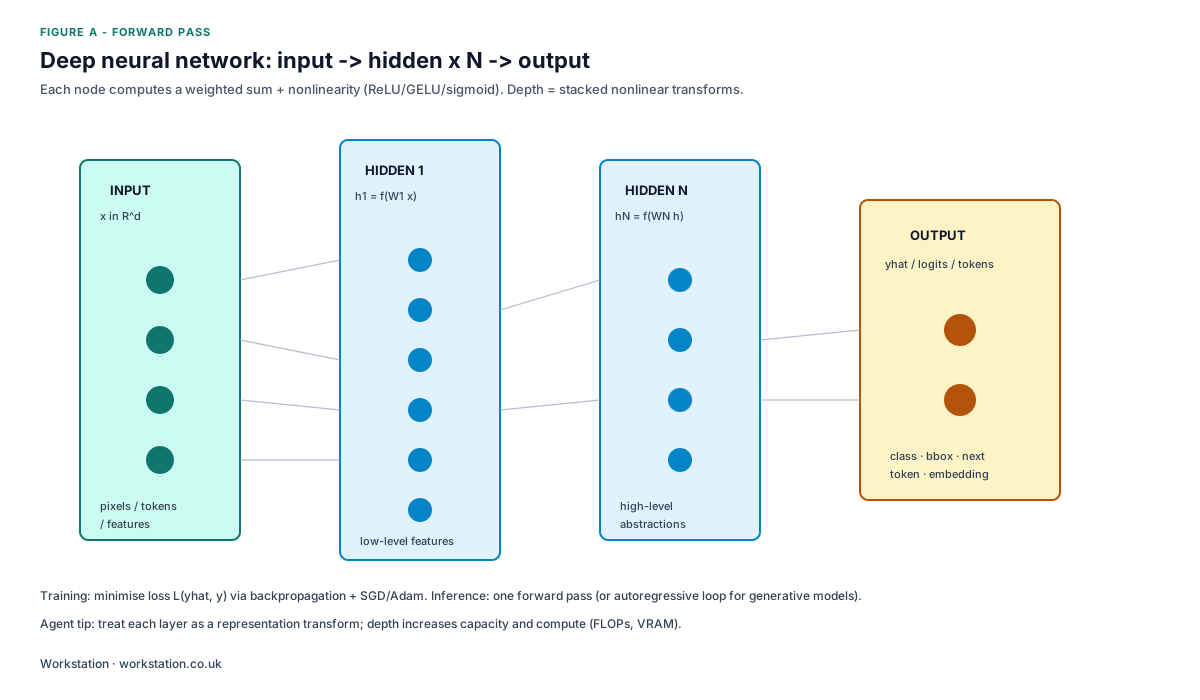
- Camada de entrada — interface de tensor: pixels normalizados, IDs de tokens, frames log-mel ou vetores tabulares.
- Camadas ocultas — transforms de representação sucessivos. Camadas iniciais capturam estrutura local (bordas, n-grams); camadas mais profundas capturam semântica da tarefa. Profundidade aumenta capacidade expressiva e compute (FLOPs, memória de ativação).
- Camada de saída — cabeça de tarefa: logits softmax, regressão de bounding-box, CTC, ou projeção de vocab para decoding autorregressivo.
Treino = muitos forward + backward passes. Inferência = apenas forward (mais KV-cache / speculative decoding para LLMs).
6. ML vs DL vs IA generativa
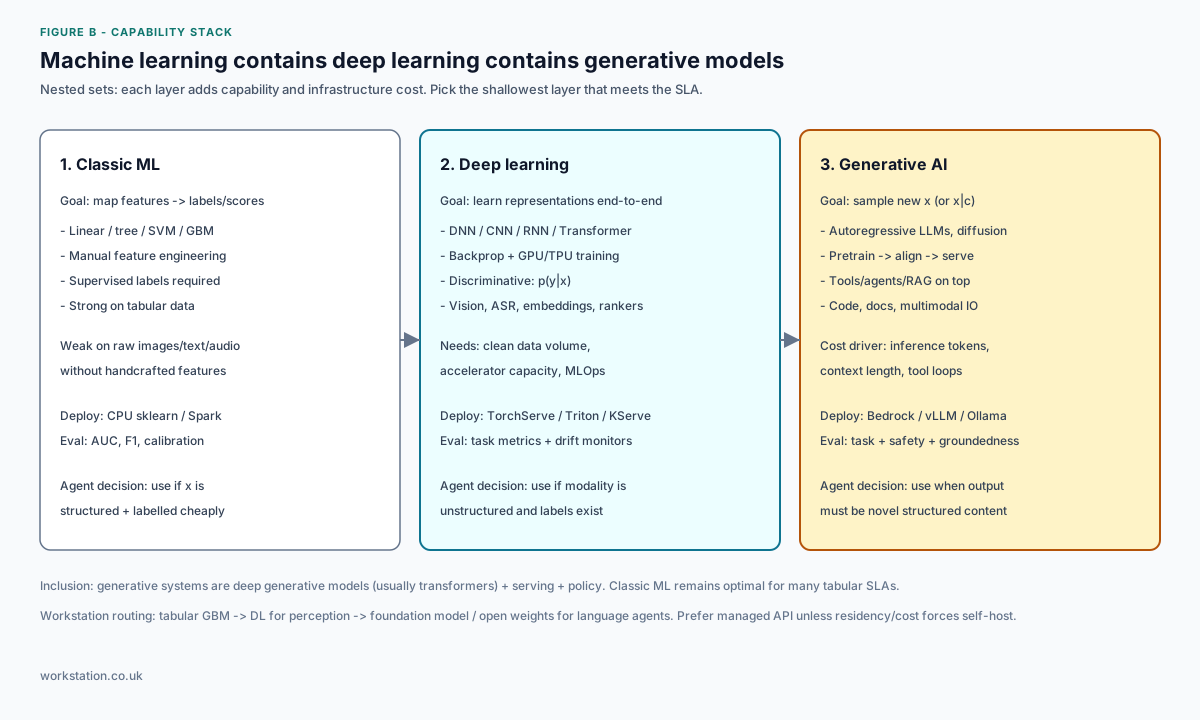
| Camada | Objetivo | Pilha típica |
|---|---|---|
| ML clássico | p(y|φ(x)) com φ engineered | GBM / linear em tabelas de warehouse |
| Deep learning | f_θ(x) end-to-end em modalidades brutas | PyTorch + Triton/KServe em nós GPU |
| IA generativa | amostrar x ou x|c; agentes/tools por cima | Bedrock Converse ou vLLM + RAG |
6.1 Vantagens do DL sobre ML raso (quando se aplicam)
- Modalidades não estruturadas — embeddings partilhados colapsam a variância de paráfrase («pagar» vs «transferir dinheiro»).
- Descoberta de features — gradientes esculpem internos úteis sem listas manuais de features.
- Transfer / fine-tune — reutilizar backbones pré-treinados; reduzir dados rotulados vs treinar from scratch.
- Modelagem de sequências / conjuntos — transformers lidam com dependências de longo alcance que bag-of-features perde.
DL não supera automaticamente um GBM bem afinado em dados tabulares densos com features fortes. Escolha por modalidade e regime de dados, não por moda.
7. Modos de falha e restrições
- Qualidade dos dados — ruído de labels e distribution shift dominam orçamentos de erro. Versione datasets; quarentene outliers antes de entrarem no set de treino.
- Compute — treino e inferência large-batch são limitados pelo acelerador. GPUs subdimensionadas produzem loops de vários dias e matam a velocidade de iteração.
- Ops — sem gates de eval, monitores de drift, telemetria de custo e rollback (GitOps), modelos apodrecem em produção independentemente dos diagramas de arquitetura.
8. Aceleração cloud vs self-host
A cloud encurta o ciclo de experimento: pools GPU/CPU elásticos, notebooks/pipelines geridos e foundation models como APIs. Blocos de construção AWS:
- Amazon SageMaker — treinar, tunar, hospedar artefactos DL custom.
- Amazon Bedrock — invocar foundation models com IAM, Guardrails e ZDR opcional.
Self-host em Kubernetes quando pesos abertos, residência de dados ou economia de tokens favorecem GPUs próprios. Padrão: model registry + KServe/vLLM + sync Argo CD.
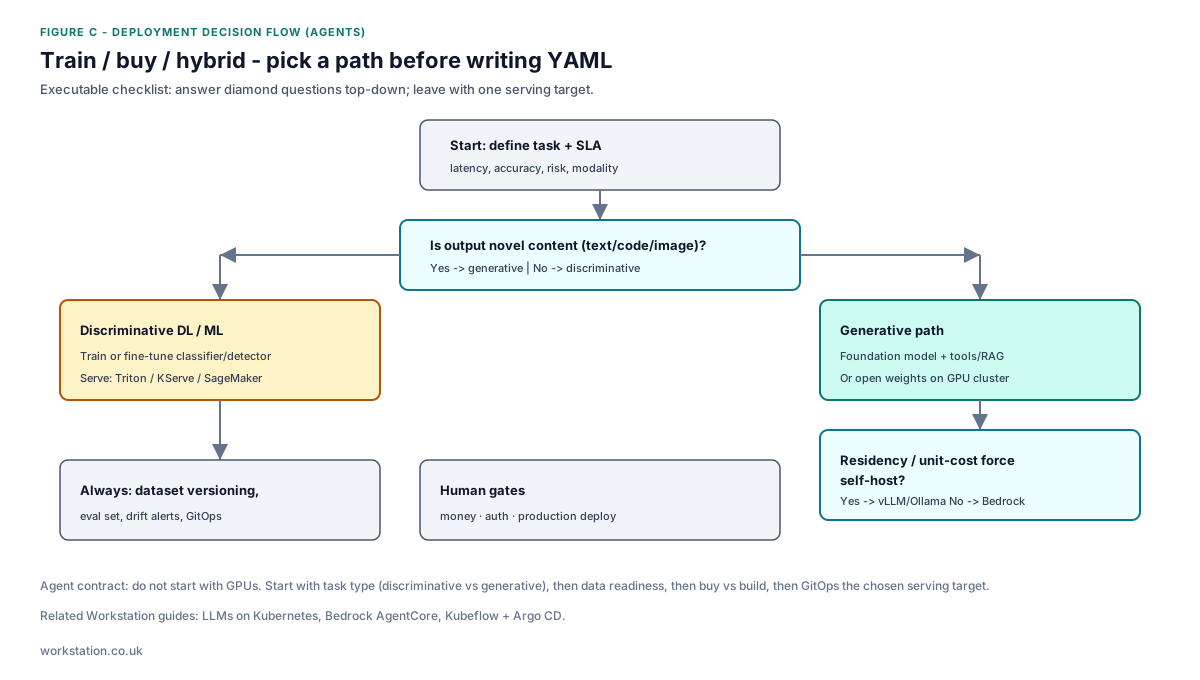
9. Checklist de execução
- Escrever a tarefa como objetivo mensurável (métrica + latência + classe de risco).
- Selecionar a camada da pilha da Figura B; não salte para gen AI por um scorecard tabular.
- Orçamentar prep de dados + OpEx de inferência; treino é frequentemente minoria do custo de vida.
- Implementar o harness de eval antes do rollout amplo; ligar alertas de drift.
- Próximas leituras: serving LLM ou agentes Bedrock.
Publicado por Workstation — plataformas de automação, software multiagente, entrega em Kubernetes.


