
LLM-knelpunten blootleggen: waarneembaarheid, OTEL en kostenbeheersing
Zakelijk overzicht: OpenTelemetry, Prometheus/Grafana, Langfuse – voor- en nadelen, kosten en gebruiksstatistieken die de uitgaven van agenten verlagen
 Balinder Walia4 september 20264 min read
Workstationzakelijke briefing: ontdek knelpunten in LLM en agenten met waarneembaarheid - OpenTelemetry, Prometheus/Grafana/Thanos en LLM-platforms zoals Langfuse - zodat u kosten kunt besparen, SLO's kunt aanscherpen en agenten met bewijs kunt verzenden. Diepe duik:lang technisch artikel (OTEL, FinOps, agentbudgetten). Gerelateerd:turbocompressor LLMs·Enterprise AI Lab.
Waarom knelpunten verborgen blijven zonder telemetrie
LLM-agents koppelen aanwijzingen, tools, RAG-ophalen en nieuwe pogingen. Latentie en uitgaven zijn samengesteld over hops heen. Zonder spanwijdten en metrieken kun je niet zeggen of het knelpunt het model, de vectoropslag, een gebrekkig hulpmiddel of een onbegrensde zelfdebuglus is. Zakelijke belanghebbenden overkopen vervolgens de GPU- of API-quota, terwijl de productkwaliteit gelijk blijft.
Het standpunt van Workstation ten aanzien van AI-complexen: behandel pijpleidingen van agenten zoals elke andere productieservice – eerst de waarneembaarheid van, daarna de service optimaliseren (ziePagedAttention / vLLM) en vervolgens met discipline promoten (Ring Promoter).
De observatiestapel die zichzelf terugbetaalt
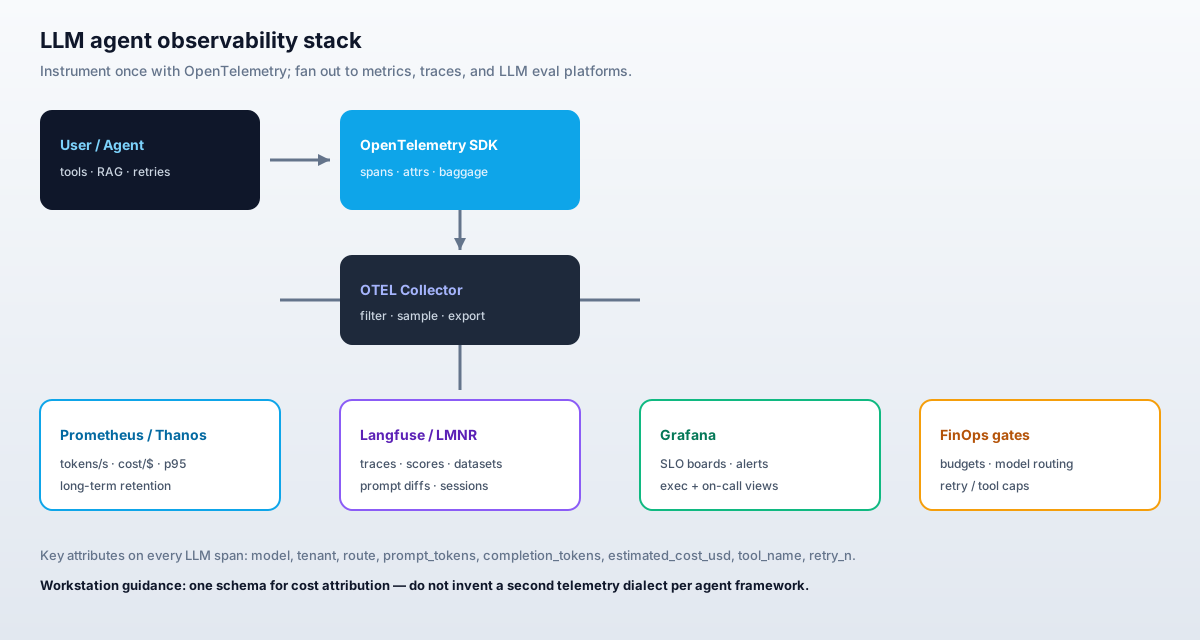
- OpenTelemetry (OTEL)— één instrumentatielaag voor traces, statistieken en (waar nuttig) logboeken. Exporteren naar een verzamelaar; waaier uit naar backends.
- Prometheus + Grafana (+ Thanos)— gouden signalen: verzoeksnelheid, foutenpercentage, latentie, tokendoorvoer, geschatte $/verzoek, GPU-gebruik. Thanos (of gelijkwaardig) houdt langetermijnstatistieken bij voor FinOps-beoordelingen.
- LLM observatieplatforms(bijv.Langfuse,LMNR) — sessie/trace-UI, promptversies, menselijke & geautomatiseerde scores, datasets voor regressie.
Voor- en nadelen van deze aanpak
| Afmeting | Voordelen | Nadelen / afwegingen |
|---|---|---|
| Kostenbeheersing | Ken uitgaven toe aan tenant, functie, model en agentstap; dood verspillende nieuwe pogingen. | Engineering tijd tot instrument; opslagkosten voor sporen als retentie naïef is. |
| Kwaliteit | Scores + datasets vangen snelle regressies op voordat klanten dat doen. | Geautomatiseerde scores kunnen luidruchtig zijn; mensen nog steeds nodig voor kritieke paden. |
| Ops | Dezelfde OTEL/Prometheus-vaardigheden als uw andere microservices. | LLM-specifieke gebruikersinterfaces (Langfuse enz.) voegen een ander product toe om uit te voeren of te kopen. |
| Naleving | Controleer wie welk model heeft aangeroepen met welke promptversie. | Prompt/PII-retentiebeleid moet vooraf worden ontworpen. |
| Snelheid naar waarde | Eerste dashboards in dagen als u Grafana al gebruikt. | Volledige kostentoeschrijving voor grafieken met meerdere agenten duurt langer. |
Kosten: wat u uitgeeft versus wat u bespaart
Instrumentatiekosten (typisch platform voor middelgrote agenten):
- 1–2 ingenieursweken om OTEL-overspanningsconventies + exporteurbedrading over te nemen.
- Collector + behoud van statistieken: vaak <5–10% van de maandelijkse LLM API/GPU-uitgaven zodra de sampling is afgestemd.
- Optionele SaaS LLM-observatie: geprijsd per gebeurtenis/trace – budgeteer dit als een percentage van de modeluitgaven, niet als een bijzaak.
Besparingshendels (gebruiksstatistieken die de naald bewegen):
- Tokens per succesvolle taak— geen tokens per onbewerkte oproep. Cap-toollussen en zelfdebugrondes.
- Kosten per succesvolle taak— route goedkope modellen voor classificeren/routeren; reserveer grensmodellen voor harde stappen.
- Cachehitpercentage— caching van prompts/voorvoegsels waar veilig; meet de correctheid, niet alleen de latentie.
- Aantal nieuwe pogingen & dode letter-percentage- schilferige gereedschappen vermommen zich als problemen met de "modelkwaliteit".
- p95 TTFT en end-to-end latentie— bescherm UX terwijl u bespaart op de uitgaven.
Score: handmatig versus automatisch
| Methode | Wanneer moet u | gebruiken?Zakelijk briefje |
|---|---|---|
| Handmatig scoren | Gold-sets, gereguleerde antwoorden, merkgevoelige kopie. | Duur, maar gegronde geautomatiseerde rechters. |
| Automatisch scoren | Regressie met groot volume, LLM-als-rechter, rubriekcontroles. | Goedkoop op schaal; kalibreer maandelijks tegen mensen. |
Migratie-playbook (begin klein)
- Instrumentéén-productieagentpad end-to-end met OTEL + token/kostenattributen.
- Verzend een Grafana-bord voor snelheid / fouten / latentie / $/succes.
- Voeg Langfuse (of gelijkwaardig) toe voor promptversies en scores op dat pad.
- Hard caps afdwingen: max. tokens, max. tooloproepen, max. nieuwe pogingen per sessie.
- Breid pas uit naar de volgende agent nadat het eerste pad een gemeten kosten- of latentiewinst laat zien.
Bekijk: waarom observatie belangrijk is voor AI-systemen
Contextbespreking over waarneembaarheidscultuur - geen Workstation-productdemo. Koppel metOpenTelemetry-documentatieen hetWorkstation technisch artikel.
Lees volgende
- Lang artikel— OTEL-spanschema, verzamelaars, kostenformules, agentcaps, Langfuse/LMNR-aantekeningen.
- Turbocompressor LLMs- knelpunten aan de bedieningszijde nadat u ze kunt zien.
- Lokale agenten·Enterprise AI Lab·Neem contact op met Workstation
Gepubliceerd doorWorkstation. Referenties:langfuse/langfuse·lmnr-ai/lmnr·OpenTelemetry.