
Workstation technische briefing: hoe u LLM- en multi-agentknelpunten kunt ontdekken OpenTelemetrie, Prometheus/Grafana/Thanos en LLM-platforms zoals Langfuse / LMNR — inclusief spanschema's, kostenattributie, steekproeven en harde gebruikslimieten. Metgezel: zakelijke blog · portie: LLM's met turbocompressor · laboratorium: Enterprise AI-lab.
- Probleem: Agentkosten en latentie worden verborgen in hops (LLM → tools → RAG → nieuwe pogingen), niet in een enkele “model is langzaam”-statistiek.
- Standaard: Instrument met OpenTelemetrie; één attribuutschema voor tokens, model, tenant, route, geschatte_kosten_usd.
- Metrische pad: Prometheus (+ Thanos) voor gouden signalen; Grafana voor SLO's en FinOps-borden.
- LLM-pad: Langfuse/LMNR voor sporen, scores, datasets, promptversies.
- Controle: Cap-tokens, tooloproepen en foutopsporingsrondes; routemodellen op moeilijkheidsgraad.
- Winnen: Meet de kosten per succesvolle taak voordat u meer GPU's koopt of API-quota verhoogt.
1. Wat ‘knelpunt’ betekent voor LLM-agents
Knelpunten in de trainingstijd (gegevens, FLOP's) verschillen van de serveertijd en agent-tijd knelpunten. Bij productiemiddelen zijn de dominante afvalmodi:
- Snelle opgeblazenheid — te grote systeemprompts, niet-hergebruikte context, ontbrekende prefix/cache-hits.
- Model-overkill — grensmodellen die worden gebruikt voor het classificeren/routeren van stappen die een klein model kan uitvoeren.
- Onbegrensde lussen — nieuwe pogingen van tools en zelf-debug-cycli zonder een hard budget (zie Self-Debugging-trade-offs in LLM's met turbocompressor).
- Externe wachttijden — vector DB, SaaS APIs en human-in-the-loop-poorten die ten onrechte worden toegeschreven aan “LLM-latentie”.
- Fragmentatie van dienst — KV-cacheverspilling op het GPU (PagedAttention/vLLM-territorium) nadat u al hebt bevestigd dat de agentgrafiek correct is.
Zonder gedistribueerde sporen kun je deze niet scheiden. Waarneembaarheid is daarom geen leuk dashboard; het is het controlevlak voor FinOps en SRE op AI-producten.
2. Referentiearchitectuur
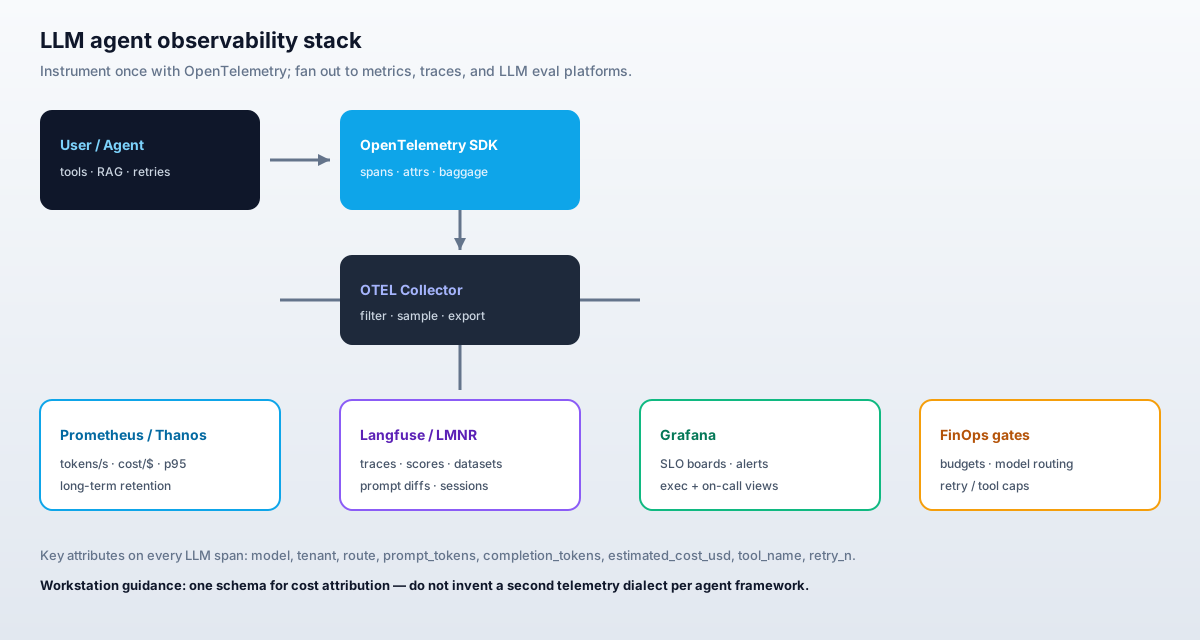
User / Orchestrator
    → Agent runtime (tools, RAG, LLM calls)
        → OpenTelemetry SDK (spans + metrics)
            → OTEL Collector (filter, sample, redact)
                ├─→ Prometheus / Thanos   (rates, costs, SLOs)
                ├─→ Grafana              (boards, alerts)
                └─→ Langfuse / LMNR      (traces, scores, datasets)
FinOps / policy layer reads the same metrics to enforce caps and model routing.
3. OpenTelemetry-spanschema voor LLM-oproepen
Hanteer één conventie voor alle frameworks (LangChain, aangepaste Go/Python-agents, Bedrock SDK's). Geef de voorkeur aan semantische conventies waar deze bestaan, en breid uit met stabiele Workstation-attributen:
| Attribuut | Voorbeeld | Waarom |
|---|---|---|
gen_ai.system | openai / antropisch / gesteente / vllm | Provider-combinaties |
gen_ai.request.model | claude-sonnet-4 / lama-3.1-8b | Kosten en kwaliteit per model |
gen_ai.usage.input_tokens | 1820 | Snelle kostendrijver |
gen_ai.usage.output_tokens | 410 | Kostendriver voor voltooiing |
wsw.estimated_cost_usd | 0.0124 | FinOps zonder later prijslijsten aan te sluiten |
wsw.tenant_id | acme-prod | Terugvordering |
wsw.route | ondersteuning.triage | Toeschrijving van productkenmerken |
wsw.agent_step | plan / hulpmiddel / kritiek | Vind dure stappen |
wsw.retry_n | 2 | Lusdetectie |
wsw.prompt_version | triage@v17 | Regressiekoppeling |
from opentelemetry import trace
from opentelemetry.trace import Status, StatusCode

tracer = trace.get_tracer("workstation.agents")

PRICE_IN = 0.003 / 1000   # example $/token — load from config
PRICE_OUT = 0.015 / 1000

def complete_llm(model: str, prompt: str, tenant: str, route: str):
    with tracer.start_as_current_span("gen_ai.chat") as span:
        span.set_attribute("gen_ai.system", "openai")
        span.set_attribute("gen_ai.request.model", model)
        span.set_attribute("wsw.tenant_id", tenant)
        span.set_attribute("wsw.route", route)
        try:
            resp = client.chat.completions.create(
                model=model,
                messages=[{"role": "user", "content": prompt}],
            )
            usage = resp.usage
            cost = usage.prompt_tokens * PRICE_IN + usage.completion_tokens * PRICE_OUT
            span.set_attribute("gen_ai.usage.input_tokens", usage.prompt_tokens)
            span.set_attribute("gen_ai.usage.output_tokens", usage.completion_tokens)
            span.set_attribute("wsw.estimated_cost_usd", round(cost, 6))
            return resp.choices[0].message.content
        except Exception as e:
            span.record_exception(e)
            span.set_status(Status(StatusCode.ERROR, str(e)))
            raise
Oefening: berekenen estimated_cost_usd bij de spanwijdte. Wacht niet op een nachtelijke klus om de tokentellingen aan de prijsoverzichten toe te voegen. Op afroep en producteigenaren hebben live FinOps nodig.
3b. Multi-agent omvat hiërarchie en bagage
Agentgrafieken hebben een stabiel ouder/kind-model nodig, zodat de kosten correct worden opgeteld:
session (root)
  └─ agent.run {wsw.route, wsw.tenant_id}
       ├─ rag.retrieve {wsw.agent_step=retrieve}
       ├─ gen_ai.chat {wsw.agent_step=plan, model=…}
       ├─ tool.execute {tool=…, wsw.retry_n}
       ├─ gen_ai.chat {wsw.agent_step=synthesize}
       └─ eval.score {score.name, score.value}
- Eén root per gebruikerstaak — niet per LLM-oproep. Sessiekosten = som van het kind
wsw.estimated_cost_usd. - Bagage – propageren
wsw.tenant_idEnwsw.routeover asynchrone werkers/wachtrijen heen, zodat toolspannes terugboekingslabels kunnen overnemen zonder elke oproeplocatie opnieuw te moeten lokaliseren. - Koppelingen — wanneer een subagent een nieuwe tracering start (bijvoorbeeld een afzonderlijke wachtrijconsument), gebruik dan span-links terug naar de bovenliggende sessie, zodat Langfuse/Grafana de grafiek nog steeds kan samenvoegen.
- Altijd hoge kosten uitproberen — hoofdbemonstering van 5-20% is prima voor gelukkige paden; monster forceren wanneer de sessie-uitgaven een drempelwaarde overschrijden of status=ERROR.
4. Statistieken die er toe doen (Prometheus)
Exporteer histogrammen en tellers (via OTEL-statistieken of een Prometheus-client). Minimaal haalbare set:
llm_requests_total{model,route,status}llm_tokens_total{model,direction}waarbij richting ∈ {invoer, uitvoer}llm_estimated_cost_usd_total{model,tenant,route}llm_ttft_seconds/llm_e2e_secondshistogrammenagent_tool_calls_total{tool,status}agent_retries_total{route}agent_task_success_total{route}— noemer voor kosten per succes
Afgeleide FinOps-query's (PromQL-schetsen):
# Cost per successful task (last 1h), by route
sum(rate(llm_estimated_cost_usd_total[1h])) by (route)
  /
sum(rate(agent_task_success_total[1h])) by (route)

# Retry tax
sum(rate(agent_retries_total[1h])) by (route)
  /
sum(rate(llm_requests_total[1h])) by (route)
Thanos (of Mimir/Cortex) is van belang als Finance om kwartaal-op-kwartaal modeluitgaven vraagt. Alleen de plaatselijke Prometheus is prima als oproepkracht; het is geen FinOps-archief.
5. Grafana-borden en waarschuwingen
Verzend drie doelgroepen vanuit één gegevensbron:
- Oproep: foutenpercentage, p95 e2e, afhankelijkheidsfouten (vector DB / tools).
- Platform: tokens/s, GPU util (indien zelf gehost), wachtrijdiepte, TTFT.
- FinOps / product: $/succes per huurder en route, top dure aanwijzingen, modelmix.
Waarschuwing voor verbranding, niet voor ijdelheid:
- Kosten per succes > budget SLO voor 30 miljoen
- Herpogingspercentage > 15% voor een route
- p95 e2e-breuk met stijgende invoertokens (prompt-regressie)
6. LLM-native platforms: Langfuse, LMNR en vrienden
Statistieken vertellen het je Dat kosten piekten; LLM-platforms vertellen het u welke promptversie En welke gereedschapsspanne deed het. Langfuse En LMNR zijn open-source voorbeelden van deze klasse:
- Hiërarchische traceringen (sessie → agent → LLM / toolspans)
- Menselijke en LLM-als-rechter-scores
- Gegevenssets voor offline evaluatie wanneer u aanwijzingen wijzigt
- Optionele gebruikstelemetrie voor productverbetering (respecteer het privacybeleid)
Integratiepatroon: behoud OTEL als registratiesysteem voor SRE; dubbele export of brug naar Langfuse voor snelle engineering. Bedenk geen tweede, onverenigbaar attribuutwoordenboek.
Framework-experimenten zoals function-first agent runtimes (die van oudsher op de markt worden gebracht rond gestructureerde streaming-agents) kunnen de boilerplate verminderen, maar niche-frameworks als optioneel behandelen – normen voor waarneembaarheid overleven deze.
7. Scorepijplijn: handmatig versus automatisch
| Methode | Uitvoering | Mislukkingsmodus |
|---|---|---|
| Handmatig | Thumbs/rubrieken in Langfuse UI; gouden set beoordelingen. | Schaalt niet; nog steeds vereist voor kalibratie. |
| Automatisch | LLM-als-rechter, eenheidscontroles, schemavalidators, terugroepactie. | Rechter drift; gaming als het alleen voor de rechter wordt geoptimaliseerd. |
Voeg scores toe als spangebeurtenissen of Langfuse-scores ingetoetst door wsw.prompt_version. Gate-promoties van prompts op dezelfde manier als app-versies: Ring Promoter voor code; evaluatiepoorten voor aanwijzingen.
8. Kostenbesparingsproces (gedetailleerd)
- Basislijnweek: geen gedragsverandering; alleen instrumentatie. Vastleggen van $/succes, tokens/succes, percentage nieuwe pogingen.
- Toeschrijving: rangschik routes op basis van uitgaven × volume. Kies de top drie.
- Modelroutering: splitsen classificeren/uitpakken naar kleine/lokale modellen; houd de grens voor synthese. Meet de kwaliteitsscores opnieuw.
- Snelle operatie: verwijder ongebruikte toolschema's; enkele shots inkorten; schakel prefix-cache in waar dit veilig is.
- Lusdoppen: max. gereedschapsoproepen, max. zelfdebugrondes, exponentiële back-off met stroomonderbrekers.
- Bemonstering: behoud 100% statistieken; voorbeeldsporen (bijv. 5-20%) plus permanente bemonstering voor fouten en dure sessies.
- Redactie: verwijder PII van span-attributen vóór export; sla volledige prompts alleen op in goedgekeurde winkels met TTL.
- Beoordeling cadans: wekelijks FinOps-bord; maandelijkse rechterkalibratie tegen mensen.
8b. Agentgebruik beheren met live budgetten
Dashboards alleen houden weggelopen agenten niet tegen. Handhaaf budgetten tijdens de runtime, zend de beslissing uit als een spangebeurtenis en waarschuw wanneer sessies vaak het plafond bereiken:
# Pseudocode: hard budget around an agent session
class Budget:
    def __init__(self, max_usd=0.50, max_tool_calls=8, max_llm_calls=12):
        self.max_usd, self.max_tool_calls, self.max_llm_calls = max_usd, max_tool_calls, max_llm_calls
        self.spent = 0.0
        self.tools = self.llms = 0

    def charge(self, usd: float, kind: str):
        self.spent += usd
        if kind == "tool":
            self.tools += 1
        else:
            self.llms += 1
        if self.spent > self.max_usd or self.tools > self.max_tool_calls or self.llms > self.max_llm_calls:
            raise RuntimeError("agent budget exhausted")
- Caps per sessie — USD, LLM-oproepen, tooloproepen (hierboven).
- Dagelijkse quota per tenant — Redis/counter ingetoetst door
wsw.tenant_id; retourneren een gecontroleerd gedegradeerd pad wanneer ze uitgeput zijn. - Modelbeleid per route — modellen op de toelatingslijst voor
support.triageversuslegal.draft; beleidsfouten en -records afwijzen of terugschakelenwsw.policy_action=downshift. - Idempotente gereedschapssleutels — hash-tool args zodat nieuwe pogingen geen dubbele facturering van externe API's tot gevolg hebben.
- Kostenformule —
cost = in_tokens × p_in + out_tokens × p_out + tool_fees; vernieuwenp_in/p_outvan een prijsoverzicht met versies, zodat historische Thanos-gegevens vergelijkbaar blijven.
Metriek om in de gaten te houden nadat de caps zijn geland: agent_budget_exhausted_total{route,reason}. Een piek betekent misbruik, een kapotte toolloop of een budget dat te krap is voor echte werklasten.
9. Configuratieschets van de collector
# otel-collector-config.yaml (illustrative)
receivers:
  otlp:
    protocols:
      http:
      grpc:
processors:
  memory_limiter: {}
  batch: {}
  attributes/redact:
    actions:
      - key: gen_ai.prompt
        action: delete
exporters:
  prometheus:
    endpoint: "0.0.0.0:8889"
  otlp/langfuse:
    endpoint: "${LANGFUSE_OTLP_ENDPOINT}"
    headers:
      Authorization: "Bearer ${LANGFUSE_KEY}"
service:
  pipelines:
    traces:
      receivers: [otlp]
      processors: [memory_limiter, attributes/redact, batch]
      exporters: [otlp/langfuse]
    metrics:
      receivers: [otlp]
      processors: [memory_limiter, batch]
      exporters: [prometheus]
10. Voor- en nadelen en wanneer u zich er niet druk over hoeft te maken
Pluspunten: terugboeking, snellere beoordeling van incidenten, meetbare ROI bij snelle/modelwijzigingen, nalevingsvriendelijke audittrails, gedeeld taalgebruik tussen ML- en platformteams.
Nadelen: instrumentatieschuld; opslagkosten als u elke prompt voor altijd bewaart; risico dat PII naar de verkeerde backend wordt verzonden; nog een console waar ingenieurs kunnen leren.
Sla (voorlopig) over als: u heeft één offline batchtaak met vaste dagelijkse uitgaven en geen interactieve agenten. Nog steeds tokens loggen; sla de volledige multi-backend-stack over totdat gelijktijdigheid verschijnt.
11. Controlelijst voor migratie
- ☐ OTEL SDK in de agentruntime; verzamelaar in het cluster
- ☐ Span-attributen omvatten model, tokens, kosten, huurder, route
- ☐ Prometheus-statistieken + Grafana FinOps-bord
- ☐ Langfuse (of LMNR) aangesloten op ten minste één kritiek pad
- ☐ Harde doppen op tokens / gereedschappen / nieuwe pogingen
- ☐ Redactiebeleid beoordeeld door de beveiliging
- ☐ Wekelijkse beoordeling van $/succes voor toproutes
- ☐ Document ADR koppelt waarneembaarheid → serveren (vLLM) → promotie (Ring Promoter)
12. Gerelateerd Workstation-materiaal
- Zakelijke bloggenoot
- LLM's met turbocompressor - repareer het serveren nadat u het knelpunt kunt zien
- Ring Promoter — agentendiensten met gezondheidspoorten bevorderen
- Muse Glimmer / lokale agenten
- Neem contact op met Workstation voor Enterprise AI Lab-opdrachten
Referenties
Gepubliceerd door Workstation.


